🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Nikolai Smirnov
Software Development Lead
已发表 Sep 21, 2026
已更新 Sep 21, 2026 · 最小阅读量
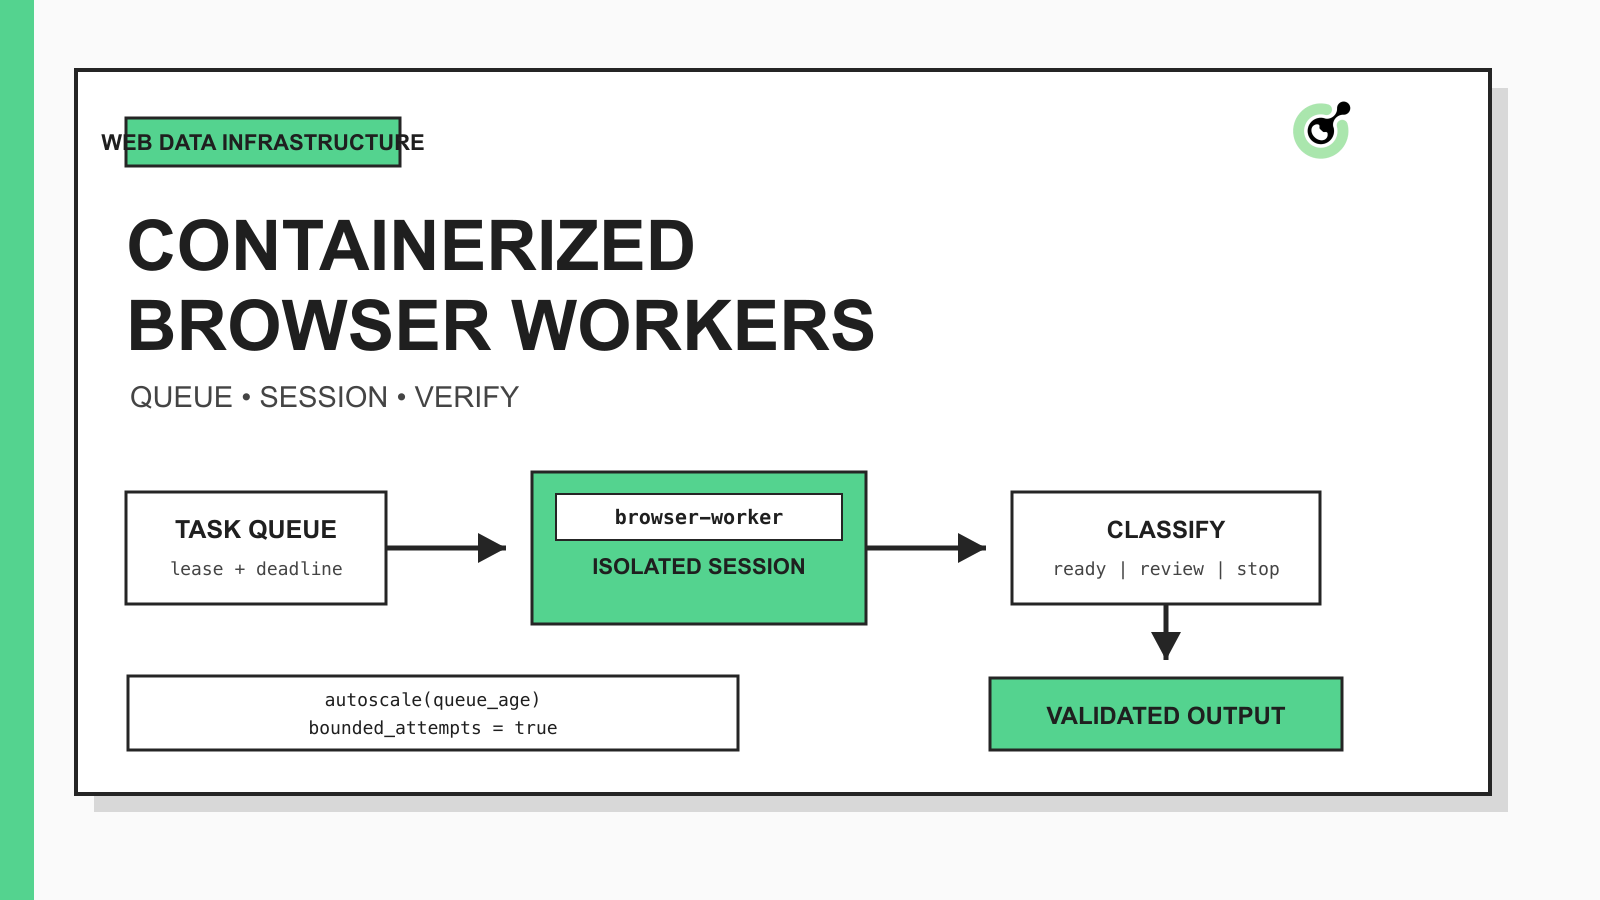
容器即服务(CaaS)为团队提供了一种托管方式,用于部署、运行和扩展容器化的工作进程。对于网络爬虫,这通常意味着将浏览器或HTTP工作进程打包一次,从队列中获取任务,并根据需求变化增加工作进程数量。运行时变得可重复,而平台负责大部分的调度、健康检查和生命周期管理。
该定义有一个重要的边界:CaaS扩展的是执行,而非正确性。即使有100个健康的容器,仍可能返回100个验证码页面、重复提交相同内容,或将错误文档解析为产品数据。因此,设计需要一个稳定的任务合同、浏览器状态模型、有限的挑战路径以及提取后的验证器。
当授权的工作流程到达支持的验证步骤时,CapSolver 可以提供文档化的解决任务,而工作进程仍需负责会话连续性、截止时间、结果应用和最终业务状态检查。
可靠的CaaS网络爬虫流水线将编排与网络访问分离。每个阶段都有小的责任,并发出类型化结果,而不是模糊的成功标志。
| 阶段 | 输入 | 操作 | 输出 | 停止条件 |
|---|---|---|---|---|
| 调度器 | 授权的URL和策略 | 创建幂等任务 | 任务ID和截止时间 | 作用域无效或截止时间已过 |
| 队列 | 任务记录 | 将工作租约给一个工作进程 | 租约所有者和尝试次数 | 无法获取租约 |
| 浏览器工作进程 | 任务和会话引用 | 导航并观察 | 页面证据和分类 | 导航或策略预算耗尽 |
| 验证码处理程序 | 合格的验证码记录 | 运行文档化的任务流程 | 类型化解决结果 | 不支持的类型或尝试次数限制 |
| 提取器 | 接受的页面证据 | 解析所需字段 | 结构化记录 | 所需字段缺失 |
| 验证器 | 结构化记录和证据 | 检查模式和业务规则 | 接受或拒绝的记录 | 验证失败 |
这种分离也使自动扩展更安全。编排器可以添加工作进程,而无需赋予每个工作进程更改作用域、创建无限验证码任务或直接写入下游系统的权限。
容器化浏览器工作进程在需要自动扩展器之前,需要一个持久化任务合同。至少需要在容器外部存储任务ID、授权目标、策略版本、创建时间、绝对截止时间、会话引用、当前阶段、尝试次数和幂等性密钥。
合同应明确三个决策:
容器是可丢弃的。Cookie、存储状态引用、截图、追踪记录和任务历史不是。将这些工件存储在批准的持久化系统中,并通过队列传递引用。Playwright文档指出浏览器上下文隔离Cookie、本地存储和其他状态,这使得每个租约任务一个上下文成为有用默认值。如果工作流程有意重用身份验证,请将存储状态作为凭证保护,并永远不要将其烘焙到镜像中。
浏览器工作进程应一次处理一个租约任务,并在确认队列消息前关闭其浏览器上下文。这可以保持会话所有权清晰,并防止Cookie或内存状态在不相关任务之间泄漏。
镜像应仅包含运行时、浏览器依赖项、工作进程代码和非秘密默认值。在运行时从平台的密钥管理器注入API密钥和存储凭证。固定浏览器和库版本,然后通过受控发布重新构建,而不是在任务开始时安装任意包。
使用三个健康信号:
不要将成功的健康探测视为页面任务成功的证明。健康描述工作进程;任务证据描述网络工作流。
页面分类应在任何解析器或下游写入之前进行。仅HTTP状态不足以判断,因为响应可能返回200,同时显示登录表单、验证码页面、同意屏幕或应用错误。
从同一浏览器上下文中收集有限的证据集:最终URL、响应状态、文档标题、选定的DOM标记、截图引用、控制台错误和所需字段的存在。将任务路由到少量状态之一,如ready、challenge、authentication_required、retryable_error、terminal_error或review_required。
分类层不应猜测如何解决每个障碍。它仅识别观察到的状态,并将类型化记录传递给下一个授权组件。这与CapSolver关于AI代理的网络自动化基础设施堆栈的指南中描述的分离相同:浏览器运行时负责会话和证据,而验证码处理是一个受控层。
验证码处理应作为可选分支,而不是通用重试循环。工作进程首先检查目标和验证码是否在批准的策略范围内,任务类型是否受支持,浏览器会话是否仍然有效,并且在绝对截止时间前是否仍有时间。
文档化的CapSolver流程使用createTask创建支持的任务,并使用getTaskResult获取异步结果。查看官方createTask和结果轮询流程以获取当前请求字段和任务类型规则。将返回的任务ID保存在持久化状态中,以便重启的工作进程轮询已知任务,而不是创建另一个任务。
使用可跨重启的预算:
如果验证码类型不受支持,会话已更改,截止时间已过,或应用拒绝结果,则返回终止或审核状态。不要让自动扩展器将一个阻塞任务变成多个重复的解决尝试。
领取您的CapSolver优惠码
立即提升您的自动化预算!
在充值CapSolver账户时使用优惠码 CAP26,每次充值可获得额外 5% 的奖励 —— 无限制。
现在在您的 CapSolver仪表板 中领取
提取应在页面分类返回ready后开始。解析业务任务所需的最小模式,然后在写入下游之前验证类型、所需字段、新鲜度、唯一性和来源一致性。
为每个记录保留一个紧凑的证据信封:
{
  "task_id": "task-20260921-0042",
  "final_url": "https://example.test/catalog/42",
  "observed_at": "2026-09-21T02:30:00Z",
  "page_state": "ready",
  "session_ref": "session://browser/task-20260921-0042",
  "required_fields_present": true,
  "artifact_refs": ["screenshot://task-20260921-0042/final"]
}
信封是示例性的,但其目的是明确的:下游系统可以区分新鲜页面证据与过时缓存、解析器输出与浏览器观察、接受的数据与虚假成功。保留应短暂且受策略驱动,特别是当截图或浏览器状态可能包含个人或机密信息时。
CaaS扩展应响应工作负载,而不仅仅是处理利用率。浏览器工作进程通常等待导航、渲染、队列或外部API,因此CPU可能显示较低,而任务延迟却在上升。
有用的扩展输入包括待处理任务数量、最老就绪任务的年龄、租约等待时间、中位任务持续时间以及每种类型状态的工作进程数量。Kubernetes文档指出HorizontalPodAutoscaler可以使用自定义指标,这比仅CPU更适用于基于队列的浏览器工作。Kubernetes还提供用于完成有限任务的Jobs,尽管当浏览器启动成本高昂时,持续的队列消费者可能更高效。
为工作进程数量、每域名并发、总验证码任务和下游写入设置硬性上限。当目标开始返回更多验证码或拒绝状态时,应减少或暂停工作,而不是扩展到失败。上升的队列可能是容量信号;上升的验证码率是诊断信号。
以下Python函数在不接触目标或解决验证码的情况下模拟决策层。它接受观察到的页面状态和持久化任务预算,然后返回下一步操作。
from dataclasses import dataclass
from enum import Enum


class NextAction(str, Enum):
    EXTRACT = "extract"
    HANDLE_CHALLENGE = "handle_challenge"
    RETRY = "retry"
    REVIEW = "review"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    attempts: int
    max_attempts: int
    seconds_remaining: int
    session_matches: bool
    challenge_allowed: bool


def decide(page_state: str, budget: Budget) -> NextAction:
    if budget.seconds_remaining <= 0:
        return NextAction.STOP
    if page_state == "ready":
        return NextAction.EXTRACT
    if page_state == "challenge":
        if not budget.challenge_allowed or not budget.session_matches:
            return NextAction.REVIEW
        if budget.attempts >= budget.max_attempts:
            return NextAction.STOP
        return NextAction.HANDLE_CHALLENGE
    if page_state == "retryable_error":
        return NextAction.RETRY if budget.attempts < budget.max_attempts else NextAction.STOP
    if page_state in {"authentication_required", "review_required"}:
        return NextAction.REVIEW
    return NextAction.STOP
本地测试覆盖就绪页面、合格验证码、更改的会话、过期截止时间、重试耗尽、审核状态和未知输入。决策模型有意保持简小,以便编排器可以记录和审计每次转换。
最有用的指标将基础设施行为与页面结果联系起来。跟踪队列年龄和工作进程饱和度,同时记录验证码率、需要身份验证的率、解析器拒绝率、重复任务率、截止时间过期和最终业务状态接受率。
在队列消息、浏览器追踪、验证码任务、提取记录和下游写入之间使用相关性ID。日志应屏蔽API密钥、Cookie、令牌和个人数据。截图是证据,而不是默认的永久记录;仅保留授权用例所需的内容。
根据比率而不是孤立失败进行警报。一个验证码可能是正常的。同一目标、路径或浏览器版本的快速增加可能表明网站更改、会话缺陷、身份验证过期、策略问题或版本回归。暂停受影响的部分,同时其余队列继续运行。
容器扩展不会扩大权限。仅在公共、授权或合法数据工作流中使用此架构。尊重目标条款、速率限制、隐私义务、司法管辖区和数据最小化要求。
除非工作流明确批准处理该数据,否则不要将私有页面、账户数据或敏感截图发送到外部系统。将登录和身份验证工作流与普通公共数据任务分开。在敏感提交、不可逆操作或作用域更改前要求人工审核。
容器即服务使浏览器工作进程可重复且可扩展,但生产可靠性来自于围绕这些工作进程的合同。为每个任务分配一个所有者、一个隔离的会话、一个持久化截止时间、一个类型化状态机和一个验证输出。当队列显示健康需求时扩展;当证据显示重复拒绝或不确定状态时暂停。
对于具有支持验证步骤的授权工作流,CapSolver 可以在准入门控后运行,同时您的应用程序保留浏览器上下文并验证最终结果。
从一个已批准的目标和一个有限制的工作者开始。在增加并发性之前,记录页面分类、挑战资格、经过时间、最终接受情况和证据引用。使用 CapSolver 文档 选择当前记录的任务流程,然后在原始浏览器会话中审查结果。
问:容器即服务能否解决网站访问问题?
不能。CaaS 部署和扩展容器化应用程序,而您的访问层仍然需要浏览器状态、路由、挑战分类、策略控制和结果验证。
问:每个 URL 是否应该在单独的容器中运行?
不一定。每个租赁任务一个隔离的浏览器上下文通常是重要的边界;如果工作者容器在关闭每个上下文、清除任务内存并在持久化状态写入后确认,它可以按顺序处理任务。
问:应使用哪个指标来扩展浏览器工作者?
队列深度和任务年龄通常比 CPU 单独作为主要信号更强。将其与工作者限制、目标级并发性、挑战率和截止期限过期结合使用,以防止平台扩展失败的工作流。
问:重启的工作者如何处理现有的 CAPTCHA 任务?
重启的工作者应加载持久化提供者任务 ID、原始截止期限、尝试次数和会话引用。只有在会话仍然匹配且剩余预算允许时,才应轮询已知任务;否则应停止或请求审查。
问:此模式能否用于私人或受限数据?
技术能力并不授予收集私人、受限、个人或敏感数据的权限。仅在批准的范围内使用此模式,并应用目标条款、适用法律、数据最小化、保留控制和人工审查要求。
Nikolai Smirnov
Software Development Lead
Building dependable software for complex automation.
关于作者