
🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado May 21, 2026
Atualizado May 21, 2026 · minutos de leitura
Em nosso artigo anterior, exploramos como o Agentic Browser se transforma de uma ferramenta passiva de “exibição” em um “agente de ação” ativo. Examinamos sua arquitetura central: compreensão de intenção, percepção do ambiente e execução de ações. No entanto, à medida que esses agentes digitais navegam na web do mundo real, checkpoints de CAPTCHA podem interromper fluxos de trabalho que, de outra forma, seriam válidos. Este artigo foca no “motor invisível” — a infraestrutura de resolução de CAPTCHA — que ajuda agentes autorizados a pausar, enviar o contexto de tarefa necessário, verificar o resultado e continuar. Vamos analisar por que checkpoints de CAPTCHA são um desafio operacional comum para IA e como serviços especializados como o CapSolver apoiam a próxima geração de automação web autorizada.
Uso responsável: o CapSolver se destina apenas a automação legal e autorizada, incluindo testes em sistemas que você possui ou tem permissão para acessar. O uso para fraude, criação de contas falsas, compras não autorizadas, spam ou abuso de controle de acesso é proibido de acordo com os Termos e Condições do CapSolver.
Imagine este cenário: uma equipe de QA pede a um Agentic Browser que complete um formulário de múltiplas etapas em um ambiente de homologação que ela própria controla. O agente abre a página, localiza os campos necessários e chega a um checkpoint de CAPTCHA antes do envio. O fluxo de trabalho é pausado até que a verificação seja concluída. O CAPTCHA, esse “Teste de Turing” surgido nos primeiros dias da Internet, tornou-se um desafio prático de confiabilidade para fluxos de trabalho de IA autorizados.
CAPTCHA significa “Completely Automated Public Turing Test to Tell Computers and Humans Apart” (Teste de Turing Público Completamente Automatizado para Distinguir Computadores de Humanos). Seu propósito original era simples: manter bots fora e permitir a entrada de humanos. Mas à medida que a IA evoluiu, os CAPTCHAs também evoluíram continuamente — de letras distorcidas simples a sliders complexos, tarefas de seleção de imagens e sistemas de análise comportamental. Eles não são mais apenas um problema de reconhecimento de caracteres.
Para scripts de automação tradicionais, checkpoints de CAPTCHA podem interromper um fluxo de trabalho. Para Agentic Browsers, eles criam três principais desafios operacionais:
Aumento dramático na dificuldade de percepção: Mesmo os modelos multimodais mais avançados têm dificuldades para reconhecer de forma confiável texto fortemente distorcido, objetos desfocados em imagens ou fendas de slider escondidas em planos de fundo complexos. A IA pode simplesmente “enxergar errado”, e um único erro pode quebrar todo o fluxo de trabalho.
Sinais de verificação em camadas: CAPTCHAs modernos não são apenas desafios de front-end. Sites podem avaliar trajetórias de mouse, ritmo de digitação, tempo de permanência na página, contexto do navegador e outros sinais de sessão. Quando uma solicitação não atende às políticas de acesso do site, verificações adicionais podem ser exigidas.
Sensibilidade ao tempo e ruptura de contexto: CAPTCHAs geralmente têm tempo de expiração. Quando um Agentic Browser permanece em um checkpoint de CAPTCHA por muito tempo durante uma tarefa de múltiplas etapas, sessões de login podem expirar e a cadeia de tarefas pode precisar ser reiniciada.
Em outras palavras, Agentic Browsers precisam de uma forma controlada de pausar em checkpoints de CAPTCHA, enviar entradas documentadas e retomar apenas após a verificação bem-sucedida. É por isso que uma infraestrutura de tratamento de CAPTCHA como o CapSolver pode fazer parte de fluxos de trabalho autorizados de navegador.
O CapSolver não é uma ferramenta voltada para usuários comuns, mas sim um “motor de CAPTCHA” oculto profundamente nos kits de ferramentas de desenvolvedores. Em seu núcleo, é uma plataforma inteligente de resolução de CAPTCHA que fornece interfaces de API projetadas especificamente para ajudar programas de automação e agentes de IA a lidar com vários tipos de CAPTCHA.
Podemos pensá-lo como uma equipe de resolução de CAPTCHAs disponível 24/7, que nunca se cansa e opera em altíssima velocidade — exceto que seus “membros de equipe” consistem não apenas em modelos de IA sofisticados, mas também em algoritmos de estratégia altamente otimizados.
Para entender melhor suas capacidades, a tabela comparativa a seguir ilustra as diferenças entre abordagens tradicionais e o CapSolver diante dos mesmos desafios de CAPTCHA:
| Dimensão de Comparação | OCR Local / Modelos Simples | Plataformas Humanas de Resolução de CAPTCHA | CapSolver |
|---|---|---|---|
| Tipos de CAPTCHA Suportados | Apenas CAPTCHAs simples de texto; seleção de imagem é em grande parte ineficaz | Teoricamente suporta todos os tipos, mas é lento e caro | Abrange os tipos de CAPTCHAs predominantes |
| Velocidade de Reconhecimento | Milissegundos, porém com baixas taxas de sucesso | 5–15 segundos por tentativa | 1–3 segundos por tentativa |
| Taxa de Sucesso | Baixa (pior em CAPTCHAs complexos) | Relativamente alta, mas afetada por fadiga dos trabalhadores e latência de rede | Alta e estável |
| Estrutura de Custo | Custo de desenvolvimento único | Pagamento por tarefa com altos custos de mão de obra | Pagamento por tarefa com preço baixo e baixo custo marginal |
| Integração com Fluxo de Trabalho em Navegadores | Requer integração personalizada | Requer coordenação de tarefas separada | Pode integrar-se a ambientes de navegador e retornar resultados de tarefas documentados |
Tabela 1-1 Comparação Entre Métodos Tradicionais de Resolução de CAPTCHA e Capacidades do CapSolver
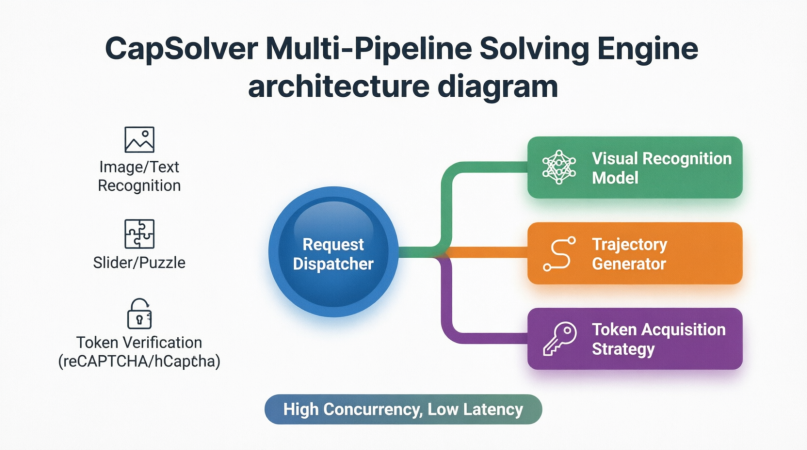
O CapSolver utiliza pipelines de processamento especializados para diferentes tipos de CAPTCHA:
CAPTCHAs de reconhecimento de imagem e texto: usando modelos de visão proprietários combinados com grandes conjuntos de treinamento, o CapSolver consegue reconhecer com precisão texto fortemente distorcido, sobreposto ou ruidoso.
CAPTCHAs de slider e quebra-cabeça: o CapSolver usa o fluxo de tarefa documentado para o tipo de desafio selecionado e retorna o resultado correspondente para que o fluxo de trabalho autorizado do cliente o aplique.
Sistemas de verificação baseados em token (reCAPTCHA v2/v3, Cloudflare, etc.): esses sistemas podem retornar um token de uso único após o envio dos parâmetros de tarefa necessários. O CapSolver usa entradas documentadas como a URL do site, a site key e contexto opcional suportado, e então retorna o resultado suportado para o fluxo de trabalho autorizado do cliente enviar.
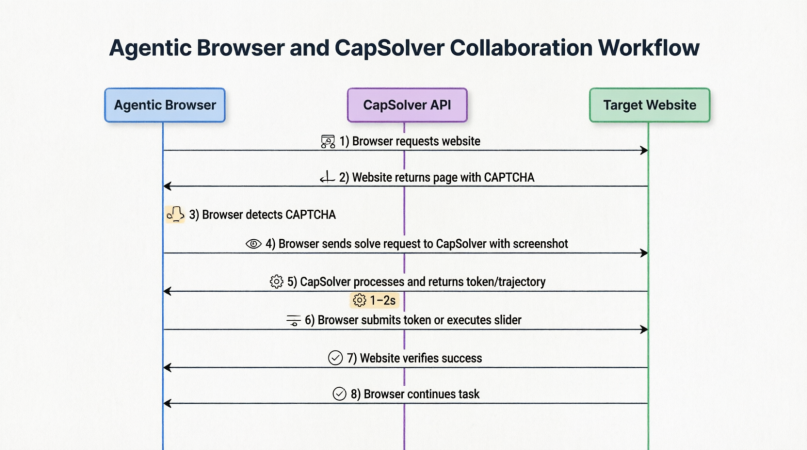
Então, como o CapSolver e os Agentic Browsers colaboram na prática? O diagrama a seguir ilustra o processo completo:
Desde o momento em que o navegador encontra um CAPTCHA, coleta o contexto de tarefa necessário, chama a API do CapSolver, recebe um resultado suportado, envia a verificação e retoma a tarefa original, o fluxo de trabalho é fortemente integrado e normalmente concluído em 1–2 segundos.
Isso significa que, para Agentic Browsers, CAPTCHAs deixam de ser problemas que a própria IA precisa “ver” e “adivinhar”. Em vez disso, tornam-se tarefas padronizadas terceirizadas para provedores de infraestrutura especializados. O navegador só precisa capturar o desafio, empacotar o contexto necessário, enviá-lo, aguardar o resultado e continuar após verificar o estado da página.
Agora vamos conectar o módulo de adaptação dinâmica de um Agentic Browser ao CapSolver e examinar um fluxo de trabalho controlado de tratamento de CAPTCHA. Use este processo apenas em sites que você possui ou está explicitamente autorizado a automatizar.
Enquanto o Agentic Browser executa tarefas, sua camada de percepção do ambiente monitora continuamente a página. Assim que um elemento de CAPTCHA é detectado (por exemplo, um pop-up contendo um iframe de reCAPTCHA), a execução de ações é imediatamente pausada e um sub-processo dedicado de tratamento de CAPTCHA é disparado.
Esse processo é altamente sofisticado e geralmente inclui as seguintes etapas:
Coleta de Contexto: o Agentic Browser captura screenshots da região do CAPTCHA e reúne informações contextuais como a URL atual, a sitekey, as dimensões da viewport do navegador e o User-Agent.
Envio da Tarefa: as screenshots e os parâmetros são empacotados e enviados ao CapSolver via API, especificando o tipo de CAPTCHA.
Resolução em Segundo Plano: após receber a tarefa, o CapSolver a encaminha pelo pipeline de resolução correspondente. Por exemplo, ao encontrar um reCAPTCHA v2, ele invoca um resolvedor dedicado para retornar um token g-recaptcha-response válido. Todo o processo de resolução geralmente é concluído em 1–2 segundos.
Retorno de Instruções: o Agentic Browser recebe o resultado especificado para o tipo de tarefa suportado, como uma string de token.
Execução no Site: o Agentic Browser aplica o resultado retornado por meio do callback, campo ou manipulador client-side documentado. Após a página confirmar a verificação, o fluxo de tarefa autorizado pode ser retomado.
Verificação de Estado: o navegador verifica se a página passou com sucesso pela validação e se os elementos-alvo reapareceram antes de continuar o fluxo de trabalho interrompido.
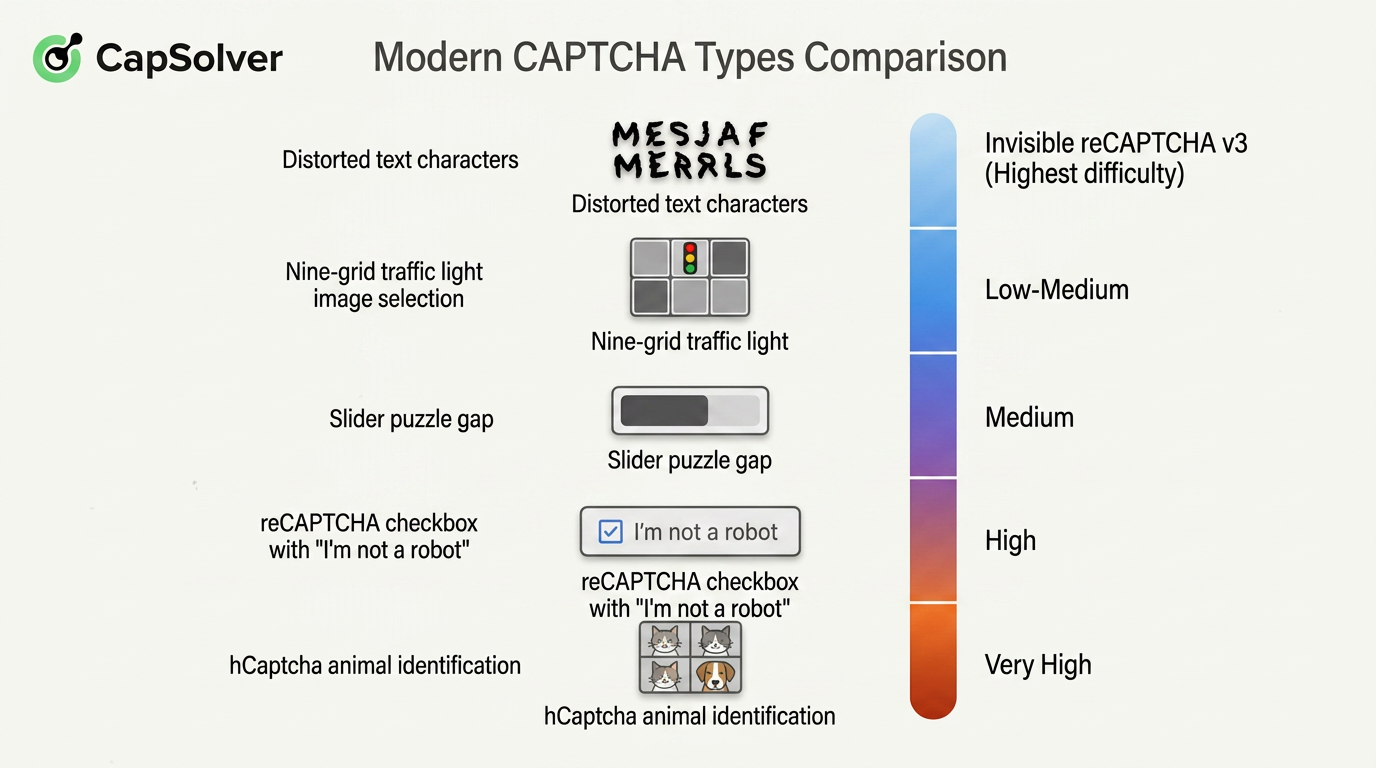
É importante notar que CAPTCHAs modernos assumem muitas formas com diferentes níveis de complexidade. O diagrama a seguir categoriza os tipos de CAPTCHA predominantes e marca seus respectivos níveis de complexidade:
Para os usuários finais, todo o processo permanece completamente transparente. No log de tarefas do Agentic Browser, os usuários podem ver apenas uma mensagem simples como:
“reCAPTCHA v2 detectado. Resolvido automaticamente em 1,2 segundos.”
Um checkpoint que antes interromperia o fluxo de automação pode ser tratado em segundo plano e registrado no log de tarefas.
Isso melhora a continuidade dos fluxos de trabalho de agentes de IA: o agente pode lidar com checkpoints de verificação suportados em ambientes autorizados, preservando o contexto de página e sessão. A infraestrutura de resolução de CAPTCHA funciona como um “motor invisível” dentro de um fluxo de trabalho delimitado e observável.
Sem um caminho de tratamento controlado, um pop-up de CAPTCHA ainda pode interromper uma tarefa automatizada que, de outra forma, seria válida.
Se os capítulos anteriores fizeram essa tecnologia parecer distante, os exemplos a seguir podem mudar completamente sua perspectiva. Agentic Browsers não são conceitos abstratos pairando no futuro — eles estão entrando rapidamente em três grandes domínios: produtividade pessoal, automação corporativa e coleta de dados. Em cada área, eles estão resolvendo problemas práticos em diferentes níveis.
O diagrama a seguir resume os cenários centrais de aplicação de Agentic Browsers:
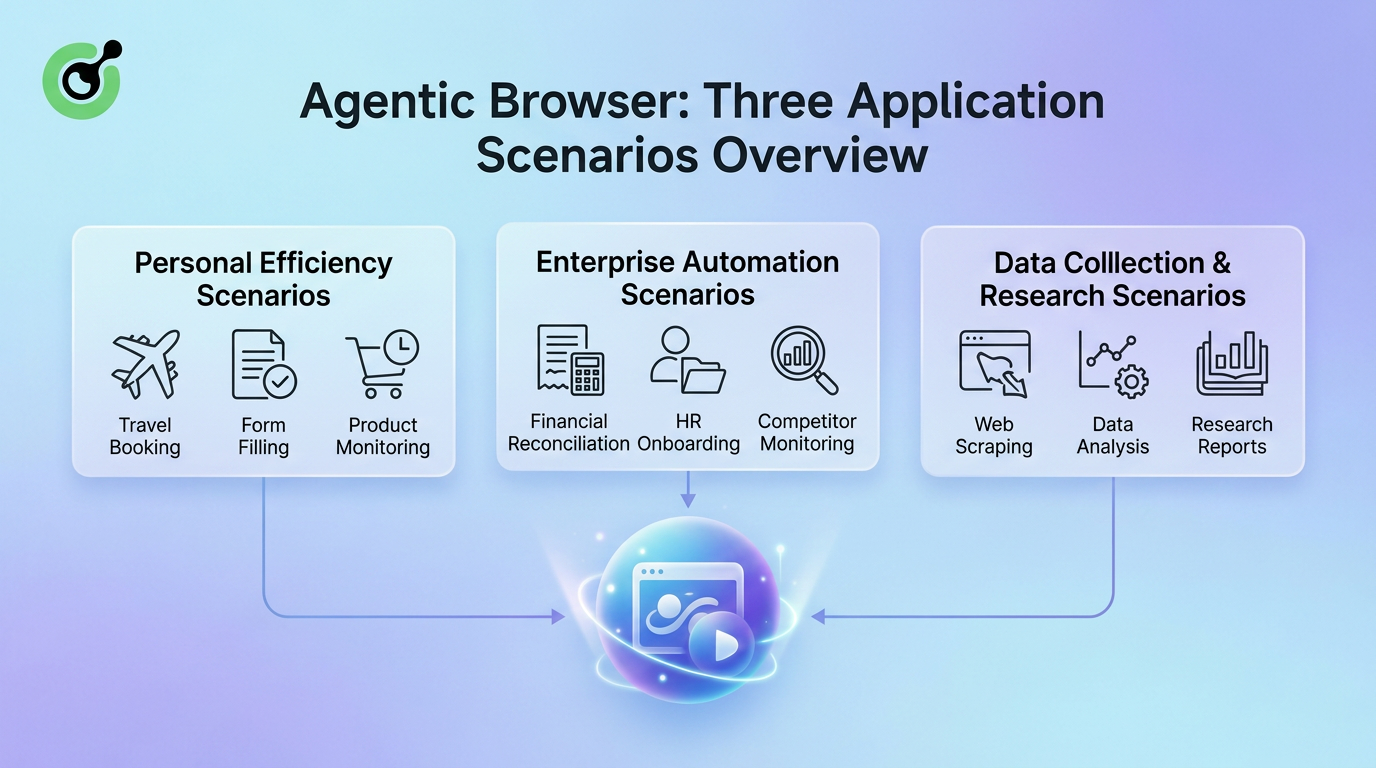
As aplicações de Agentic Browsers vão de usuários individuais a grandes empresas, e de tarefas diárias a fluxos de trabalho de pesquisa profissional. Em produtividade pessoal, eles ajudam usuários a reservar viagens, preencher formulários repetitivos e monitorar flutuações de preços de produtos. Em automação corporativa, lidam com conciliação financeira, onboarding de funcionários e acompanhamento de concorrentes. Em coleta de dados e pesquisa, atuam como crawlers incansáveis e assistentes de análise inteligentes.
A seguir, examinaremos esses três cenários em detalhe para entender como Agentic Browsers realmente “fazem o trabalho acontecer”.
Para usuários comuns, o valor mais imediato de um Agentic Browser é simples: economizar tempo.
Todos os dias, as pessoas executam inúmeras tarefas online repetitivas e de múltiplas etapas dentro de navegadores. Essas tarefas geralmente compartilham três características:
Agentic Browsers são excelentes em assumir exatamente esse tipo de tarefa — situações em que os usuários sabem o que querem que seja feito, mas não querem executar manualmente as operações.
Em cenários de produtividade pessoal, Agentic Browsers podem auxiliar nas seguintes tarefas típicas:
Por exemplo, um Agentic Browser pode comparar opções de voos ou hotéis, filtrar resultados com base em horário, preferências ou orçamento e preparar os detalhes selecionados para o usuário revisar e confirmar.
Tarefas como solicitações de visto, inscrições em escolas ou reembolsos de despesas costumam exigir que os usuários insiram repetidamente as mesmas informações em vários formulários.
Um Agentic Browser atua como um “gerenciador de informações” ao lembrar de forma segura os dados do usuário, identificar automaticamente campos de formulário e mapeá-los de forma inteligente. Por exemplo, ele pode dividir um nome completo em “First Name” e “Last Name” automaticamente.
Agentic Browsers podem monitorar estoque de produtos, alterações de preços ou lançamentos de novos produtos em segundo plano. Quando condições predefinidas são atendidas — como uma queda de preço ou reposição de estoque — o navegador notifica imediatamente o usuário para revisão.
Para ilustrar melhor a transformação na experiência do usuário, a tabela a seguir compara fluxos de trabalho tradicionais com fluxos de trabalho usando Agentic Browser:
| Tipo de Tarefa | Custo de Tempo no Fluxo Tradicional | Fluxo de Trabalho com Agentic Browser | Transformação do Papel do Usuário |
|---|---|---|---|
| Comparar e reservar um voo | 15–30 minutos (navegando manualmente em vários sites) | 1 minuto (descrever requisitos e confirmar recomendações) | De executor → tomador de decisão |
| Preenchimento de formulários online complexos | 20–40 minutos (inserindo repetidamente as mesmas informações) | 2 minutos (revisando resultados de preenchimento automático e corrigindo pequenas diferenças) | De digitador de dados → revisor |
| Monitorar reposição de produtos ou queda de preços | Extremamente demorado (atualização manual e atenção constante) | 0 minutos (monitoramento em segundo plano com notificações automáticas) | De monitor → recebedor |
| Organização de dados entre plataformas | 1–2 horas (copiar e colar, formatar) | 5 minutos (extração e formatação automáticas) | De operador manual → analista |
Tabela 2-1 Comparação Entre Tarefas Pessoais Tradicionais e Eficiência com Agentic Browser
Como mostrado acima, o Agentic Browser atua efetivamente como um assistente pessoal. Ele libera os usuários de serem “operadores de fluxos de trabalho” e os transforma em “definidores de metas” e “revisores de resultados”.
Se as melhorias em produtividade pessoal dizem respeito a “reduzir esforço”, então o valor dos Agentic Browsers em ambientes corporativos diz respeito à conexão.
Grandes organizações costumam depender de diversos sistemas legados desconectados, plataformas SaaS e portais de fornecedores que não podem ser facilmente integrados por meio de APIs. Os funcionários são forçados a se tornar “cola humana”, transferindo informações manualmente entre sistemas repetidas vezes.
É exatamente aqui que os Agentic Browsers demonstram suas maiores vantagens.
Com autorização explícita, um Agentic Browser pode acessar portais financeiros ou de fornecedores controlados pela organização, recuperar registros aprovados, compará-los com os sistemas ERP, gerar relatórios de discrepância e preparar rascunhos de notificações para revisão.
As organizações podem predefinir pacotes de tarefas de onboarding. Dentro de sistemas controlados pela organização e de políticas de acesso aprovadas, o Agentic Browser pode preparar ou concluir etapas autorizadas de provisionamento de contas em sistemas de RH e TI.
Agentic Browsers podem funcionar como sistemas de “radar de mercado” ao visitar páginas públicas que permitem acesso automatizado, identificar mudanças relevantes de informação e armazená-las em bancos de dados estruturados, dentro dos termos aplicáveis e limites de taxa.
Para ilustrar melhor o posicionamento exclusivo dos Agentic Browsers na automação corporativa, a tabela a seguir os compara com operações manuais e integrações tradicionais via API:
| Dimensão | Operações Manuais | Desenvolvimento de Integração via API | Agentic Browser |
|---|---|---|---|
| Sistemas Aplicáveis | Qualquer sistema ao qual um usuário tenha autorização de acesso | Apenas sistemas com APIs abertas | Sistemas baseados na web autorizados, incluindo sistemas legados controlados pela organização |
| Ciclo de Implantação | Nenhum desenvolvimento requerido, porém demorado | Semanas a meses (depende dos recursos de desenvolvimento) | Horas a dias (configuração e teste da tarefa) |
| Flexibilidade | Alta (humanos se adaptam dinamicamente) | Baixa (é necessário reescrever interfaces após mudanças) | Alta (a IA se adapta dinamicamente às mudanças na página) |
| Tratamento de CAPTCHA/Login | Exige tratamento manual | Geralmente difícil de tratar diretamente | Pode acionar soluções de CAPTCHA configuradas dentro de fluxos de trabalho autorizados |
| Escalabilidade | Fraca | Extremamente forte | Forte (execução paralela de tarefas é possível) |
| Cenários Típicos de Falha | Fadiga humana e omissões | Limites de taxa da API ou incompatibilidade de versão | Pode exigir confirmação humana em condições de página extremamente caóticas |
Tabela 2-2 Comparação de Soluções de Automação Corporativa Entre Sistemas
Como mostrado acima, os Agentic Browsers não são projetados para substituir APIs. Em vez disso, fornecem uma camada de integração leve em situações nas quais as APIs não estão disponíveis ou são muito caras de implementar.
Ao aproveitar a flexibilidade e adaptabilidade da IA, os Agentic Browsers preenchem as lacunas deixadas pelas abordagens tradicionais de automação, permitindo que as empresas alcancem coordenação inteligente entre sistemas sem reconstruir a infraestrutura legada.
Dados são frequentemente descritos como o petróleo da era digital, mas coletar de forma eficiente dados públicos limpos da web sempre foi difícil.
Rastreadores tradicionais (crawlers) da web dependem de regras de parsing fixas. Assim que os sites-alvo redesenham seus layouts ou exigem verificações adicionais, esses crawlers podem falhar completamente. A coleta automatizada só deve continuar quando o acesso for autorizado e consistente com os termos aplicáveis do site. Pesquisadores acadêmicos, empresas de pesquisa de mercado e equipes de jornalismo investigativo frequentemente precisam extrair informações específicas de um grande número de páginas públicas, o que torna as abordagens tradicionais caras e demoradas.
Os Agentic Browsers introduzem um paradigma totalmente novo de coleta de dados:
Uma mudança da extração baseada em “regras de código” para a extração baseada em “objetivos semânticos”.
Seu fluxo de trabalho geralmente funciona da seguinte forma:
Pesquisadores descrevem as dimensões de dados necessárias e os intervalos de amostragem usando linguagem natural. Por exemplo:
“Extraia títulos de produtos, preços, avaliações e quantidade de reviews das 100 principais páginas de produtos de e-commerce, excluindo produtos patrocinados.”
O Agentic Browser navega autonomamente pelas páginas, identifica blocos de informação relevantes por meio de percepção do ambiente, extrai e estrutura os dados de forma inteligente e lida com interações complexas, como paginação, rolagem infinita e pop-ups.
Quando os sites-alvo redesenham seus layouts, crawlers tradicionais costumam entrar em colapso imediatamente. Em contraste, os Agentic Browsers tentam realocar a informação visualmente e continuam a execução.
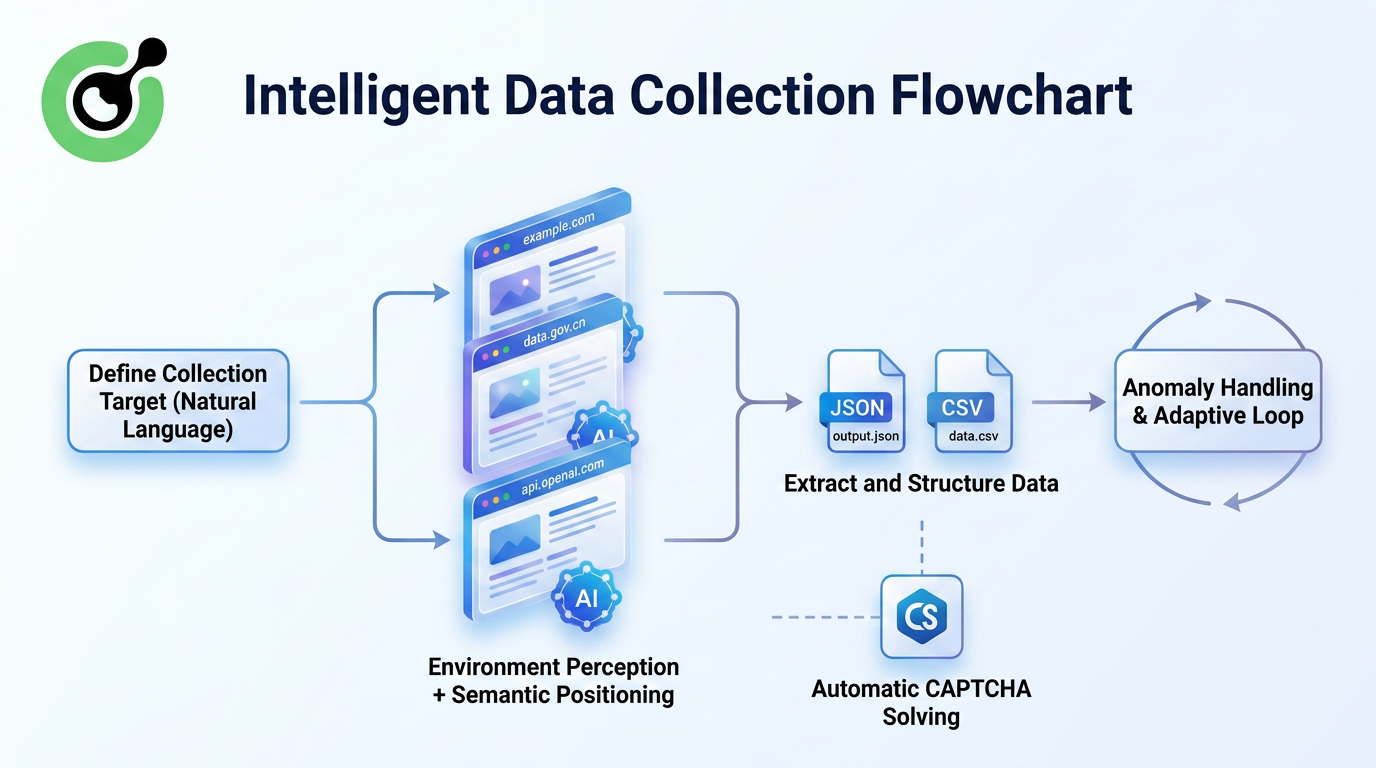
Essa abordagem traz diversas melhorias fundamentais:
A IA entende o que é um “preço” em termos semânticos, em vez de depender de nomes fixos de classes HTML.
Pequenas mudanças de layout não interrompem imediatamente os pipelines de extração.
Para sites autorizados que exigem login, rolagem infinita ou troca de abas, os Agentic Browsers podem usar ações de navegador compatíveis e sessões aprovadas antes de extrair as informações permitidas.
Configurações de tarefas podem ser salvas e compartilhadas, tornando a coleta de dados padronizada e reproduzível.
Para demonstrar melhor as vantagens de resiliência dos Agentic Browsers em tarefas de coleta de dados, a figura a seguir compara crawlers tradicionais e Agentic Browsers após múltiplos redesigns de sites:
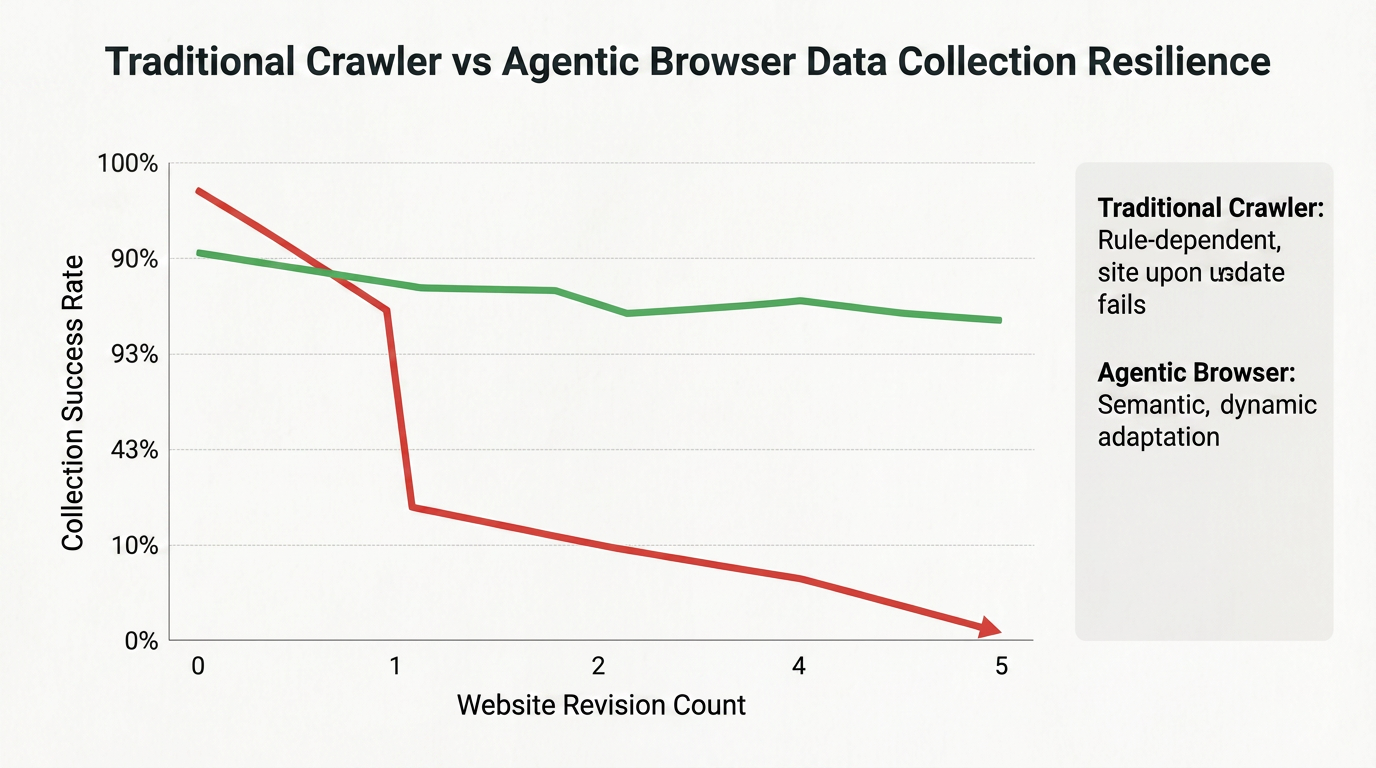
Crawlers tradicionais apresentam quedas drásticas nas taxas de sucesso após o primeiro redesign do site, enquanto Agentic Browsers mantêm taxas de extração relativamente altas mesmo após vários redesigns, graças às suas capacidades de localização visual e compreensão semântica.
Essa resiliência os torna ideais para projetos de coleta de dados em larga escala e de longo prazo.
Por exemplo, imagine uma equipe de pesquisas em ciências sociais que precisa comparar cláusulas de políticas específicas em 200 sites de políticas públicas de 30 países. Tradicionalmente, isso exigiria que assistentes de pesquisa passassem meses copiando e organizando informações manualmente.
Agora, os pesquisadores podem configurar uma tarefa em um Agentic Browser que visite páginas públicas de políticas dentro dos termos aplicáveis e limites de taxa, localize páginas contendo palavras-chave-alvo, extraia as cláusulas relevantes e as categorize automaticamente.
Os pesquisadores só precisam revisar e analisar os resultados coletados depois, permitindo que o esforço humano valioso se concentre em “pesquisa” real em vez de “trabalho manual de transporte” repetitivo.
O Agentic Browser representa não apenas um novo produto, mas toda uma nova filosofia de estar online. Sua lógica central é: o navegador não deve ser apenas uma interface esperando que você clique, mas um agente inteligente que entende sua intenção e ajuda a concluir tarefas. Do ponto de vista de implementação técnica, ele se baseia na capacidade de raciocínio de grandes modelos de linguagem para planejar tarefas, em percepção multimodal para entender páginas da web, em um ambiente de navegador real para executar operações e em infraestruturas como o CapSolver para lidar com checkpoints de verificação compatíveis em automações autorizadas. A fusão dessas tecnologias está atualizando a “janela de informação” que usamos há trinta anos em uma verdadeira “plataforma de ação”.
P1: Por que modelos gerais de IA não conseguem resolver CAPTCHAs sozinhos?
R1: Embora modelos gerais de IA sejam poderosos, CAPTCHAs são projetados especificamente para serem adversariais e mudar constantemente. Resolver esses desafios de forma confiável e rápida exige uma infraestrutura especializada como o CapSolver, dedicada exclusivamente a essa tarefa.
P2: Como o CapSolver ajuda os Agentic Browsers?
R2: O CapSolver atua como um “motor invisível” que lida com desafios de CAPTCHA compatíveis por meio de uma API documentada. Isso permite que um fluxo de trabalho autorizado de Agentic Browser envie o contexto de tarefa necessário, aplique o resultado, verifique o estado da página e continue.
P3: Os Agentic Browsers vão substituir empregos humanos?
R3: Eles são projetados para substituir “tarefas”, não “empregos”. Ao lidar com trabalho digital repetitivo, liberam as pessoas para focar em criatividade de nível mais alto e tomada de decisão estratégica.
P4: Como posso começar a usar um Agentic Browser hoje?
R4: Muitos navegadores e extensões experimentais já estão disponíveis. Para a melhor experiência, use um serviço confiável de resolução de CAPTCHA como o CapSolver apenas para checkpoints compatíveis em sistemas que você possui ou está autorizado a automatizar.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Corrija o tratamento de CAPTCHA que funciona localmente, mas falha em um agente de IA na nuvem. Compare a configuração do navegador, dependências, credenciais, acesso à rede e o estado da página.
Configure o CapSolver MCP no Claude Code, verifique as ferramentas CAPTCHA disponíveis e escolha token ou resolução de página para uma tarefa de navegador suportada e autorizada.