

🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Nov 13, 2026
Atualizado Nov 13, 2026 · minutos de leitura
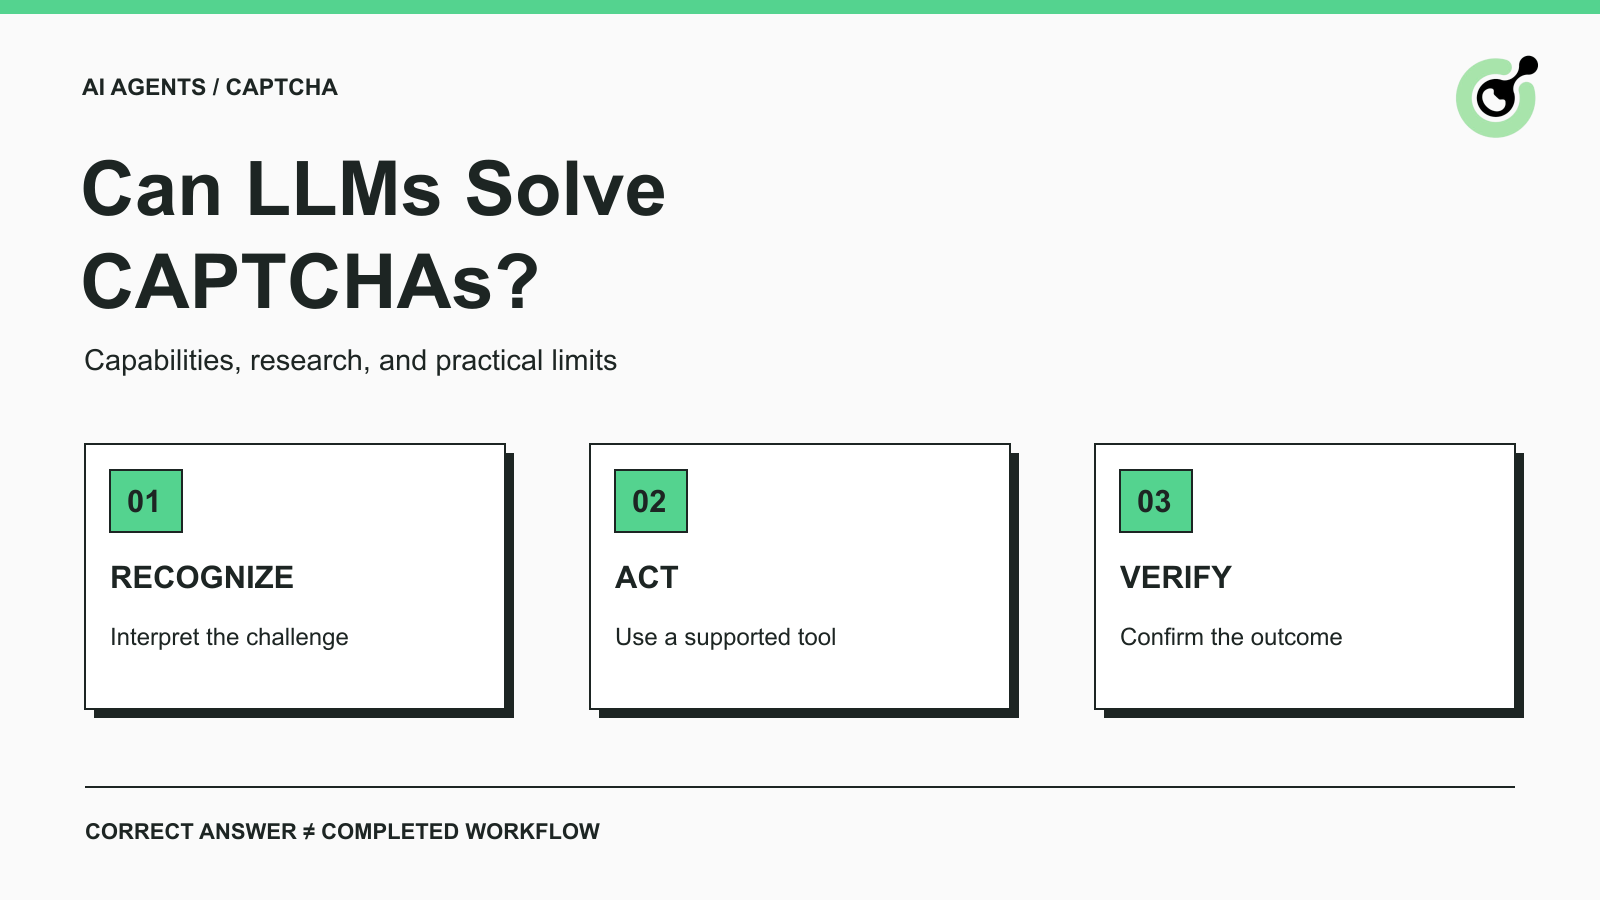
Uma captura de tela mostrando um objeto corretamente identificado é uma evidência útil sobre a capacidade de visão de um modelo. Ela deixa outra pergunta sem resposta: o aplicativo aceitou a verificação e concluiu a operação solicitada? Essa distinção é importante ao avaliar um solucionador de CAPTCHA com LLM para agentes de navegador, QA ou coleta de dados permitida.
Este guia explica o que o termo significa, o que a pesquisa demonstra e quais verificações pertencem a uma avaliação. Ele também mostra onde um serviço como o CapSolver se encaixa. O foco é capacidade e seleção de produto, e não prompts para atacar um site específico ou a alegação de que todo agente de IA consegue resolver todo desafio.
Um solucionador de CAPTCHA com LLM usa um modelo de linguagem, geralmente com compreensão de imagens, para interpretar uma tarefa de CAPTCHA ou ajudar a coordenar sua conclusão. A expressão abrange vários sistemas diferentes, então pergunte o que o produto realmente aceita e retorna.
Um sistema pode aceitar uma imagem e produzir uma resposta em texto. Outro pode retornar uma posição de clique proposta. Um agente de navegador pode chamar um serviço de resolução separado e então continuar uma tarefa depois que código confiável do aplicativo verifica o resultado. Esses sistemas exigem métodos de avaliação diferentes.
O verbete de glossário sobre LLM explica a categoria de modelo subjacente. Adicionar um navegador ou uma ferramenta de solução confere capacidades adicionais ao modelo; isso não faz com que todo resultado de ferramenta seja resultado do raciocínio visual próprio do modelo.
Reconhecimento pergunta se um modelo interpreta corretamente a entrada do desafio. Orquestração pergunta se um agente seleciona e usa uma ferramenta apropriada no ponto certo de um fluxo de trabalho.
Um agente que delega um CAPTCHA a uma API pode ser útil sem resolver a imagem em si. Por outro lado, um modelo que rotula uma imagem corretamente ainda pode não ter os controles de navegador, entradas de tarefa ou resposta aceita necessários para concluir uma operação na web. Avalie o papel de que seu aplicativo realmente precisa.
Pesquisas publicadas mostram que o desempenho varia entre tipos de desafio e designs de sistema. Elas sustentam uma resposta condicional à pergunta “LLMs conseguem resolver CAPTCHAs?”
O artigo de pesquisa Oedipus examina CAPTCHAs de raciocínio e relata dificuldades ao usar capacidades de LLM diretamente. Seu framework proposto adiciona decomposição de tarefa e uma representação específica de domínio. Um resultado do framework inclui, portanto, o sistema ao redor, e não apenas um modelo desacompanhado.
O estudo COGNITION avalia modelos multimodais em vários tipos de tarefa de CAPTCHA. Suas descobertas relatadas distinguem tarefas de reconhecimento com baixa interação de tarefas mais difíceis de localização, raciocínio espacial e entre quadros. O artigo também considera novas tentativas, latência e custo, e não apenas acurácia.
Esses estudos não fornecem uma taxa de sucesso transferível para todo serviço, navegador ou implantação em produção. Ao ler um resultado, mantenha o modelo avaliado, o conjunto de tarefas, a permissão para repetição e o ponto de medição associados à alegação. Apenas um nome de modelo mais recente não é evidência de que o mesmo resultado se mantém.
Uma descrição útil de benchmark informa se sucesso significou um rótulo correto, uma sequência aceita de interações, uma resposta válida do servidor ou a conclusão do trabalho original do aplicativo.
Para uma equipe de QA autorizada, um benchmark de imagem–resposta pode ajudar a escolher um componente de reconhecimento. Uma equipe de agente de navegador precisa de evidências adicionais sobre interação com a página e conclusão do aplicativo. Nenhuma das equipes deve substituir silenciosamente uma medição pela outra.
Verifique também se tentativas com falha ou expiradas permanecem no denominador. Relatar apenas saídas bem-sucedidas esconde o trabalho que um operador teria de investigar.
Uma resposta visual correta pode ser insuficiente porque um aplicativo pode exigir uma resposta de verificação válida e suas próprias verificações de aceitação. O enigma visível é apenas a parte que uma captura de tela expõe.
Por exemplo, a documentação de verificação de resposta do Google descreve um token de resposta que o backend do aplicativo verifica. Ela documenta um período de validade de dois minutos e uso único. Uma descrição gerada por modelo de uma imagem não é essa resposta de verificação.
De forma semelhante, o guia de validação do Turnstile da Cloudflare exige validação de token no servidor e descreve uma vida útil de cinco minutos com tokens de uso único. O Turnstile não deve ser avaliado como se fosse simplesmente uma tarefa de rotulagem de imagens.
Esses exemplos estabelecem por que o ponto de avaliação importa. Eles não implicam que um solucionador garanta acesso ao aplicativo. O site ainda controla sua lógica de aplicação e decisões de acesso.
Ao testar seu próprio aplicativo, inspecione o resultado da validação do lado do servidor e o estado final do aplicativo. Ao trabalhar com um fluxo de trabalho de terceiros permitido, use o resultado observável documentado disponível para você.
Se o resultado de backend estiver indisponível, rotule-o como desconhecido. Um botão alterado, um widget fechado ou uma resposta de API devolvida podem ser sinais úteis, mas nenhum deve se tornar silenciosamente “servidor aceitou” em um relatório.
Resgate Seu Código de Bônus CapSolver
Aumente imediatamente o seu orçamento de automação!
Use o código de bônus CAP26 ao recarregar sua conta CapSolver para obter 5% de bônus extra em cada recarga — sem limites.
Resgate agora no seu Painel CapSolver
Um solucionador de CAPTCHA dedicado lida com uma tarefa de verificação compatível dentro de um fluxo de trabalho autorizado maior. O agente permanece responsável pelo objetivo original e o aplicativo permanece responsável por verificar o resultado.
A documentação do CapSolver Agent Tools descreve uma divisão entre decisões do modelo, um adaptador de ferramenta e a camada de execução Core. Isso oferece às equipes uma rota de integração documentada sem exigir que um modelo de linguagem deduza o protocolo de solução a partir de uma captura de tela.
Uma avaliação prática deve seguir esta sequência:
Isto é uma lista de responsabilidades, não código de integração executável. Use o exemplo oficial para o framework escolhido e verifique-o em seu ambiente antes da implantação.
O modelo geralmente precisa de uma explicação do resultado, como concluído, ainda pendente ou parado para revisão. Ele não precisa do conteúdo completo de cookies do navegador, credenciais de serviço ou todas as respostas brutas.
Isso torna a solução de problemas mais clara. Registre separadamente o desafio observado, a operação selecionada e o estado final. Se uma chamada de ferramenta nunca começou, investigue a seleção de ferramenta. Se o solucionador retornou um resultado mas o aplicativo o rejeitou, investigue essa etapa posterior.
Para a questão de implementação separada de escolher entrada por captura de tela ou uma API de token, veja manuseio de CAPTCHA para agentes de uso de computador. Essa decisão depende do que o ambiente de execução consegue observar e executar.
Avalie um solucionador de CAPTCHA com LLM em um pequeno conjunto de tarefas autorizadas com condições explícitas de aceitação. O objetivo é testar o papel de que você precisa, e não fabricar um ranking universal.
Anote o tipo de entrada, ações permitidas, família de desafio compatível, orçamento de repetição e estado final esperado antes de comparar sistemas. Mantenha falhas comuns de navegador separadas de falhas de desafio. Caso contrário, um carregamento lento de página pode distorcer o resultado aparente de solução.
Relate a contagem de resultados, o tempo decorrido, as tentativas consumidas e o custo para a unidade completa avaliada. Se a unidade for um trabalho de agente, inclua trabalhos com falha e chamadas pagas repetidas. Se for uma tarefa de imagem, diga isso diretamente.
Um relatório de avaliação útil também preserva casos negativos. Inclua um desafio não compatível, uma entrada obrigatória ausente e um resultado que chega depois que o trabalho terminou. O comportamento desejado nesses casos pode ser uma parada clara em vez de outra tentativa.
Não interprete a declaração de confiança de um modelo como uma probabilidade medida de aceitação. Use um resultado observado a partir do aplicativo ou do ambiente de teste. Mantenha o ambiente de teste limitado a sistemas e dados que você está autorizado a testar.
Um teste pequeno pode mostrar que uma integração se comporta como pretendido nos casos inspecionados. Ele não pode justificar alegações como “melhor para todos os agentes” ou “funciona em todos os sites”. Mantenha o relatório de teste anexado à decisão de compra para que outra equipe possa ver seus limites.
Quando os requisitos mudarem, repita os casos relevantes. Alterar o modelo, o ambiente de navegador, o tipo de tarefa do solucionador ou o aplicativo alvo pode mudar o que sua evidência anterior estabelece. Uma declaração de compatibilidade precisa é mais útil do que uma promessa irrestrita.
Escolha um modelo de reconhecimento quando o requisito for uma tarefa delimitada de compreensão de imagem que você possa avaliar diretamente. Escolha uma integração de solução documentada quando um aplicativo autorizado precisar de um resultado de CAPTCHA compatível. Use um agente quando o trabalho em torno se beneficiar de planejamento e seleção de ferramentas.
O CapSolver pode fornecer a etapa de solução documentada. Confirme o tipo de tarefa atualmente compatível, teste o fluxo de trabalho autorizado completo e trate a aceitação do aplicativo como um resultado separado.
Comece com o guia oficial de primeiros passos em CAPTCHA e escolha a capacidade que corresponda ao seu desafio real. Mantenha o primeiro teste pequeno o suficiente para inspecionar cada resultado antes de ampliar o uso.
P: LLMs conseguem resolver CAPTCHAs?
LLMs com capacidades visuais adequadas podem resolver algumas tarefas de CAPTCHA avaliadas. Os resultados dependem do desafio, do modelo, do sistema ao redor e da definição de sucesso. Uma resposta visual correta não prova automaticamente uma verificação bem-sucedida no site.
P: Um solucionador de CAPTCHA com LLM é o mesmo que uma API de CAPTCHA?
Não. Um LLM é um componente de modelo; uma API de CAPTCHA expõe uma operação de serviço documentada. Um agente pode chamar essa API sem realizar o reconhecimento de imagem subjacente por conta própria.
P: Um LLM apenas de texto pode resolver um CAPTCHA de imagem?
Um LLM apenas de texto não pode inspecionar a imagem diretamente. Ele precisa de um componente separado com capacidade de imagem ou outra fonte de informação visual, e o sistema completo ainda precisa ser avaliado.
P: Um agente deve continuar tentando até que um CAPTCHA seja aprovado?
Não. Defina um orçamento explícito de tentativas e tempo e então pare ou solicite revisão quando o orçamento se esgotar. Tentativas repetidas não devem ocultar entradas não compatíveis ou uma rejeição do aplicativo.
P: Um benchmark de pesquisa prova que um solucionador funcionará no meu site?
Não. Um benchmark descreve suas tarefas e condições avaliadas. Valide a capacidade necessária em seu ambiente autorizado e distinga resultados de reconhecimento de conclusão de aplicativo.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Decida quais entradas de CAPTCHA seu agente de uso de computador pode realmente fornecer e quando alternar para inspeção no navegador ou solicitar entrada humana.
Lidar o cancelamento de CAPTCHA MCP em agentes de IA. Interrompa novas chamadas, distinga tarefas remotas de esperas locais e impeça que resultados atrasados reiniciem o trabalho.
