🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Oct 29, 2026
Atualizado Oct 29, 2026 · minutos de leitura
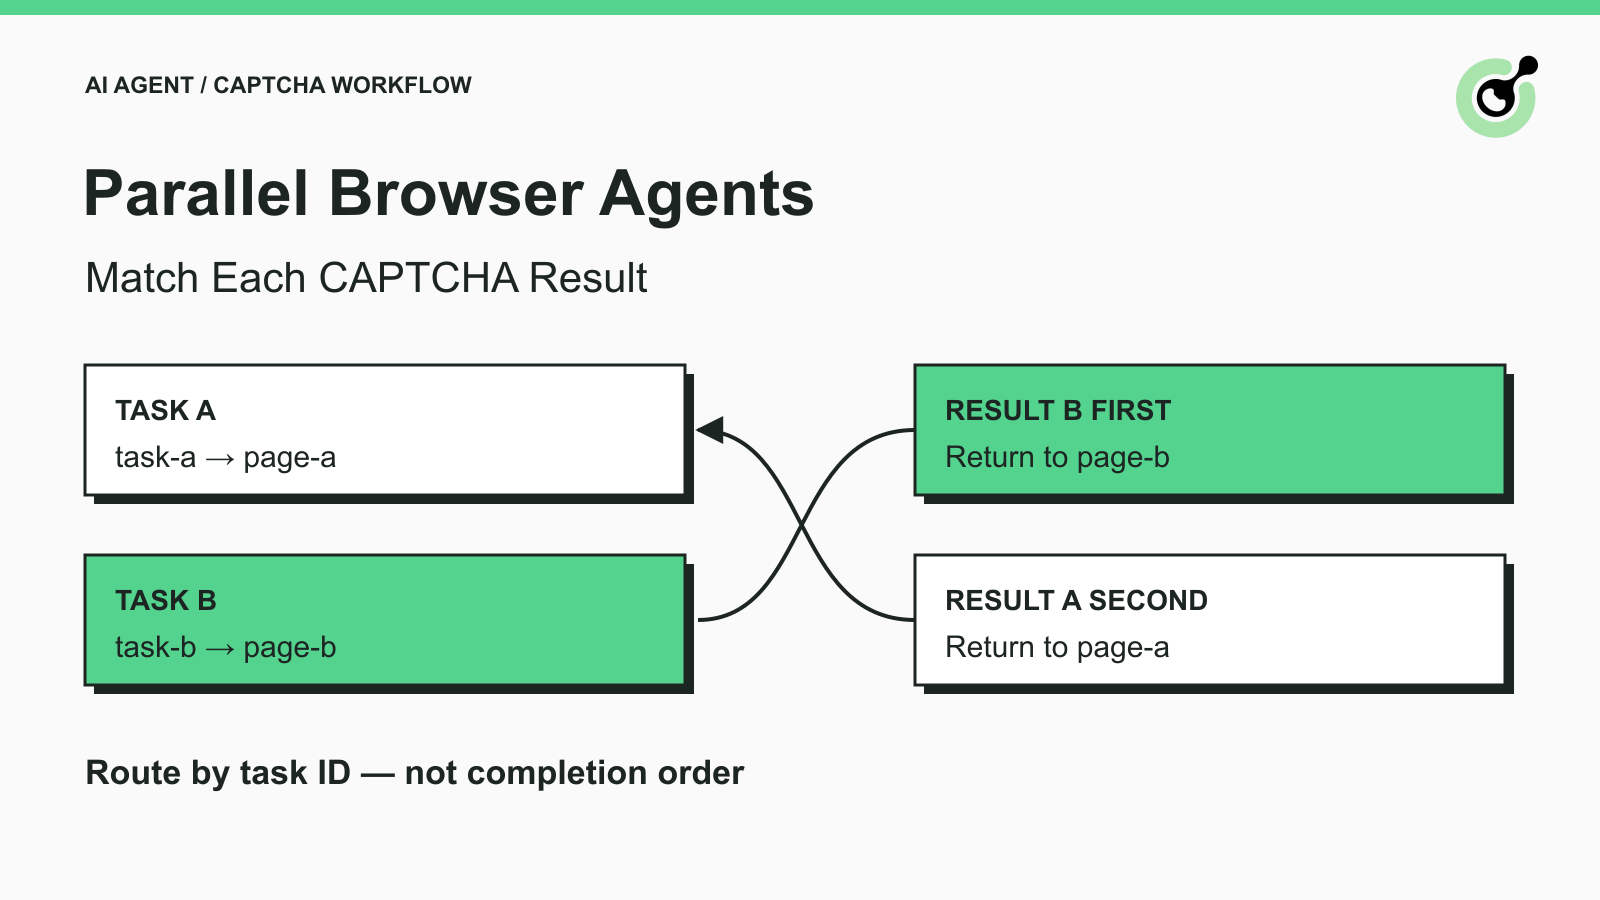
Dois agentes de navegador encontram CAPTCHAs suportados durante tarefas separadas e autorizadas. O Agente A começa primeiro, mas o Agente B recebe um resultado primeiro. Se a aplicação simplesmente atribuir o próximo resultado à primeira aba em espera, ambos os jobs podem ser afetados, apesar de cada solicitação ao solver ter sido válida.
Este é um problema de correlação de tarefas. Mais tentativas não vão corrigir um resultado entregue à página errada. A aplicação precisa se lembrar qual item de trabalho do navegador criou cada tarefa do solver e se esse item de trabalho ainda é atual quando a resposta chega.
A CapSolver retorna identificadores de tarefa para trabalho de API assíncrono. Este guia explica como preservar essa associação entre agentes paralelos, com um pequeno exemplo local que você pode executar antes de conectar um solver real. Ele não reivindica um benchmark de concorrência nem sucesso de CAPTCHA em produção.
Um agente de navegador deve manter o job da aplicação, o proprietário da página e o ID da tarefa do solver associados a uma tentativa.
A API createTask retorna um taskId para uma tarefa assíncrona. Salve-o quando a resposta de criação for aceita. A API getTaskResult recebe esse identificador para recuperar o resultado correspondente.
Sua aplicação também precisa do próprio identificador de item de trabalho e de uma referência ao proprietário do navegador. Esses são campos da aplicação, não parâmetros adicionais da requisição à CapSolver. Um rótulo de página como page-a no exemplo identifica o worker que é dono da página; não é um handle de navegador reutilizável nem uma credencial de API.
Adicione uma pequena versão da tentativa, chamada de epoch abaixo. Incremente-a quando uma nova navegação ou tentativa de desafio tornar inadequado um resultado pendente anterior. Uma URL sozinha é insuficiente: dois jobs podem visitar a mesma URL, e uma página pode carregar um estado diferente sem alterar seu endereço.
A documentação de browser-context do Playwright explica o estado isolado do navegador. Isolamento de contexto e correlação de tarefas resolvem problemas diferentes. Cookies separados não roteiam automaticamente resultados do solver para o worker correto.
A ordem de conclusão descreve quando os resultados chegam, não qual job de navegador é dono deles.
A documentação do Python para asyncio.as_completed descreve o processamento de “awaitables” conforme elas terminam. Se a orquestração usa callbacks baseados em ordem de conclusão, cada resultado precisa carregar sua própria associação em vez de depender de uma posição em uma lista de páginas em espera.
Trate a criação da tarefa e a vinculação como uma única passagem local: valide a resposta de criação, armazene o ID retornado com seu item de trabalho e, então, permita a recuperação do resultado. Uma implementação baseada em callback precisa de um plano equivalente para resultados que chegam antes de sua vinculação local ficar visível. Não descarte essa condição de corrida como uma “página desconhecida” e crie imediatamente outra tarefa paga.
A interface de fila do Python pode ajudar a passar um item de trabalho completo entre workers locais. A fila não substitui o mapeamento: leve o identificador com o resultado até o proprietário da página.
Aceite um resultado para entrega apenas quando o ID da tarefa for conhecido e a tentativa registrada ainda pertencer à página ativa.
Use um único proprietário para atualizar esse estado em uma aplicação pequena. Em um serviço distribuído, use armazenamento durável e uma “claim” atômica ou controle de concorrência equivalente. Um dicionário Python compartilhado informalmente entre processos não pode fornecer essa garantia.
O exemplo abaixo é um fixture local de roteamento, não um método oficial de SDK nem uma integração completa de solver. Ele usa IDs de tarefa inventados e um fixture_marker, que não é um token de CAPTCHA nem um campo de solução da CapSolver. Execute-o com Python 3; ele não requer pacotes de terceiros, chave de API, navegador ou requisição de rede.
def accept_result(reply, pending, current_epochs):
    task_id = reply.get('taskId')
    if not isinstance(task_id, str) or type(reply.get('errorId')) is not int:
        return 'malformed_reply', None
    job = pending.get(task_id)
    if job is None:
        return 'unknown_or_duplicate', None
    if current_epochs.get(job['page_id']) != job['epoch']:
        pending.pop(task_id)
        return 'stale_page', None
    if reply.get('errorId', 0) != 0:
        pending.pop(task_id)
        return 'solver_error', None
    if reply.get('status') != 'ready':
        return 'pending', None
    if not reply.get('solution'):
        pending.pop(task_id)
        return 'missing_solution', None
    pending.pop(task_id)
    return 'ready_for_owner', (job['page_id'], reply['solution'])

pending = {
    'fixture-task-a': {'page_id': 'page-a', 'epoch': 1},
    'fixture-task-b': {'page_id': 'page-b', 'epoch': 1},
}
epochs = {'page-a': 1, 'page-b': 1}
for task_id in ['fixture-task-b', 'fixture-task-a']:
    reply = {'taskId': task_id, 'errorId': 0, 'status': 'ready',
             'solution': {'fixture_marker': task_id}}
    state, target = accept_result(reply, pending, epochs)
    print(task_id, state, target[0] if target else None)
O exemplo imprime estas duas linhas:
fixture-task-b ready_for_owner page-b
fixture-task-a ready_for_owner page-a
A Tarefa B termina primeiro e ainda assim retorna para a página B. A função deliberadamente entrega o resultado ao proprietário sem preencher ou submeter uma página. Substitua o fixture somente depois de ter um parser de resultado específico de tarefa, documentado, e uma operação de navegador suportada.
Para um worker que faz polling, mantenha o ID da tarefa usado na requisição como parte do item de trabalho local. Se a resposta incluir um ID de tarefa, verifique se ele corresponde; não use um ID de resposta não confiável ou divergente para re-rotular a requisição. O fixture assume que essa associação já foi validada antes de accept_result ser chamado.
Resgate Seu Código de Bônus CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta CapSolver para receber 5% de bônus extra em cada recarga — sem limites.
Resgate agora em seu Dashboard CapSolver
Resultados atrasados ou repetidos devem produzir um estado explícito em vez de serem aplicados à aba que estiver ativa no momento.
Marque a tentativa antiga como obsoleta quando sua página for fechada, navegar ou iniciar um desafio de substituição. O fixture compara o epoch armazenado com current_epochs; remover uma página fechada também faz essa checagem falhar. Não transfira um resultado antigo para uma nova tentativa apenas porque o hostname coincide.
Seu proprietário de página deve verificar a tentativa mais uma vez imediatamente antes de usar um resultado entregue. A verificação do fixture e uma ação posterior do navegador são operações separadas. Manter a navegação da página e a aplicação do resultado sob o mesmo proprietário impede que outro worker altere a página entre elas.
Mantenha a vinculação da tarefa existente enquanto o solver reportar um estado não terminal. Siga as orientações atuais de polling da tarefa e o prazo do seu job. Criar uma tarefa de substituição toda vez que um resultado não está pronto pode multiplicar o trabalho pendente sem resolver a requisição original.
Registre a falha no item de trabalho correspondente. O fixture separa erros do solver, envelopes malformados e soluções ausentes. Um parser de produção deve, além disso, validar os campos exatos da solução para o tipo de tarefa escolhido; um dicionário não vazio não basta para comprovar um token utilizável.
Considere a entrega feita uma única vez. O fixture local remove uma vinculação pronta, de modo que uma repetição é classificada como desconhecida ou duplicada. Workers de produção precisam de registros terminais duráveis e uma política de confirmação se a entrega ou a execução no navegador puder falhar. Não use este exemplo em memória como uma fila distribuída com entrega exatamente uma vez.
Verifique a propriedade correta e o comportamento de rejeição antes de tirar conclusões sobre throughput.
As checagens locais exercitaram ordem de conclusão invertida, uma tarefa em andamento, um ID desconhecido, uma tentativa alterada, uma página fechada, uma resposta de erro, uma solução vazia, um envelope malformado e uma entrega duplicada. Essas checagens passaram para a função publicada. Elas não testaram solução real de CAPTCHA, preenchimento de página pelo navegador nem aceitação pela aplicação.
Para um teste autorizado de ponta a ponta, adicione as chamadas reais de criação e recuperação de tarefa, mantenha resultados sensíveis no worker do navegador e confirme o resultado pretendido da aplicação após a etapa de solução documentada. Se a página ainda mostrar um desafio ou se o registro esperado estiver ausente, registre esse resultado separadamente do estado “pronto” do solver.
Mantenha logs úteis sem copiar tokens brutos, cookies ou chaves de API. Armazene IDs de itens de trabalho, IDs de tarefa, nomes de estágio e informações de erro sanitizadas. O guia de timeout de API existente aborda o comportamento de espera; a preocupação deste artigo é qual job recebe o resultado final. O glossário de concorrências fornece contexto sobre trabalho simultâneo sem implicar promessa de desempenho.
Mantenha cada solução suportada vinculada ao item de trabalho que a solicitou. A CapSolver fornece o resultado do solver; sua aplicação roteia esse resultado, verifica se a tentativa ainda é atual e valida a tarefa do navegador. Essa separação permite que agentes paralelos permaneçam independentes quando os resultados chegam fora de ordem.
P: Dois agentes de navegador podem compartilhar uma única variável de tarefa pendente?
Uma única variável mutável é insegura se trabalho posterior sobrescrever a associação anterior. Armazene uma vinculação separada para cada tarefa ativa do solver e seu proprietário de página.
P: A URL da página é suficiente para identificar o destino?
Não. Abas diferentes podem compartilhar uma URL, e uma página pode mudar de estado no mesmo endereço. Mantenha a identidade do item de trabalho e uma versão atual da tentativa.
P: Posso reutilizar um resultado pronto após a página navegar?
Não presuma que ele continua aplicável. Trate a tentativa antiga como obsoleta e inspecione a nova página antes de decidir sobre qualquer nova solução permitida.
P: Este exemplo resolve ou submete um CAPTCHA real?
Não. Ele testa o roteamento local com identificadores inventados e resultados inertes. Solução paga e aceitação pela aplicação exigem testes de integração separados.
P: O exemplo com dicionário é seguro entre workers distribuídos?
Não. Ele assume um único proprietário em um único processo. Execução distribuída precisa de estado de tarefa durável, “claims” de entrega atômicas e uma política de tratamento de falhas.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Leia corretamente os resultados da ferramenta de CAPTCHA: distinga erros de transporte, tarefas pendentes, saída do solucionador e sucesso no navegador antes de permitir que um agente de IA continue.
Escolha uma API de CAPTCHA ou MCP para o seu agente de IA comparando o controle de tarefas, a descoberta de ferramentas, o tratamento de resultados e as responsabilidades do navegador antes de integrar.