

🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Nov 13, 2026
更新されました Nov 13, 2026 · 最小読み取り
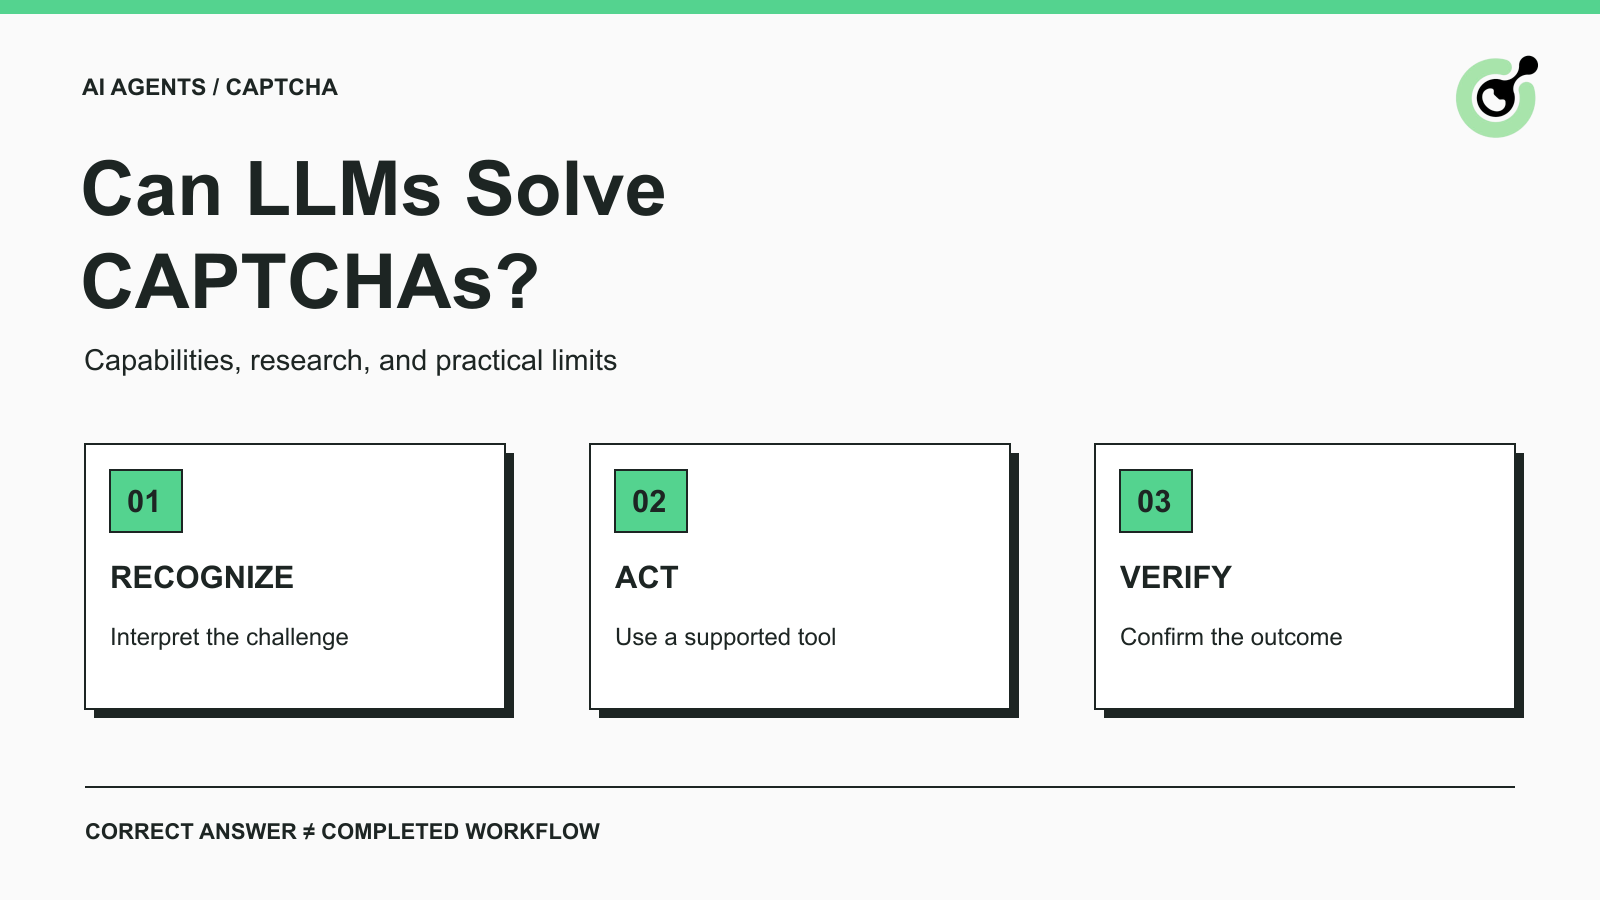
正しく物体を特定したスクリーンショットは、モデルの画像認識能力に関する有用な証拠となる。しかし、もう1つの重要な問いが残る――アプリケーションは検証を受け入れ、要求された操作を完了したのか。LLM CAPTCHAソルバーをブラウザエージェント、QA、許可されたデータ収集の用途で評価する場合、この区別が重要になる。
本ガイドでは、用語の意味、研究で示されている内容、評価に含めるべきチェック項目について説明する。また、CapSolverのようなサービスがどこに位置付けられるかも示す。焦点は、特定サイトへの攻撃用プロンプトや「すべてのAIエージェントがすべてのチャレンジを解ける」といった主張ではなく、能力とプロダクト選定にある。
LLM CAPTCHAソルバーとは、通常は画像理解機能を備えた言語モデルを用いて、CAPTCHAタスクを解釈したり、その完了を調整したりする仕組みを指す。実際にはいくつか異なるタイプのシステムが含まれるため、その製品が何を入力として受け取り、何を出力するのかを確認する必要がある。
あるシステムは画像を受け取り、テキストによる回答を返すかもしれない。別のシステムはクリック位置の候補を返すかもしれない。ブラウザエージェントは、別のソルバーサービスを呼び出し、その結果を信頼できるアプリケーションコードが検証したあとでタスクを継続することもある。これらのシステムは、それぞれ異なる評価方法を必要とする。
LLM用語集の項目では、その基盤となるモデルカテゴリについて説明している。ブラウザやソルバーツールを追加すると、モデルは新たな能力を得るが、だからといってすべてのツール結果がモデル単体の視覚的推論の産物になるわけではない。
認識とは、モデルがチャレンジ入力を正しく解釈できるかどうかを問うものである。オーケストレーションとは、エージェントがワークフローの適切なタイミングで適切なツールを選択・利用できるかを問うものである。
エージェントがCAPTCHAをAPIに委譲できるのであれば、自身が画像を解かなくても有用な場合がある。逆に、画像を正しくラベル付けできるモデルであっても、ブラウザ操作、タスク入力、受け入れられるレスポンスといった要素を欠いていれば、Web上の処理は完了できない。自分のアプリケーションに実際に必要な役割を評価すること。
公開されている研究は、チャレンジの種類やシステム設計によって性能が変わることを示している。「LLMはCAPTCHAを解けるのか?」という問いに対して条件付きの答えを支持している。
Oedipus論文は推論型CAPTCHAを調査し、LLMの能力をそのまま利用した場合に問題が多いと報告している。同論文で提案されているフレームワークは、タスクの分解とドメイン固有の表現を追加するものだ。したがって、フレームワークの結果には、モデル単体ではなくその周囲のシステムが含まれる。
COGNITION研究は、複数のCAPTCHAタスクタイプにわたりマルチモーダルモデルを評価している。その報告は、認識に特化した低インタラクションのタスクと、より困難なローカライゼーション、空間推論、複数フレームにまたがるタスクとを区別している。また、精度だけでなく、リトライ回数、レイテンシ、コストも考慮している。
これらの研究は、あらゆるサービス、ブラウザ、運用環境にそのまま適用できる成功率を与えるものではない。結果を読む際には、評価対象のモデル、タスクコレクション、リトライ許可、測定の終点を、主張とセットにして把握しておくこと。新しいモデル名だけでは、同じ結果が成り立つ証拠にはならない。
有用なベンチマークの説明は、「成功」とは正しいラベルを意味するのか、正しいインタラクションのシーケンスなのか、有効なサーバーレスポンスなのか、あるいはアプリケーション本来のジョブの完了なのかを明示している。
認可されたQAチームにとっては、画像回答ベンチマークが認識コンポーネント選定の手がかりになる。ブラウザエージェントを担当するチームには、ページ操作やアプリケーション完了に関する追加の証拠が必要になる。どちらのチームも、片方の測定項目をもう一方にこっそり置き換えるべきではない。
また、失敗やタイムアウトした試行が分母に含まれているかどうかも確認すること。成功出力だけを報告すると、オペレーターが調査しなければならない実際の作業量が隠れてしまう。
正しい画像回答が不十分になり得るのは、アプリケーション側が有効な検証レスポンスと独自の受け入れチェックを要求することがあるためだ。表示されているパズルは、スクリーンショットに映る一部にすぎない。
たとえば、Googleのレスポンス検証ドキュメントでは、アプリケーションのバックエンドが検証するレスポンストークンについて説明している。同ドキュメントには、有効期限が2分で単回使用であることが記載されている。画像に対するモデル生成の説明は、この検証レスポンスとは別物である。
同様に、Cloudflare Turnstileのバリデーションガイドも、サーバーサイドでのトークン検証を要求し、有効期限5分かつ単回使用であることを説明している。Turnstileを単なる画像ラベリングタスクとして評価してはならない。
これらの例は、評価の終点が重要である理由を示すものであり、「ソルバーがアプリケーションへのアクセスを保証する」という意味ではない。サイト側は依然としてアプリケーションロジックとアクセス判断をコントロールしている。
自分のアプリケーションをテストする場合は、サーバーサイドの検証結果と最終的なアプリケーション状態を確認する。許可された第三者ワークフローで作業する場合は、自分が利用できる、ドキュメント化された観測可能な結果を使う。
バックエンドの結果が取得できない場合は「不明」とラベリングする。ボタンの状態が変わった、ウィジェットが閉じた、APIレスポンスが返ってきたといったサインは有用ではあるが、レポートのなかで黙って「サーバーが受け入れた」に置き換えるべきではない。
CapSolver ボーナスコードを利用しよう
自動化用の予算を今すぐ増強!
入金時にボーナスコード CAP26 を入力すると、チャージ額の 5% 追加ボーナス を無制限で獲得できます。
今すぐ CapSolverダッシュボード で引き換えましょう。
専用CAPTCHAソルバーは、より大きな認可済みワークフローの中で、対応している検証タスクを処理する。エージェントは元々の目的に責任を持ち、アプリケーションは結果のチェックに責任を持つ。
CapSolver Agent Toolsのドキュメントでは、モデルの意思決定、ツールアダプター、Core実行レイヤーの分担について説明している。これにより、言語モデルにスクリーンショットからソルビングプロトコルを推測させることなく、チームは文書化された統合ルートを得られる。
実践的な評価は、次の手順に従うべきである。
これは責任分担のチェックリストであり、実行可能な統合コードではない。選択したフレームワーク用の公式サンプルを使用し、本番展開前に自分の環境で検証すること。
モデルが通常必要とするのは、「完了」「保留中」「レビュー停止」など、結果に関する説明である。ブラウザのクッキー全体、サービスの認証情報、すべての生レスポンスといった情報までは必要ない。
このほうがトラブルシューティングが明確になる。観測されたチャレンジ、選択された操作、最終状態を別々に記録する。ツール呼び出しがまったく始まらなかったなら、ツール選択を調査する。ソルバーが結果を返したのにアプリケーションがそれを拒否した場合は、その後段階を調査する。
スクリーンショット入力とトークンAPIのどちらを選ぶかという、別の実装上の論点については、コンピュータ利用エージェントのためのCAPTCHA処理を参照。どちらを選ぶかは、ランタイムが何を観測・実行できるかに依存する。
LLM CAPTCHAソルバーは、小規模かつ認可されたタスクセットに対し、明確な合格条件を定めて評価するべきである。目的は「万能ランキング」を作ることではなく、自分が必要とする役割をテストすることにある。
比較を行う前に、入力タイプ、許可されたアクション、対応チャレンジの種類、リトライ予算、期待される最終状態を書き出す。通常のブラウザ失敗とチャレンジ失敗は分けておく。そうしないと、ページ読み込みの遅さがCAPTCHAソルブ結果をゆがめてしまう。
評価対象となる単位ごとに、アウトカム件数、経過時間、消費された試行数、コストを報告する。その単位がエージェントジョブであれば、失敗したジョブや繰り返し発生した有料コールも含める。画像タスク単体であれば、その旨を明確に記載する。
有用な評価レポートは、ネガティブケースも保存する。未対応のチャレンジ、必須入力の欠如、ジョブ終了後に届いた結果などを含めること。そうしたケースで望ましい挙動は、さらなる再試行ではなく、明確な停止である場合も多い。
モデルが出力する「自信度」を、受け入れ確率の実測値と解釈してはならない。アプリケーションやテストハーネスから観測された結果を用いること。ハーネスは、自分がテストを許可されたシステムとデータに限定する。
小規模テストは、検査したケースにおいて統合が想定通り動作することを示すことはできるが、「すべてのエージェントにとって最適」「あらゆるサイトで動作する」といった主張を正当化することはできない。テストレポートは購入判断と紐付けて保管し、他チームがその限界を確認できるようにする。
要件が変わったら、関連するケースを再テストする。モデル、ブラウザランタイム、ソルバーのタスクタイプ、ターゲットアプリケーションが変われば、以前の証拠が示す内容も変わり得る。無制限の約束よりも、範囲を絞った互換性の記述の方が有用である。
直接評価できる範囲の画像理解タスクが要件であれば、認識モデルを選ぶ。認可されたアプリケーションが対応CAPTCHA結果を必要としている場合は、ドキュメント化されたソルビング統合を選ぶ。周囲のジョブが計画やツール選択の恩恵を受けるのであれば、エージェントを用いる。
CapSolverは、ドキュメント化されたソルビングステップを提供できる。現在対応しているタスクタイプを確認し、認可された完全なワークフローをテストし、アプリケーション側の受け入れは別個の結果として扱うこと。
まずは公式CAPTCHA入門ガイドから始め、自分の実際のチャレンジに合致する機能を選択する。最初のテストは、各結果を1件ずつ確認できる程度の規模に留めてから、利用を拡大すること。
Q: LLMはCAPTCHAを解くことができますか?
適切な視覚能力を備えたLLMは、評価された一部のCAPTCHAタスクを解くことができる。結果はチャレンジ内容、モデル、周辺システム、成功の定義に依存する。正しい画像回答であっても、それだけでサイトの認証に成功したことを証明するものではない。
Q: LLM CAPTCHAソルバーはCAPTCHA APIと同じものですか?
いいえ。LLMはモデルコンポーネントであり、CAPTCHA APIは文書化されたサービス操作を公開するものである。エージェントは、その背後で実際の画像認識を自分で行わなくても、そのAPIを呼び出す場合がある。
Q: テキスト専用LLMは画像CAPTCHAを解くことができますか?
テキスト専用LLMは画像を直接確認できない。別途、画像対応コンポーネントや他の視覚情報源が必要であり、システム全体としての評価が依然として必要となる。
Q: エージェントはCAPTCHAを通過するまでリトライし続けるべきですか?
いいえ。明示的な試行回数と時間の予算を設定し、その予算を使い切った時点で停止するかレビューを要求すること。繰り返し試行することで、未対応入力やアプリケーション側の拒否を覆い隠すべきではない。
Q: 研究ベンチマークは、自分のサイトでソルバーが動作することの証拠になりますか?
いいえ。ベンチマークは、自身が評価したタスクと条件を記述したものに過ぎない。自分の認可された環境で必要な能力を検証し、「認識の結果」と「アプリケーション完了」を区別すること。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
