🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Oct 29, 2026
更新されました Oct 29, 2026 · 最小読み取り
許可されたブラウザタスクの途中で、AI エージェントが CAPTCHA に遭遇したとする。アプリケーション側はすでにページ URL と公開サイトキーを把握している。この次のステップは HTTP リクエストにすべきか、それとも MCP ツール呼び出しにすべきか?
重要な違いは「誰がその操作をコントロールすべきか」という点にある。あなたが運用するサービスでは、タスク ID を直接扱い、自前のポーリングロジックを持つ必要があるかもしれない。一方で、既存の MCP クライアントであれば、定義済み入力を持つ発見可能なツールのほうが適していることもある。どちらの場合も、結果を正しく利用できるブラウザワークフローが必要なのは変わらない。
CapSolver はタスク API と MCP サービスの両方を提供している。本稿では、同じ CAPTCHA チェックポイントでそれぞれをどう使い分けるかを比較する。まず、必要な CAPTCHA タスクの種類と、そのタスクをどのアプリケーションコンポーネントが所有するのかを決めよう。
直接 API はソルバーへのリクエストをアプリケーションに公開し、MCP は MCP クライアントに対してツールを公開する。
API ルートでは、サービスがドキュメント化されたタスクを createTask に送信する。非同期タスクは識別子を返し、アプリケーションはその識別子を用いて結果を取得する。識別子をどこに保存し、ワーカーがいつ再チェックすべきかはアプリケーションが決める。
MCP ルートでは、クライアントがサーバーに接続し、利用可能なツールを検出し、構造化された引数でツールを呼び出す。MCP ツール仕様はツール検出と呼び出し方法を定義している。サーバーはツール境界の裏側で独自の実装処理を行う。
CapSolver の MCP サービスは Core SDK をラップしている。公式サーバーリポジトリは実装のリファレンスであり、別個の CAPTCHA 解析モデルではない。そのため、インターフェースを変えただけでは、認識精度の向上や高速化の根拠にはならない。
すでに実行を担当しているコンポーネントに合うインターフェースを選ぶ。
| 判断軸 | 直接タスク API | MCP サービス |
|---|---|---|
| 既存アプリケーション | バックエンドがすでに HTTP コールとジョブ状態を所有している場合に有用 | ホスト側がすでに MCP ツールを検出・呼び出している場合に有用 |
| タスクライフサイクル | アプリケーションがタスク ID を保持し結果を取得 | ツール実装側が内部のソルバーフローを処理 |
| 入力 | タスク固有の API スキーマ | インストールされたサーバーが公開するツールスキーマ |
| 結果処理 | API のエラー / ステータスラッパとタスク固有のソリューションをパース | MCP 結果と、ツール独自の成功 / エラーデータを確認 |
| 対応可否チェック | 該当タスクタイプのドキュメントを確認 | インストール済みツール一覧と supported-types レジストリを確認 |
| ブラウザ継続処理 | アプリケーションがサポートするブラウザフローを通じて結果を適用 | ブラウザ所有者は依然として、継続に対応した仕組みを持つ必要がある |
これは実装方式の選択であり、プロバイダー同士の優劣をつけるものではない。どちらを選んでも、チャレンジ種別を正しく特定し、最終ページを確認する必要性は変わらない。非同期 API は「作業の依頼」と「結果の受け取り」を分離する。エージェント側はその 2 ステップの対応関係を保持しておかなければならない。
バックエンド所有のワーカーは、タスクライフサイクルへの直接アクセスによって恩恵を受ける。たとえば、認可されたカタログエージェントはブラウザジョブを一時停止し、返ってきたソルバーのタスク ID を記録し、定義された期限内で待機できる。別のワーカーは、モデルに状況を推測させることなく、そのジョブレコードを参照できる。
getTaskResult リファレンスには、非同期状態とタスク固有のソリューションデータが記載されている。結果は作成したタスクと対応づけて扱うこと。すべてのタスクを非同期前提で扱ってはいけない。createTask のドキュメントには、一部タスクタイプでは即時結果が返ることも記載されている。
MCP 対応クライアントは共通の検出インターフェースによる利点を持つ。許可された呼び出しを行う前に、どのツールが存在し、どの引数を必要とするかを調べられる。すでに他のツールを扱っているクライアントで、同じインタラクションパターンの中に CAPTCHA 対応を組み込みたい場合に便利だ。
MCP アーキテクチャ概要では、ホスト・クライアント・サーバーが区別されている。この役割の違いを理解すると、「サーバーがブラウザを所有せずとも、接続されたサーバーがエージェントから利用できる」理由がわかる。
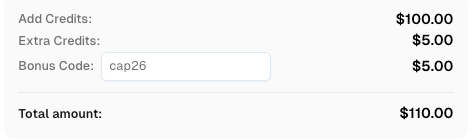
CapSolver ボーナスコードを利用しよう
自動化予算をすぐにブースト!
CapSolver アカウントのチャージ時にボーナスコード CAP26 を利用すると、すべてのチャージ額に対して 5% のボーナス が無制限に付与されます。
今すぐ CapSolver ダッシュボード で引き換えましょう。
API ボディをそのまま MCP 呼び出しに流用できると仮定するのではなく、サポートされている 1 つのタスクに対して入力を比較する。
トークンモード解決の場合、現在の MCP サービスリファレンスは solve_captcha を公開している。インストール済みの capsolver-mcp 0.1.3 では、必須入力として captcha_type、website_url、website_key の 3 つがアナウンスされていた。実行時レジストリには reCaptchaV2、reCaptchaV3、cloudflare が列挙されている。これらの名前は、そのインストール済みツールの表面を説明するものであり、「MCP ラッパーが HTTP API の全カタログを公開している」という約束ではない。
一方で生のタスク API では、clientKey と、選択した API タスクタイプおよびそのタイプ固有フィールドを含む task オブジェクトを使用する。ツール引数と API フィールド名は別々のスキーマに属する。アカウントキーはサーバーまたはバックエンド環境に保持し、エージェントの会話引数内には置かないようにする。
どちらの経路を選ぶにせよ、まずはチャレンジタイプ、許可されたページ、実際に利用可能な入力、期待する結果、およびその結果をブラウザに届けられるコンポーネントを書き出しておくこと。必要な入力が欠けている場合は、モデルに推測させるのではなく、そのギャップを先に解消する。
ブラウザタスクを再開する前に、トランスポートレベルの結果とソルバーレベルの結果の両方を確認する。
生 API では、ソリューションを利用する前に、ドキュメント化されたエラーおよびステータスフィールドを確認する。タスク ID はアプリケーションのジョブと紐づけて保持する。処理継続中を示すレスポンスは、ドキュメントどおりの取得フローを続ける理由であって、自動的に 2 件目のタスクを作成する理由ではない。
MCP では、リクエストが完了していてもツールエラーを含んでいることがある。また、MCP 結果の内部で、アプリケーションレベルの成功 / エラーデータをツールが返す場合もある。これら両方のレイヤーを、サーバーのドキュメントや実際の出力に従って扱うこと。「ツールがテキストを返した=CAPTCHA が解決された」といった一律のルールは避ける。
そのうえでブラウザ側にも独自の受け入れチェックが必要だ。元のタスクで許可されたフォーム送信やデータリクエストは完了したか? 期待するレコードは存在するか? ツールが別ページ上で動作した場合、その結果だけではエージェントが一時停止していたページが変化したことにはならない。既存の MCP セットアップガイドはインストール手順を扱っており、「アプリケーションが結果をどう消費するか」という判断とは分けて考えるべきだ。
MCP 連携に依存する前に、インストール済みツールスキーマとレジストリを確認する。パッケージバージョンによって、過去のセットアップ例とは異なるツール群やサポートタスクタイプが公開されることがある。
capsolver-mcp 0.1.3 では、実際のローカル接続によりツールスキーマと supported-types レジストリが返ってきた。必須のページ URL とサイトキーを欠いた solve_captcha 要求は拒否された。こうしたチェックにより入力契約が確立されるが、有料ソルビングやサイトでの受け入れ状況を測るものではない。
ロールアウトにあたっては、許可された実際のチャレンジを有効なクレデンシャルでテストし、アプリケーション側で意図した結果になっているかを確認すること。ツール一覧を取得できたからといって、それは接続ステップをクリアしたにすぎない。
チームが実際に運用・保守する作業を比較しよう。直接 API コールならジョブストアとポーリングワーカーが必要になり、MCP ならクライアント / サーバーランタイムとツール結果のパーサーが必要になる。どちらも必要なアプリケーションもある。たとえば、エージェントは高レベルの操作をリクエストしつつ、バックエンドワーカーがソルバータスクのライフサイクルを所有する構成などだ。
MCP だからといってソルビングが無料になるわけでも、ソフトウェアレイヤーが 1 つ増えたから必ず遅くなるわけでもない。本当に意味のあるコスト比較には、実際の利用状況とデプロイ構成が必要になる。有料タスク消費、クライアント利用、ランタイムホスティングは、実環境のレビュー時には切り分けて評価すること。
エージェントの「実行オーナー」を中心にインターフェースを選ぼう。バックエンドジョブワークフローには直接 API 制御を、対応クライアントがある場合には MCP のツール検出を選ぶ。それぞれのケースで、CapSolver はサポートされた CAPTCHA 操作を提供し、アプリケーション側がユーザーの意図した結果を検証する。
Q: MCP は CAPTCHA API を置き換えるのですか?
いいえ。MCP はツールインターフェースを提供し、サーバーが実装を通じて基盤のソルバーを呼び出せるようにするものだ。統合境界を変えるだけであり、ソルビングサービス自体をなくすものではない。
Q: AI エージェントが CAPTCHA ソルバーを使うには MCP が必須ですか?
いいえ。エージェントアプリケーションはバックエンドコードからドキュメント化された API を呼び出せる。すでに利用しているクライアントに、MCP の検出とツールインターフェースがフィットする場合に MCP が有用となる。
Q: API のタスクボディをそのまま solve_captcha に送ってよいですか?
インストール済みツールのスキーマを使用すること。MCP ツールの引数は、HTTP API の clientKey と task オブジェクトのラッパとは異なる。
Q: MCP サーバーに接続できれば、ソルビングが動作している証拠になりますか?
いいえ。接続とツール検出はプロトコルアクセスがあることを示すだけ。有料ソルビングや、許可されたアプリケーション側での受け入れは別途検証が必要だ。
Q: 同じ CAPTCHA に対して、エージェントが両方のルートを試すべきですか?
試行ごとに 1 つの実行オーナーを割り当てること。両方を独立に呼び出すと、重複作業が生まれ、どの結果がどのブラウザタスクに対応するのか追跡しづらくなる。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について