🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Oct 29, 2026
更新されました Oct 29, 2026 · 最小読み取り
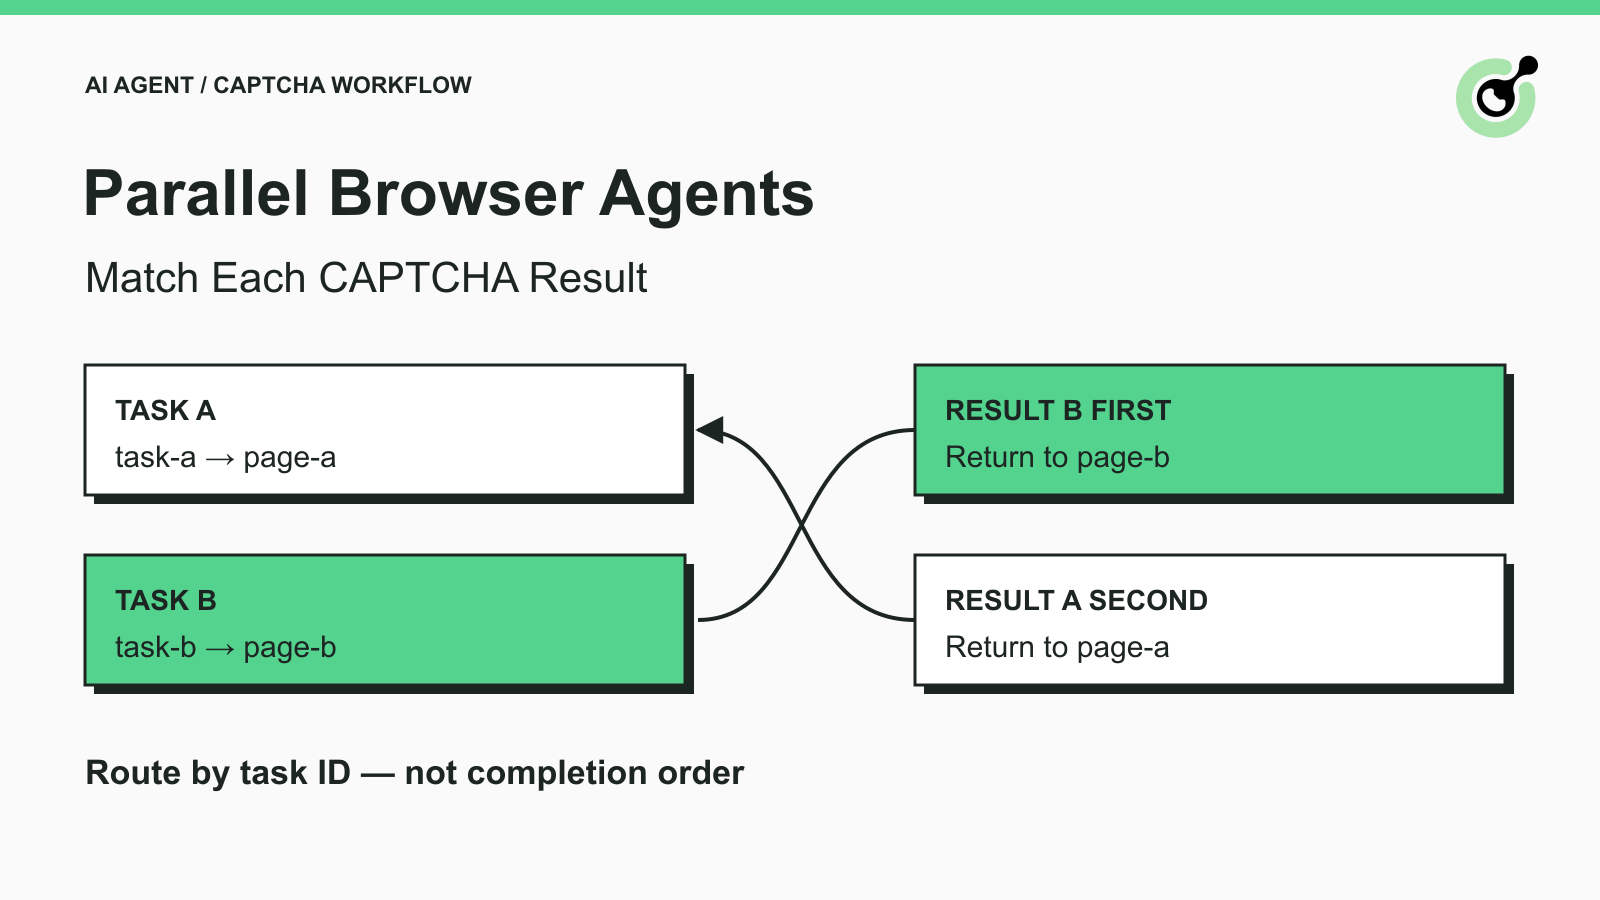
2 つのブラウザーエージェントが、それぞれ別々の正規タスク中に対応済み CAPTCHA に遭遇する。エージェント A が先に開始するが、エージェント B が先に結果を受け取る。もしアプリケーションが「次に来た結果を、最初に待っているタブに割り当てる」だけの挙動をすると、両方のジョブに影響が出てしまう。各ソルバーリクエスト自体はどちらも正当であっても、である。
これはタスク相関の問題であり、リトライ回数を増やしても「誤ったページに届けられた結果」は修復できない。アプリケーション側は「どのブラウザー作業項目がどのソルバータスクを作成したか」と、「レスポンスが届いたときにその作業項目がまだ有効かどうか」を覚えておく必要がある。
CapSolver は非同期 API に対してタスク識別子を返す。本ガイドでは、並列エージェント環境でその関連付けを維持する方法を説明し、実ソルバーを接続する前にローカルで実行できる小さな例を示す。ここで示す内容は、同時実行ベンチマークや本番環境での CAPTCHA 成功率を主張するものではない。
ブラウザーエージェントは、1 回の試行に紐づく「アプリケーションジョブ」「ページ所有者」「ソルバータスク ID」を保持しておくべきである。
createTask API は非同期タスクに対して taskId を返す。その作成レスポンスを受け入れた時点で保存しておく。getTaskResult API は、その識別子を受け取り、対応する結果を取得する。
アプリケーション側には、独自の「作業項目 ID」と「ブラウザー所有者への参照」も必要になる。これらは CapSolver の追加リクエストパラメータではなく、アプリケーション側のフィールドである。例に出てくる page-a のようなページラベルは「そのページを所有するワーカー」を識別するためのものであり、再利用可能なブラウザーハンドルでも API 認証情報でもない。
ここに小さな試行バージョン、以下では epoch と呼ぶものを追加する。新しいナビゲーションやチャレンジ試行が始まって、以前の保留結果が不適切になったときにインクリメントする。URL だけでは不十分である。2 つのジョブが同じ URL にアクセスすることもあるし、1 つのページがアドレスを変えずに別状態を読み込むこともあるからだ。
Playwright の ブラウザーコンテキストのドキュメント は、分離されたブラウザー状態について説明している。コンテキスト分離とタスク相関は別問題である。Cookie を分離しても、それだけではソルバー結果が自動的に正しいワーカーにルーティングされるわけではない。
完了順は「いつ結果が届いたか」を表すだけで、「どのブラウザージョブの所有物か」は表さない。
Python の asyncio.as_completed のドキュメント は、完了した順に awaitable を処理することを説明している。オーケストレーションで完了順コールバックを使っている場合には、「待機中のページのリスト内ポジション」に頼るのではなく、各結果が自分自身の関連付け情報を必ず運んでいなければならない。
タスク作成とバインディングは、1 回のローカルハンドオフとして扱うこと。作成レスポンスを検証し、返ってきた ID をその作業項目と共に保存し、その後で結果取得を許可する。コールバックベースの実装では、「ローカルのバインディングが可視になる前に結果が返ってきた」ケースに対する同等のプランが必要になる。その競合状態を「不明なページ」として捨てて、すぐに別の有料タスクを作成してはならない。
Python のキューインターフェイス は、完全な作業項目をローカルワーカー間で渡すのに役立つ。キューはマッピングの代替ではない。識別子は結果とともにページ所有者のところまで運び続けなければならない。
タスク ID が既知であり、記録されている試行が「まだアクティブなページに属している」場合にのみ、その結果を配達対象として受け入れる。
小さなアプリケーションでは、単一オーナーにこの状態更新を任せる。分散サービスでは、永続ストレージとアトミックなクレーム、またはそれに相当する並行制御を利用する。プロセス間で「なんとなく共有」した Python の辞書では、その保証は得られない。
以下の例はローカルでのルーティング用フィクスチャであり、公式 SDK のメソッドでも完全なソルバー統合でもない。ここでは架空のタスク ID と fixture_marker を使用しているが、これは CAPTCHA トークンや CapSolver のソリューションフィールドではない。Python 3 で実行でき、サードパーティパッケージ・API キー・ブラウザー・ネットワークリクエストは不要である。
def accept_result(reply, pending, current_epochs):
    task_id = reply.get('taskId')
    if not isinstance(task_id, str) or type(reply.get('errorId')) is not int:
        return 'malformed_reply', None
    job = pending.get(task_id)
    if job is None:
        return 'unknown_or_duplicate', None
    if current_epochs.get(job['page_id']) != job['epoch']:
        pending.pop(task_id)
        return 'stale_page', None
    if reply.get('errorId', 0) != 0:
        pending.pop(task_id)
        return 'solver_error', None
    if reply.get('status') != 'ready':
        return 'pending', None
    if not reply.get('solution'):
        pending.pop(task_id)
        return 'missing_solution', None
    pending.pop(task_id)
    return 'ready_for_owner', (job['page_id'], reply['solution'])

pending = {
    'fixture-task-a': {'page_id': 'page-a', 'epoch': 1},
    'fixture-task-b': {'page_id': 'page-b', 'epoch': 1},
}
epochs = {'page-a': 1, 'page-b': 1}
for task_id in ['fixture-task-b', 'fixture-task-a']:
    reply = {'taskId': task_id, 'errorId': 0, 'status': 'ready',
             'solution': {'fixture_marker': task_id}}
    state, target = accept_result(reply, pending, epochs)
    print(task_id, state, target[0] if target else None)
この例は次の 2 行を出力する。
fixture-task-b ready_for_owner page-b
fixture-task-a ready_for_owner page-a
タスク B は最初に完了するが、それでも結果はページ B に返される。関数はあえて、その結果を「ページ所有者に渡す」だけで、ページの入力や送信は行わない。ドキュメント化された「タスク固有の結果パーサ」と「サポートされたブラウザー操作」を備えるまでは、このフィクスチャを実ソルバーに置き換えてはならない。
ポーリングワーカーの場合、リクエストに使ったタスク ID をローカル作業項目の一部として保持する。レスポンスにタスク ID が含まれるなら、それが一致していることを確認しなければならない。不正な、あるいは一致しないレスポンス ID を使ってリクエストをラベルし直してはならない。このフィクスチャは、accept_result が呼ばれる前に、その関連付けがすでに検証済みであることを前提としている。
CapSolver ボーナスコードを利用しよう
自動化用の予算を即座に増やしましょう!
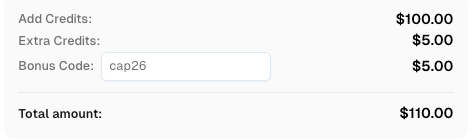
入金時にボーナスコード CAP26 を使用すると、チャージごとに 5% のボーナス が無制限で追加されます。
今すぐ CapSolver ダッシュボード で引き換えましょう。
遅延した結果や重複した結果は、「現在アクティブなタブにそのまま適用する」のではなく、必ず明示的な状態として扱う。
ページが閉じられた・ナビゲートされた・置き換えとなるチャレンジを開始した、といった場合には、その古い試行を stale(陳腐化)としてマークする。このフィクスチャでは、保存してある epoch と current_epochs を比較している。閉じたページを削除した場合も、このチェックに失敗する。ホスト名が一致しているからといって、古い結果を新しい試行に移してはならない。
ページ所有者は、配達された結果を使用する直前に、もう一度その試行を確認すべきである。フィクスチャによるチェックと、後続のブラウザー操作とは別の処理だ。ナビゲーションと結果適用を同じ所有者の管理下に置くことで、その間に別のワーカーがページを変更することを防げる。
ソルバーが非終端状態を報告している間は、既存のタスクバインディングを維持する。現在のタスクドキュメントにあるポーリング手順と、ジョブの締め切りを守ること。結果が ready でないたびに代替タスクを作成していると、元のリクエストを解決しないまま保留作業だけを増やすことになりかねない。
該当する作業項目に対して、その失敗を記録する。このフィクスチャは、ソルバーエラー、不正な封筒(envelope)、ソリューションの欠落を区別している。本番用パーサでは、これに加えて「選択したタスクタイプに対する正確な solution フィールド」を検証する必要がある。空でない辞書であることだけでは、有効なトークンである証拠にはならない。
配達は 1 度だけクレームする。ローカルフィクスチャでは、ready なバインディングを削除しているため、同じものが再度届けば unknown or duplicate と分類される。本番ワーカーでは、永続的な終端レコードと、配達やブラウザー実行が失敗し得る場合の ACK(確認応答)ポリシーが必要となる。このインメモリの例を「厳密に 1 回だけ配達される分散キュー」としてそのまま使ってはならない。
スループットについて結論を出す前に、「所有権」と「拒否動作」が正しく機能していることを確認する。
ローカルチェックでは、「完了順の逆転」「進行中タスク」「未知の ID」「変更された試行」「閉じたページ」「エラーレスポンス」「空のソリューション」「不正な封筒」「重複配達」を検査した。公開されている関数について、これらのチェックはすべて通過している。ただし、本当の CAPTCHA ソルビング・ブラウザーへの入力反映・アプリケーション側での受理についてはテストしていない。
認可されたエンドツーエンドテストでは、実際のタスク作成・取得呼び出しを追加し、機微な結果はブラウザーワーカー内に留め、ドキュメント化された solve 手順に従った後で、意図したアプリケーション結果を確認すること。ページがまだチャレンジを表示している・期待したレコードが存在しないといった場合には、それを「ソルバーの ready 状態」とは別に記録する。
ログは、トークン・Cookie・API キーを生のままコピーせずに役立つように保つ。作業項目 ID・タスク ID・ステージ名・正規化したエラー情報を保存する。API タイムアウトガイド では待機挙動に関する説明がすでになされており、本稿の関心は「最終的な結果をどのジョブが受け取るか」にある。同時実行性用語集 は同時作業に関する背景を提供するものであり、性能に関する保証を意味するものではない。
サポートされたすべての solve を、「それを要求した作業項目」に確実に紐づけておくこと。CapSolver はソルバー結果を提供し、アプリケーション側はその結果をルーティングし、試行がまだ有効かどうかを確認し、ブラウザータスクを検証する。この役割分担により、結果が順不同で届いても、並列エージェント同士が互いに独立したままでいられる。
Q: 2 つのブラウザーエージェントが 1 つの保留タスク変数を共有できますか?
後からの作業が以前の関連付けを上書きし得る単一のミュータブル変数は安全ではない。アクティブな各ソルバータスクとそのページ所有者ごとに、個別のバインディングを保存すること。
Q: ページ URL だけで宛先を識別できますか?
いいえ。異なるタブが同じ URL を共有することもあるし、ページが同じアドレスのまま状態を変更することもある。作業項目 ID と、現在の試行バージョンを保持すること。
Q: ページがナビゲーションした後で ready な結果を再利用できますか?
そのまま適用可能だと決めつけてはならない。古い試行を stale とみなし、新しいページを確認してから、許可される追加 solve をどうするか判断すべきである。
Q: この例は実際の CAPTCHA を solve したり送信したりしますか?
いいえ。これは架空の識別子と不活性な結果を用いたローカルルーティングのテストである。有料ソルビングとアプリケーション側の受理は、別途統合テストが必要。
Q: この辞書ベースの例は分散ワーカー間でも安全ですか?
いいえ。単一プロセス内の単一オーナーを前提としている。分散実行では、永続的なタスク状態・アトミックな配達クレーム・失敗時の処理ポリシーが必要になる。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について