🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Oct 30, 2026
更新されました Oct 30, 2026 · 最小読み取り
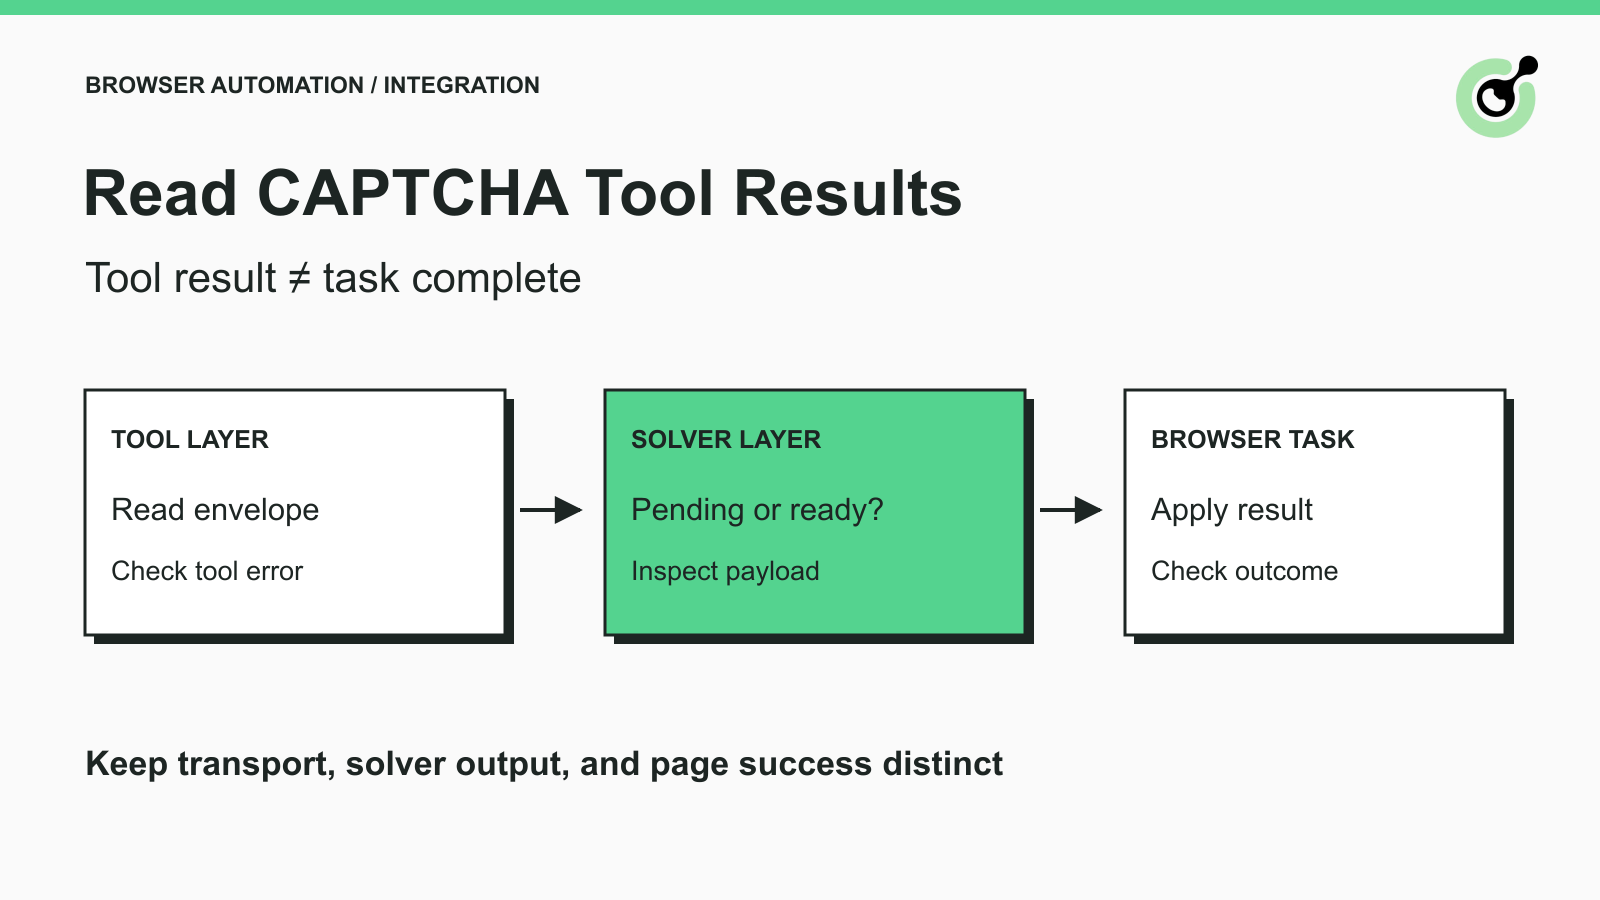
status や solution を解釈する前に errorId を確認する。ブラウザエージェントは、有効なツールレスポンスを受け取っても、次に実行できる有用な処理が何もない場合がある。レスポンスには、入力検証エラー、未完了のタスク、あるいはページにまだ受理されていない解が含まれることがある。これら 3 つをすべて同じ「完了」メッセージにしてしまうと、エージェントは早すぎる段階で先に進んでしまう。
CapSolver は CAPTCHA 処理を直接 API とエージェント向けインターフェースで提供している。どのインターフェースを使うかによって、結果の形が異なる。本ガイドでは、その結果形式の読み方と、新しいプロバイダフィールドを発明せずに小さなアプリケーションサマリを設計する方法を説明する。
ここでの具体例は、自前のテストフォームを操作するエージェントである。ブラウザが対応 CAPTCHA に到達し、選択したソルバーが動作し、そのうえでアプリケーションが「待つ/入力を修正する/結果を適用する/停止する」のどれを行うかを決める。このとき、何を根拠にその判断を行うべきか、が本稿のテーマである。
success や status という名前のフィールドを見る前に、まずレスポンスのレイヤーを特定する。
見るべきレイヤーは 3 つある:ツールのトランスポート、CAPTCHA オペレーション、ブラウザタスクだ。API は特定のインターフェースを定義し、そのレスポンスはその契約の範囲で解釈すべきである。ツールラッパーがさらに包み込みを追加することもあり、アプリケーションが独自のワークフローステータスを載せることもある。
| レイヤー | 答える質問 | 単体では確定できないこと |
|---|---|---|
| MCP/ツール トランスポート | ツール呼び出しは返ってきたか、ツールエラーを報告したか? | 利用可能な CAPTCHA 解が存在するかどうか |
| CAPTCHA サービス | 解決処理が失敗したか、保留中か、仕様通りの結果を返したか? | 対象フォームやページがその結果を受理したかどうか |
| ブラウザ/アプリケーション | 想定した操作が期待どおりの状態に到達したか? | それ以前のすべての診断が正しく記録されているかどうか |
元の結果はデバッグのために保持しておくこと。もしアプリケーションが結果を正規化するなら、そのフィールドはアプリケーション所有であると明示する。workflow_state のような内部用の便利なフィールドを、CapSolver API の公式フィールドとして見せてはならない。
まず MCP のツールエラーシグナルを確認し、その後はツール固有の契約に従ってペイロードを読む。
MCP ツール仕様は、ツール結果コンテンツと isError フラグについて定義している。クライアントライブラリは、プログラミング言語ごとに別の名前でこれを公開しているかもしれない。たとえば FastMCP のツール結果は、.is_error、.content、およびパース済みデータを提供する。
すべてのツールレスポンスが素の JSON ディクショナリだと決めつけてはいけない。サーバによっては、シリアライズされた JSON を含むテキストコンテンツを返したり、同時に構造化コンテンツを返したりする。ドキュメントで定義されたクライアントプロパティをまず読み、そのうえで、実際に JSON を含むレイヤーだけをパースする。「success」という単語を探してレスポンス全文を検索するようなやり方は信頼できない。
FastMCP 3.4.11 と capsolver-mcp 0.1.3 を用いたローカル接続テストでは、意図的に不完全な solve_captcha 呼び出しに対し、website_url と website_key が不足しているというツールエラーが返ってきた。一方で、別のレジストリ呼び出しは成功して返ってきた。これらの観察が確認しているのは、エラーの読み取り経路とレジストリの実行であって、有料の解決処理ではない。
ツールは、MCP としては正常なエンベロープを返しつつ、その内部にサービスレベルの失敗を含めることもできる。したがって「ツール例外がない」というのは、あくまで最初の確認にすぎない。続いて、そのツール固有のビジネス結果を確認すること。直接 API のフィールドを、推測で MCP フィールドにマッピングしてはならない。
特定フレームワークでの登録例としては、Pydantic AI ツールガイド が型付き入力とアダプタ実行を解説している。ここでの焦点は、どのフレームワークでツールを登録したかではなく、レスポンスが届いた「後」にどのような判断を下すかである。
直接 API を使う場合は、まず errorId を確認し、その後にドキュメント化されたタスク状態をたどる。
createTask リファレンス と getTaskResult リファレンス が、このフローを定義している。タスク作成が成功すると、後で結果取得に使うタスク ID を返すことがある。この ID はあくまで処理を参照するためのハンドルであり、解そのものではない。
ポーリングで結果を取得する場合、解を読む前にエラーレスポンスを処理する必要がある。ドキュメントにある idle と processing 状態は未完了状態だ。既存の取得フローを、設定した締切時間の範囲内で継続する。リファレンスでは、processing の結果に対しては 3 秒待ってから再試行するよう指定している。準備完了の結果は、タスクタイプごとに定義された解の形を含んでいなければならない。
| レスポンス上の観察 | 解釈 | アプリケーションのアクション |
|---|---|---|
errorId が 0 以外 |
サービスがエラーを報告している | errorCode と errorDescription を保持し、修正か停止かを選択 |
| タスク受理済みだが、結果は処理中 | 最終的な解はまだない | ドキュメントに従い、同じタスクをポーリング |
| 期待どおりの解フィールドを持つ準備完了の結果 | 候補解が利用できる | 同じチャレンジを担当するコンポーネントに渡す |
| 解がない・形式が想定と異なる結果 | 契約が確立されていない | 解釈を中止し、レスポンスを確認。トークンをでっち上げない |
| ブラウザが目的タスクの成功を確認 | アプリケーションとしての結果が確定 | ワークフロー完了を別に記録 |
タスクタイプによっては同期的に完了するものもある。すべてのタスクを無理にポーリングループにはめ込まず、選択したタスクタイプごとのレスポンス定義に従うこと。逆に、非同期結果がまだ準備できていないからといって、createTask を繰り返し呼び出してはいけない。
reCAPTCHA v2 リファレンス では、その解フィールドが定義されている。他のタスクファミリーは異なるデータを返しうる。あらゆる結果が同じトークンフィールドを持つと仮定するラッパーは、正しい解を捨ててしまったり、無関係なフィールドを解だと誤認したりする危険がある。
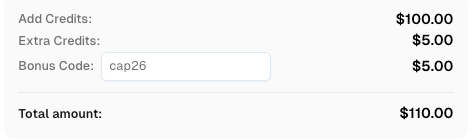
CapSolver ボーナスコードを利用しよう
自動化予算をその場で増額!
チャージ時にボーナスコード CAP26 を利用すると、すべてのリチャージ額に対して 5% のボーナス を無制限に獲得できます。
今すぐ CapSolver ダッシュボード で引き換えましょう。
エージェントの「次の許可された一手」に必要な情報だけを返し、サービス詳細はそれを消費するコンポーネント側に保持する。
小さなアプリケーションサマリには、処理ステージ、正規化された結果、無害な説明文、そして次に許されるアクションを含められる。これらはアプリケーション独自のフィールドであり、プロバイダレスポンスの代替ではない。
たとえば、直接 API から保留中のレスポンスを受け取った場合、サマリは次のように表現できる:「CAPTCHA タスクは処理中です。同じタスクの完了を引き続き待ってください。」入力エラー後であれば、「リクエストが不完全です。再試行の前に、足りないページパラメータを取得してください。」ソルバーの結果がある場合には、「解は利用可能です。ブラウザ側の検証はまだです。」といった具合である。
これらのメッセージが意図的に避けている点に注意してほしい:どれも「フォームを送信した」「データリクエストが完了した」とは主張していない。ブラウザが、その証拠を後から提供しなければならない。
実務的な実装では、2 種類の記録を持つ。運用レコードには、タスク参照、安全な診断フィールド、ステージ遷移を保存する。ブラウザコンポーネントは、一時的に必要な解の値を保持する。モデル向けサマリは、完全なトークンを会話応答にコピーすることなく、「許可された次のアクション」を指し示す。
アプリケーションがモデルからの構造化出力を受け入れる場合は、その出力をアプリケーション自身のスキーマで検証する。スキーマが保証するのは形だけであり、真偽ではない。モデルが単に別のステータス文字列を返しただけで、保留中のソルバー観測を「完了したブラウザ結果」に書き換えられるようなことがあってはならない。
再試行ルールを一律に決めるのではなく、エラーメッセージと現在のページ状態から「次のアクション」を選ぶ。
公式エラーリファレンス は、無効なデータ、サポート外のタスク、認証情報、制限、解決失敗などを区別している。これらは別々の対処が必要だ。同じ無効ペイロードを再送してもフィールドは直らない。有料タスクを新たに開始しても、欠けている認証情報は補えない。
コンパクトな判断手順は次のとおり:
有限な「停止」も有用な結果だ。「このステップを完了できなかった」という正確な理由付きの結果は、成功したかのように振る舞わせてしまう空文字列よりも、はるかに行動可能である。
アプリケーションは、CAPTCHA ステップ後に「元々のタスクの期待結果」を観測しなければならない。
自前のテストフォームであれば、ソルバーを呼ぶ前に、その条件を定義しておくべきだ。たとえば、既知の確認要素と、その要素に対応するテスト送信レコードの存在など。iframe の消滅、レスポンスフィールドへの値設定、ツールからのトークン返却といったものは、有用な中間証拠ではあるが、本来のアプリケーションアウトカムよりも弱い根拠にすぎない。
Google の reCAPTCHA 検証ドキュメントは、サーバ側検証ステップを説明している。だからこそ、ブラウザに返されたトークンを、受信側アプリケーションによる受理と混同してはならない。
ワークフローが失敗したときは、最後に確立されたステージを保持しておく。「ソルバーは返ったが、アプリケーションに拒否された」のと「ソルバーがそもそも返ってこなかった」のとは異なる。この区別があることで、本当の問題が別の必須フォームフィールドにあるのに、デバッグのたびにソルバーリクエストを変更してしまう、といった事態を防げる。
各結果分岐を個別にテストし、そのうえで、本番許可された認証情報と自前ページを使ったエンドツーエンドテストを行う。
入力検証失敗、サービスエラーのフィクスチャ、処理中レスポンス、準備完了レスポンス、想定外のペイロード、候補解適用後のブラウザ拒否をすべて含める。フィクスチャはアプリケーションの判断ロジックをテストするものであり、ライブ API の挙動や CAPTCHA 受理を証明するものではない。
また、アプリケーションが待機を終了した後に到着するレスポンスもテストするべきだ。アプリケーションは「待機終了」という状態を維持し、遅れて届いた結果のせいで放棄済みフォームが再開してしまわないようにする。その結果は元の試行と結び付けたままにしておく。
本稿で挙げたチェックは、「ドキュメントに基づいたレスポンス解釈」と「実際の MCP 検証/レジストリ経路」を確立するものであり、有料解決のベンチマークでも、導入事例でも、エージェント成功率の測定でもない。
CAPTCHA の結果は、その実際の状態を保持し、ブラウザでの結果を確認することで、初めて行動可能になる。CapSolver は、そのステップのためのドキュメント化されたソルバーインターフェースを提供する。CapSolver を試し、許可されたテストワークフローで利用し、最終的なアプリケーションチェックは別に保つこと。
Q: isError が false なら、CAPTCHA は解決されたという意味ですか?
いいえ。これは、ツールレスポンスがツール実行エラー扱いではないことを示すだけです。ペイロードのドキュメント化されたビジネス結果を確認し、そのうえでブラウザタスクを別途検証してください。
Q: エージェントに完全な CAPTCHA トークンを渡すべきですか?
そのトークンを実際に消費するコンポーネントが必要としている場合だけです。多くの設計では、値はアプリケーション状態に保持し、モデル側には短いステータスだけを渡すことができます。
Q: REST と MCP で同じ結果パーサーを使えますか?
両者のレスポンス契約の違いを明示的に吸収した場合に限ります。REST のタスク結果と MCP のツールエンベロープは、交換可能なオブジェクトではありません。
Q: 結果がまだ processing のとき、何を返すべきですか?
アプリケーション独自形式の「保留中」ステータスを返し、締切時間の範囲で同じタスクの結果取得を続けてください。完了とラベル付けしたり、最初のタスクが未完了というだけで新しいタスクを作成してはいけません。
Q: ソルバーが結果を返したのにフォーム送信が失敗した場合は?
ソルバー完了とアプリケーション失敗を別々に記録してください。新しい CAPTCHA 試行が適切かどうかを決める前に、ページ側の拒否内容と、現在のタスクコンテキストを確認すること。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について