🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Sep 24, 2026
更新されました Sep 24, 2026 · 最小読み取り
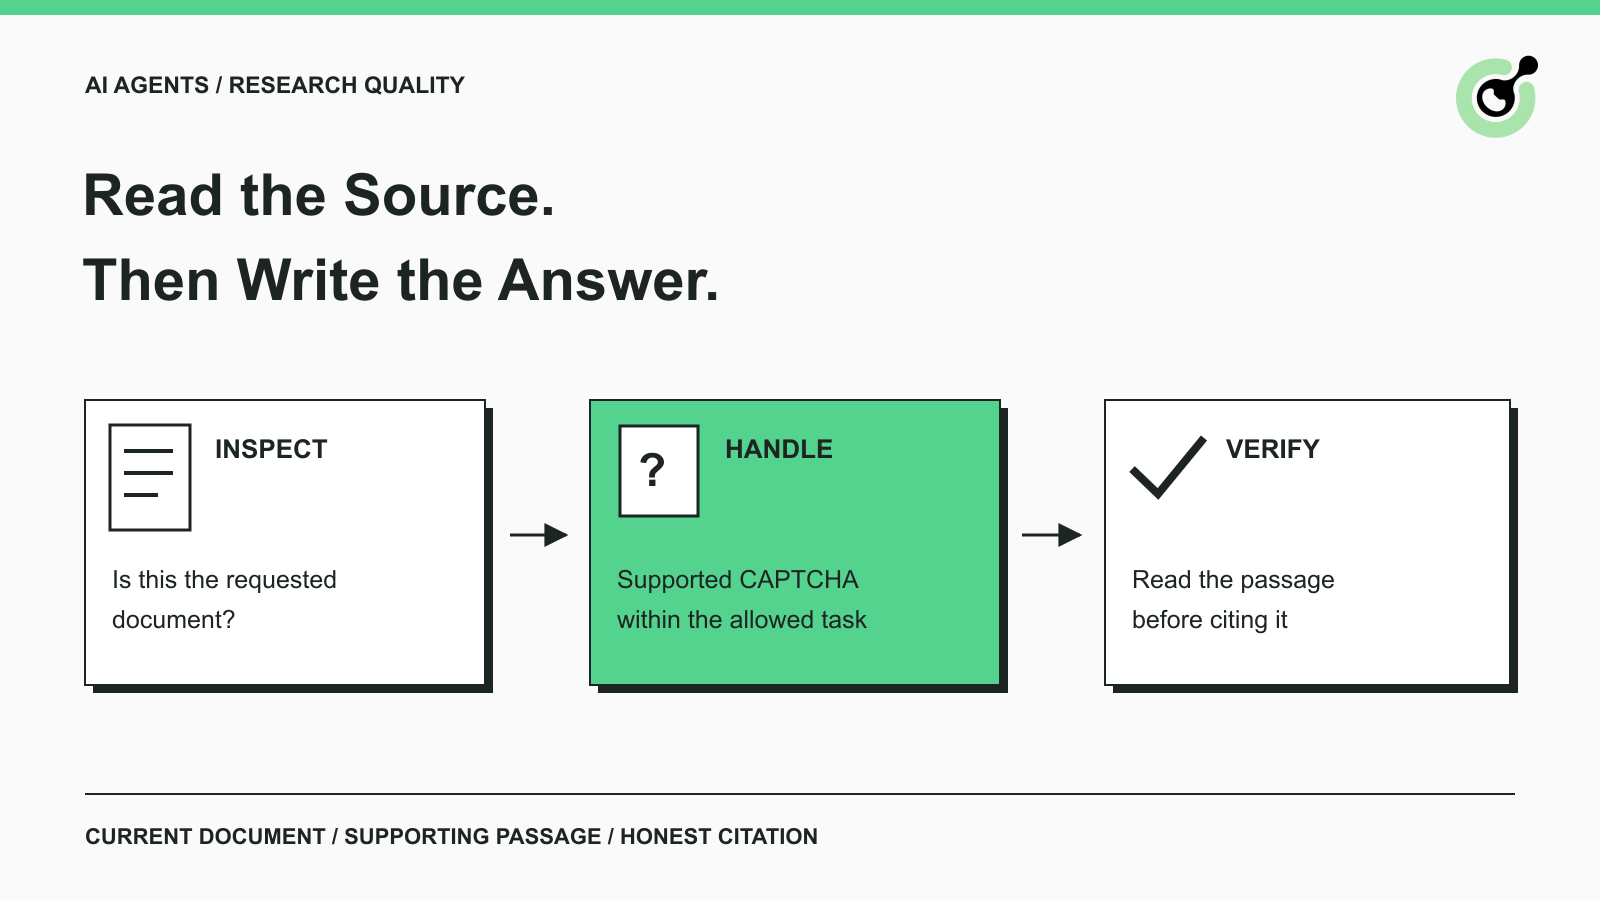
エージェントが取得したページを証拠として扱う前に、そのページに何が含まれているかを確認しない場合、リサーチ実行は信頼できなくなります。CAPTCHAの処理は、このコンテンツ確認プロセスに含まれるべきです。
リサーチエージェントが複数のサプライヤーの公開された製品仕様を比較していると想像してください。いくつかのドキュメントを開き、テーブルを抽出し、簡潔な比較を作成します。1つのソースが仕様ではなく検証ページを表示する場合、エージェントがURL、検索スニペット、または以前の要約のみを使用し続けると、最終的なレポートは完璧に見えるかもしれませんが、その中の1つの主張にはサポートとなるセクションがありません。
CapSolverは、許可されたブラウジングワークフロー内でサポートされているCAPTCHAステップを処理できます。リサーチアプリケーションは、その後にソースが利用可能になったことを確認する必要があります。このガイドは、エージェントのノートにどのコンテンツが到達したか、どの引用が使用可能か、そして検証できなかったソースをどのように報告するかに焦点を当てています。
ソースチェックは、応答が期待されるドキュメントであり、リサーチの質問に必要な情報が含まれていることを確認する必要があります。
< a href="https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/200" rel="nofollow">HTTP 200応答はHTTPリクエストの結果を説明します。あなたのリサーチタスクには、返されたコンテンツが実際に意図された分析をサポートしているという追加の要件があります。HTTPステータスを完全な承認ルールではなく、1つの診断信号として扱ってください。
簡単なチェックから始めましょう。ページタイトルが期待される製品やレポートを識別していますか?関連するテーブル、セクション、またはセクションが表示されていますか?ナビゲーションは意図されたソースに終了しましたか、それとも関係のないホームページに終了しましたか?タスクが最近のリリースに関係する場合、ドキュメントは関連するバージョンや日付を識別していますか?
これらのチェックは、サイトがコンテンツが読み込まれる前にページの枠組みをレンダリングする場合に特に役立ちます。ナビゲーションが終了しても、テーブルがまだ表示されていない場合があります。エージェントは、ブラウザワークフローの制限付きロードルールに従って必要なコンテンツを待機し、証拠がまだ読み取れない場合はソースを利用不可とマークする必要があります。
Cloudflareチャレンジページの場合、Cloudflareはcf-mitigated: challenge応答ヘッダーとHTMLコンテンツタイプをドキュメント化しています。これはプロバイダー固有のシグナルであり、ユニバーサルなCAPTCHA検出器ではありません。
ログイン画面、欠落ページ、サポートされていないドキュメント形式、アプリケーションエラーは、それぞれ異なる処理が必要です。これらをすべてソルバーに送信すると、労力の無駄となり、実際のソースの問題が曖昧になる可能性があります。観測されたページとサポートされている検出ツールを使用して、タスクを選択する前にチャレンジを識別してください。
CapSolverのCore SDKドキュメントは、検出、パラメータの読み取り、解決、ブラウザへの入力の分離を説明しています。この分離により、アプリケーションはどの段階で失敗したかを決定できるようになりますが、失敗したリサーチソースを一般的なモデルエラーとして説明する必要はありません。
明確なソースステータスは、欠落した証拠が静かに答えに変換されるのを防ぎます。ラベルは単純で、複雑なエージェントアーキテクチャは必要ありません。
| リサーチステータス | アプリケーションが知っていること | ライターが行えること |
|---|---|---|
| コンテンツ検証済み | 関連するソースセクションが読み込まれ、保持されています | そのセクションがサポートする主張に使用してください |
| チャレンジ保留中 | 許可されたCAPTCHAが許可されたソースワークフローを妨げています | チャレンジステップが処理される間、抽出を一時停止してください |
| コンテンツ不完全 | ソースは開きましたが、必要なセクションが欠如しているか読み取れません | ギャップを報告するか、制限付きコンテンツロードチェックを実行してください |
| ソース利用不可 | 有用なソースコンテンツなしでワークフローが終了しました | 証拠として除外し、関連する場所で制限を明記してください |
| 代替検証済み | 他の適切なソースが主張をサポートしています | そのソースを引用し、範囲に意味のある違いがある場合は説明してください |
これらは推奨されるアプリケーションラベルであり、CapSolverの応答フィールドではありません。これらをリサーチシステムの独自の記録に保持してください。ソルバータスクが完了していても、ソースステータスが未完了のままになることがあります。
この区別はデータ品質の一部です。収集された資料は、意図された質問に適合している必要があります。空の価格表はゼロ価格として扱われてはなりません。欠落した機能リストは、その機能がサポートされていないという主張として扱われてはなりません。読み取れないリリースノートは、リリースが行われなかったという証拠として扱われてはなりません。
要約エージェントに許可されたコンテンツとともにステータスを提供してください。そうでなければ、後続のエージェントが空の文字列を受け取り、ページが空だった理由を推測しようとする可能性があり、ブラウザワーカーによってすでに作成されたより有用な診断を失うことになります。
ソルバーは、サポートされているチャレンジが識別された後、アプリケーションがソースコンテンツをリサーチに受け入れる前に配置されるべきです。
ユーザーの許可されたソースとタスクから始めます。要求されたドキュメントURLと、ドキュメントが答えなければならない質問を保持してください。公式フィード、ダウンロード可能なレポート、または承認されたAPIがすでに必要な資料を提供している場合、直接それらを使用してください。
ブラウザがサポートされているCAPTCHAに遭遇した場合、現在のページから必要なパラメータを収集し、文書化されたタスクを使用してください。チャレンジが処理される間、ブラウザはそのソースに関連付けられたままにしてください。後のナビゲーションで以前の結果が別のドキュメントの証拠のように見えることを許してはいけません。
CapSolver Coreの文書化されたトークンベースのブラウザフローはreCAPTCHA v2/v3とTurnstileをカバーしており、これは画像グリッドをクリックするか、スライダーをドラッグするのとは明確に区別されています。チャレンジに適したツールを使用し、すべてのCAPTCHAスタイルを同じ方法で処理できる一般的なブラウザエージェントを仮定しないでください。
許可されたソルバーステップの後、再度ページを読み取ります。関連するセクションやテーブルを確認し、必要な資料を抽出し、それをソース記録に添付してください。ページがまだブロックされているか、期待されるコンテンツが欠如している場合、その結果を保持し、実行の制限に従って停止してください。
より広範な責任範囲のために、AIエージェントのCAPTCHAソルビングインフラストラクチャのガイドは関連する文脈を提供します。小さなリサーチアシスタントは、各ステップに別個のサービスを構築することなく、同じ基本的な区別を適用できます。
CapSolverボーナスコードを取得する
自動化予算を即座に増やす!
CapSolverアカウントにチャージする際にボーナスコード CAP26 を使用すると、すべてのチャージで 5%のボーナス を受け取れます — 制限なし。
今すぐCapSolverダッシュボードで取得してください
証拠記録は、何が読み込まれたか、そしてそれが報告された主張をサポートする理由をレビュー者が理解できるようにする必要があります。
要求されたURLと最終URL、ドキュメントタイトル、関連するセクションまたはテーブルの場所、観測時間を保持してください。表示可能な場合は、ドキュメントの公開日またはバージョンも含めてください。ソースリンクだけでは、レビュアーがエージェントが現在のドキュメントを読み込んだのか、古いものを記憶していたのかを判断できません。
セクションを狭く保ち、主張に接続してください。サプライヤードキュメントが地域の利用制限をリストしている場合、製品の事実とともにその制限を保持してください。限定語を省いた要約は、ページが正常に取得された場合でも誤りになる可能性があります。
ソーステキストを情報として検証するものと扱ってください。OWASPのプロンプトインジェクションガイドラインは、信頼できないコンテンツがアプリケーションの指示を変更するリスクを説明しています。エージェントに資格情報を明かす、タスクを変更する、または関係のない場所にアクセスするように要求するページは、リサーチ中に表示されたからといって権限を持つべきではありません。
CAPTCHAのスクリーンショットやソルバーの応答は、運用記録であり、製品比較のソース資料ではありません。リサーチノートから分離してください。失敗を調査するのに必要な診断情報をのみ保持し、APIキー、応答トークン、セッションクッキーをレポートから除外してください。
文書は本物であっても、エージェントが書いた文をサポートしない可能性があります。引用を承認する前に、主張と実際のセクションを比較してください。セクションは同じ製品、地域、時間帯、機能を扱っていますか?主張は直接的な声明ですか、それともラベルが必要な推論ですか?
このレビューは軽量でかまいません。短い製品比較には、重要な機能主張ごとに1つの特定のセクションが必要です。より長い市場レポートには、複数のソースと不一致の説明が必要です。チェックの量は、主張の結果に応じて決めるべきです。訪問したURLの数ではなく。
これらの仮想の状況は、CAPTCHA処理が最終的なリサーチ出力にどのように影響するかを示しています。これらはワークフローの例であり、顧客のケーススタディや測定されたパフォーマンス結果ではありません。
エージェントは、許可された公開仕様書を読み、寸法とサポートされるインターフェースを比較します。1つの仕様書はチャレンジの後ろに表示されません。サポートされている解決後、エージェントは正しい製品バージョンと関連する行を見つける必要があります。
行がまだ利用できない場合、比較はその仕様が検証されていないことを示すべきです。小売業者の説明は代替ソースになるかもしれませんが、それはメーカーに帰属するのではなく、そうであると識別されるべきです。
エージェントは、チームのワークフローに影響を与える変更を確認するために、パブリッシャーのリリースノートをチェックします。ブラウザはサイトに到達しますが、検証画面がリリース本文へのアクセスを妨げます。許可された処理でノートが読み取れる場合、バージョンと実際の変更説明を保持してください。そうでない場合、リリーステキストが検証できなかったことを報告してください。古いドキュメンテーションページは背景を提供するかもしれませんが、新しいリリースで何が変更されたかの証拠ではありません。
エージェントは、現在のポリシーまたは技術ドキュメントページを以前の保存されたバージョンと比較します。現在の実行中にチャレンジページが表示されます。このページを以前のドキュメントと直接比較すると、意味のない変更アラートが生成されます。
最後に検証されたドキュメントを歴史的観測として保持し、現在のチェックを未解決としてマークしてください。チャレンジテキストで上書きしたり、ソースが正常にチェックされたようにタイムスタンプを更新したりしないでください。現在のコンテンツが利用可能になると、2つの実際のドキュメントを比較してください。
不完全なリサーチ実行でも、欠落した証拠が表示され、残りの主張がサポートされていれば、有用なレポートを生成できます。
実行の終わりに、検証済みの発見と未解決の質問を区別してください。どの要求されたソースがチェックできなかったか、別のソースを使用したかを説明してください。1つの自動化された試行が失敗しただけで、ドキュメントが誰にとっても利用できないとラベル付けしないでください。
理由に基づいた制限なしにツールを繰り返し切り替えないでください。小さなソースギャップは手動レビューまたは後日の許可された試行を正当化するかもしれませんが、無限のソルバーコールを正当化するものではありません。適切な次のステップは、欠落した主張の重要性とユーザーの期限に依存します。
継続的なリサーチの場合、訪問したページの数ではなく、必要な主張に使用可能な証拠がどれだけあるかを測定してください。CAPTCHA関連のギャップを抽出エラーとは別に記録し、ワークフローの適切な部分を改善できるようにしてください。
ページ確認、サポートされているCAPTCHA処理、コンテンツ抽出、証拠レビューを同じリサーチ質問に関連付けてください。各段階は次の段階に明確な結果を残すべきです。
CapSolverは、認可されたリサーチブラウジングでのCAPTCHAステップをサポートできます。最終的なソースチェックは不可欠です。エージェントが実際に取得し、検証した資料のみが、要約や引用のサポートに使われるべきです。
Q: AIエージェントは、まだCAPTCHAを表示しているページを引用できますか?
そのページを未読の内容の証拠として引用すべきではありません。レポートでは、ソースが利用不可であることを特定できますが、事実的な主張には実際に取得されたセクションまたは別途検証された代替手段が必要です。
Q: 成功したソルバー結果は、リサーチを直ちに続けることができるのでしょうか?
アプリケーションはまずページを再確認する必要があります。期待されるドキュメントと関連セクションが利用可能であることを確認してから、コンテンツをリサーチノートに受け入れるべきです。
Q: フルページを開けない場合、検索スニペットで十分ですか?
スニペットはソースの場所を特定するのに役立ちますが、フルドキュメントとして静かに扱ってはいけません。タスクに詳細や現在の証拠が必要な場合、適切なソースを取得するか、制限を明記してください。
Q: チャレンジページを知識ベースに保存すべきですか?
通常の証拠収集から除外してください。運用診断に記録が必要な場合、限られた赤字付きのエントリを別途保存してください。これにより、後の取得時に証拠資料と混同されないようにします。
Q: 特定のエージェントフレームワークが必要ですか?
いいえ。これらのソースチェックは、ブラウザや検索ツールを使用する任意の研究ワークフローに適用できます。正確なCAPTCHAの統合は、その環境向けにサポートされているツールおよびドキュメンテーションに従う必要があります。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について