

🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Nov 17, 2026
更新されました Nov 17, 2026 · 最小読み取り
CAPTCHA を通過した後でも、レポートのエクスポートは失敗する可能性がある。ページが日付範囲をリセットしたり、誤ったレポートをキューに入れたり、PDF というファイル名なのにエラーページをダウンロードしたりすることがある。検証ウィジェットだけをテストしても、こうした不具合は検出できない。成功したダウンロードだけをテストすると、却下された検証にもかかわらずエクスポートが作成されてしまう、同じく重要なケースを見逃してしまう。
本ガイドは、自分たちが所有している、またはテストの権限を持つレポートダウンロード機能をテストする QA チーム向けである。目的は、CAPTCHA ステップを含む機能に対する、再現性のある受け入れテスト計画を作ることである。外部サイトからレポートをダウンロードするコレクターとは違い、ここではチームがテストデータ、期待される挙動、リリース基準をコントロールできる。CapSolver は、サポートされたソルバーがテスト対象ワークフローの一部となっている場合にのみ、この計画に含める。
成功したテストでは、「必要な検証が成功した後に、アプリケーションが意図したレポートを解放した」ことを確認しなければならない。
まず、識別しやすい小さなテスト用レポートから始める。例えば、特定のレコード構成を持つ 4 月のレポートを含むテストアカウントを作成する。そのレポートの期間、出力形式、期待されるカラム、特徴的な値を定義する。これらは実在顧客データに関する主張ではなく、フィクスチャの選択にすぎない。以前のエクスポートが誤って再利用されていないか検出できるよう、異なる値を持つ 2 つめのレポートも用意する。
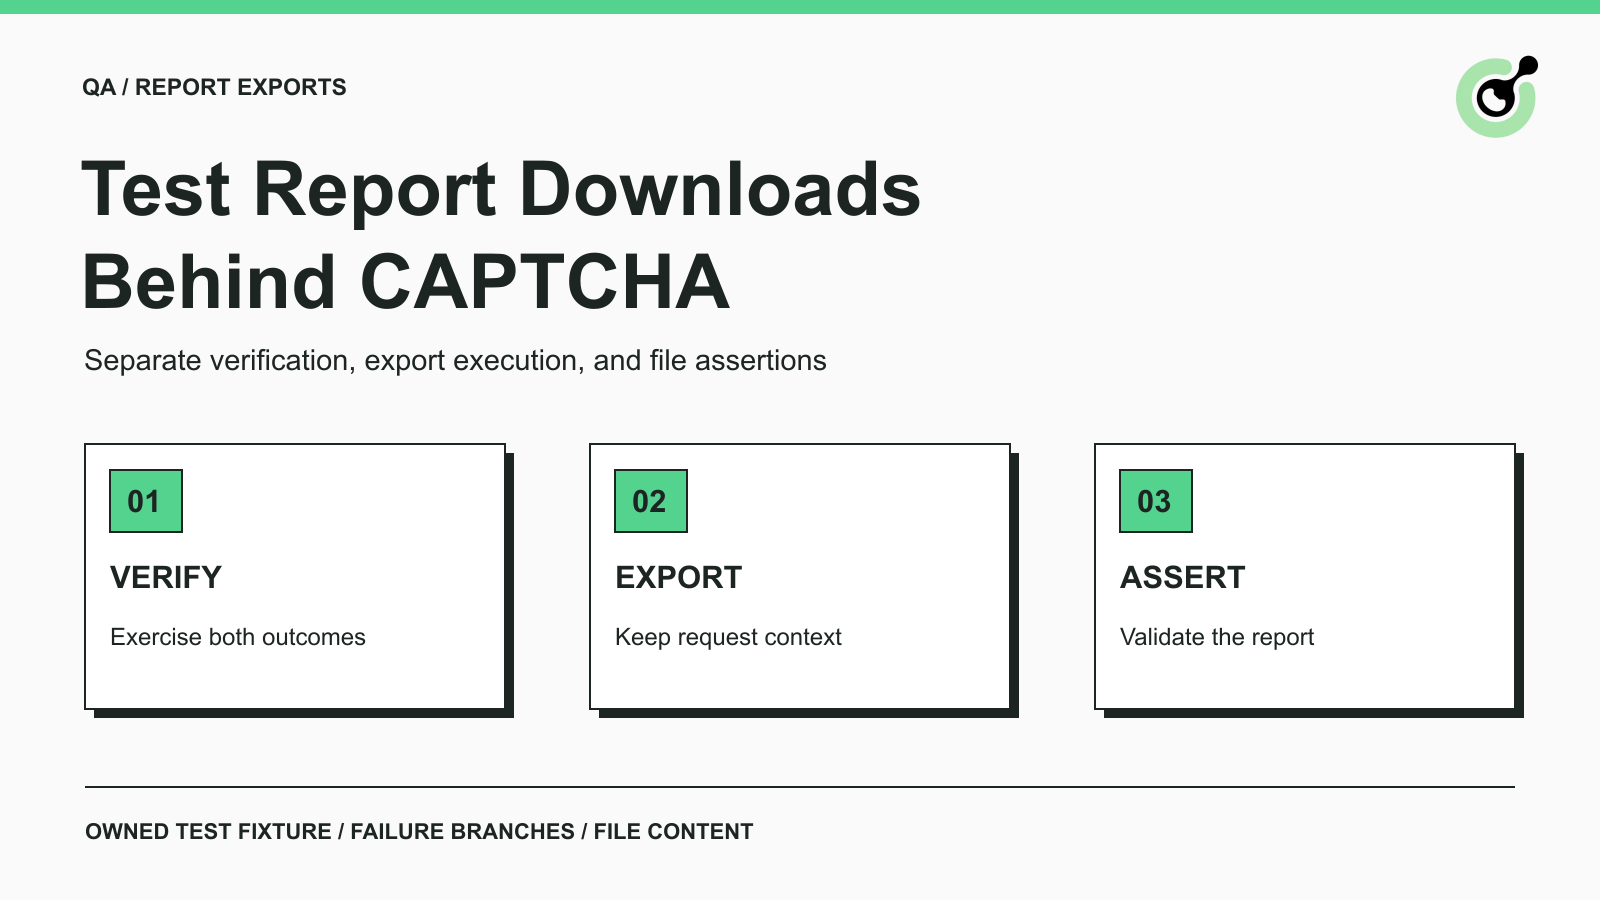
期待される結果を、次の 3 つのチェックポイントで記録する。
アサーションをファイル名だけに頼ることは避ける。ブラウザは、HTML レスポンスを拡張子 .pdf の名前で保存することがある。同様に、スプレッドシートは形式としては正しくても、中身が先月のレコードということもある。受け入れ基準は、ユーザーにとって意味のあるコンテンツを記述すべきである。
非同期エクスポートの場合は、ジョブの参照情報やユーザーから見える完了状態も定義する。テストレポート上では、検証結果とエクスポートジョブ結果を分けておく。そうすることで、どの段階で問題が発生したかが開発者にとって明確になり、ジョブ作成前なのか後なのかを判断しやすくなる。
日常的な回帰テストでは、隔離されたテスト環境で、予測可能な検証結果を扱うべきである。
reCAPTCHA v2 に対しては、Google のテストに関するガイダンスがテストキーを提供している。Turnstile では、Cloudflare がテスト結果用のダミーキーを提供している。利用しているプロバイダとバージョンに対して文書化されている仕組みを使うこと。他の CAPTCHA に対して、あるプロバイダのキーや挙動がそのまま適用できると想定してはならない。
プロバイダのテストキーは、アプリケーション側の連携を検証するのに役立つが、CAPTCHA ソルバーの本番精度を測るものではない。逆に、本番のチャレンジを繰り返し解くのは、すべてのエクスポートエラー分岐を決定論的にカバーする手段として適切ではない。
ウィジェットとサーバサイドの検証は、異なる責務を持つ。ブラウザテストでは、ユーザーが期待される UI フローを完了できるかどうかを確認する。アプリケーションテストでは、検証が成功した場合、失敗した場合、または完了できなかった場合に何が起きるかを確認する。
プロバイダのテスト設定で、必要な特定の失敗パターンが再現できない場合は、自分たちの検証境界にアプリケーション側で制御可能なテストダブルを導入する。その置き換えをテスト設定として文書化しておくこと。結果としてのテストを「ライブプロバイダによる検証」と表現してはならず、テスト専用設定が、通常のリクエストパラメータによって本番環境で有効化されないようにしておく。
有効な CAPTCHA 応答によって、他アカウントのレポート閲覧権限が得られてはならない。選択したレポートにアクセス権を持たないテストユーザーを用意し、アプリケーションがエクスポートを拒否し続けることを確認する。CAPTCHA は認可の代替にはならない。CAPTCHA 用語集は検証という概念を説明しており、レポートへの権限はあくまでアプリケーション側の責任にとどまる。
これらのテストには合成データを使用すること。現実的なスクリーンショットやサンプル出力が欲しいからといって、顧客レポートをダウンロードしてはならない。
テストマトリクスは、各検証結果を観測可能なエクスポート結果に結びつけるべきである。
| テスト条件 | 期待される検証の挙動 | 期待されるレポートの挙動 |
|---|---|---|
| 検証成功 | 認可済みフローを継続する | エクスポートは選択した期間、フィルター、形式と一致する |
| 検証拒否 | 定義された失敗状態を表示する | 新しいエクスポートもダウンロード可能なレポートも存在しない |
| 応答が欠落または期限切れ | 新たな検証の試行を要求する | ファイルを解放せずにレポート選択を保持する |
| 検証サービスが利用不能 | アプリケーションの一時的障害状態を表示する | エクスポートを黙って承認してはならない |
| 検証中にレポートフィルターが変更された | 文書化された製品ルールに従う | 確定した選択でエクスポートするか、または再確認を要求する |
| 検証後にエクスポートジョブが失敗 | 障害はエクスポート段階に結びつけたままにする | 誤った成功メッセージや不正なファイルを出さない |
| ダウンロード操作の繰り返し | 製品の重複リクエストポリシーに従う | 不要な重複処理や混在したレポート結果を発生させない |
最後の 2 行が重要なのは、CAPTCHA を解くことがステップの一部に過ぎないからである。ウィジェットテストに合格しても、リリースによってエクスポート機能が壊れる可能性は依然としてある。
フィルター変更時のルールは、自動化する前に文書化しておく。製品によっては、検証が保留中の間レポート選択を固定することもあれば、ユーザーに編集を許し、その後に再度確認を要求するものもある。どちらの設計もテスト可能である。問題なのは、文書化されていない混在ルールであり、これがテストを不安定にする。
繰り返し操作についても、すべてのエクスポートがイドンプテントであると決めつけないこと。プロダクトチームに、2 回目の操作でジョブを再利用すべきか、新たなジョブを作成すべきか、それとも無効化されたままにすべきかを確認する。その挙動を明示的にアサートし、テストによって新たな製品要件を押し付けないようにする。
CapSolver ボーナスコードを利用しよう
自動化予算を今すぐブースト!
入金時にボーナスコード CAP26 を利用すると、すべてのチャージに対して 5% のボーナス が無制限に付与されます。
今すぐ CapSolver ダッシュボード で引き換えましょう。
エクスポートテストでは、アプリケーションが完了を報告した後に、保存された成果物を検査する。
ブラウザフレームワークのダウンロードイベントを利用して、その操作によって生成されたファイルを特定する。例えば公式のPlaywright ダウンロードガイドでは、ブラウザコンテキストが閉じる前にダウンロード完了を待ち、保存する方法が説明されている。これはフレームワークの機能であり、あなたの特定のレポートワークフローがテストされた証拠ではない。
ファイルは、段階的に詳細度を上げて検査する。まずファイルが保存されたこと、その中身があること、その種類が妥当そうであることを確認する。そのうえで、期待される形式用のパーサで開く。最後に、レポート固有のフィールドをフィクスチャと突き合わせる。最初のチェックをパスしたからといって、コンテンツ比較を省略してよい理由にはならない。
CSV であれば、期待されるヘッダーと、安定したフィクスチャレコード集合を検証する。PDF であれば、文書が開けること、および期待されるレポート識別情報と集計期間を含んでいることを検証する。ワークブックであれば、関連するシートと既知のセルを確認する。エクスポートに生成時刻など変化するタイムスタンプが埋め込まれる場合は、バイト単位の完全一致は避け、安定したビジネス値を比較対象とする。
これらのチェックはテストレイヤー内にとどめること。ダウンロード成功を判断するために、レポートを CAPTCHA 認識 API に送信してはならない。CAPTCHA 画像認識とレポート内容抽出は別物の処理である。画像認識とトークンソルブの比較ガイドでも、この 2 つの CAPTCHA 結果タイプが区別されている。
ソルバー連携テストは、リリースされる正規の自動化処理がソルバーを実際に呼び出す場合に適切である。
管理されたページと、現在の API がサポートする CAPTCHA タイプを選ぶ。例えば reCAPTCHA v2 のタスクパラメータ のように、文書化されたタスク契約に従う。ソルバーアカウントキーは、サイトの公開キーやサーバの検証用シークレットとは分離して保持する。ソルバーの応答は、アプリケーション自身の検証の代替にはならない。
返却されたトークンを晒さずに、タスクの結果を記録する。タスクが非同期の場合は、文書化されたタスク結果ステートに従う。既存のタスクがまだ処理中だからといって、新しいタスクを作成してはならない。
解決結果を受け取ったら、アプリケーションの通常の認可された検証パスをそのまま辿り、決定論的テストと同じレポート検証を行う。ソルバー検証が答えるべき問いは、「この設定済み環境が、必要なステップを完了し、期待されるテストレポートを配信できるかどうか」である。
この検証は、通常の回帰テスト結果とは切り離し、実行時間にも上限を設ける。プロバイダエラー、アカウント問題、ネットワーク中断などが、レポートフォーマッタの不具合として誤報されてはならないし、逆にソルバー呼び出しが成功したからといって、エクスポートの失敗を覆い隠してもならない。
役に立つ障害記録は、機微情報を開示することなく、どのチェックポイントで失敗したかを次に担当するエンジニアに伝える。
テストケース、環境、アプリケーションビルド、テスト用レポート識別子、選択されたフィルター、最後に完了したチェックポイントを記録する。アプリケーションがエクスポートジョブ参照を提供している場合は、それも含める。関連するエラー状態のマスク済みスクリーンショットや、成果物が生成された場合はファイル検証エラーも保存しておく。
ソルバーの生認証情報、CAPTCHA トークン、プライベートなレポート内容、セッションクッキーなどは、日常的なテストレポートに含めないこと。ファイル名、Content-Type の観察結果、パーサエラーといった情報だけで、完全な文書を保持せずとも問題を説明できる場合が多い。完全な合成フィクスチャが必要な場合は、チーム既存の制限付き成果物ストレージを利用する。
障害を再現する際には、レポートフィクスチャをリセットし、新たな検証試行を行う。以前の実行からトークンを再利用してはならない。Google の応答検証に関する文書では、トークンの有効期間と一回限りの使用ルールが説明されており、他のプロバイダにもそれぞれ独自のルールがある。
リリース基準は、ユーザーの結果にフォーカスするべきである。「正しいレポートが、正しいスコープで、必要な検証の後に提供されるかどうか」だ。予測可能なテスト結果はアプリケーションロジックをカバーし、必要な場合は別枠のソルバー検証がサポートされた連携をカバーする。CapSolver は、そのソルバーステップを担うことはできるが、エクスポート成功の定義そのものになってはならない。
Q: すべてのレポートダウンロードテストで、ライブの CAPTCHA ソルバーを呼び出すべきですか?
いいえ。通常の回帰テストでは、文書化されたプロバイダのテストモードか、制御されたアプリケーションテストダブルを使用すべきである。ライブソルブは、実際に検証が必要な連携挙動に対してのみ追加する。
Q: CAPTCHA が成功したことは、レポートが正しいことの証明になりますか?
いいえ。エクスポートジョブを検証し、ダウンロードされた成果物を、選択されたレポート、フィルター、期間、および期待されるテストレコードに照らして確認する必要がある。
Q: CAPTCHA 検証が失敗した場合は、どうなるべきですか?
アプリケーションは、保護されたレポートを解放することなく、定義された失敗フローに従うべきである。その失敗した試行から、エクスポートやダウンロードリンクが利用可能にならないことをテストする。
Q: レポート権限チェックの代わりにソルバーを使えますか?
いいえ。CAPTCHA ソルバーがレポートへのアクセス権を付与することはない。アプリケーションは、CAPTCHA の結果とは独立して、自身の認可ルールを強制しなければならない。
Q: 公開レポートを自動取得する場合とは、どう違うのですか?
本ガイドがテストするのは、自分たちのチームがコントロールするレポートエクスポート機能である。外部レポート収集には、ソースの可用性やドキュメントの真正性といった別の懸念事項があり、ソースアプリケーションの検証ロジックをチーム側で制御することはできない。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
LLMベースのCAPTCHAソルバーで何ができるのか、ビジュアルリスニングがどこで限界に直面するのか、そして認可されたブラウザーエージェントのワークフローにおいて、どのように受け入れられた結果を評価するかを学びましょう。
AIエージェントにおけるMCP CAPTCHAのキャンセル処理を行う。新規呼び出しを停止し、リモートタスクとローカル待機を区別し、遅延した結果によって作業が再開されないようにする。
