
🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み May 21, 2026
更新されました May 21, 2026 · 最小読み取り
前回の記事では、エージェンティック・ブラウザが受動的な「表示ツール」から能動的な「アクションエージェント」へとどのように変化するのかを紹介しました。そこで私たちは、意図の理解、環境認識、アクション実行という中核アーキテクチャを検討しました。しかし、これらのデジタルエージェントが現実世界のウェブをナビゲートする際、CAPTCHA チェックポイントが本来は妥当なワークフローを中断してしまうことがあります。本記事では、「見えないエンジン」――すなわち、認可されたエージェントが一時停止し、必要なタスクコンテキストを送信し、結果を検証してから継続できるようにする CAPTCHA 解決インフラストラクチャに焦点を当てます。なぜ CAPTCHA チェックポイントが AI にとって一般的な運用上の課題となるのか、そして CapSolver のような専用サービスが、次世代の認可されたウェブ自動化をどのように支えているのかを見ていきます。
責任ある利用について: CapSolver は、法的に認められた正当な自動化目的にのみ利用されることを想定しています。これには、あなたが所有している、またはアクセス許可を得ているシステムのテストが含まれます。不正行為、偽アカウント作成、無許可の購入、スパム、アクセス制御の乱用などへの利用は禁止されており、CapSolver 利用規約 に違反します。
次のようなシナリオを想像してみてください。QA チームが、自社が所有するステージング環境で複数ステップのフォーム送信をエージェンティック・ブラウザに依頼します。エージェントはページを開き、必要なフィールドを特定し、送信前に CAPTCHA チェックポイントに到達します。ワークフローは、認証が完了するまで一時停止します。インターネット黎明期に生まれたこの「チューリングテスト」である CAPTCHA は、認可された AI エージェントのワークフローにとって、実務上の信頼性課題となっています。
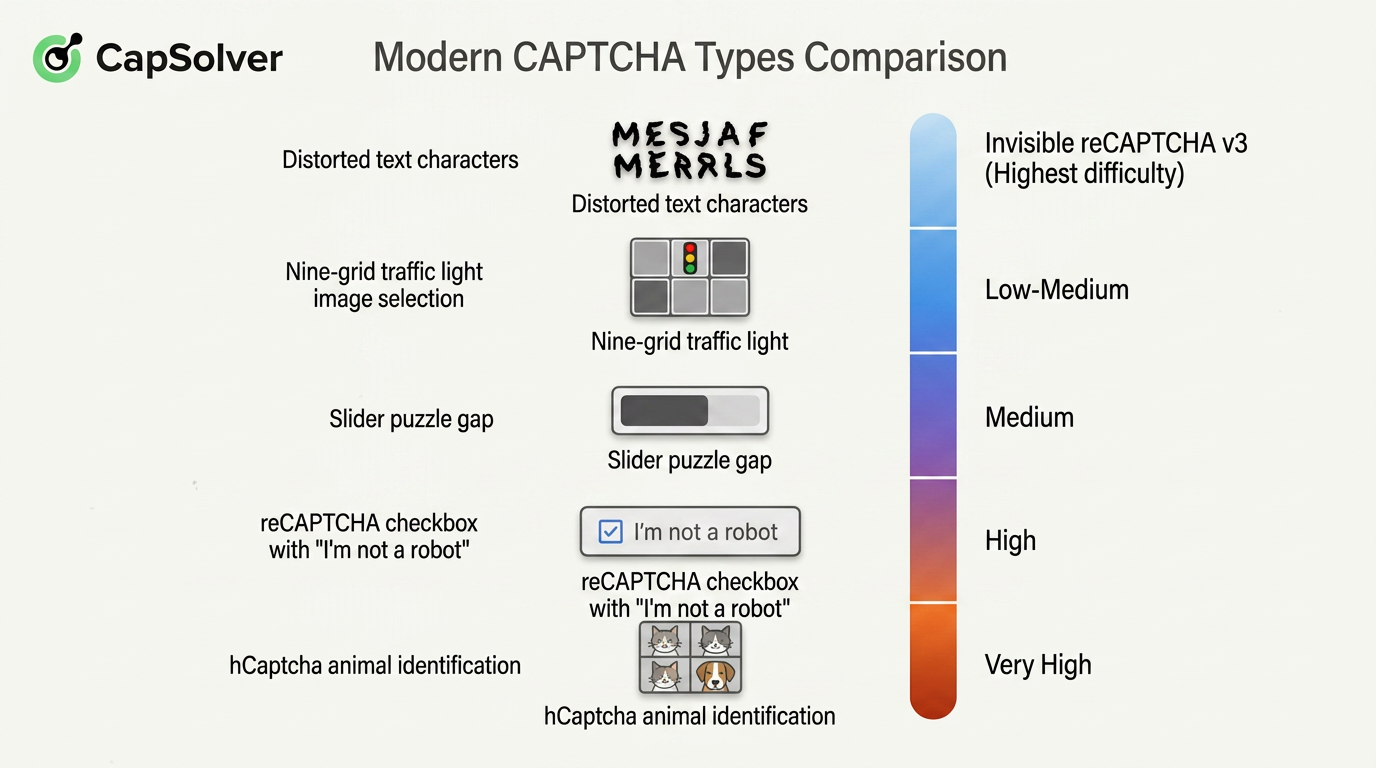
CAPTCHA は “Completely Automated Public Turing Test to Tell Computers and Humans Apart(コンピュータと人間を判別するための完全自動化公開チューリングテスト)” の略です。その本来の目的は単純で、「ボットを締め出し、人間を通す」ことでした。しかし AI の進化とともに CAPTCHA も進化し続け、単純な歪んだ文字から、複雑なスライダー、画像選択タスク、さらには行動解析システムにまで発展しました。もはや単なる文字認識の問題ではありません。
従来型の自動化スクリプトにとって、CAPTCHA チェックポイントはワークフローを完全に停止させる要因となり得ます。エージェンティック・ブラウザにとっても、以下の3つの主要な運用上の課題を生じさせます。
知覚難易度の劇的な上昇: もっとも高度なマルチモーダルモデルでさえ、激しく歪んだテキスト、ぼやけた画像中の物体、複雑な背景に埋もれたスライダーの隙間を安定して認識することは困難です。AI は単純に「見誤る」可能性があり、1回のミスがワークフロー全体を破綻させることもあります。
多層化された検証シグナル: 現代の CAPTCHA は、もはやフロントエンド上のチャレンジだけではありません。サイト側はマウス軌跡、タイピングのリズム、ページ滞在時間、ブラウザコンテキストなど、セッション全体のシグナルを評価する場合があります。リクエストがサイトのアクセス方針を満たさない場合、追加の検証が求められることがあります。
時間制約とコンテキスト分断: CAPTCHA には有効期限が設定されていることがほとんどです。エージェンティック・ブラウザが複数ステップのタスク途中で CAPTCHA チェックポイントに長時間留まると、ログインセッションが期限切れとなり、タスクチェーンを最初からやり直す必要が生じる場合があります。
言い換えると、エージェンティック・ブラウザには、CAPTCHA チェックポイントで制御された形で一時停止し、記録された入力を送信し、検証が成功してからのみ再開できる仕組みが必要です。こうした理由から、CapSolver のような CAPTCHA 処理インフラストラクチャは、認可されたブラウザワークフローの一部になり得ます。
CapSolver は一般ユーザー向けのツールではなく、開発者のツールキットの奥深くに隠れた「CAPTCHA エンジン」です。その中核は、各種 CAPTCHA を処理するために設計された API インターフェースを提供する、インテリジェントな CAPTCHA 解決プラットフォームです。これは自動化プログラムや AI エージェントがさまざまな種類の CAPTCHA に対応できるようにするものです。
これは、24時間365日待機し、疲れることなく超高速で動作する CAPTCHA 解決チームと考えることができます——ただし、その「チームメンバー」は高度な AI モデルだけでなく、最適化された戦略アルゴリズム群でも構成されている点が異なります。
その能力をより理解しやすくするために、同一の CAPTCHA 課題に直面したときの従来手法と CapSolver の違いを、次の比較表にまとめます。
| 比較項目 | ローカル OCR / 単純モデル | 人力 CAPTCHA 解決プラットフォーム | CapSolver |
|---|---|---|---|
| 対応可能な CAPTCHA タイプ | 単純な文字 CAPTCHA のみ。画像選択にはほぼ無力 | 理論上すべて対応可能だが、遅く高コスト | 主流のCAPTCHA タイプを網羅 |
| 認識速度 | ミリ秒単位だが成功率は低い | 1 回あたり 5〜15 秒 | 1〜3 秒程度 |
| 成功率 | 低い(複雑な CAPTCHA ではさらに悪化) | 相対的に高いが、作業者の疲労やネットワーク遅延の影響を受けやすい | 高く安定 |
| コスト構造 | 一度きりの開発コスト | タスク毎の従量課金(人的コストが高い) | タスク毎の従量課金(低価格・限界コストも低い) |
| ブラウザワークフローへの統合 | 個別のカスタム実装が必要 | 別途タスク調整の仕組みが必要 | ブラウザ環境と統合し、記録されたタスク結果を返却可能 |
表1-1 従来の CAPTCHA 解決手法と CapSolver の比較
CapSolver は、CAPTCHA の種類ごとに特化した処理パイプラインを用意しています。
画像・テキスト認識系 CAPTCHA: 自社開発のビジョンモデルと大規模な学習データセットを組み合わせることで、強く歪んだ文字、重なり合った文字、ノイズの多い文字列も高精度に認識します。
スライダー系・パズル系 CAPTCHA: 選択されたチャレンジタイプに応じた記録済みのタスクフローを踏まえて処理し、認可されたクライアントワークフローが適用可能な結果を返します。
トークンベースの認証システム(reCAPTCHA v2/v3、Cloudflare など): これらのシステムは、必要なタスクパラメータが送信された後にワンタイムトークンを返す場合があります。CapSolver はサイト URL、サイトキー、サポートされるオプションコンテキストなどの記録された入力を使用し、認可されたクライアントワークフローが送信可能な結果を返却します。
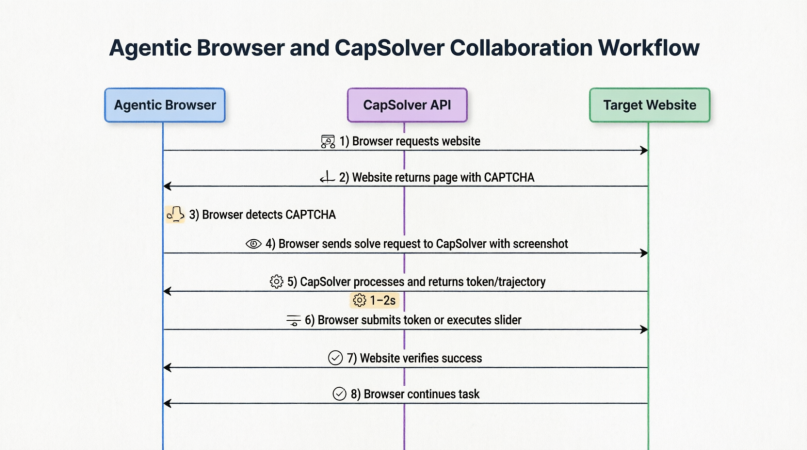
では、実際に CapSolver とエージェンティック・ブラウザはどのように連携するのでしょうか。次の図は、その全体プロセスを示しています。
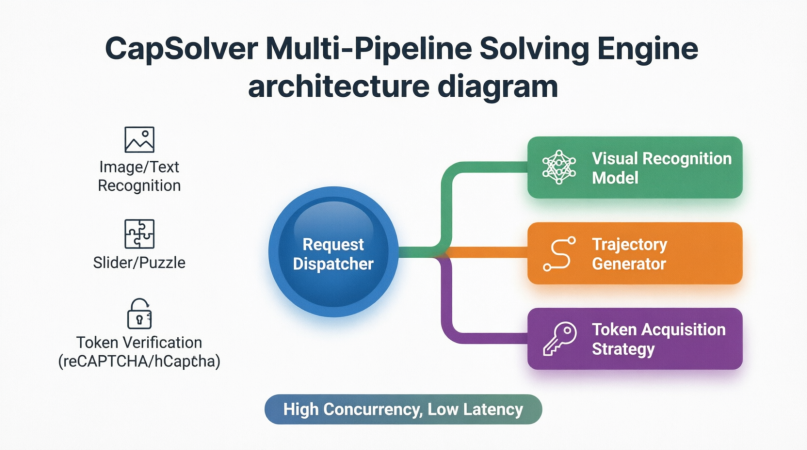
ブラウザが CAPTCHA に遭遇し、必要なタスクコンテキストを収集し、CapSolver API を呼び出し、サポートされた結果を受け取り、検証を送信し、元のタスクを再開するまで、ワークフローは密接に統合されており、通常 1〜2 秒以内に完了します。
これはつまり、エージェンティック・ブラウザにとって CAPTCHA はもはや AI 自身が「見て」「当てる」必要のある問題ではなくなったことを意味します。代わりに、それらは専門インフラプロバイダーにアウトソースされた標準化タスクとなります。ブラウザ側はチャレンジをキャプチャし、必要なコンテキストをパッケージ化して送信し、結果を待ち、ページ状態を検証してから続行すればよいだけです。
ここで、エージェンティック・ブラウザの動的適応モジュールと CapSolver を接続し、制御された CAPTCHA 処理ワークフローを見ていきます。このプロセスは、あなたが所有している、または自動化の明示的な許可を得ているサイトでのみ利用してください。
エージェンティック・ブラウザがタスクを実行している間、その環境認識レイヤーは常にウェブページを監視しています。CAPTCHA 要素(たとえば reCAPTCHA iframe を含むポップアップ)が検出されると、アクション実行は即座に一時停止され、専用の CAPTCHA 処理サブプロセスがトリガーされます。
このプロセスは高度に洗練されており、一般的に次のステップを含みます。
コンテキスト収集: エージェンティック・ブラウザは CAPTCHA 領域のスクリーンショットを取得し、現在の URL、sitekey、ブラウザのビューポートサイズ、User-Agent などの周辺情報を収集します。
タスク送信: スクリーンショットとパラメータはひとまとめにされ、CAPTCHA タイプを指定したうえで API 経由で CapSolver に送信されます。
バックグラウンド解決: タスクを受信すると、CapSolver はそれを該当する解決パイプラインにルーティングします。たとえば reCAPTCHA v2 の場合、専用ソルバーを呼び出し、有効な g-recaptcha-response トークンを返します。解決プロセス全体は通常 1〜2 秒以内に完了します。
結果返却: エージェンティック・ブラウザは、サポート対象タスクタイプに応じて指定された結果(トークン文字列など)を受け取ります。
オンサイト適用: エージェンティック・ブラウザは、記録されているコールバック、フィールド、クライアント側ハンドラーなどを通じて返された結果を適用します。ページ側で認証が確認されると、認可されたタスクフローは再開可能になります。
状態検証: ブラウザは、ページが正常に認証を通過したか、ターゲット要素が再表示されているかを確認してから、中断していたワークフローを続行します。
重要なのは、現代の CAPTCHA には多様な形態と複雑性レベルが存在することです。次の図は、主流の CAPTCHA タイプを分類し、それぞれの複雑性レベルを示したものです。
エンドユーザーにとって、この一連のプロセスは完全に透過的です。エージェンティック・ブラウザのタスクログには、次のような簡単なメッセージが表示されるだけかもしれません。
「reCAPTCHA v2 を検出しました。1.2 秒で自動解決しました。」
従来であれば自動化ワークフローを停止させていたチェックポイントは、バックグラウンドで処理され、タスクログに記録されます。
これにより、AI エージェントのワークフロー連続性が向上します。エージェントは、ページやセッションコンテキストを保持しながら、認可された環境内のサポート対象検証チェックポイントを処理できます。CAPTCHA 解決インフラは、制約された観測可能なワークフローの内部で「見えないエンジン」として機能するのです。
制御された処理経路がなければ、CAPTCHA ポップアップは、妥当な自動化タスクであっても依然として中断させる原因となり得ます。
ここまでの説明で、この技術がどこか遠い存在に感じられたかもしれません。ですが、次の事例は、その印象を大きく変えるでしょう。エージェンティック・ブラウザは、未来の抽象概念ではなく、すでにパーソナル生産性、企業自動化、データ収集という3つの主要領域へ急速に浸透しつつあります。それぞれの領域で、異なるレベルの実務的な課題解決に貢献しています。
次の図は、エージェンティック・ブラウザの中核的な利用シナリオをまとめたものです。
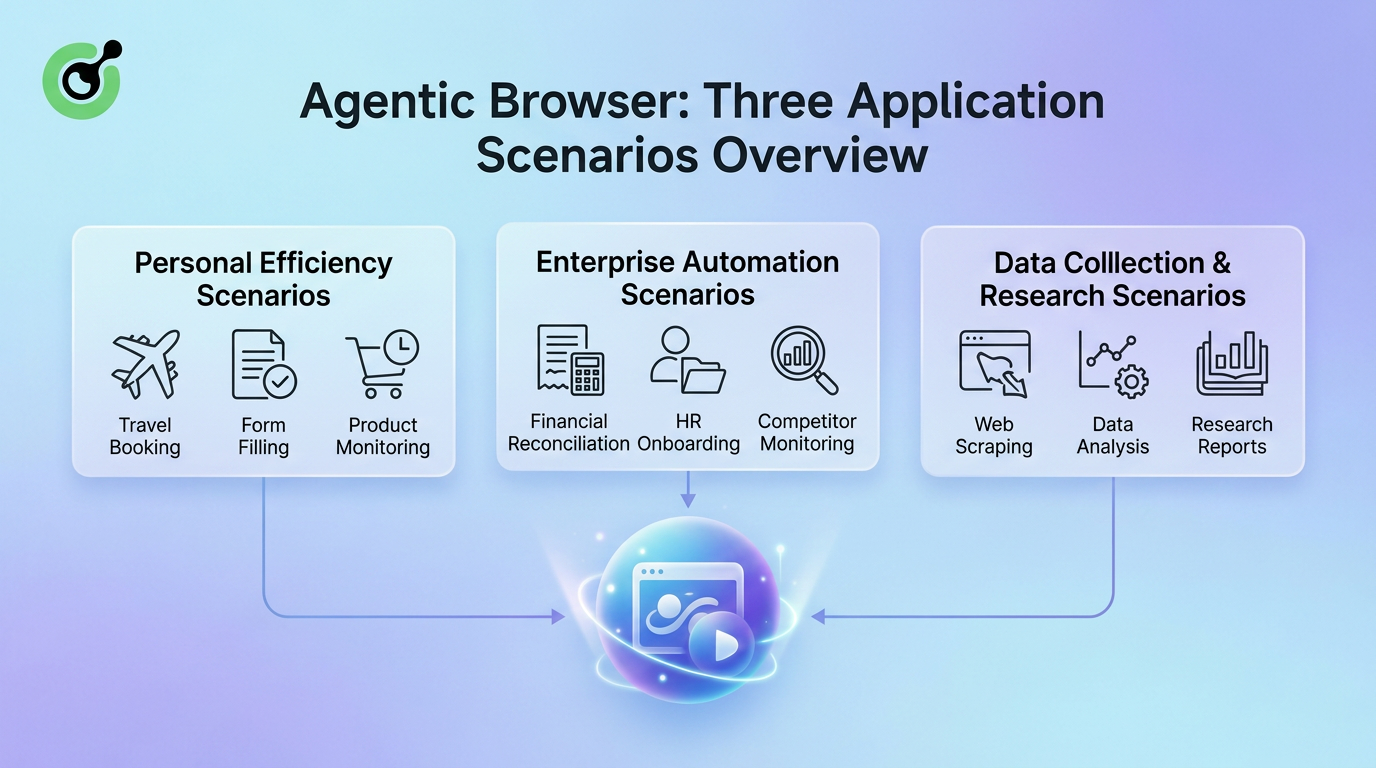
エージェンティック・ブラウザの応用範囲は、個人ユーザーから大企業まで、日常的なタスクから専門的な研究ワークフローにまで及びます。パーソナル生産性の分野では、旅行予約、反復的なフォーム入力、商品の価格変動モニタリングなどを支援します。企業自動化の分野では、財務照合、従業員オンボーディング、競合他社の動向追跡などに対応します。データ収集・リサーチの分野では、疲れ知らずのクローラー兼インテリジェント分析アシスタントとして機能します。
次に、これら3つのシナリオを順に見て、エージェンティック・ブラウザが実際にどのように「仕事をこなしている」のかを理解していきます。
一般ユーザーにとって、エージェンティック・ブラウザのもっとも直接的な価値は、時間の節約です。
日々、人々はブラウザ上で無数の反復的かつ複数ステップのオンラインタスクを行っています。これらのタスクには、以下の3つの共通点があります。
エージェンティック・ブラウザがもっとも得意とするのは、まさにこのタイプのタスクです——ユーザーは「何をしたいか」はわかっているが、その作業を自分の手で行いたくはない状況です。
パーソナル生産性のシナリオにおいて、エージェンティック・ブラウザは次のような典型的タスクを支援できます。
たとえば、エージェンティック・ブラウザは複数のフライトやホテルの選択肢を比較し、時間帯、好み、予算などに応じてフィルタリングしたうえで、選択された候補をユーザーが確認・承認しやすい形で整理できます。
ビザ申請、学校出願、経費精算などのタスクでは、同じ情報を複数のフォームに何度も入力する必要があります。
エージェンティック・ブラウザは「情報マネージャー」として機能し、ユーザーデータを安全に記憶し、フォームフィールドを自動的に認識し、賢くマッピングします。たとえば、フルネームを自動的に「First Name」と「Last Name」に分割するといったことが可能です。
エージェンティック・ブラウザは、商品の在庫状況、価格変動、新商品のリリースなどをバックグラウンドで監視できます。あらかじめ設定した条件(値下げや再入荷など)が満たされると、ブラウザはすぐにユーザーへ通知します。
ユーザー体験の変化をわかりやすく示すために、従来のワークフローとエージェンティック・ブラウザ利用時のワークフローを、次の表で比較します。
| タスク種別 | 従来ワークフローの時間コスト | エージェンティック・ブラウザ利用時 | ユーザー役割の変化 |
|---|---|---|---|
| 航空券の比較・予約 | 15〜30 分(複数サイトを手動で閲覧) | 1 分(要件を伝え、提案を確認) | 実行者 → 意思決定者 |
| 複雑なオンラインフォームの入力 | 20〜40 分(同じ情報を何度も入力) | 2 分(自動入力結果の確認と微調整) | データ入力作業者 → チェッカー |
| 商品の再入荷・値下げ監視 | 非常に時間がかかる(手動で更新・常時監視) | 0 分(バックグラウンド監視と自動通知) | 監視者 → 受信者 |
| クロスプラットフォームのデータ整理 | 1〜2 時間(コピペと整形の繰り返し) | 5 分(自動抽出とフォーマット) | 手作業オペレーター → アナリスト |
表2-1 従来のパーソナルタスクとエージェンティック・ブラウザの効率比較
このように、エージェンティック・ブラウザは事実上「パーソナルアシスタント」として機能します。ユーザーを「ワークフローの作業者」から解放し、「目標設定者」かつ「結果のレビュー担当者」へと変えてくれます。
パーソナル生産性の向上が「手間の削減」であるとすれば、企業環境におけるエージェンティック・ブラウザの価値は、つながりの創出にあります。
大規模な組織では、API で容易に統合できない多数の分断されたレガシーシステム、SaaS プラットフォーム、サプライヤーポータルに依存していることがよくあります。従業員はシステム間で何度も情報を手動で転記する「人間の糊」とならざるを得ません。
まさにこの点で、Agentic Browser は最も大きな強みを発揮します。
明示的な許可がある場合、Agentic Browser は組織が管理する財務ポータルやサプライヤーポータルにアクセスし、承認済みの記録を取得して ERP システムと突き合わせ、不整合レポートを生成し、レビュー用の通知文案を作成できます。
組織側であらかじめオンボーディングタスクのパッケージを定義できます。組織管理下のシステムと承認済みのアクセス方針の範囲内で、Agentic Browser は HR・IT システムをまたいだ権限付与やアカウント作成のステップを、許可された範囲で準備・実行できます。
Agentic Browser は、自動アクセスが認められている公開ページを巡回し、関連する情報の変化を検知し、適用される利用規約やレート制限の範囲内で、それらを構造化データベースに保存する「マーケットレーダー」として機能できます。
エンタープライズ自動化における Agentic Browser の独自の立ち位置をより明確にするため、以下の表では、手動オペレーションや従来型 API 連携と比較しています。
| 次元 | 手動オペレーション | API 連携開発 | Agentic Browser |
|---|---|---|---|
| 対応可能なシステム | 利用者にアクセス権があるあらゆるシステム | 公開 API を持つシステムのみ | 組織管理のレガシーシステムを含む、認可済みの Web ベースシステム |
| 導入サイクル | 開発は不要だが、工数は大きい | 数週間〜数か月(開発リソースに依存) | 数時間〜数日(タスク設定とテスト) |
| 柔軟性 | 高い(人間が動的に適応) | 低い(変更のたびにインターフェース改修が必要) | 高い(AI がページ変更に動的に適応) |
| CAPTCHA・ログイン対応 | 手作業での対応が必要 | 直接扱うのは困難な場合が多い | 認可済みワークフロー内で、設定された CAPTCHA 対応を呼び出し可能 |
| スケーラビリティ | 低い | 非常に高い | 高い(タスクの並列実行が可能) |
| 典型的な失敗シナリオ | 人為的な疲労・記入漏れ | API レート制限やバージョン非互換 | ページが極端にカオスな場合、人間の確認を要することがある |
表 2-2 企業のシステム横断自動化ソリューション比較
上記のとおり、Agentic Browser は API を置き換えるために設計されたものではありません。むしろ、API が存在しない、あるいは実装コストが高すぎる状況において、軽量な統合レイヤーとして機能します。
AI の柔軟性と適応力を活用することで、Agentic Browser は従来型自動化では埋めきれなかった隙間を補完し、レガシーインフラを作り直すことなく、企業がインテリジェントなシステム間連携を実現できるようにします。
データはしばしば「デジタル時代の石油」と形容されますが、クリーンな公開 Web データを効率よく収集することは、これまでも常に困難でした。
従来の Web クローラーは固定的なパースルールに依存しています。対象サイトがレイアウトを刷新したり、追加検証を要求するようになると、クローラーは完全に動かなくなる場合があります。自動収集は、アクセスが許可され、かつサイトの適用される利用規約に沿う場合にのみ継続されるべきです。学術研究者、マーケットリサーチ企業、調査報道チームなどは、多数の公開 Web ページから特定情報を抽出する必要があり、従来手法ではコストと時間がかかりすぎます。
Agentic Browser は、データ収集にまったく新しいパラダイムをもたらします。
「コード上のルール」に基づく抽出から、「意味的な目的」に基づく抽出へのシフト。
一般的なワークフローは次のように動作します。
研究者は、必要なデータの次元やサンプル範囲を自然言語で記述します。たとえば:
「上位 100 件の EC 商品ページから、スポンサー枠の商品を除外して、商品名、価格、評価、レビュー件数を抽出してください。」
Agentic Browser は自律的に Web ページを遷移し、環境認識を通じて関連する情報ブロックを特定し、データを知的に抽出・構造化するとともに、ページネーション、無限スクロール、ポップアップといった複雑なインタラクションも処理します。
対象サイトがレイアウトを刷新すると、従来のクローラーはたちまち機能不全に陥ることが多い一方で、Agentic Browser は視覚的に情報を再特定し、処理を継続しようと試みます。
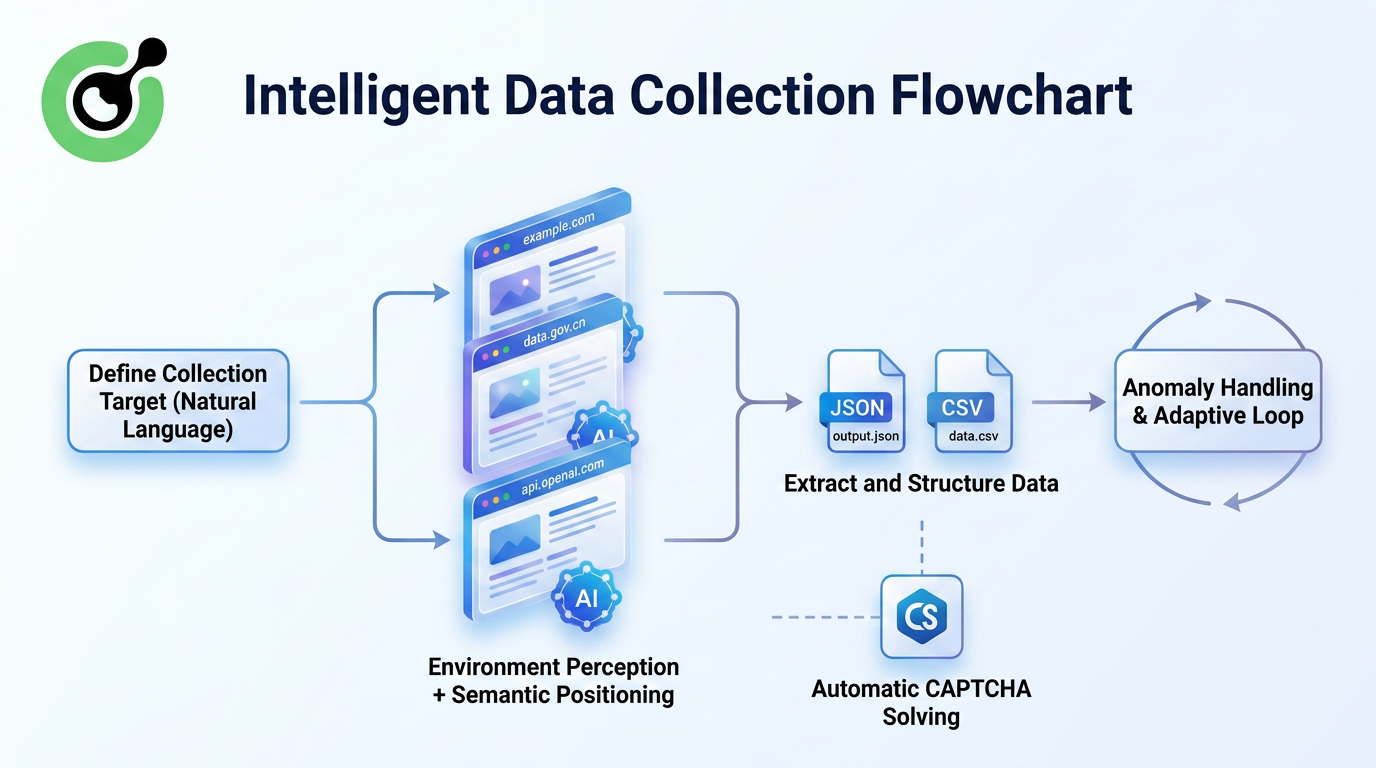
このアプローチは、いくつかの本質的な改善をもたらします。
AI は、固定的な HTML クラス名に依存するのではなく、「価格」が意味的にどう見えるかを理解します。
レイアウトの軽微な変更で抽出パイプラインが即座に壊れることがなくなります。
ログインが必要な認可済みサイトや、無限スクロール・タブ切り替えを伴うサイトであっても、Agentic Browser はサポートされたブラウザ操作と承認済みセッションを用いてから、許可された情報の抽出を行えます。
タスク設定は保存・共有できるため、データ収集プロセスを標準化し、再現可能にできます。
データ収集タスクにおける耐障害性という点での Agentic Browser の優位性をより分かりやすく示すため、次の図では、複数回のサイトリニューアル後における従来型クローラーと Agentic Browser の比較を行っています。
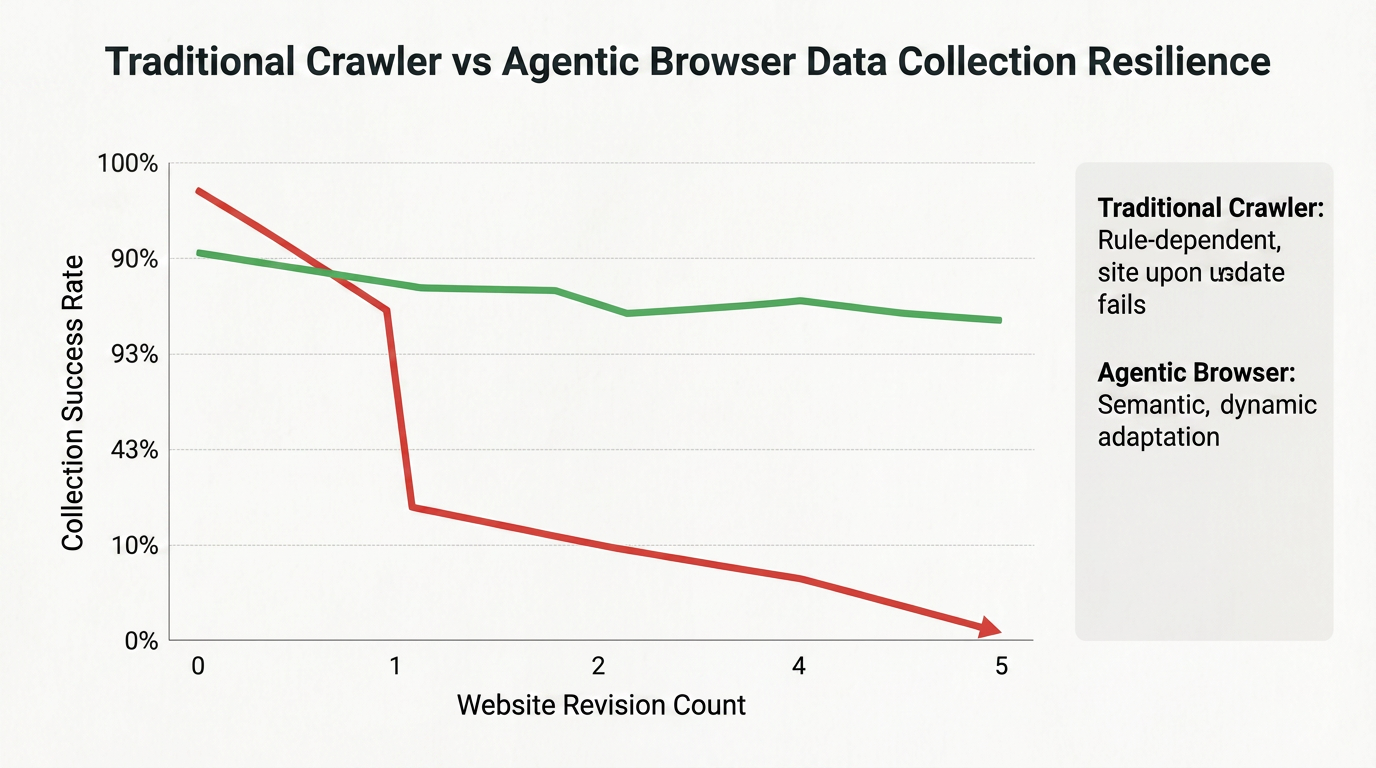
従来型クローラーは、最初のサイトリニューアル後に成功率が急激に低下する一方で、Agentic Browser は視覚的ローカライゼーションと意味理解能力のおかげで、複数回のリニューアル後でも比較的高い抽出成功率を維持します。
この耐障害性により、長期的かつ大規模なデータ収集プロジェクトに理想的な手段となります。
たとえば、30 か国・200 の政策関連サイトにまたがって特定の条文を比較する必要がある社会科学の研究チームを想像してみてください。従来であれば、リサーチアシスタントが数か月を費やして手作業で情報をコピーし、整理する必要がありました。
今では、研究者は Agentic Browser のタスクを設定し、適用される利用規約とレート制限の範囲内で公開された政策ページを訪問させ、対象キーワードを含むページを特定し、関連条文を抽出・分類させることができます。
研究者は最終的な収集結果をレビュー・分析するだけでよくなり、貴重な人的リソースを、反復的な「手作業での運搬」ではなく、本来の「研究」そのものに集中させることができるのです。
Agentic Browser は、単なる新しいプロダクトというだけでなく、「オンラインであること」の哲学そのものを一新する存在です。その中核となるロジックは「ブラウザは、クリックを待つだけのインターフェースではなく、ユーザーの意図を理解し、タスク完了を支援するインテリジェントなエージェントであるべきだ」というものです。技術的な実装の観点から見ると、タスクを計画するための大規模言語モデルの推論能力、Web ページを理解するためのマルチモーダル認識、実際のブラウザ環境による操作実行、そして認可された自動化の中でサポート対象の認証チェックポイントを処理するための CapSolver のようなインフラに依存しています。これらの技術が融合することで、過去 30 年間使われてきた「情報の窓」は、真の「アクションプラットフォーム」へとアップグレードされつつあります。
Q1: なぜ汎用 AI モデルだけでは CAPTCHA を解決できないのですか?
A1: 汎用 AI モデルは強力ですが、CAPTCHA はそもそも対抗的に設計され、常に変化し続けるよう作られています。これを安定的かつ高速に解くには、この単一のタスクに特化した CapSolver のような専用インフラが必要になります。
Q2: CapSolver は Agentic Browser をどのように支援しますか?
A2: CapSolver は、ドキュメント化された API 経由でサポート対象の CAPTCHA チャレンジを処理する「見えないエンジン」として機能します。これにより、認可された Agentic Browser のワークフローは、必要なタスクコンテキストを送信し、結果を適用し、ページ状態を検証し、処理を継続できます。
Q3: Agentic Browser は人間の仕事を奪ってしまいますか?
A3: これは「仕事」を置き換えるのではなく、「タスク」を置き換えるために設計されています。反復的なデジタル作業を引き受けることで、人間はより高度な創造性や戦略的な意思決定に集中できるようになります。
Q4: 今日から Agentic Browser を使い始めるにはどうすればよいですか?
A4: すでに多くの実験的なブラウザや拡張機能が利用可能です。最良の体験を得るには、自分が所有している、もしくは自動化する権限を持つシステムにおける、サポート対象のチェックポイントに対してのみ、CapSolver のような信頼できる CAPTCHA 解決サービスを利用してください。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
ローカル環境では動作するがクラウド上のAIエージェントでは失敗するCAPTCHA処理を修正してください。ブラウザの設定、依存関係、認証情報、ネットワークアクセス、およびページの状態を比較してください。
Claude CodeでCapSolver MCPを設定し、利用可能なCAPTCHAツールを確認し、サポートされており、認証されたブラウザタスク用にトークンまたはページ解決を選択してください。