🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Emma Foster
Machine Learning Engineer
已发表 Nov 16, 2026
已更新 Nov 16, 2026 · 最小阅读量
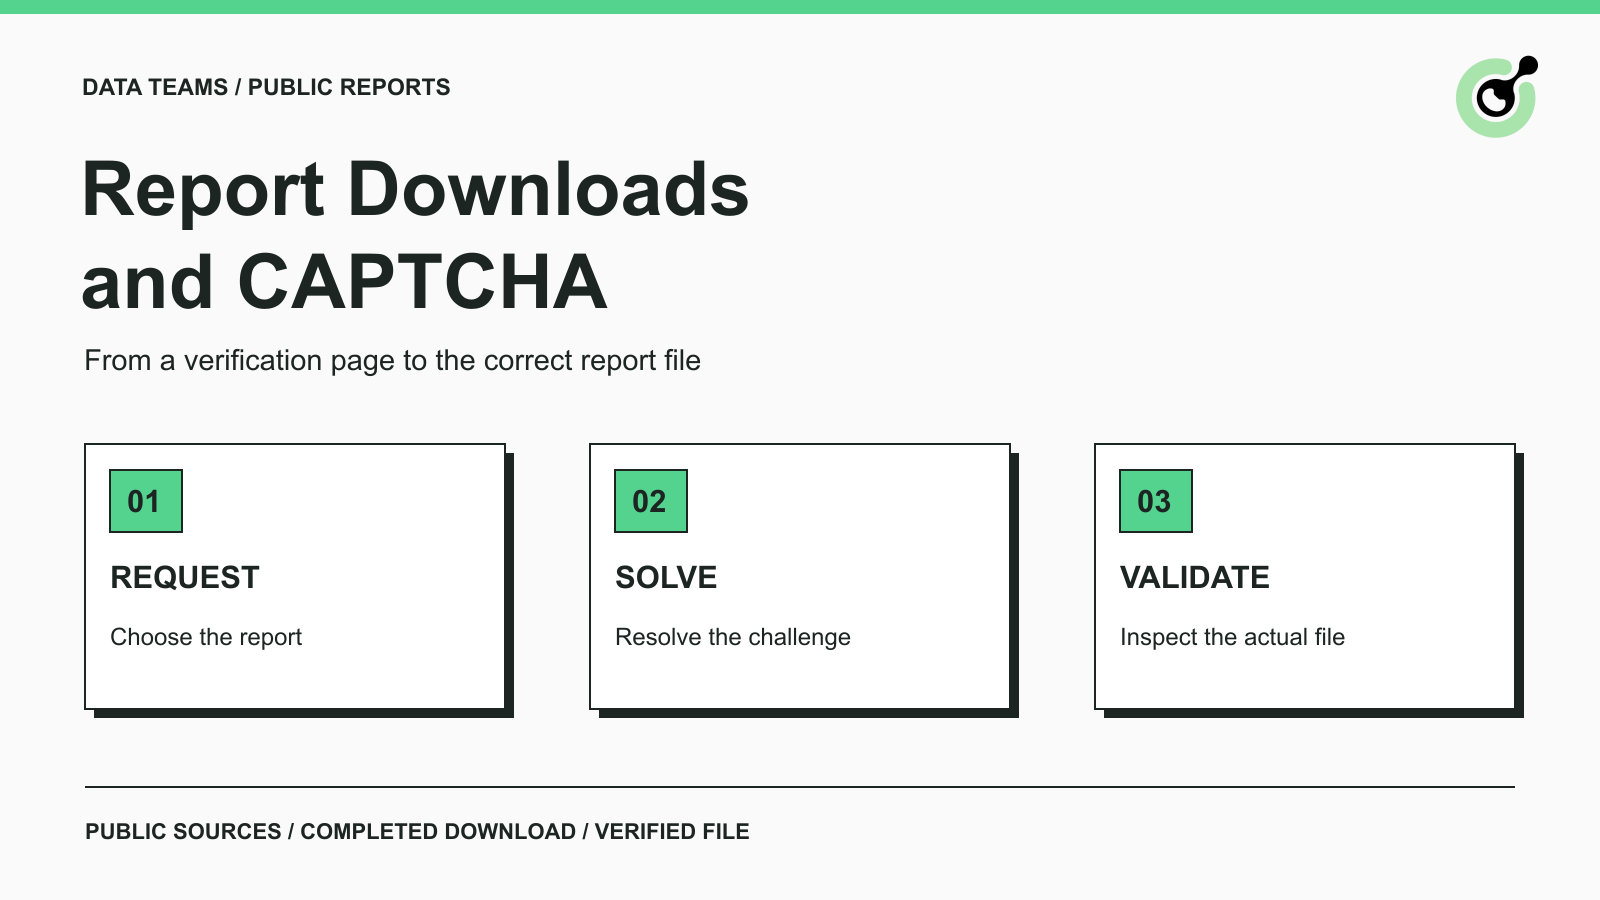
一个研究团队打开一份公开的行业报告,点击“下载”,却得到一个验证页面,而不是 PDF。浏览器用户可以看到这次中断。而自动采集程序可能会将该响应按预期文件名保存,并传给下一处理步骤,在那里,这个错误表现为损坏的文档或空白摘要。
修复要从文档提取之前开始。CapSolver 可以在已授权的下载工作流中,为受支持的验证码提供求解步骤。但采集程序仍然必须完成下载并检查文件。本文按照该顺序处理公开报告与公司出版物,重点关注验证结果与实际文档之间的边界。
在重试下载或调用求解器前,先识别下载尝试返回的页面类型。
在获取 PDF 过程中被验证码中断是一个已有文档记录的问题。Paperpile 的 PDF 下载说明 将验证码阻断的下载与出版方访问限制和缺失文件区分开来。即便你使用的是另一种文档采集工具,这种区分仍然有用。这并不意味着 Paperpile 与 CapSolver 有集成关系。
检查浏览器响应中是否有可见的验证提示和预期的挑战组件。如果页面转而要求订阅或组织登录,那么验证码结果并不能提供这种访问权。如果文档已被移动,请找到它当前的官方发布页面,而不是将每一次失败请求都视为验证码问题。
让调查始终围绕目标公开报告展开。搜索结果、出版物落地页和可下载文件是不同的资源。落地页可能正常加载,而文件请求则遇到额外检查。
在尝试获取之前,记录报告标题、出版方、版本或报告期以及官方落地页。文件 URL 可以改变,但出版物身份不变。
以某个示例性市场报告来说,任务可能是“出版方最新的公开英文季度行业报告”。如果请求被挑战中断,要将该需求与这次尝试绑定在一起。之后下载的旧版报告,即便能正常打开,也不能算作成功替代品。
在符合报告要求的前提下,优先使用受支持的订阅源、仓库导出或文档 API。只在确有必要且获得出版方许可时,才使用浏览路径。
在加入验证码求解器之前,先确认以下事项:
验证码 (CAPTCHA) 可能出现在表单提交之前,或者在跳转到文档的导航过程中。要识别到底是哪一步失败。仅在网站通用首页上解决一个挑战,并不能说明某个单独下载请求已经被接受。
这是一个文件获取工作流指南,而不是针对某个网站的专用采集器。本文不会为未测试的出版方指定选择器,也不会声称所有 PDF 来源都接受同一种集成方式。
先解决已经观察到的、受支持的验证码,然后再通过已批准的页面流程继续原始报告请求。
对于包含字符的图片型验证码,ImageToTextTask 接口说明定义了识别接口。它的输出是挑战的答案文本,而不是报告的提取文本。务必将这两种识别任务分开处理。
reCAPTCHA 控件需要对应的 reCAPTCHA v2 任务配置,包括相关的页面上下文。不要把任意截图发给图片任务,却期待基于 token 的控件接受这个答案。
对于异步任务,getTaskResult 协议区分正在处理的任务与已就绪的结果。创建任务并不意味着可以开始解析文件。
在拿到合适的结果后,恢复预期的页面操作,并观察接下来发生的情况。可能是下载开始、表单显示另一条错误信息,或者出版方返回其出版物列表。求解成功应当推动工作流进入“下载验证”阶段,而不是直接进入“报告已入库”。
在等待求解结果期间,不要丢弃已选定的报告或浏览器状态。仅仅重新打开一个只带落地页 URL 的新标签页,可能会丢失当前语言选择或下载表单状态。
如果页面刷新后出现新的挑战,在复用任何结果前先检查这次新的尝试。明确设定重试上限。反复求解,而应用实际是在等待某个缺失的表单字段,这并不能解决根本问题。
兑换你的 CapSolver 奖励码
立即提升你的自动化预算!
在为 CapSolver 账户充值时使用奖励码 CAP26,每次充值即可额外获得 5% 奖励,不限次数。
现在就前往 CapSolver 控制台 兑换
只有在文件存在、可读并且与所请求的出版物相符时,才接受这次下载。
成功的 HTTP 响应以及以 .pdf 结尾的文件名是有用的信号,但任何一个单独存在都不够。采集程序完全可能将 HTML 验证页面按 PDF 文件名保存。这样一来,失败要到 PDF 阅读器或 OCR 阶段才会暴露,与最初触发错误的请求已经相隔甚远。
要把多种检查结合起来使用:
| 检查 | 能证明什么 |
|---|---|
| 下载完成 | 浏览器或客户端已经完成响应内容的获取 |
| 响应媒体类型 | 服务器将返回内容标识为预期格式 |
| 文件可读性 | 合适的阅读器能打开文档结构 |
| 出版物身份 | 标题、出版方、语言和版本与请求一致 |
| 来源关联 | 能将文件追溯到预期的发布页面 |
MDN 的 Content-Type 参考 解释了响应如何标明其媒体类型。要把该头部视为与文件检查相结合的证据,而不是无条件保证响应体一定是正确的报告。
Content-Disposition 头部 可以描述附件处理方式和建议文件名。但它并不能证明文档内容的正确性。一个看起来合理的文件名,绝不能覆盖失败的文件检查结果。
在清理浏览器上下文之前,让下载过程完成,并将文件保存到指定的持久位置。
Playwright 的 下载文档 说明:下载的文件属于浏览器上下文,如果没有妥善保存,在该上下文关闭时会被删除。同样的工作流经验适用于任何采集器:必须在结束获取会话之前完成临时下载的处理。
这里引用的是浏览器的既有行为说明,并不表示本文测试了新的 Playwright 与 CapSolver 的集成方案。
只有在下载完成且通过身份检查之后,才存储新报告,并使其进入后续提取或摘要流程。
如果较早已有一个有效版本,且其出版与获取日期都被记录,那么在新尝试尚未解决时,应保留该版本。要记录本次刷新失败,而不是悄然把旧文档标记为最新版本。
对研究服务而言,这能防止访问问题演变成内容断言。“无法获取最新报告”与“出版方没有新报告”是两回事。采集程序应当如实反馈它实际观察到的情况。
在生成 AI 摘要之前,确认其输入是已接受的报告或已验证的提取文本。现有的防止验证码页面进入 AI 研究的指南讨论了更广泛的源质量问题。本文关注的关键检查点是下载的文件本身,在它进入研究步骤之前完成核验。
在报告仍不可用时,以最后一个已验证阶段为依据来选择下一步操作。
如果挑战仍在屏幕上,检查任务类型、当前参数和返回的错误。如果挑战已完成但没有文件到达,检查下载动作、重定向或页面上的验证消息。如果文件已到达却不能读取,在再次花费求解费用之前先检查其实际内容。
一份可读但报告期错误的文件,属于文档选择问题。一份有效扫描 PDF 却提取为空文本的情况,则属于文档处理阶段的问题。这两种结果本身都不能直接证明验证码求解失败。
不要无限重试,也不要寻找绕过出版方访问决策的变通路径。保留失败尝试的记录,在必要时使用获批准的人工获取方式或出版方提供的渠道。
在受支持的验证码检查点使用 CapSolver,然后再验证最终进入存储的文档。对研究团队而言,有用的结果是一份来源清晰、版本明确、可供分析的正确报告。
问:验证码求解器能帮我下载 PDF 吗?
文档化的求解任务只提供验证码挑战的结果。你的浏览器或应用必须继续执行已批准的下载过程,并验证返回的文件。
问:为什么下载的 PDF 里是一个验证页面?
采集程序可能将 HTML 响应按 PDF 文件名保存了。请检查响应内容,并在接受新文件前恢复到受支持的验证流程。
问:解决验证码是否等同于获得付费报告的访问权限?
不是。订阅、登录、授权许可和出版方许可仍然是独立的要求。
问:是否应该在任何一次下载成功后就替换已存报告?
只有在验证文件和出版物身份之后才替换。当最新一次获取不完整或存在疑点时,要保留最后一个有效副本。
问:这是否等同于提取文档元数据?
不是。该工作流的目的是确认目标报告文件确实已被获取。元数据提取、OCR 和摘要是在此“接受步骤”之后才进行的。
Emma Foster
Machine Learning Engineer
Where machine learning meets practical AI tooling.
关于作者