🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Ethan Collins
AI Agent Workflow Engineer
已发表 Nov 13, 2026
已更新 Nov 13, 2026 · 最小阅读量
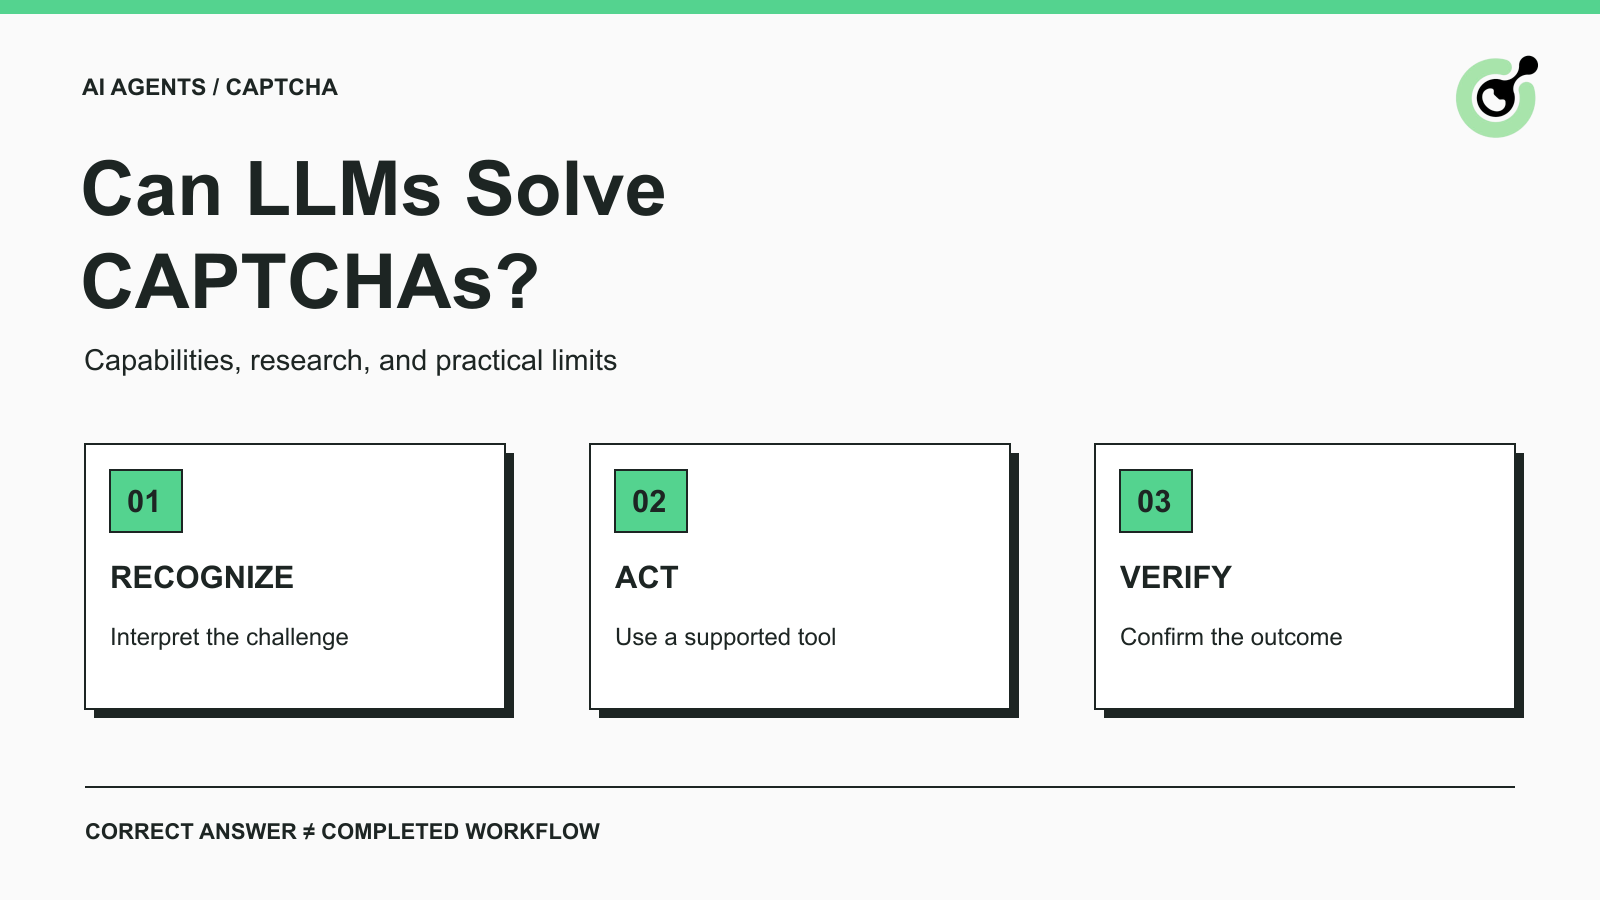
一张显示正确识别目标的截图,是评估模型视觉能力的有用证据。但它仍然留下一个问题:应用程序是否接受了这次验证并完成了请求的操作?在为浏览器智能体、QA 或合法的数据采集评估 LLM 验证码求解器时,这一差别非常关键。
本指南解释这个术语的含义、研究结果表明了什么,以及哪些检查应当纳入评估。同时说明像 CapSolver 这样的服务处在什么位置。重点在于能力与产品选择,而不是针对特定网站的攻击提示或声称每个 AI 智能体都能解决所有挑战。
LLM 验证码求解器使用语言模型(通常具备图像理解能力)来解释验证码任务或协助协调其完成。这个词组涵盖多种不同系统,因此要问清产品实际接收和返回的是什么。
有的系统可能接收一张图片并输出文本答案。另一些可能返回建议的点击位置。浏览器智能体可能调用独立的求解服务,然后在可信应用代码检查结果之后继续任务。不同系统需要不同的评估方法。
LLM 术语表条目解释了底层模型类别。给模型添加浏览器或求解工具可以提升其能力,但这并不意味着每次工具调用的结果都源自模型自身的视觉推理。
识别问的是模型能否正确解释挑战输入。编排问的是智能体能否在工作流的正确阶段选择并使用合适的工具。
一个把验证码委托给 API 的智能体,即使不自行求解图像也可能很有用。相反,一个能给图像正确打标签的模型,仍可能缺乏完成 Web 操作所需的浏览器控制、任务输入或被接受的响应。评估时要聚焦你真正需要的应用角色。
已发表的研究表明,性能会随挑战类型和系统设计变化而显著不同。它们支持对“LLM 能否求解验证码?”这个问题给出条件性的回答。
Oedipus 论文研究了推理型验证码,并报告了在直接使用 LLM 能力时遇到的困难。其提出的框架增加了任务分解和领域特定表示。因此,该框架的结果包括周边系统,而不只是未经辅助的模型。
COGNITION 研究在多种验证码任务类型上评估了多模态模型。其报告区分了以识别为导向、低交互的任务,与更难的定位、空间推理和跨帧任务。论文还考虑了重试、时延和成本,而不仅仅是准确率。
这些研究不会为每个服务、浏览器或线上部署给出可迁移的成功率。阅读结果时,要把被评估的模型、任务集合、重试允许以及测量端点附在结论上。仅凭一个更新的模型名称,不能证明同样结果仍然成立。
有用的基准描述会告诉你,成功是指正确标签、正确的交互序列、有效的服务器响应,还是应用原始任务的完成。
对授权 QA 团队而言,图像-答案类基准有助于选择识别组件。浏览器智能体团队则需要页面交互和应用完成方面的额外证据。任何一方都不应悄悄用一种衡量代替另一种。
还要检查失败或超时的尝试是否仍计入分母。只报告成功输出,会掩盖操作人员原本需要调查的工作量。
正确的视觉答案仍然可能不够,因为应用可能需要有效的验证响应和自身的接受检查。可见的谜题只是截图能展示的部分。
例如,Google 响应验证文档描述了一个由应用后端验证的响应 token。文档规定了两分钟有效期和一次性使用。由模型生成的图像描述并不是这种验证响应。
类似地,Cloudflare Turnstile 验证指南要求服务器端 token 校验,并描述了五分钟有效期和一次性使用。评估 Turnstile 不应该像评估单纯图像标注任务那样。
这些示例说明了评估端点为何重要。它们并不意味着求解器可以保证应用访问。网站仍然控制自己的应用逻辑与访问决策。
在测试你自己的应用时,检查服务器端的验证结果和最终应用状态。在与第三方许可工作流协作时,使用对你开放的、文档中列出的可观察结果。
如果后端结果不可用,就把它标记为未知。按钮变化、控件关闭或 API 响应返回可能是有用信号,但在报告中不应被悄悄视为“服务器已接受”。
兑换你的 CapSolver 奖励码
立即提升你的自动化预算!
充值 CapSolver 账号时使用奖励码 CAP26,每次充值额外获得 5% 奖励 —— 无金额上限。
立刻在你的 CapSolver 控制台中兑换
专用验证码求解器在更大的授权工作流中处理其支持的验证任务。智能体仍然负责原始目标,而应用仍然负责检查结果。
CapSolver Agent Tools 文档描述了模型决策、工具适配器与 Core 执行层之间的分工。这为团队提供了一条有文档的集成路线,而不必让语言模型从截图中“猜”出求解协议。
务实的评估应遵循以下顺序:
这是一份责任清单,而不是可直接执行的集成代码。请使用你选择框架的官方示例,并在你的环境中验证后再部署。
模型通常只需要了解结果情况,例如已完成、仍在等待或已暂停待审。它不需要浏览器 Cookie 的全部内容、服务凭证或每一个原始响应。
这有助于让故障排查更加清晰。分别记录观察到的挑战、选择的操作以及最终状态。如果工具调用从未开始,就调查工具选择问题。如果求解器返回了结果但应用拒绝了它,则调查后续阶段。
至于在实现层面选择截图输入还是 token API,可参见 面向电脑操作智能体的验证码处理。这一决策取决于运行环境可以观察和执行什么。
在一小组有明确接受条件的授权任务上评估 LLM 验证码求解器。目的是验证你需要的角色,而不是制造一个“通用排行榜”。
在比较系统之前,先写下输入类型、允许的动作、支持的挑战类别、重试预算和期望的最终状态。将普通的浏览器故障与验证码故障区分开来,否则,页面加载缓慢会扭曲表面上的求解结果。
针对完整评估单元报告结果数量、耗时、消耗的尝试次数和成本。如果评估单元是智能体任务,要包括失败任务和重复付费调用。如果是图像任务,就明确说明。
有用的评估报告还应保留负面案例。包括不支持的挑战、缺失必需输入的情况,以及在任务结束后才返回的结果。在这些情况下,期望行为可能是明确停止,而不是再次尝试。
不要把模型的置信度陈述当作被接受概率的测量值。要使用应用或测试框架中的观测结果。将测试框架限制在你被授权测试的系统和数据上。
小规模测试可以表明,在所检查的案例上集成按预期工作。但它不能为诸如“最适合所有智能体”或“适用于每个网站”这样的说法背书。请把测试报告附在采购决策上,方便其他团队了解其局限性。
当需求变化时,要重复相关案例。更换模型、浏览器运行环境、求解任务类型或目标应用,都可能改变早期证据能说明什么。精确的兼容性说明比泛泛的无限承诺更有价值。
当需求是可直接评估的、边界清晰的图像理解任务时,选择识别模型。当授权应用需要受支持的验证码结果时,选择有文档的求解集成。当周围任务从规划和工具选择中受益时,使用智能体。
CapSolver可以提供有文档的求解步骤。确认当前支持的任务类型,测试完整的授权工作流,并将应用的接受情况视为单独结果。
从官方验证码入门指南开始,选择与实际挑战匹配的能力。保持首次测试规模足够小,以便在扩大使用前检查每个结果。
问:LLM 能求解验证码吗?
具备合适视觉能力的 LLM 能求解部分已评估的验证码任务。结果取决于挑战、模型、周边系统以及对“成功”的定义。正确的视觉答案并不自动等同于网站验证成功。
问:LLM 验证码求解器和验证码 API 是一回事吗?
不是。LLM 是模型组件;验证码 API 暴露的是一个有文档的服务操作。智能体可以调用该 API,而无需自行执行底层图像识别。
问:纯文本 LLM 能求解图像验证码吗?
纯文本 LLM 无法直接检查图像。它需要独立的图像能力组件或其他视觉信息来源,并且仍需对整个系统进行评估。
问:智能体应该一直重试直到验证码通过吗?
不应。应设定明确的尝试次数和时间预算,当预算耗尽时停止或请求人工复核。反复尝试不应掩盖不受支持的输入或应用拒绝。
问:研究基准能证明求解器在我的网站上可用吗?
不能。基准只描述其评估的任务与条件。请在你的授权环境中验证所需能力,并区分识别结果与应用完成状态。
Ethan Collins
AI Agent Workflow Engineer
Building clearer handoffs between AI agents and tools.
关于作者