🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Nikolai Smirnov
Software Development Lead
已发表 Oct 29, 2026
已更新 Oct 29, 2026 · 最小阅读量
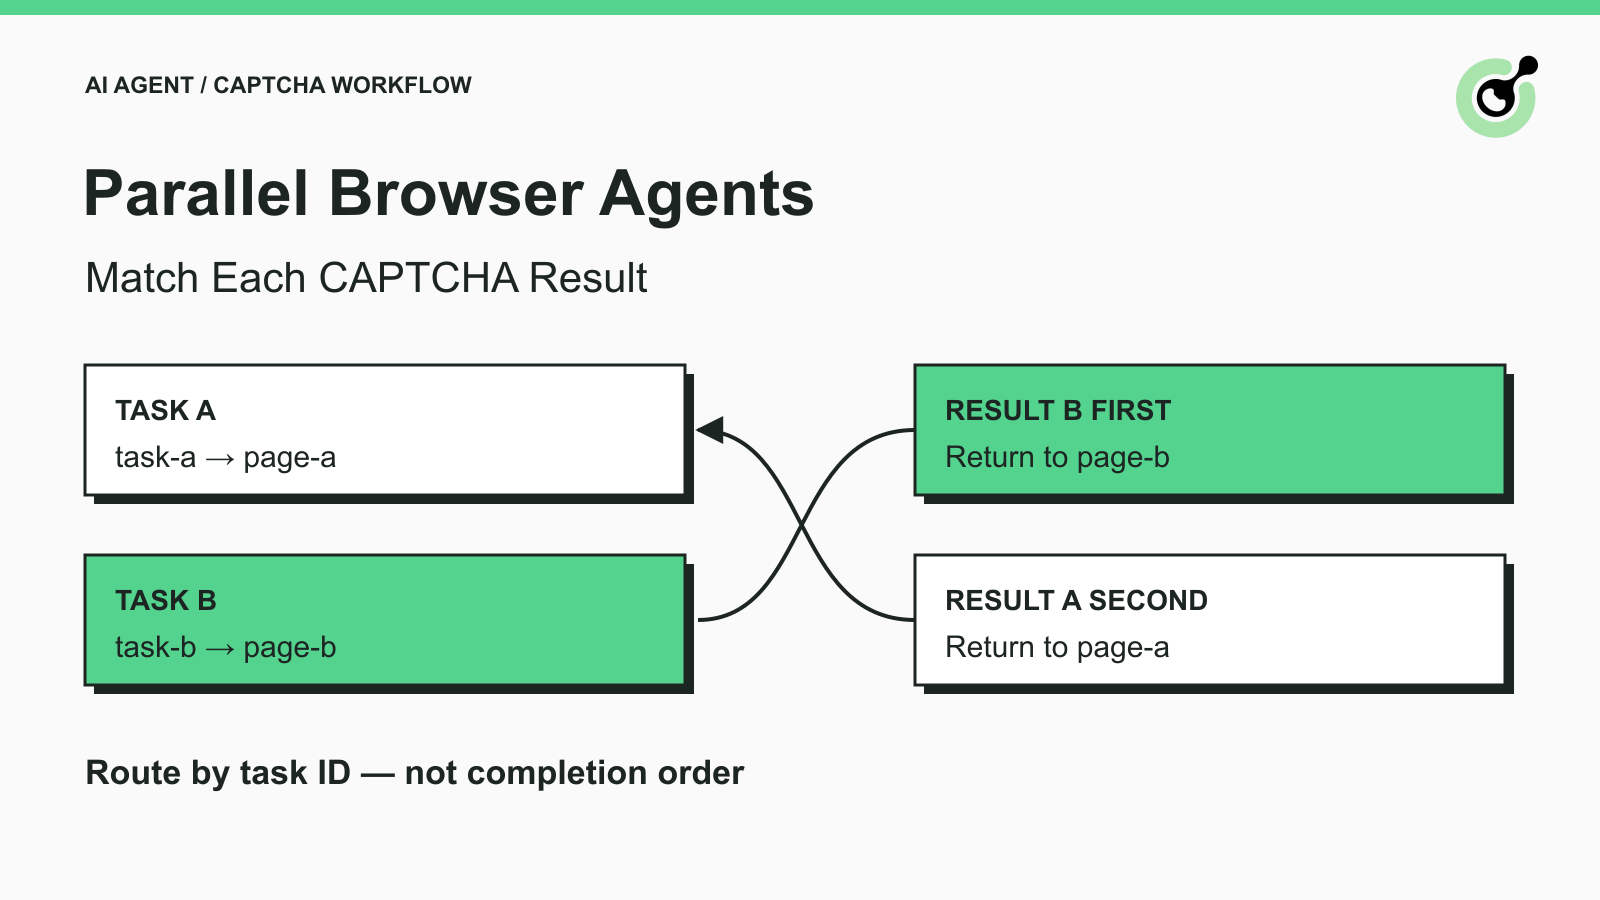
两个浏览器代理在各自的授权任务中遇到受支持的 CAPTCHA。代理 A 先开始,但代理 B 先收到结果。如果应用只是把下一个结果分配给第一个等待中的标签页,那么即使每个 solver 请求本身有效,两个作业都可能受到影响。
这是一个任务关联问题。再多的重试也无法挽回被交付到错误页面的结果。应用需要记住是哪一个浏览器工作项创建了每个 solver 任务,以及在响应到达时该工作项是否仍然是当前的。
CapSolver 会为异步 API 工作返回任务标识符。本文说明如何在并行代理间保持这种关联,并给出一个在接入真实 solver 之前可本地运行的小示例。本文不声称给出并发基准或生产级 CAPTCHA 成功率。
浏览器代理应在一次尝试中保留应用作业 ID、页面所有者以及 solver 任务 ID 的关联。
createTask API 为异步任务返回一个 taskId。在接受该创建响应时保存它。getTaskResult API 通过该标识符检索对应结果。
你的应用还需要自己的工作项标识符,以及对浏览器所有者的引用。这些是应用字段,而不是额外的 CapSolver 请求参数。示例中的 page-a 之类的页面标签用来标识拥有该页面的 worker;它不是可重用的浏览器句柄,也不是 API 凭据。
再增加一个小的尝试版本号,下面称为 epoch。当新的导航或新的挑战尝试使早期的等待结果不再合适时,将其递增。仅靠 URL 不够:两个作业可以访问同一 URL,一个页面也可以在地址不变的情况下加载不同状态。
Playwright 的浏览器上下文文档解释了隔离的浏览器状态。上下文隔离和任务关联解决的是不同问题。分开的 cookie 并不会自动把 solver 结果路由到正确的 worker。
完成顺序只描述结果何时抵达,而不是说明哪个浏览器作业拥有它们。
Python 的asyncio.as_completed 文档描述了按完成时间处理 awaitable。如果你的编排使用按完成顺序触发的回调,那么每个结果必须携带自己的关联信息,而不能依赖在等待页面列表中的位置。
把任务创建和绑定视为一次本地交接:验证创建响应,把返回的 ID 与其工作项一起存储,然后再允许检索结果。基于回调的实现需要对那些在本地绑定可见之前就到达的结果制定等效方案。不要把这种竞争条件简单当作“未知页面”,然后立刻创建另一个付费任务。
Python 队列接口可以帮助在本地 worker 之间传递完整的工作项。队列不能替代映射:要在结果抵达页面所有者的整个过程中保持该标识符。
只有当任务 ID 已知且记录的尝试仍属于活动页面时,才接受结果交付。
在小型应用中使用单一所有者更新该状态。在分布式服务中,使用持久存储和原子声明或等效的并发控制。在多个进程之间随意共享的 Python 字典无法提供这种保证。
下面的示例是一个本地路由夹具,而不是官方 SDK 方法或完整的 solver 集成。它使用虚构的任务 ID 和 fixture_marker,后者不是 CAPTCHA token 也不是 CapSolver 解决字段。用 Python 3 运行它;不需要第三方包、API key、浏览器或网络请求。
def accept_result(reply, pending, current_epochs):
    task_id = reply.get('taskId')
    if not isinstance(task_id, str) or type(reply.get('errorId')) is not int:
        return 'malformed_reply', None
    job = pending.get(task_id)
    if job is None:
        return 'unknown_or_duplicate', None
    if current_epochs.get(job['page_id']) != job['epoch']:
        pending.pop(task_id)
        return 'stale_page', None
    if reply.get('errorId', 0) != 0:
        pending.pop(task_id)
        return 'solver_error', None
    if reply.get('status') != 'ready':
        return 'pending', None
    if not reply.get('solution'):
        pending.pop(task_id)
        return 'missing_solution', None
    pending.pop(task_id)
    return 'ready_for_owner', (job['page_id'], reply['solution'])

pending = {
    'fixture-task-a': {'page_id': 'page-a', 'epoch': 1},
    'fixture-task-b': {'page_id': 'page-b', 'epoch': 1},
}
epochs = {'page-a': 1, 'page-b': 1}
for task_id in ['fixture-task-b', 'fixture-task-a']:
    reply = {'taskId': task_id, 'errorId': 0, 'status': 'ready',
             'solution': {'fixture_marker': task_id}}
    state, target = accept_result(reply, pending, epochs)
    print(task_id, state, target[0] if target else None)
示例会打印以下两行:
fixture-task-b ready_for_owner page-b
fixture-task-a ready_for_owner page-a
任务 B 先完成,但仍被返回到页面 B。该函数刻意把结果交给所有者,而不去填写或提交页面。只有在你已经有文档化的、面向特定任务的结果解析器以及受支持的浏览器操作之后,才替换这些夹具。
对于轮询 worker,要在本地工作项中保留请求中使用的任务 ID。如果响应包含任务 ID,要验证它是否匹配;不要使用不可信或不匹配的响应 ID 来为请求重新贴标签。该夹具假定在调用 accept_result 之前,这种关联已被验证。
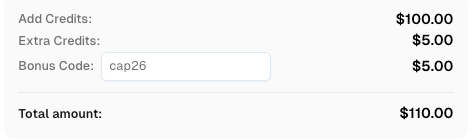
兑换你的 CapSolver 奖励码
立即提升你的自动化预算!
充值 CapSolver 账户时使用奖励码 CAP26,每次充值即可额外获得 5% 奖励——没有上限。
现在就到你的 CapSolver 控制台 进行兑换。
迟到或重复的结果应该产生一个明确的状态,而不是被直接应用到当前活动的任意标签页。
当页面关闭、发生导航或启动替代挑战时,将旧尝试标记为过期。夹具通过将存储的 epoch 与 current_epochs 进行比较来实现;移除已关闭的页面同样会导致检查失败。不要仅仅因为主机名匹配就把旧结果转移到新的尝试上。
在页面所有者实际使用交付结果之前,应再次检查该尝试。夹具中的检查和后续的浏览器动作是两个独立操作。让页面导航和结果应用都由同一个所有者控制,可以防止在两者之间有其他 worker 更改页面。
当 solver 报告一个非终止状态时,保持现有的任务绑定。遵循当前任务文档中的轮询指南以及作业截止时间。每次结果未就绪就创建替换任务,可能会成倍增加挂起工作,却无法解决原始请求。
在对应的工作项上记录失败。夹具将 solver 错误、信封格式错误和缺失解决方案区分开来。生产环境中的解析器还必须验证所选任务类型的确切解决字段;一个非空字典不足以证明存在可用 token。
只认领一次交付。本地夹具会删除处于就绪状态的绑定,因此重复到达会被归类为未知或重复。若交付或浏览器执行可能失败,生产 worker 需要持久化的终态记录和确认策略。不要把这个内存示例当作精确一次的分布式队列来使用。
先验证所有权和拒绝行为是否正确,然后再得出关于吞吐量的结论。
本地检查涵盖了完成顺序相反、任务进行中、未知 ID、尝试变更、页面关闭、错误响应、空解决方案、信封格式错误以及重复交付。这些检查对于文中发布的函数都是通过的。它们没有测试真实 CAPTCHA 求解、浏览器回填或应用接收。
对于授权的端到端测试,加入真实的任务创建和结果检索调用,把敏感结果保留在浏览器 worker 中,并在文档化的求解步骤之后确认预期的应用结果。如果页面仍显示挑战,或预期记录缺失,要将该结果与 solver 就绪状态分开记录。
在不复制原始 token、cookie 或 API key 的前提下保持日志有用。存储工作项 ID、任务 ID、阶段名称以及净化后的错误信息。现有的 API 超时指南 讨论了等待行为;本文关注的是哪一个作业接收最终结果。并发术语表 为同时工作提供背景说明,但不构成性能承诺。
让每一次受支持的求解都牢牢附着在发起它的工作项上。CapSolver 提供 solver 结果;你的应用负责路由该结果、检查尝试是否仍然当前,并验证浏览器任务。通过这种分工,即使结果乱序到达,并行代理仍然能保持相互独立。
问:两个浏览器代理可以共享一个待处理任务变量吗?
如果后续工作会覆盖先前的关联,那么单一可变变量是不安全的。为每个活动的 solver 任务及其页面所有者分别存储绑定。
问:页面 URL 足以标识结果目标吗?
不行。不同标签页可能共享一个 URL,一个页面也可以在同一地址下改变状态。应保留工作项身份以及当前尝试版本号。
问:页面导航后可以复用一个已就绪的结果吗?
不要假定它仍然适用。把旧尝试视为过期,并在对后续求解做任何决策前先检查新页面。
问:这个示例会求解或提交真实 CAPTCHA 吗?
不会。它使用虚构标识符和惰性结果来测试本地路由。付费求解和应用接收需要单独的集成测试。
问:字典示例在分布式 worker 间安全吗?
不安全。它假定在单进程中有一个单一所有者。分布式执行需要持久化的任务状态、原子化的交付声明以及失败处理策略。
Nikolai Smirnov
Software Development Lead
Building dependable software for complex automation.
关于作者