🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Nikolai Smirnov
Software Development Lead
已发表 Oct 28, 2026
已更新 Oct 28, 2026 · 最小阅读量
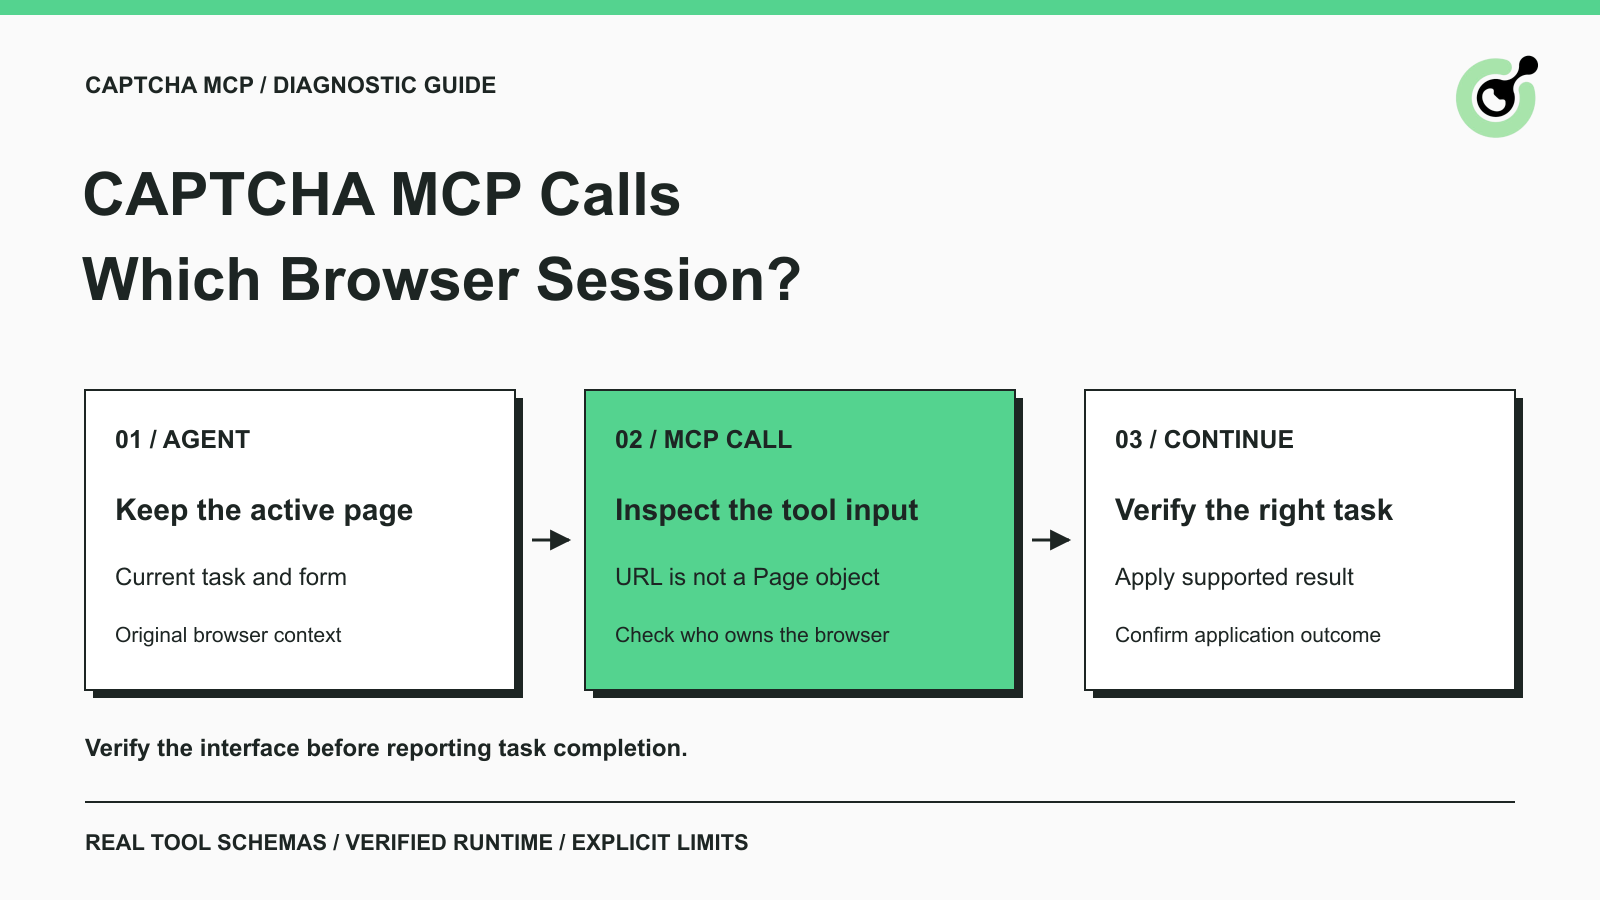
capsolver-mcp 0.1.3 接口中,detect_captchas 和 solve_on_page 接受的是 page_url;二者都没有暴露现有页面或浏览器会话的输入参数。你的浏览器代理已经填写好表单并来到一个 CAPTCHA 页面。它调用第二个 MCP 工具,并传入页面 URL,收到响应后返回到原来的标签页,却发现页面完全没有变化。缺失的那一环,很可能就是浏览器会话本身。
MCP 让一个工具可以被调用;它不会让所有已连接的服务器共享实时浏览器对象。准备表单的浏览器和由 URL 工具打开的浏览器可以是两个独立的实例。CapSolver 同时提供 MCP 工具和 Python Core SDK,因此在 CAPTCHA 出现在现有任务的中途时,选择正确的接口至关重要。
本指南专门诊断这一交接过程。它包含一次真实的 MCP schema 检查,以及来自自有本地浏览器夹具的观察。未支付任何挑战费用,也不宣称任何生产环境表单被真实接受。
测试中的 MCP 浏览器工具会从 URL 创建自己的浏览器,而不是接收代理当前正在使用的页面。
MCP 服务参考文档 描述了基于 URL 的检测与页面求解。我们检查了已安装包对外声明的 schema 以及其浏览器启动实现,并观察它对本地夹具的请求。这些检查在边界问题上达成了一致:仅仅提供 URL 并不会把工具附着到一个已运行的标签页上。
即便两个页面显示相同地址,这种区别仍然非常重要。同一个地址下,一个标签页中的表单字段可能包含尚未提交的值,而另一个则是空的。一个在某个浏览器上下文中可用的 cookie,并不会自动出现在另一个不相关的上下文中。Playwright 的浏览器上下文指南说明了不同上下文之间的隔离。
不要因为两个工具服务器同时出现在助手的侧边栏中,就推断它们共享状态。这些工具也许对同一个模型可用,但其浏览器进程仍然是相互独立的。
先检查在线 schema,以识别该工具实际上能够接收哪些状态。
使用 Python 3.12 以复现下面的检查。测试环境包含 capsolver-mcp 0.1.3、capsolver-core 0.1.1、MCP Python SDK 1.30.0 和 Playwright 1.64.1。官方 MCP 仓库标明了服务器包;MCP Python SDK则提供本次诊断所用的客户端。
使用将要启动服务器的同一个 Python 解释器运行以下命令:
python -m pip install "capsolver-mcp[browser]==0.1.3" "capsolver-core==0.1.1" "mcp==1.30.0" "playwright==1.64.1"
python -m playwright install chromium
将下面这个小诊断脚本保存为 inspect_mcp.py,并用同一个 Python 运行。它初始化一个真实的 stdio 连接,读取 schema,并调用受支持类型注册表。脚本刻意传入一个空的 API-key 值,且从不调用求解或余额方法。真实的付费求解需要有效的密钥和已授权的目标;本诊断不会测试那条路径。
import asyncio
import json
import sys
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def main():
    server = StdioServerParameters(
        command=sys.executable,
        args=["-m", "capsolver_mcp"],
        env={"CAPSOLVER_API_KEY": ""},
    )
    async with stdio_client(server) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()
            result = await session.list_tools()
            for tool in result.tools:
                if tool.name in {"detect_captchas", "solve_on_page"}:
                    print(json.dumps({
                        "tool": tool.name,
                        "arguments": sorted(tool.inputSchema.get("properties", {})),
                        "required": tool.inputSchema.get("required", []),
                    }))
            registry = await session.call_tool("get_supported_captchas", {})
            print("registry_is_error:", bool(registry.isError))

asyncio.run(main())
在测试版本中,有意义的输出是:
{"tool": "detect_captchas", "arguments": ["page_url"], "required": ["page_url"]}
{"tool": "solve_on_page", "arguments": ["autofill", "page_url", "polling_interval", "timeout"], "required": ["page_url"]}
registry_is_error: False
缺少会话参数这一点,说明应当去检查实现本身,而不是对所有 MCP 服务器做出一概而论的判断。在这里,通过检查包的实现可以确认,每次基于 URL 的浏览器调用都会启动一个新的无头浏览器和页面。更换版本时请重新检查 schema 与行为。
本地测试在不尝试真实解决 CAPTCHA 的前提下,展示了会话边界。
我们在一个 Playwright 上下文中打开了自有 HTTP 夹具,设置一个无害的 fixture_session cookie,并在文本字段中输入一个目录查询。该夹具会记录每个请求是否携带该 cookie。然后我们使用同一个 URL 调用了真实 MCP 的 detect_captchas 工具。
原始浏览器的请求包含标记 cookie;MCP 浏览器的请求则没有。工具返回后,原始页面仍然保留着输入的查询。在这个惰性夹具上,检测结果返回的是一个空列表;它不是一个真实的服务商挑战,本测试也不衡量检测覆盖率。
这些观察给出了一个更窄但有用的结论:MCP 调用是独立重新拉取该 URL 的,而第一个页面保持原封不动。它们并未证明付费求解、令牌转移或目标站点接受等行为。在测试中,不使用任何生产 cookie、凭据或私有记录。
在你的应用中,可在你控制的预发布页面上,用一个无害标记复现实验中的同样区分。记录哪个页面由浏览器工具所有、哪个页面是求解器接收到的。避免在诊断日志中记录真实 cookie 内容或 CAPTCHA 令牌。
兑换你的 CapSolver 奖励码
立刻提升你的自动化预算!
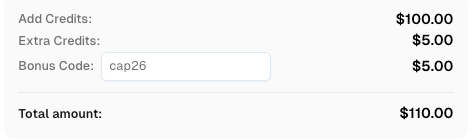
充值 CapSolver 账号时使用奖励码 CAP26,每次充值都可额外获得 5% 奖励——无次数上限。
现在就前往你的 CapSolver 控制台 进行兑换
根据你的应用是否能够访问当前活动的页面对象,选择相应的交接方式。
Core SDK 对浏览器相关方法支持接收已有的 Playwright 页面。文档中的 detect(page) 和 get_captcha_info(page) 方法会检查该页面;solve_on_page(page) 则会对受支持的挑战执行文档说明的求解和回填流程。Core SDK 参考文档 描述了这些接口及其结果字段。
让页面保留在你自己的应用中,并在 CAPTCHA 检查点传入现有对象。在处理程序内部创建新页面,会改变你正在诊断的操作。对于持有浏览器代码的应用来说,这是一种实现选择,而不是某个能让仅支持 URL 的 MCP 工具附着到现有标签页上的配置开关。
本指南验证的是 MCP 的边界,而非付费的 Core SDK 求解。在将基于页面的求解用于生产环境前,请在已授权的目标上单独测试受支持的挑战类型和应用的完成条件。
当浏览器由另一个服务器持有时,使用该服务器文档中声明的能力来检查当前页面,并判断它是否能应用外部结果。不要凭空发明求解器 schema 尚不接受的 session_id、CDP 参数或页面句柄。
基于令牌模式的求解可以从文档化的挑战参数中返回结果,但你的应用仍然需要一个受支持的方式把结果交付回原始页面。如果浏览器所有者无法做到这一点,请记录这一能力缺口,或者将任务交由人工处理。仅仅连接两个服务器,并不能凭空产生缺失的浏览器操作。
当你希望启动的是一个完全独立的检查时,基于 URL 的工具可能正好适合。要把这类任务与代理暂停的表单任务区分开来进行命名。在新页面上的检查取得成功,不应被报告为原始表单任务已完成。
现有的 Playwright 上下文复用指南 解释了存储快照与实时页面。本次讨论的 MCP 问题更早:究竟是哪一个浏览器接到了调用。
只有在预期页面和应用响应共同确认下一步有效之后,才能继续原始任务。
让浏览器所有者、当前操作和完成条件始终绑定在一起。在受支持的求解完成后,再次检查原始页面。确认表单或查询依然代表同一个任务,然后通过浏览器所有者的常规接口执行被允许的提交或导航。
对于数据代理来说,成功可能意味着返回数据中包含预期的记录标识符和所需字段。对于表单流程而言,成功可能是带有已提交输入的应用确认信息。一个空的 CAPTCHA 检测结果都不等同于这些结果。
如果在调用期间页面发生了跳转或挑战发生了变化,请在重用任何早先结果之前再次检查当前任务。避免仅仅因为某个不相关标签页仍然显示小组件,就反复执行付费求解。让未解决状态保持明确,而不是任由模型将其概括为“成功”。
把浏览器所有权视作 CAPTCHA 集成契约的一部分。CapSolver 可以提供有文档说明的求解能力,而你的应用则仍然要对目标页面和最终任务负责。从检查实际 MCP schema 开始,然后测试与你浏览器环境相匹配的交接方式。
问:把相同 URL 传给 CAPTCHA MCP 工具,会复用我现有的浏览器标签页吗?
不会,至少在已测试的 capsolver-mcp 0.1.3 URL 工具中不会。在线 schema 和本地请求测试表明,它会发起一个独立的浏览器请求。
问:我能把浏览器服务器的 session ID 传给 solve_on_page 吗?
测试过的工具 schema 不接受该参数。请只使用已安装服务器声明的输入;来自另一个工具的 session ID 在这里并不会自动有意义。
问:autofill 会更新代理最初的那个标签页吗?
不要做这样的假设。基于 URL 的工具只会操作由它自己打开的页面。在这个页面中进行回填,并不能说明另一个单独所有的标签页发生了变化。
问:文中的示例是否解决了真实 CAPTCHA?
没有。示例只是在一个惰性自有夹具上验证 MCP 连接、工具 schema 和浏览器会话隔离。付费求解以及应用的真实接受情况需要单独测试。
问:如果我的浏览器工具无法应用求解器的结果怎么办?
在一个拥有浏览器的应用中使用受支持的、基于页面的集成方式,或者暂停并交给人工处理。不要声称仅凭两个 MCP 连接就自动具备了缺失的浏览器能力。
Nikolai Smirnov
Software Development Lead
Building dependable software for complex automation.
关于作者