🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Sep 21, 2026
更新されました Sep 21, 2026 · 最小読み取り
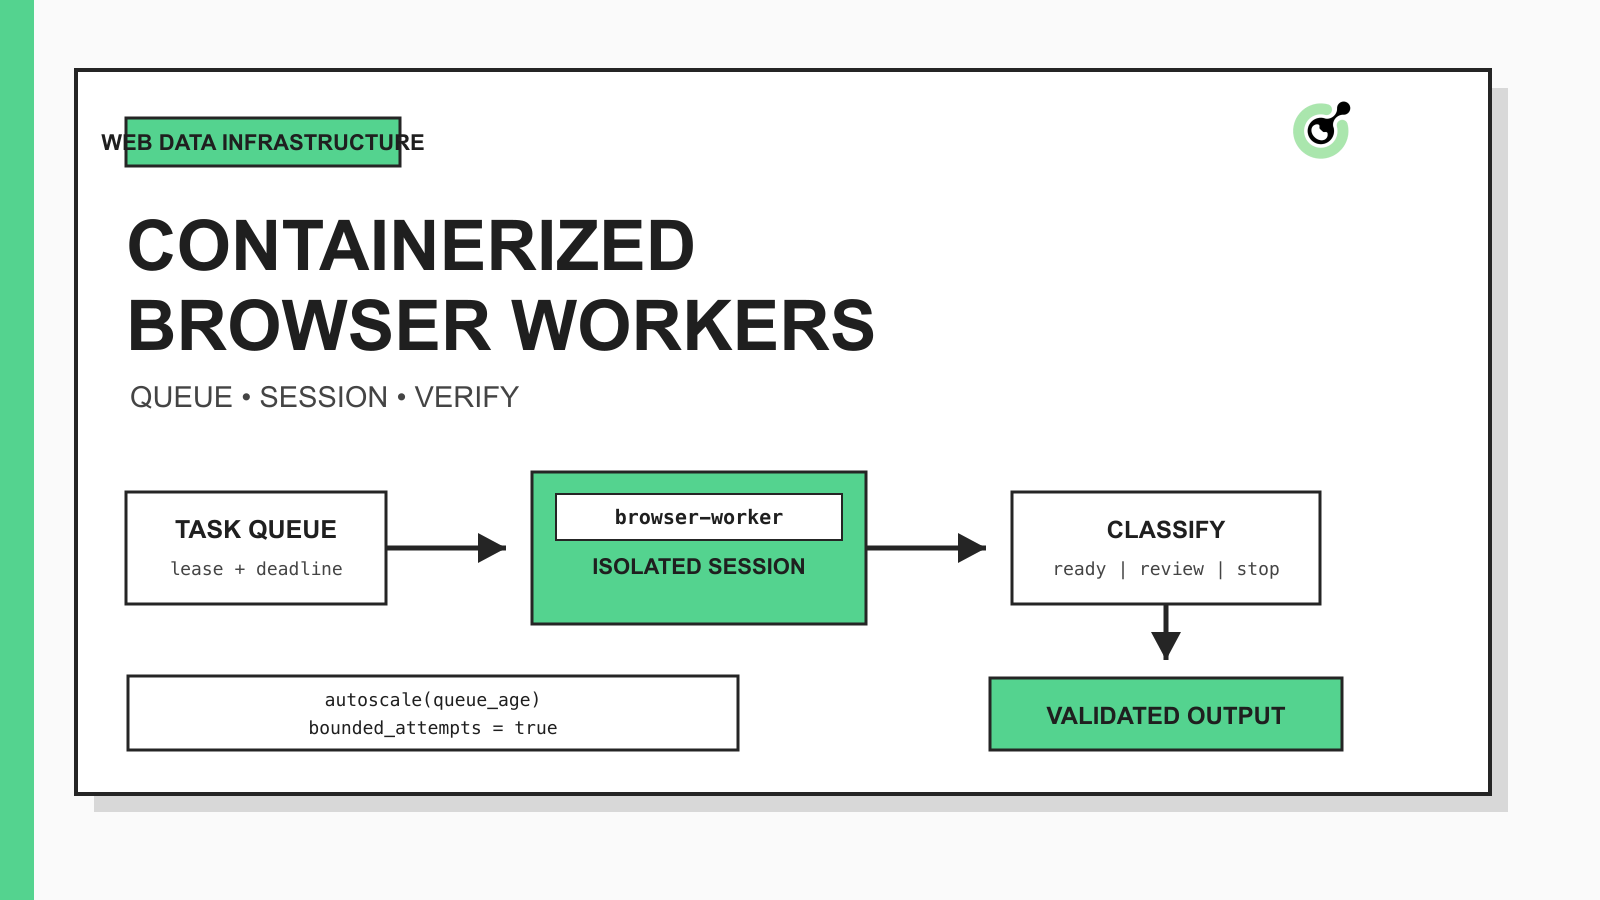
コンテナーサービス(CaaS)は、チームがコンテナ化されたワーカーを管理された方法でデプロイ、実行、スケールするための手段を提供します。ウェブスクレイピングにおいては、通常、ブラウザまたはHTTPワーカーを一度だけパッケージングし、キューからタスクを供給し、需要に応じてワーカー数を増やすことが一般的です。ランタイムは繰り返し可能になりますが、プラットフォームがスケジューリング、健全性チェック、ライフサイクルの作業の多くを処理します。
この定義には重要な境界があります。CaaSは実行のスケーリングではなく、正しさのスケーリングではありません。100の健全なコンテナでも、100のチャレンジページを返す、同じ送信を繰り返す、エラドキュメントを製品データとして解析する可能性があります。したがって、安定したタスク契約、ブラウザ状態モデル、制限されたチャレンジパス、抽出後の検証器が必要です。
認可されたワークフローがサポートされている検証ステップに到達すると、CapSolverは、ワーカーがセッションの連続性、期限、結果の適用、最終的なビジネス状態チェックを担当しながら、文書化された解決タスクを提供できます。
信頼性の高いCaaSウェブスクレイピングパイプラインは、オーケストレーションとウェブアクセスを分離します。各ステージには小さな責任があり、曖昧な成功フラグではなく、型付きの結果を出力します。
| ステージ | 入力 | 操作 | 出力 | ストップ条件 |
|---|---|---|---|---|
| スケジューラー | 認可されたURLとポリシー | 一意性タスクの作成 | タスクIDと期限 | 範囲が無効または期限切れ |
| キュー | タスク記録 | 1つのワーカーに作業をリース | リース所有者と試行回数 | リースを取得できない |
| ブラウザワーカー | タスクとセッション参照 | ナビゲートと観測 | ページ証拠と分類 | ナビゲーションまたはポリシー予算が尽きる |
| チャレンジハンドラー | エリギビリティチャレンジ記録 | 文書化されたタスクフローの実行 | 型付き解決結果 | サポートされていないタイプまたは試行制限 |
| エクストラクター | 受け入れられたページ証拠 | 必要なフィールドの解析 | 構造化された記録 | 必要なフィールドが欠如 |
| バリデーター | 構造化された記録と証拠 | スキーマとビジネスルールのチェック | 受け入れられたまたは拒否された記録 | 検証失敗 |
この分割により、オートスケーリングがより安全になります。オーケストレーターは、すべてのワーカーが範囲を変更したり、無制限のチャレンジタスクを作成したり、下流システムに直接書き込みたりする権限を与えることなく、ワーカーを追加できます。
コンテナ化されたブラウザワーカーは、オートスケーラーが必要になる前に耐久性のあるタスク契約が必要です。少なくとも、タスクID、認可されたターゲット、ポリシーのバージョン、作成時間、絶対的な期限、セッション参照、現在のステージ、試行回数、一意性キーをコンテナの外に保存してください。
契約は3つの決定を明確にする必要があります:
コンテナは破棄可能ですが、クッキー、ストレージ状態の参照、スクリーンショット、トレース、タスク履歴はそうではありません。これらのアーティファクトを承認された耐久性のあるシステムに保存し、キューを通じて参照を渡してください。Playwrightはブラウザコンテキストがクッキー、ローカルストレージ、その他の状態を隔離することを文書化しており、リースされたタスクごとに1つのコンテキストが役に立ちます。ワークフローが意図的に認証を再利用する場合、ストレージ状態を資格情報として保護し、イメージに組み込まないでください。
ブラウザワーカーは一度に1つのリースタスクを処理し、キューのメッセージを確認する前にブラウザコンテキストを閉じるべきです。これにより、セッション所有権が明確になり、関係のないジョブ間でクッキーまたはメモリ内状態が漏洩することを防ぎます。
イメージにはランタイム、ブラウザの依存関係、ワーカーコード、非機密デフォルトのみを含めます。APIキーとストレージ資格情報をプラットフォームのシークレットマネージャーから実行時にインジェクトしてください。ブラウザとライブラリのバージョンをピン止めし、タスクが始まるときに任意のパッケージをインストールする代わりに、制御されたリリースを通じて再ビルドしてください。
3つの健全性シグナルを使用してください:
成功した健全性プローブをページタスクの成功の証明とは見なさないでください。健全性はワーカープロセスを表し、タスクの証拠はウェブワークフローを表します。
ページの分類は、パーサーや下流の書き込みよりも先に行う必要があります。HTTPステータスだけでは不十分です。応答が200を返すものの、ログインフォーム、チャレンジページ、同意画面、またはアプリケーションエラーを表示している可能性があります。
同じブラウザコンテキストから制限された証拠セットを収集してください:最終URL、応答ステータス、ドキュメントタイトル、選択されたDOMマーカー、スクリーンショット参照、コンソールエラー、および必須フィールドの存在。タスクをready、challenge、authentication_required、retryable_error、terminal_error、review_requiredなどの少数の状態のいずれかにルーティングしてください。
分類レイヤーはすべての障害を解決する方法を推測する必要はありません。観測された状態を識別し、次の承認されたコンポーネントに型付き記録を渡すだけです。これは、CapSolverのAIエージェントのウェブ自動化インフラストラクチャスタックに関するガイドで説明されている同じ分離です。ブラウザランタイムはセッションと証拠を所有し、チャレンジ処理は1つの制御されたレイヤーです。
CAPTCHA処理は、一般的なリトライループではなく、オプションの分岐として扱う必要があります。ワーカーはまず、ターゲットとチャレンジが承認されたポリシー内にあるか、タスクタイプがサポートされているか、ブラウザセッションがまだ有効か、絶対的な期限までに時間が残っているかを確認します。
文書化されたCapSolverフローはcreateTaskを使用してサポートされているタスクを作成し、getTaskResultで非同期結果を取得します。現在のリクエストフィールドとタスクタイプのルールについて、公式のcreateTaskと結果ポーリングのワークフローを確認してください。再起動したワーカーが既知のタスクをポーリングするように、返されたタスクIDを耐久性のある状態に保持してください。
再起動を乗り越える予算を使用してください:
チャレンジタイプがサポートされていない、セッションが変更された、期限が切れた、またはアプリケーションが結果を拒否した場合、終了またはレビュー状態を返してください。オートスケーラーが1つのブロックタスクを多くの重複する解決試行に変換しないようにしてください。
CapSolverのボーナスコードを取得してください
即座に自動化予算を増やしましょう!
CapSolverアカウントにチャージする際にボーナスコード CAP26 を使用すると、すべてのチャージで5%のボーナスが得られます — 限界なし。
今すぐCapSolverダッシュボードで取得してください
分類がreadyを返した後で、抽出を開始してください。ビジネスタスクに必要な最小限のスキーマを解析し、下流に書き込む前に型、必須フィールド、新鮮さ、一意性、ソースの整合性を検証してください。
すべての記録にコンパクトな証拠エナメルを保持してください:
{
  "task_id": "task-20260921-0042",
  "final_url": "https://example.test/catalog/42",
  "observed_at": "2026-09-21T02:30:00Z",
  "page_state": "ready",
  "session_ref": "session://browser/task-20260921-0042",
  "required_fields_present": true,
  "artifact_refs": ["screenshot://task-20260921-0042/final"]
}
エナメルは例示的なものですが、その目的は明確です:下流システムは新しいページ証拠と古くなったキャッシュ、パーサー出力とブラウザ観測、受け入れられたデータと偽の成功を区別できます。保持は短期間でポリシーに従うべきです。特に、スクリーンショットやブラウザ状態に個人または機密情報が含まれる場合です。
CaaSのスケーリングは、単にプロセスの使用量ではなく、作業に応じて反応する必要があります。ブラウザワーカーはナビゲーション、レンダリング、キュー、または外部APIで待機することが多く、CPUは低いかもしれませんが、タスクの遅延は増加しています。
有用なスケーリング入力には、保留中のタスク数、最も古い準備ができているタスクの年齢、リース待機時間、中央値タスクの期間、各型の状態のワーカー数が含まれます。KubernetesはHorizontalPodAutoscalerがカスタムメトリクスを使用できることを文書化しており、これはCPUのみよりもキュー駆動型のブラウザ作業に適しています。Kubernetesは有限なタスクを完了するためのJobsも提供していますが、ブラウザ起動が高コストな場合、永続的なキューのコンシューマーの方が効率的です。
ワーカー数、ドメインごとの並行性、総チャレンジタスク、下流の書き込みのハード制限を設定してください。ターゲットがより多くのチャレンジや拒否状態を返し始めたら、スケーリングではなく、作業を減らすか一時停止してください。増加するキューは容量のシグナルであり、増加するチャレンジ率は診断のシグナルです。
次のPython関数は、ターゲットにアクセスせずにCAPTCHAを解決せずに決定レイヤーをモデル化します。観測されたページ状態と耐久性のあるタスク予算を受け取り、次のアクションを返します。
from dataclasses import dataclass
from enum import Enum


class NextAction(str, Enum):
    EXTRACT = "extract"
    HANDLE_CHALLENGE = "handle_challenge"
    RETRY = "retry"
    REVIEW = "review"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    attempts: int
    max_attempts: int
    seconds_remaining: int
    session_matches: bool
    challenge_allowed: bool


def decide(page_state: str, budget: Budget) -> NextAction:
    if budget.seconds_remaining <= 0:
        return NextAction.STOP
    if page_state == "ready":
        return NextAction.EXTRACT
    if page_state == "challenge":
        if not budget.challenge_allowed or not budget.session_matches:
            return NextAction.REVIEW
        if budget.attempts >= budget.max_attempts:
            return NextAction.STOP
        return NextAction.HANDLE_CHALLENGE
    if page_state == "retryable_error":
        return NextAction.RETRY if budget.attempts < budget.max_attempts else NextAction.STOP
    if page_state in {"authentication_required", "review_required"}:
        return NextAction.REVIEW
    return NextAction.STOP
ローカルテストは、準備ができているページ、適格なチャレンジ、変更されたセッション、期限切れのデッドライン、リトライの枯渇、レビュー状態、および未知の入力をカバーしています。決定モデルは意図的に小さく、オーケストレーターがすべての遷移をログおよび監査できるようにするためです。
最も役立つメトリクスはインフラストラクチャの動作とページの結果を結びつけています。キューの年齢とワーカーの過負荷を追跡するだけでなく、チャレンジ率、認証が必要な率、パーサーの拒否率、重複タスク率、デッドラインの期限切れ、最終的なビジネス状態の受け入れを記録してください。
キューのメッセージ、ブラウザトレース、チャレンジタスク、抽出された記録、および下流の書き込みで相関IDを使用してください。ログはAPIキー、クッキー、トークン、個人データをマスクする必要があります。スクリーンショットは証拠であり、デフォルトの永続記録ではありません。認可された使用ケースに必要なものだけを保持してください。
孤立した失敗ではなく、比率でアラートを設定してください。1つのチャレンジは通常です。同じターゲット、ルート、またはブラウザバージョンで急激に増加すると、サイトの変更、セッションの欠陥、有効期限切れの認証、ポリシーの問題、またはリリースの回帰を示す可能性があります。影響を受けたスライスを一時停止し、他のキューは引き続き動作させます。
コンテナのスケールは権限を拡張しません。このアーキテクチャは、公開、認可、または他の合法的なデータワークフローでのみ使用してください。ターゲットの利用規約、レートリミット、プライバシー義務、管轄、データ最小化の要件を尊重してください。
ワークフローがそのデータに対して明示的に承認されていない限り、プライベートページ、アカウントデータ、または機密スクリーンショットを外部システムに送信しないでください。ログインとアイデンティティワークフローを通常の公開データタスクから分離してください。機密提出、不可逆的なアクション、または範囲の変更の前に人間のレビューを要求してください。
コンテナーサービスはブラウザワーカーを繰り返し可能でスケーラブルにしますが、本番環境の信頼性はそのワーカーの周りの契約にあります。すべてのタスクに1つのオーナー、1つの隔離されたセッション、1つの耐久的なデッドライン、1つの型付き状態マシン、および1つの検証された出力を与えてください。キューが健全な需要を示したときにスケールし、証拠が繰り返し拒否または不明な状態を示したときに一時停止してください。
認可されたワークフローでサポートされている検証ステップがある場合、CapSolverはエリギビリティゲートの後ろに配置できます。あなたのアプリケーションはブラウザコンテキストを保持し、最終的な結果を検証します。
最初に1つの承認されたターゲットと1つのバウンドされたワーカーから始めます。並列処理を増やす前に、ページ分類、チャレンジの資格、経過時間、最終的な受け入れ、証拠の参照を記録してください。CapSolverドキュメンテーションを使用して現在の文書化されたタスクフローを選択し、元のブラウザセッションで結果を確認してください。
Q: コンテナーアス・ア・サービスはウェブサイトへのアクセス問題を解決しますか?
いいえ。CaaSはコンテナ化されたアプリケーションをデプロイおよびスケーリングしますが、あなたのアクセス層は依然としてブラウザの状態、ルーティング、チャレンジの分類、ポリシー制御、および結果の検証が必要です。
Q: すべてのURLを別のコンテナで実行する必要がありますか?
必ずしもそうではありません。通常、リースされたタスクごとに1つの隔離されたブラウザコンテキストが重要な境界となります。ワーカーコンテナは、各コンテキストを閉じ、タスクメモリをクリアし、永続的な状態が書き込まれた後にのみ承認する場合、タスクを逐次処理できます。
Q: ブラウザワーカーをスケールするにはどのメトリクスを使用すべきですか?
キューの深度とタスクの年齢は、CPUだけよりも強力な主要なシグナルであることが一般的です。それらをワーカーの制限、ターゲットレベルの並列性、チャレンジの発生率、および期限切れのタイミングと組み合わせて、失敗したワークフローをスケールさせないようしてください。
Q: 再起動したワーカーは既存のCAPTCHAタスクをどのように処理すべきですか?
再起動したワーカーは、永続的なプロバイダータスクID、元の期限、試行回数、セッション参照を読み込む必要があります。セッションがまだ一致し、残りの予算が許可されている場合にのみ、既知のタスクをポーリングする必要があります。それ以外の場合は、停止するかレビューを要求する必要があります。
Q: このパターンはプライベートまたは制限付きデータに使用できますか?
技術的な能力は、プライベート、制限付き、個人的、または機密データを収集する権限を提供するものではありません。このパターンは、承認された範囲内でのみ使用し、ターゲットの利用規約、適用可能な法律、データ最小化、保持制御、および人間のレビューの要件を適用してください。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
スケーラブルなRustウェブスクレイピングアーキテクチャを学びましょう。リクエスト、スクレイパー、非同期スクレイピング、ヘッドレスブラウザスクレイピング、プロキシローテーション、およびコンプライアンス対応のCAPTCHA処理で。
2026年のデータ・アズ・ア・サービス(DaaS)を理解する。その利点、ユースケース、およびリアルタイムの洞察と拡張性を通じて企業を変革する方法について探る。