
🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित May 21, 2026
अद्यतन May 21, 2026 · मिनट पढ़ने का समय
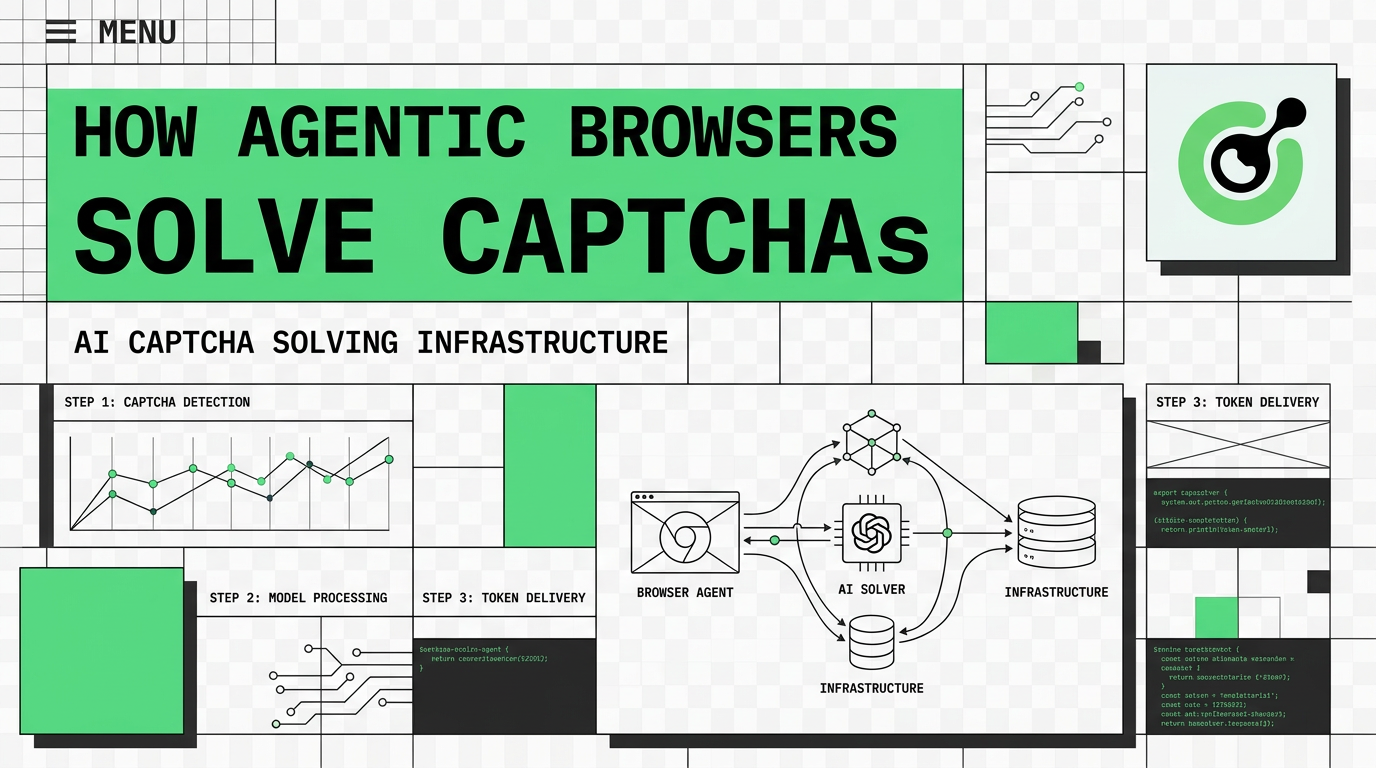
हमारे पिछले लेख में, हमने यह देखा कि Agentic Browser किस तरह एक निष्क्रिय "डिस्प्ले टूल" से एक सक्रिय "एक्शन एजेंट" में बदलता है। हमने इसकी कोर आर्किटेक्चर की जांच की: इरादे की समझ, पर्यावरण की धारणा, और क्रिया निष्पादन। लेकिन जैसे-जैसे ये डिजिटल एजेंट वास्तविक दुनिया के वेब पर नेविगेट करते हैं, CAPTCHA चेकपॉइंट अन्यथा वैध वर्कफ़्लो को बाधित कर सकते हैं। यह लेख उस "अदृश्य इंजन"—CAPTCHA सॉल्विंग इन्फ्रास्ट्रक्चर—पर केंद्रित है, जो अधिकृत एजेंटों को रुकने, आवश्यक टास्क संदर्भ सबमिट करने, परिणाम की पुष्टि करने और आगे बढ़ने में मदद करता है। हम यह देखेंगे कि CAPTCHA चेकपॉइंट AI के लिए सामान्य ऑपरेशनल चुनौती क्यों हैं और CapSolver जैसे विशेषीकृत सर्विसेज अधिकृत वेब ऑटोमेशन की अगली पीढ़ी को कैसे समर्थन देती हैं।
जिम्मेदार उपयोग: CapSolver केवल वैध, अधिकृत ऑटोमेशन के लिए बनाया गया है, जिसमें वे सिस्टम शामिल हैं जिनके आप मालिक हैं या जिन तक पहुंचने की आपको अनुमति है। धोखाधड़ी, फर्जी अकाउंट, अनधिकृत खरीद, स्पैम, या एक्सेस कंट्रोल के दुरुपयोग के लिए इसका उपयोग CapSolver Terms & Conditions के तहत प्रतिबंधित है।
कल्पना करें: एक QA टीम अपने स्वामित्व वाले स्टेजिंग एनवायरनमेंट में मल्टी-स्टेप फ़ॉर्म भरने के लिए एक Agentic Browser को कहती है। एजेंट पेज खोलता है, ज़रूरी फ़ील्ड ढूंढता है और सबमिशन से पहले एक CAPTCHA चेकपॉइंट पर पहुंच जाता है। वर्कफ़्लो तब तक रुक जाता है जब तक वेरिफिकेशन पूरा नहीं हो जाता। इंटरनेट के शुरुआती दौर में जन्मा यह “ट्यूरिंग टेस्ट” CAPTCHA आज अधिकृत AI-एजेंट वर्कफ़्लो के लिए एक व्यावहारिक विश्वसनीयता चुनौती बन चुका है।
CAPTCHA का पूरा नाम है “Completely Automated Public Turing Test to Tell Computers and Humans Apart.” इसका मूल उद्देश्य सरल था: बॉट्स को बाहर रखना और मनुष्यों को अंदर आने देना। लेकिन जैसे-जैसे AI विकसित हुआ है, CAPTCHAs भी लगातार विकसित हुए हैं — साधारण विकृत अक्षरों से जटिल स्लाइडर, इमेज-सेलेक्शन टास्क और बिहेवियरल एनालिसिस सिस्टम तक। अब ये केवल कैरेक्टर-रिकग्निशन की समस्या नहीं रह गए हैं।
पारंपरिक ऑटोमेशन स्क्रिप्ट्स के लिए CAPTCHA चेकपॉइंट किसी वर्कफ़्लो को पूरी तरह रोक सकते हैं। Agentic Browsers के लिए ये तीन मुख्य ऑपरेशनल चुनौतियाँ पैदा करते हैं:
धारणा की कठिनाई में भारी वृद्धि: सबसे उन्नत मल्टीमॉडल मॉडल भी अत्यधिक विकृत टेक्स्ट, धुंधली इमेज ऑब्जेक्ट्स या जटिल बैकग्राउंड में छिपे स्लाइडर गैप्स को विश्वसनीय रूप से पहचानने में संघर्ष करते हैं। AI बस “गलत देख” सकता है, और एक ही गलती पूरे वर्कफ़्लो को तोड़ सकती है।
परतदार वेरिफिकेशन संकेत: आधुनिक CAPTCHAs अब केवल फ्रंट-एंड चुनौतियाँ नहीं हैं। वेबसाइटें माउस ट्रैजेक्टरी, टाइपिंग रिद्म, पेज पर बिताया समय, ब्राउज़र कॉन्टेक्स्ट और अन्य सेशन सिग्नल्स का मूल्यांकन कर सकती हैं। जब कोई रिक्वेस्ट साइट की एक्सेस नीतियों को पूरा नहीं करती, तो अतिरिक्त वेरिफिकेशन की आवश्यकता हो सकती है।
समय-संवेदनशीलता और संदर्भ में बाधा: CAPTCHAs आमतौर पर एक्सपायरी लिमिट के साथ आते हैं। जब कोई Agentic Browser मल्टी-स्टेप टास्क के दौरान CAPTCHA चेकपॉइंट पर बहुत देर तक रुका रहता है, तो लॉगिन सेशन समाप्त हो सकते हैं और टास्क चैन को दोबारा शुरू करना पड़ सकता है।
दूसरे शब्दों में, Agentic Browsers को CAPTCHA चेकपॉइंट्स पर नियंत्रित तरीके से रुकने, प्रलेखित इनपुट सबमिट करने और केवल वेरिफिकेशन सफल होने के बाद ही पुनः शुरू होने की आवश्यकता होती है। यही कारण है कि CapSolver जैसी CAPTCHA-हैंडलिंग इन्फ्रास्ट्रक्चर अधिकृत ब्राउज़र वर्कफ़्लो का हिस्सा हो सकती है।
CapSolver साधारण उपयोगकर्ताओं के लिए बना टूल नहीं, बल्कि डेवलपर्स के टूलकिट में छिपा एक “CAPTCHA इंजन” है। अपने मूल में, यह एक इंटेलिजेंट CAPTCHA-सॉल्विंग प्लेटफ़ॉर्म है जो विशेष रूप से ऑटोमेशन प्रोग्राम्स और AI एजेंटों को विभिन्न प्रकार के CAPTCHAs से निपटने में मदद करने के लिए API इंटरफेसेज़ प्रदान करता है।
हम इसे 24/7 ऑन-कॉल CAPTCHA-सॉल्विंग टीम की तरह समझ सकते हैं जो कभी नहीं थकती और अत्यंत उच्च गति से काम करती है — फ़र्क सिर्फ यह है कि इसकी “टीम” में केवल उन्नत AI मॉडल ही नहीं, बल्कि अत्यधिक अनुकूलित स्ट्रेटजी एल्गोरिद्म भी शामिल हैं।
इसकी क्षमताओं को बेहतर समझने के लिए, नीचे दी गई तुलना तालिका दिखाती है कि समान CAPTCHA चुनौतियों का सामना करते समय पारंपरिक तरीकों और CapSolver के बीच क्या अंतर हैं:
| तुलना आयाम | लोकल OCR / साधारण मॉडल | मानव CAPTCHA-सॉल्विंग प्लेटफ़ॉर्म | CapSolver |
|---|---|---|---|
| समर्थित CAPTCHA प्रकार | केवल सरल टेक्स्ट CAPTCHA; इमेज सेलेक्शन अधिकांशतः अप्रभावी | सैद्धांतिक रूप से सभी प्रकारों को सपोर्ट, लेकिन धीमे और महंगे | प्रचलित CAPTCHAs प्रकार को कवर करता है |
| रिकग्निशन गति | मिलीसेकंड, लेकिन कम सफलता दर | प्रति प्रयास 5–15 सेकंड | प्रति प्रयास 1–3 सेकंड |
| सफलता दर | कम (जटिल CAPTCHAs पर और भी खराब) | अपेक्षाकृत उच्च, लेकिन वर्कर थकान और नेटवर्क लेटेंसी से प्रभावित | उच्च और स्थिर |
| लागत संरचना | एक-बार का डेवलपमेंट कॉस्ट | प्रति टास्क भुगतान, उच्च श्रम लागत | प्रति टास्क भुगतान, कम कीमत और कम सीमांत लागत |
| ब्राउज़र वर्कफ़्लो इंटीग्रेशन | कस्टम इंटीग्रेशन की आवश्यकता | अलग टास्क समन्वय की आवश्यकता | ब्राउज़र एनवायरनमेंट के साथ इंटीग्रेट होकर प्रलेखित टास्क परिणाम वापस कर सकता है |
तालिका 1-1 पारंपरिक CAPTCHA-सॉल्विंग तरीकों और CapSolver क्षमताओं की तुलना
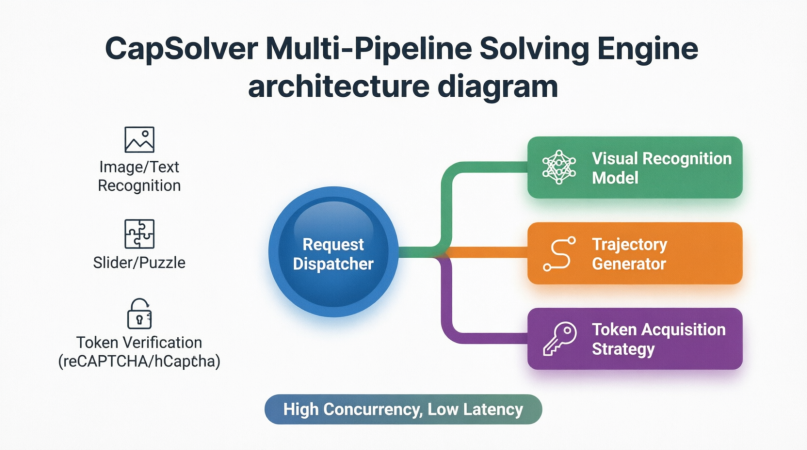
CapSolver विभिन्न CAPTCHA प्रकारों के लिए विशिष्ट प्रोसेसिंग पाइपलाइन का उपयोग करता है:
इमेज और टेक्स्ट रिकग्निशन CAPTCHAs: स्वामित्व वाले विज़न मॉडल और विशाल ट्रेनिंग डेटासेट्स के संयोजन से CapSolver अत्यधिक विकृत, ओवरलैपिंग या शोर वाले टेक्स्ट को सटीक रूप से पहचान सकता है।
स्लाइडर और पज़ल CAPTCHAs: CapSolver चयनित चुनौतियों के लिए प्रलेखित टास्क फ्लो का उपयोग करता है और अधिकृत क्लाइंट वर्कफ़्लो के लिए लागू करने हेतु संबंधित परिणाम लौटाता है।
टोकन-आधारित वेरिफिकेशन सिस्टम (reCAPTCHA v2/v3, Cloudflare, आदि): ये सिस्टम आवश्यक टास्क पैरामीटर सबमिट होने के बाद एक बार उपयोग होने वाला टोकन वापस कर सकते हैं। CapSolver वेबसाइट URL, साइट की, और समर्थित वैकल्पिक संदर्भ जैसे प्रलेखित इनपुट का उपयोग करता है, फिर अधिकृत क्लाइंट वर्कफ़्लो द्वारा सबमिट करने के लिए समर्थित परिणाम लौटाता है।
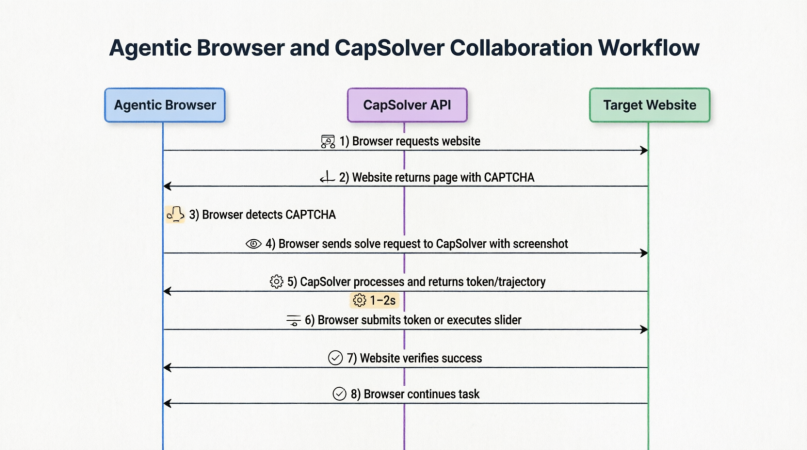
तो व्यवहार में CapSolver और Agentic Browsers कैसे सहयोग करते हैं? निम्नलिखित डायग्राम पूरा प्रोसेस दर्शाता है:
जैसे ही ब्राउज़र किसी CAPTCHA से टकराता है, आवश्यक टास्क संदर्भ इकट्ठा करता है, CapSolver API को कॉल करता है, समर्थित परिणाम प्राप्त करता है, वेरिफिकेशन सबमिट करता है, और मूल टास्क को फिर से शुरू करता है, पूरा वर्कफ़्लो कड़े रूप से इंटीग्रेटेड रहता है और आमतौर पर 1–2 सेकंड के भीतर पूरा हो जाता है।
इसका मतलब यह है कि Agentic Browsers के लिए CAPTCHA अब ऐसे मुद्दे नहीं रहते जिन्हें AI को स्वयं “देखना” और “अनुमान लगाना” पड़े। इसके बजाय, वे विशेषीकृत इन्फ्रास्ट्रक्चर प्रदाताओं को आउटसोर्स किए गए मानकीकृत टास्क बन जाते हैं। ब्राउज़र को सिर्फ चैलेंज कैप्चर करना, आवश्यक संदर्भ पैकेज करना, सबमिट करना, परिणाम की प्रतीक्षा करना और पेज स्टेट वेरिफाई करने के बाद आगे बढ़ना होता है।
अब हम Agentic Browser के डायनेमिक एडॉप्टेशन मॉड्यूल को CapSolver से जोड़ते हैं और एक नियंत्रित CAPTCHA-हैंडलिंग वर्कफ़्लो की जांच करते हैं। इस प्रक्रिया का उपयोग केवल उन्हीं साइट्स पर करें जिनके आप मालिक हैं या जिन्हें ऑटोमेट करने की आपको स्पष्ट रूप से अनुमति है।
जब Agentic Browser टास्क्स निष्पादित कर रहा होता है, उसका एनवायरनमेंटल परसेप्शन लेयर लगातार वेबपेज की निगरानी करता है। जैसे ही कोई CAPTCHA एलिमेंट (उदाहरण के लिए reCAPTCHA iframe वाला पॉपअप) डिटेक्ट होता है, एक्शन एक्ज़िक्यूशन तुरंत रुक जाता है और एक समर्पित CAPTCHA-हैंडलिंग सब-प्रोसेस ट्रिगर हो जाता है।
यह प्रक्रिया अत्यंत परिष्कृत है और आमतौर पर निम्न चरणों को शामिल करती है:
संदर्भ संग्रह: Agentic Browser CAPTCHA क्षेत्र के स्क्रीनशॉट लेता है और वर्तमान URL, साइटकी, ब्राउज़र व्यूपोर्ट डाइमेंशंस और User-Agent जैसी संदर्भ जानकारी एकत्र करता है।
टास्क सबमिशन: स्क्रीनशॉट और पैरामीटर एक साथ पैकेज किए जाते हैं और CAPTCHA प्रकार निर्दिष्ट करते हुए API के माध्यम से CapSolver को भेजे जाते हैं।
बैकग्राउंड सॉल्विंग: टास्क प्राप्त होने पर CapSolver उसे संबंधित सॉल्विंग पाइपलाइन के माध्यम से रूट करता है। उदाहरण के लिए, reCAPTCHA v2 मिलने पर यह एक समर्पित सॉल्वर को इनवोक करता है जो वैध g-recaptcha-response टोकन लौटाता है। पूरा सॉल्विंग प्रोसेस आमतौर पर 1–2 सेकंड में पूरा हो जाता है।
इंस्ट्रक्शन रिटर्न: Agentic Browser समर्थित टास्क प्रकार के लिए निर्दिष्ट परिणाम प्राप्त करता है, जैसे कि एक टोकन स्ट्रिंग।
ऑन-साइट निष्पादन: Agentic Browser प्रलेखित कॉलबैक, फ़ील्ड या क्लाइंट-साइड हैंडलर के माध्यम से लौटाए गए परिणाम को अप्लाई करता है। पेज द्वारा वेरिफिकेशन कन्फर्म होने के बाद अधिकृत टास्क फ्लो फिर से शुरू हो सकता है।
स्टेट वेरिफिकेशन: ब्राउज़र यह वेरिफाई करता है कि पेज ने सफलतापूर्वक वेलिडेशन पास कर लिया है और क्या लक्ष्य एलिमेंट्स दोबारा दिखाई दे गए हैं, उसके बाद ही बाधित वर्कफ़्लो को जारी रखता है।
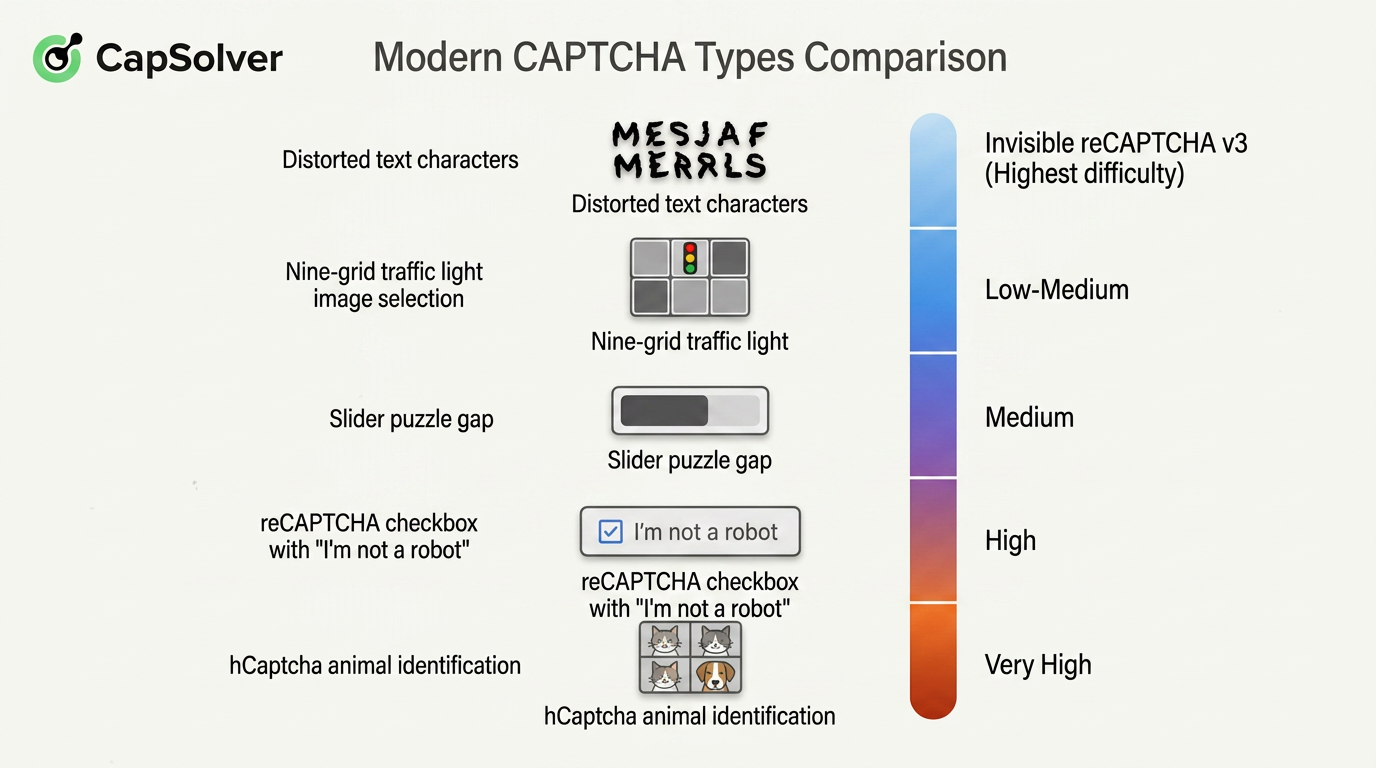
ध्यान देने योग्य है कि आधुनिक CAPTCHAs कई फॉर्म्स में आते हैं और उनकी जटिलता के स्तर अलग-अलग होते हैं। निम्नलिखित चित्र मुख्यधारा के CAPTCHA प्रकारों को वर्गीकृत करता है और उनके संबंधित जटिलता स्तरों को चिह्नित करता है:
एंड यूज़र्स के लिए पूरा प्रोसेस पूरी तरह पारदर्शी रहता है। Agentic Browser के टास्क लॉग में यूज़र्स केवल इतना साधारण संदेश देख सकते हैं:
“reCAPTCHA v2 detected. Automatically resolved in 1.2 seconds.”
एक ऐसा चेकपॉइंट जो पहले ऑटोमेशन वर्कफ़्लो को रोक देता, अब बैकग्राउंड में हैंडल हो सकता है और टास्क लॉग में दर्ज हो जाता है।
यह AI-एजेंट वर्कफ़्लो की निरंतरता को बेहतर बनाता है: एजेंट अधिकृत एनवायरनमेंट में समर्थित वेरिफिकेशन चेकपॉइंट्स को हैंडल कर सकता है, जबकि पेज और सेशन संदर्भ को संरक्षित रखता है। CAPTCHA-सॉल्विंग इन्फ्रास्ट्रक्चर एक सीमित, अवलोकनीय वर्कफ़्लो के भीतर “अदृश्य इंजन” की तरह कार्य करता है।
किसी नियंत्रित हैंडलिंग पाथ के बिना, CAPTCHA पॉपअप अभी भी अन्यथा वैध ऑटोमेटेड टास्क को बाधित कर सकता है।
यदि पिछले अध्यायों ने इस तकनीक को कुछ दूरस्थ महसूस कराया हो, तो निम्न उदाहरण आपका दृष्टिकोण पूरी तरह बदल सकते हैं। Agentic Browsers कोई अमूर्त भविष्य की अवधारणा नहीं हैं — वे तेज़ी से तीन प्रमुख क्षेत्रों में प्रवेश कर रहे हैं: पर्सनल प्रोडक्टिविटी, एंटरप्राइज़ ऑटोमेशन और डेटा कलेक्शन। प्रत्येक क्षेत्र में, वे अलग-अलग स्तरों पर व्यावहारिक समस्याएँ हल कर रहे हैं।
निम्न चित्र Agentic Browsers के कोर एप्लिकेशन परिदृश्यों का सारांश प्रस्तुत करता है:
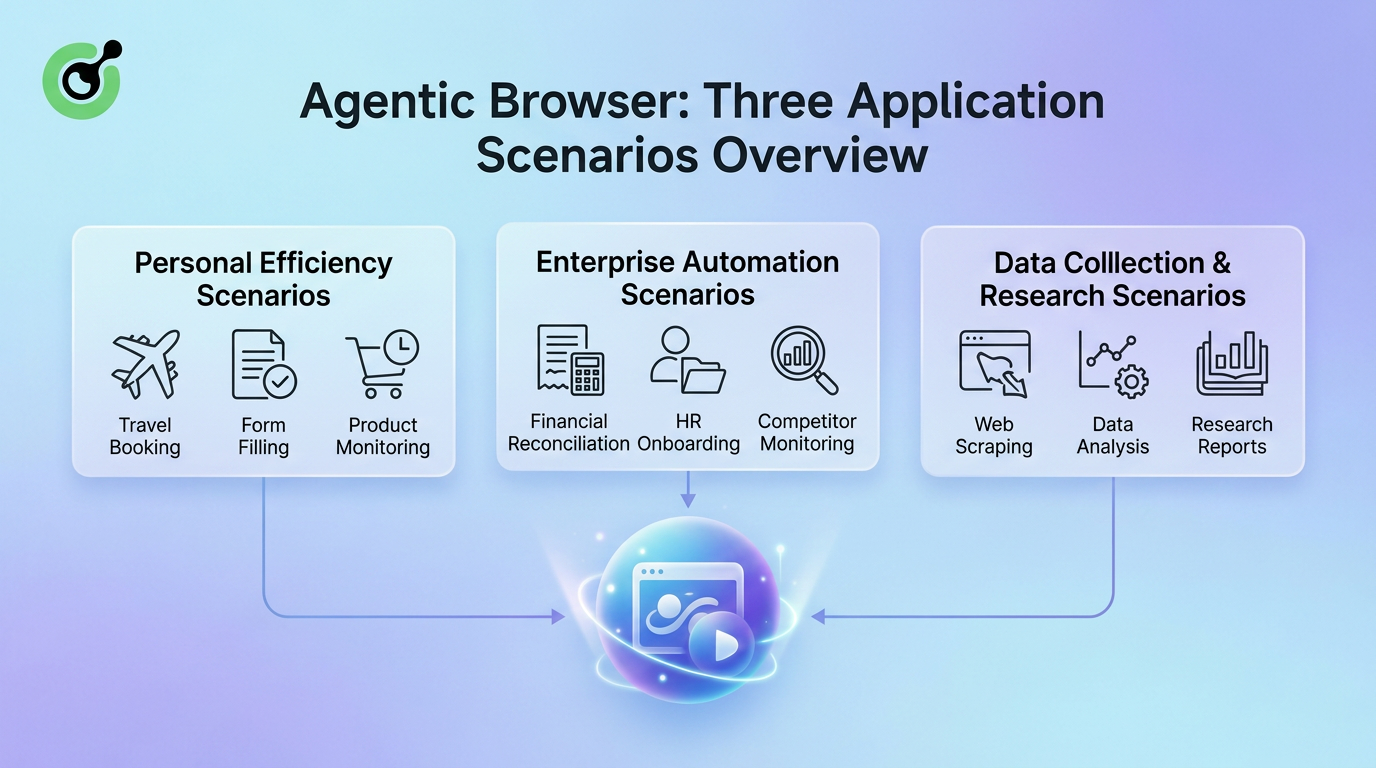
Agentic Browsers के एप्लिकेशन्स व्यक्तिगत उपयोगकर्ताओं से लेकर बड़े एंटरप्राइज़ तक और दैनिक टास्क्स से लेकर प्रोफेशनल रिसर्च वर्कफ़्लो तक फैले हुए हैं। पर्सनल प्रोडक्टिविटी में, वे यूज़र्स को ट्रिप बुक करने, दोहराए जाने वाले फ़ॉर्म भरने और प्रोडक्ट प्राइस फ़्लक्चुएशन मॉनिटर करने में मदद करते हैं। एंटरप्राइज़ ऑटोमेशन में, वे फाइनेंशियल रिकंसिलिएशन, कर्मचारी ऑनबोर्डिंग और प्रतियोगी ट्रैकिंग संभालते हैं। डेटा कलेक्शन और रिसर्च में, वे अथक क्रॉलर और इंटेलिजेंट एनालिसिस असिस्टेंट के रूप में कार्य करते हैं।
अब हम इन तीनों परिदृश्यों को विस्तार से देखेंगे ताकि समझ सकें कि Agentic Browsers वास्तव में कैसे “काम करते हैं।”
साधारण उपयोगकर्ताओं के लिए Agentic Browser का सबसे तात्कालिक मूल्य सरल है: समय बचाना।
हर दिन लोग ब्राउज़र के भीतर अनगिनत दोहराए जाने वाले और मल्टी-स्टेप ऑनलाइन टास्क्स करते हैं। इन टास्क्स में आमतौर पर तीन विशेषताएँ साझा होती हैं:
Agentic Browsers ठीक इसी तरह के टास्क्स को अपने हाथ में लेने में श्रेष्ठ हैं — वे स्थितियाँ जहाँ यूज़र जानते हैं कि उन्हें क्या करवाना है, लेकिन स्वयं मैन्युअली ऑपरेशन नहीं करना चाहते।
पर्सनल प्रोडक्टिविटी परिदृश्यों में Agentic Browsers निम्नलिखित विशिष्ट टास्क्स में सहायता कर सकते हैं:
उदाहरण के लिए, कोई Agentic Browser फ़्लाइट या होटल विकल्पों की तुलना कर सकता है, समय, पसंद या बजट के आधार पर परिणामों को फ़िल्टर कर सकता है और चुने गए विकल्पों का विवरण यूज़र के रिव्यू और कन्फर्मेशन के लिए तैयार कर सकता है।
वीज़ा एप्लिकेशन, स्कूल एप्लिकेशन या ख़र्च प्रतिपूर्ति जैसे टास्क्स अक्सर यूज़र्स से कई फ़ॉर्म्स में बार-बार वही जानकारी दर्ज करने की मांग करते हैं।
Agentic Browser एक “इन्फॉर्मेशन मैनेजर” की तरह काम करता है — वह यूज़र डेटा को सुरक्षित रूप से याद रखता है, फ़ॉर्म फ़ील्ड्स को ऑटोमैटिकली पहचानता है और उन्हें बुद्धिमानी से मैप करता है। उदाहरण के लिए, यह किसी पूरे नाम को स्वतः “First Name” और “Last Name” में विभाजित कर सकता है।
Agentic Browsers बैकग्राउंड में प्रोडक्ट इन्वेंटरी, प्राइस चेंज या नए प्रोडक्ट रिलीज़ मॉनिटर कर सकते हैं। जैसे ही कोई पूर्व-निर्धारित शर्त — जैसे प्राइस ड्रॉप या रीस्टॉकिंग इवेंट — पूरी होती है, ब्राउज़र तुरंत यूज़र को रिव्यू के लिए नोटिफाई कर देता है।
यूज़र एक्सपीरियंस में इस परिवर्तन को बेहतर दर्शाने के लिए, निम्न तालिका पारंपरिक वर्कफ़्लो और Agentic Browser वर्कफ़्लो की तुलना करती है:
| टास्क प्रकार | पारंपरिक वर्कफ़्लो समय लागत | Agentic Browser वर्कफ़्लो | यूज़र रोल में परिवर्तन |
|---|---|---|---|
| फ़्लाइट की तुलना और बुकिंग | 15–30 मिनट (मैन्युअली कई वेबसाइट्स ब्राउज़ करना) | 1 मिनट (आवश्यकताएँ बताना और सिफारिशें कन्फ़र्म करना) | एक्ज़िक्यूटर → निर्णय-निर्माता |
| जटिल ऑनलाइन फ़ॉर्म भरना | 20–40 मिनट (समान जानकारी बार-बार दर्ज करना) | 2 मिनट (ऑटोफिल परिणाम रिव्यू करना और छोटी-मोटी सुधार करना) | डेटा-एंट्री ऑपरेटर → रिव्यूअर |
| प्रोडक्ट रीस्टॉक या प्राइस ड्रॉप मॉनिटर करना | अत्यंत समय-साध्य (बार-बार मैन्युअल रिफ़्रेश और लगातार ध्यान) | 0 मिनट (बैकग्राउंड मॉनिटरिंग और ऑटोमेटिक नोटिफिकेशन) | मॉनिटर → रिसीवर |
| क्रॉस-प्लेटफ़ॉर्म डेटा ऑर्गनाइज़ेशन | 1–2 घंटे (कॉपी-पेस्ट और फॉर्मेटिंग) | 5 मिनट (ऑटोमैटिक एक्सट्रैक्शन और फॉर्मेटिंग) | मैन्युअल ऑपरेटर → एनालिस्ट |
तालिका 2-1 पारंपरिक व्यक्तिगत टास्क्स और Agentic Browser दक्षता की तुलना
जैसा कि ऊपर देखा जा सकता है, Agentic Browser प्रभावी रूप से एक पर्सनल असिस्टेंट की भूमिका निभाता है। यह यूज़र्स को “वर्कफ़्लो के ऑपरेटर्स” होने से मुक्त करता है और उन्हें “लक्ष्य निर्धारित करने वाले” और “आउटकम रिव्यू करने वाले” में बदल देता है।
यदि पर्सनल प्रोडक्टिविटी सुधार “प्रयास कम करने” के बारे में है, तो एंटरप्राइज़ एनवायरनमेंट में Agentic Browsers का मूल्य कनेक्शन के बारे में है।
बड़ी संस्थाएँ अकसर अनेक असंबद्ध लेगेसी सिस्टम, SaaS प्लेटफ़ॉर्म और सप्लायर पोर्टल पर निर्भर रहती हैं, जो API के ज़रिए आसानी से इंटीग्रेट नहीं हो पाते। कर्मचारियों को मजबूरन “मानवीय गोंद” बनना पड़ता है, जो बार‑बार हाथ से अलग‑अलग सिस्टमों के बीच सूचना स्थानांतरित करते रहते हैं।
यहीं पर Agentic Browsers अपने सबसे मज़बूत फ़ायदे दिखाते हैं।
स्पष्ट प्राधिकरण मिलने पर, एक Agentic Browser संगठन‑नियंत्रित वित्तीय या सप्लायर पोर्टल्स तक पहुँच सकता है, स्वीकृत रिकॉर्ड प्राप्त कर सकता है, उन्हें ERP सिस्टम से तुलना कर सकता है, विसंगति रिपोर्टें तैयार कर सकता है और समीक्षा के लिए नोटिफ़िकेशन ड्राफ़्ट बना सकता है।
संगठन ऑनबोर्डिंग टास्क पैकेज पहले से परिभाषित कर सकते हैं। संगठन‑नियंत्रित सिस्टम और स्वीकृत एक्सेस नीतियों की सीमा में, Agentic Browser HR और IT सिस्टमों में अधिकृत अकाउंट‑प्रोविज़निंग चरणों को तैयार या पूरा कर सकता है।
Agentic Browsers “मार्केट रडार” सिस्टम के रूप में काम कर सकते हैं; वे उन सार्वजनिक पेजों पर जाते हैं जो स्वचालित एक्सेस की अनुमति देते हैं, प्रासंगिक सूचना में हुए बदलावों की पहचान करते हैं और लागू शर्तों व रेट लिमिट्स के भीतर उन्हें संरचित डेटाबेस में सहेजते हैं।
एंटरप्राइज़ ऑटोमेशन में Agentic Browsers की विशिष्ट स्थिति को बेहतर ढंग से दर्शाने के लिए, नीचे दिया गया तालिका उन्हें मैन्युअल ऑपरेशन्स और पारंपरिक API इंटीग्रेशन से तुलना करता है:
| आयाम | मैन्युअल ऑपरेशन्स | API इंटीग्रेशन डेवलपमेंट | Agentic Browser |
|---|---|---|---|
| लागू सिस्टम | कोई भी सिस्टम जिसे यूज़र एक्सेस करने के लिए अधिकृत हो | केवल वे सिस्टम जिनमें ओपन APIs हों | अधिकृत वेब‑आधारित सिस्टम, जिनमें संगठन‑नियंत्रित लेगेसी सिस्टम शामिल हैं |
| डिप्लॉयमेंट चक्र | कोई डेवलपमेंट नहीं, पर समय‑साध्य | हफ़्तों से महीनों तक (डेवलपमेंट संसाधनों पर निर्भर) | घंटों से दिनों तक (टास्क कॉन्फ़िगरेशन और टेस्टिंग) |
| लचीलापन | उच्च (मानव डायनेमिक रूप से अनुकूलित होते हैं) | कम (परिवर्तन के बाद इंटरफ़ेस को फिर से लिखना पड़ता है) | उच्च (AI पेज परिवर्तनों के अनुसार डायनेमिक रूप से अनुकूलित होता है) |
| CAPTCHA/लॉगिन हैंडलिंग | मैन्युअल हैंडलिंग ज़रूरी | आम तौर पर सीधे हैंडल करना कठिन | अधिकृत वर्कफ़्लो के भीतर कॉन्फ़िगर किए गए CAPTCHA‑हैंडलिंग को कॉल कर सकता है |
| स्केलेबिलिटी | कमज़ोर | अत्यंत मज़बूत | मज़बूत (समानांतर टास्क निष्पादन संभव) |
| सामान्य विफलता परिदृश्य | मानव थकान और चूक | API रेट लिमिट्स या वर्ज़न असंगति | अत्यधिक अव्यवस्थित पेज स्थितियों में मानवीय पुष्टि की आवश्यकता हो सकती है |
तालिका 2‑2 एंटरप्राइज़ क्रॉस‑सिस्टम ऑटोमेशन समाधानों की तुलना
जैसा ऊपर दिखाया गया है, Agentic Browsers APIs को बदलने के लिए डिज़ाइन नहीं किए गए हैं। इसके बजाय, वे तब एक हल्की इंटीग्रेशन लेयर प्रदान करते हैं जब APIs उपलब्ध न हों या उन्हें लागू करना बहुत महँगा हो।
AI की लचीलापन और अनुकूलन‑क्षमता का लाभ उठाकर, Agentic Browsers पारंपरिक ऑटोमेशन तरीकों से छूटे अंतरालों को भरते हैं, जिससे एंटरप्राइज़ बिना लेगेसी इन्फ्रास्ट्रक्चर को दोबारा बनाए, बुद्धिमान क्रॉस‑सिस्टम समन्वय हासिल कर सकते हैं।
डेटा को अक्सर डिजिटल युग का तेल कहा जाता है, फिर भी स्वच्छ सार्वजनिक वेब डेटा को कुशलतापूर्वक इकट्ठा करना हमेशा कठिन रहा है।
पारंपरिक वेब क्रॉलर स्थिर पार्सिंग नियमों पर निर्भर होते हैं। जैसे ही लक्षित वेबसाइटें अपना लेआउट बदलती हैं या अतिरिक्त सत्यापन की मांग करती हैं, क्रॉलर पूरी तरह विफल हो सकते हैं। स्वचालित संग्रहण केवल तभी जारी रहना चाहिए जब एक्सेस अधिकृत हो और लागू साइट शर्तों के अनुरूप हो। अकादमिक शोधकर्ता, मार्केट रिसर्च फ़र्म और खोजी पत्रकारिता टीमें अक्सर बड़ी संख्या में सार्वजनिक वेबपेजों से विशिष्ट जानकारी निकालने की ज़रूरत महसूस करती हैं, जिससे पारंपरिक तरीक़े महंगे और समय‑साध्य हो जाते हैं।
Agentic Browsers डेटा संग्रह के लिए एक बिल्कुल नया प्रतिमान पेश करते हैं:
“कोड नियमों” पर आधारित एक्सट्रैक्शन से “सिमैंटिक उद्देश्यों” पर आधारित एक्सट्रैक्शन की ओर बदलाव।
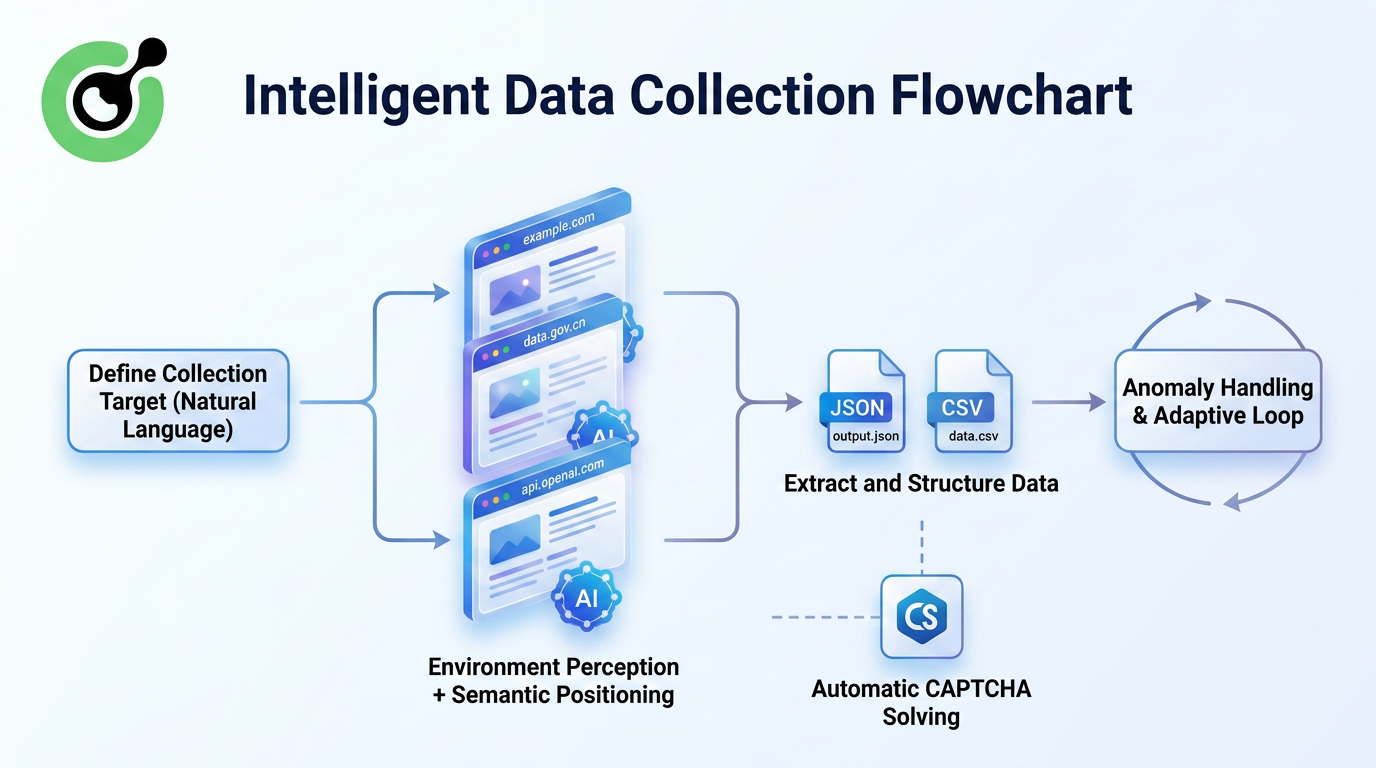
इनका वर्कफ़्लो आम तौर पर इस प्रकार काम करता है:
शोधकर्ता आवश्यक डेटा डाइमेंशन और सैंपल रेंज को प्राकृतिक भाषा में वर्णित करते हैं। उदाहरण के लिए:
“शीर्ष 100 ई‑कॉमर्स प्रोडक्ट पेजों से प्रोडक्ट टाइटल, प्राइस, रेटिंग और रिव्यू काउंट निकालो, जबकि प्रायोजित (sponsored) प्रोडक्ट्स को छोड़ दो।”
Agentic Browser स्वायत्त रूप से वेबपेजों पर नेविगेट करता है, पर्यावरणीय अनुभूति के ज़रिए प्रासंगिक सूचना ब्लॉक्स की पहचान करता है, बुद्धिमानी से डेटा निकालकर संरचित करता है और पेजिनेशन, इन्फ़िनिट स्क्रोलिंग और पॉप‑अप्स जैसी जटिल इंटरैक्शनों को संभालता है।
जब लक्षित वेबसाइटें अपना लेआउट बदलती हैं, तो पारंपरिक क्रॉलर अक्सर तुरंत ध्वस्त हो जाते हैं। इसके विपरीत, Agentic Browsers जानकारी को दृश्य रूप से दोबारा खोजने और निष्पादन जारी रखने की कोशिश करते हैं।
यह दृष्टिकोण कई बुनियादी सुधार लाता है:
AI “कीमत” को स्थिर HTML क्लास नामों पर निर्भर रहने के बजाय सिमैंटिक रूप से पहचानता है कि वह कैसी दिखती है।
छोटे‑मोटे लेआउट परिवर्तन अब तुरंत एक्सट्रैक्शन पाइपलाइन को नहीं तोड़ते।
लॉगिन, इन्फ़िनिट स्क्रोलिंग या टैब‑स्विचिंग की माँग करने वाली अधिकृत वेबसाइटों के लिए, Agentic Browsers समर्थित ब्राउज़र क्रियाओं और स्वीकृत सत्रों का उपयोग कर सकते हैं और फिर अनुमत जानकारी निकालते हैं।
टास्क कॉन्फ़िगरेशन सहेजे और साझा किए जा सकते हैं, जिससे डेटा संग्रह मानकीकृत और पुनरुत्पाद्य बन जाता है।
डेटा संग्रह कार्यों में Agentic Browsers की रेज़िलिएंस (लचीलापन) के फ़ायदों को बेहतर ढंग से दर्शाने के लिए, नीचे दिया गया चित्र कई वेबसाइट री‑डिज़ाइनों के बाद पारंपरिक क्रॉलर और Agentic Browsers की तुलना करता है:
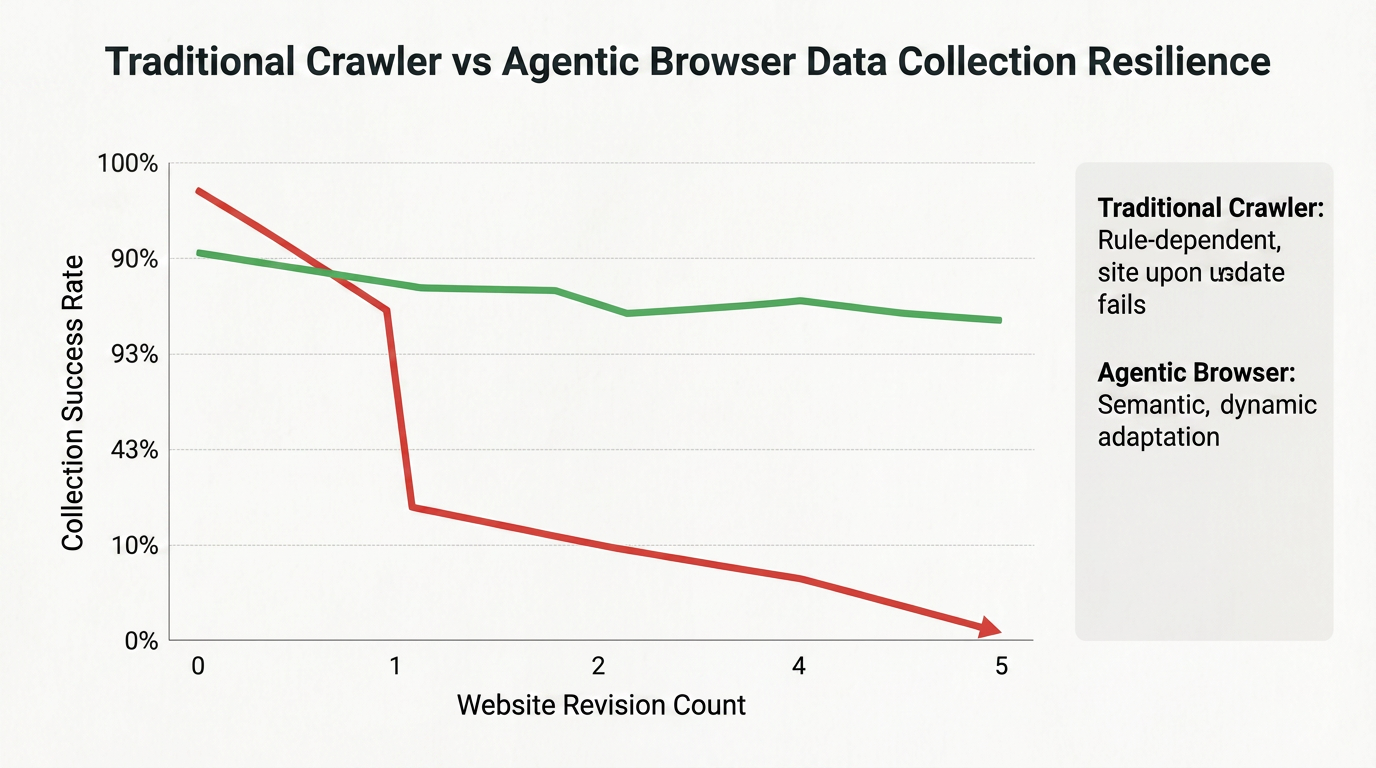
पहले ही री‑डिज़ाइन के बाद पारंपरिक क्रॉलर की सफलता दर नाटकीय रूप से गिर जाती है, जबकि Agentic Browsers अपनी दृश्य लोकेलाइज़ेशन और सिमैंटिक समझ क्षमताओं के कारण अनेक री‑डिज़ाइनों के बाद भी अपेक्षाकृत ऊँची एक्सट्रैक्शन सफलता दर बनाए रखते हैं।
यह लचीलापन उन्हें दीर्घकालिक, बड़े पैमाने के डेटा संग्रह प्रोजेक्ट्स के लिए आदर्श बनाता है।
उदाहरण के लिए, मान लें किसी सोशल‑साइंस रिसर्च टीम को 30 देशों के 200 पॉलिसी वेबसाइटों पर विशिष्ट नीति धाराओं की तुलना करनी है। पारंपरिक तरीक़े से, रिसर्च असिस्टेंट्स को महीनों तक मैन्युअल रूप से जानकारी कॉपी और व्यवस्थित करनी पड़ती।
अब, शोधकर्ता एक Agentic Browser टास्क कॉन्फ़िगर कर सकते हैं, जो लागू शर्तों और रेट लिमिट्स के भीतर सार्वजनिक पॉलिसी पेजों पर जाए, लक्षित कीवर्ड वाले पेज ढूँढे, संबंधित धाराएँ निकाले और उन्हें स्वतः वर्गीकृत करे।
शोधकर्ताओं को बाद में केवल संकलित परिणामों की समीक्षा और विश्लेषण करना होता है, जिससे मूल्यवान मानवीय प्रयास वास्तविक “शोध” पर केंद्रित हो पाता है, न कि दोहराए जाने वाले “मैन्युअल परिवहन कार्य” पर।
Agentic Browser केवल नया उत्पाद नहीं, बल्कि ऑनलाइन होने का एक बिल्कुल नया दर्शन है। इसका मुख्य तर्क यह है: ब्राउज़र सिर्फ़ एक इंटरफ़ेस न हो जो आपके क्लिक का इंतज़ार करे, बल्कि एक बुद्धिमान एजेंट हो जो आपके इरादे को समझे और कार्य पूरे करने में मदद करे। तकनीकी अमल के नज़रिए से, यह टास्क की योजना बनाने के लिए बड़े भाषा मॉडल की तर्क‑क्षमता, वेब पेजों को समझने के लिए मल्टी‑मॉडल अनुभूति, ऑपरेशन्स निष्पादित करने के लिए वास्तविक ब्राउज़र परिवेश और अधिकृत ऑटोमेशन में समर्थित वेरिफ़िकेशन चेकपॉइंट सँभालने के लिए CapSolver जैसी इन्फ्रास्ट्रक्चर पर निर्भर करता है। इन तकनीकों का संगम पिछले तीस साल से इस्तेमाल हो रही “सूचना खिड़की” को एक वास्तविक “एक्शन प्लेटफ़ॉर्म” में अपग्रेड कर रहा है।
प्र.1: सामान्य AI मॉडल अपने‑आप CAPTCHAs क्यों नहीं सुलझा सकते?
उ.1: भले ही सामान्य AI मॉडल शक्तिशाली हों, CAPTCHAs विशेष रूप से प्रतिकूल (adversarial) होने और लगातार बदलते रहने के लिए डिज़ाइन किए जाते हैं। उन्हें विश्वसनीय और तेज़ी से हल करने के लिए CapSolver जैसी विशेषीकृत इन्फ्रास्ट्रक्चर की आवश्यकता होती है, जो केवल इसी कार्य के लिए समर्पित हो।
प्र.2: CapSolver Agentic Browsers की कैसे मदद करता है?
उ.2: CapSolver एक “अदृश्य इंजन” की तरह काम करता है जो प्रलेखित API के माध्यम से समर्थित CAPTCHA चुनौतियों को सँभालता है। इससे एक अधिकृत Agentic Browser वर्कफ़्लो आवश्यक टास्क संदर्भ सबमिट कर सकता है, परिणाम लागू कर सकता है, पेज की स्थिति सत्यापित कर सकता है और आगे बढ़ सकता है।
प्र.3: क्या Agentic Browsers मानव नौकरियों की जगह ले लेंगे?
उ.3: इन्हें “जॉब्स” नहीं, बल्कि “टास्क्स” बदलने के लिए डिज़ाइन किया गया है। दोहराए जाने वाले डिजिटल श्रम को सँभालकर, ये इंसानों को उच्च‑स्तरीय रचनात्मकता और रणनीतिक निर्णय‑निर्धारण पर ध्यान केंद्रित करने की अनुमति देते हैं।
प्र.4: मैं आज ही Agentic Browser का उपयोग कैसे शुरू कर सकता हूँ?
उ.4: कई प्रयोगात्मक ब्राउज़र और एक्सटेंशन पहले से उपलब्ध हैं। सर्वोत्तम अनुभव के लिए, CapSolver जैसे विश्वसनीय CAPTCHA‑सॉल्विंग सर्विस का उपयोग केवल उन समर्थित चेकपॉइंट्स के लिए करें जो उन सिस्टमों में हों जिन्हें आप स्वामित्व में रखते हैं या जिन्हें ऑटोमेट करने के लिए अधिकृत हैं।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
ऐसे CAPTCHA हैंडलिंग को ठीक करें जो लोकली काम करता है लेकिन क्लाउड AI एजेंट में फेल हो जाता है। ब्राउज़र सेटअप, डिपेंडेंसियाँ, क्रेडेंशियल्स, नेटवर्क एक्सेस और पेज स्टेट की तुलना करें।
क्लॉड कोड में कैपसॉल्वर एमसीपी सेट करें, उपलब्ध कैपचा उपकरण चेक करें, और एक समर्थित, अधिकृत ब्राउजर कार्य के लिए टोकन या पृष्ठ हल करने का चयन करें।