

🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Nov 13, 2026
अद्यतन Nov 13, 2026 · मिनट पढ़ने का समय
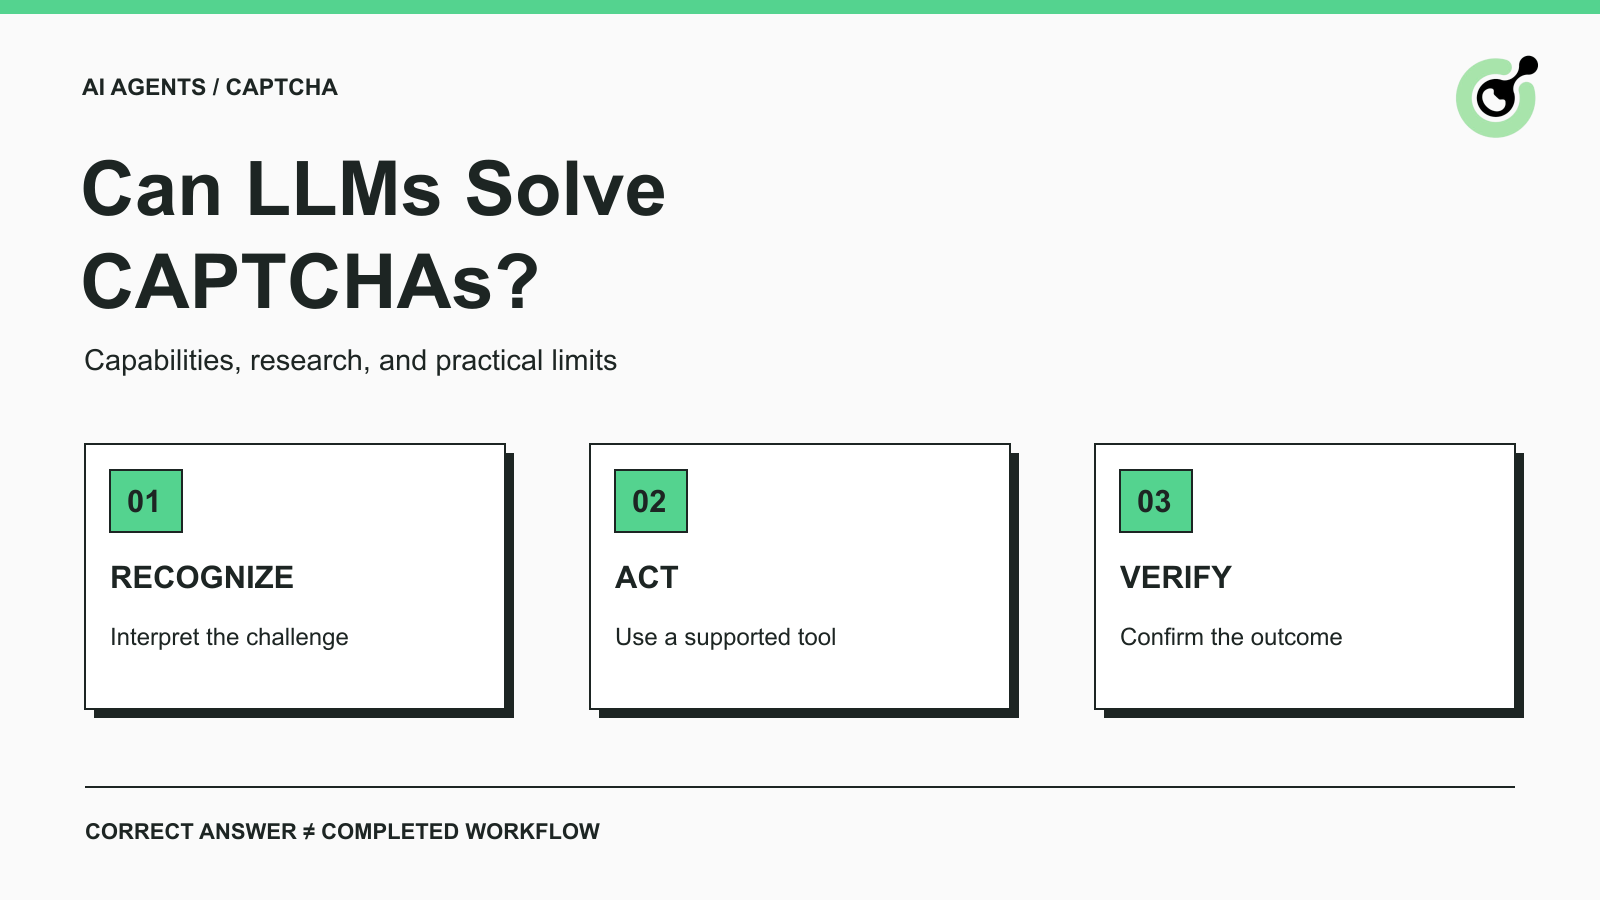
सही ढंग से पहचाने गए ऑब्जेक्ट का स्क्रीनशॉट किसी मॉडल की विज़न क्षमता का अच्छा प्रमाण हो सकता है। लेकिन यह सवाल खुला रह जाता है कि क्या एप्लिकेशन ने वेरिफिकेशन स्वीकार किया और अनुरोधित ऑपरेशन पूरा किया? ब्राउज़र एजेंट, QA, या अनुमत डेटा संग्रह के लिए किसी LLM CAPTCHA सॉल्वर का मूल्यांकन करते समय यह अंतर महत्वपूर्ण है।
यह गाइड बताती है कि इस शब्द का मतलब क्या है, शोध क्या दर्शाता है, और मूल्यांकन में किन जाँचों की ज़रूरत है। यह यह भी दिखाती है कि CapSolver जैसी सेवा कहाँ फ़िट होती है। फोकस क्षमता और प्रोडक्ट चुनने पर है, न कि किसी विशेष वेबसाइट पर हमले के प्रॉम्प्ट या इस दावे पर कि हर AI एजेंट हर चुनौती हल कर सकता है।
LLM CAPTCHA सॉल्वर एक भाषा मॉडल (अक्सर इमेज समझने की क्षमता के साथ) का उपयोग करके CAPTCHA कार्य की व्याख्या करता है या उसके पूरा होने में मदद करता है। यह वाक्यांश कई अलग-अलग सिस्टमों को कवर करता है, इसलिए यह पूछना ज़रूरी है कि प्रोडक्ट वास्तव में क्या इनपुट लेता है और क्या आउटपुट देता है।
कोई सिस्टम सिर्फ इमेज लेकर टेक्स्ट उत्तर दे सकता है। कोई दूसरा सिस्टम क्लिक लोकेशन का प्रस्तावित स्थान वापस कर सकता है। कोई ब्राउज़र एजेंट एक अलग सॉल्विंग सेवा को कॉल कर सकता है, फिर ट्रस्टेड एप्लिकेशन कोड द्वारा परिणाम जाँचने के बाद कार्य जारी रख सकता है। इन सिस्टमों के लिए अलग‑अलग मूल्यांकन तरीकों की ज़रूरत होती है।
LLM शब्दावली प्रविष्टि आधारभूत मॉडल श्रेणी समझाती है। ब्राउज़र या सॉल्वर टूल जोड़ने से मॉडल को अतिरिक्त क्षमताएँ मिलती हैं; इससे हर टूल का परिणाम मॉडल की अपनी विज़ुअल रीजनिंग का नतीजा नहीं बन जाता।
पहचान यह पूछती है कि क्या मॉडल ने चुनौती इनपुट को सही तरह से समझा। संयोजन यह पूछता है कि क्या एजेंट वर्कफ़्लो के सही चरण पर सही टूल चुनता और उपयोग करता है।
कोई एजेंट जो CAPTCHA को API पर डेलीगेट करता है, इमेज खुद हल किए बिना भी उपयोगी हो सकता है। इसके विपरीत, जो मॉडल इमेज को सही लेबल करता है, उसके पास फिर भी ब्राउज़र कंट्रोल, टास्क इनपुट, या स्वीकृत रिस्पॉन्स की कमी हो सकती है, जो वेब ऑपरेशन पूरा करने के लिए ज़रूरी है। वही रोल आँकें जो आपकी एप्लिकेशन को सचमुच चाहिए।
प्रकाशित शोध दिखाता है कि प्रदर्शन चुनौती के प्रकार और सिस्टम डिज़ाइन के अनुसार बदलता है। यह “क्या LLMs CAPTCHA हल कर सकते हैं?” के लिए एक सशर्त उत्तर देता है।
Oedipus शोध पेपर रीजनिंग CAPTCHA की जाँच करता है और सीधे LLM क्षमताओं का उपयोग करने पर आने वाली मुश्किलों की रिपोर्ट करता है। इसका प्रस्तावित फ़्रेमवर्क टास्क डीकंपोज़िशन और डोमेन-विशिष्ट प्रतिनिधित्व जोड़ता है। इसलिए फ़्रेमवर्क का परिणाम केवल बिना सहारे वाले मॉडल के बजाय आसपास की पूरी प्रणाली को शामिल करता है।
COGNITION अध्ययन कई CAPTCHA टास्क प्रकारों पर मल्टीमॉडल मॉडलों का मूल्यांकन करता है। इसके निष्कर्ष पहचान-उन्मुख, कम-इंटरैक्शन वाले कार्यों को कठिन लोकेलाइज़ेशन, स्पैशियल-रीजनिंग, और क्रॉस-फ़्रेम कार्यों से अलग दिखाते हैं। पेपर सिर्फ शुद्ध सटीकता के बजाय रीट्राइ, लेटेंसी, और लागत पर भी विचार करता है।
ये अध्ययन हर सेवा, ब्राउज़र, या लाइव डिप्लॉयमेंट के लिए ट्रांसफ़रेबल सफलता दर नहीं देते। किसी दावे को पढ़ते समय मूल्यांकित मॉडल, टास्क संग्रह, रीट्राइ अनुमति, और माप बिंदु को दावे के साथ जोड़े रखें। सिर्फ एक नया मॉडल नाम इस बात का सबूत नहीं है कि वही परिणाम अब भी लागू है।
किसी उपयोगी बेंचमार्क का विवरण बताएगा कि क्या सफलता का मतलब सही लेबल था, स्वीकृत इंटरैक्शन अनुक्रम था, वैध सर्वर रिस्पॉन्स था, या एप्लिकेशन का मूल काम पूरा होना था।
किसी अधिकृत QA टीम के लिए इमेज‑answer बेंचमार्क पहचान घटक चुनने में मदद कर सकता है। ब्राउज़र‑एजेंट टीम को पेज इंटरैक्शन और एप्लिकेशन पूर्णता के बारे में अतिरिक्त सबूत चाहिए। किसी भी टीम को चुपचाप एक मापन को दूसरे से नहीं बदल देना चाहिए।
यह भी जाँचें कि असफल या टाइम‑आउट हुई कोशिशें हर गणना में शामिल हैं या नहीं। सिर्फ सफल आउटपुट रिपोर्ट करना उस काम को छिपा देता है जिसे किसी ऑपरेटर को जाँचने की ज़रूरत पड़ेगी।
सही विज़ुअल उत्तर काफ़ी नहीं हो सकता क्योंकि एप्लिकेशन को वैध वेरिफिकेशन रिस्पॉन्स और अपनी स्वीकृति जाँचें भी चाहिए होती हैं। दिखने वाली पहेली सिर्फ वह हिस्सा है जो स्क्रीनशॉट दिखाता है।
उदाहरण के लिए, Google के रिस्पॉन्स-वेरिफिकेशन दस्तावेज़ एक रिस्पॉन्स टोकन का वर्णन करते हैं जिसे एप्लिकेशन का बैकएंड वेरिफ़ाई करता है। यह दो मिनट की वैधता और एक बार उपयोग का नियम बताता है। इमेज का मॉडल‑जनित वर्णन वह वेरिफिकेशन रिस्पॉन्स नहीं है।
इसी तरह, Cloudflare की Turnstile वेलिडेशन गाइड सर्वर‑साइड टोकन वेलिडेशन की मांग करती है और पाँच मिनट की लाइफ़टाइम के साथ सिंगल‑यूज़ टोकन का वर्णन करती है। Turnstile का मूल्यांकन ऐसे नहीं होना चाहिए जैसे यह सिर्फ एक इमेज‑लेबलिंग टास्क हो।
ये उदाहरण बताते हैं कि मूल्यांकन का एंडपॉइंट क्यों मायने रखता है। वे यह संकेत नहीं देते कि सॉल्वर एप्लिकेशन एक्सेस की गारंटी देता है। साइट अपनी एप्लिकेशन लॉजिक और एक्सेस निर्णयों पर अपना नियंत्रण बनाए रखती है।
अपनी एप्लिकेशन का परीक्षण करते समय सर्वर‑साइड वेलिडेशन परिणाम और अंतिम एप्लिकेशन स्टेट की जाँच करें। किसी अनुमत तृतीय‑पक्ष वर्कफ़्लो के साथ काम करते समय आपके लिए उपलब्ध दस्तावेज़ित, ऑब्ज़र्वेबल आउटपुट का उपयोग करें।
यदि बैकएंड परिणाम उपलब्ध नहीं है, तो उसे अज्ञात (unknown) की तरह लेबल करें। बदला हुआ बटन, बंद हुआ विजेट, या लौटा हुआ API रिस्पॉन्स उपयोगी संकेत हो सकते हैं, परन्तु इनमें से किसी को भी रिपोर्ट में चुपचाप “सर्वर ने स्वीकार किया” नहीं बना देना चाहिए।
अपना CapSolver बोनस कोड रिडीम करें
अपना ऑटोमेशन बजट तुरंत बढ़ाएँ!
CapSolver अकाउंट में टॉप‑अप करते समय बोनस कोड CAP26 का उपयोग करें और हर रिचार्ज पर बिना किसी सीमा के अतिरिक्त 5% बोनस पाएँ।
इसे अभी अपने CapSolver डैशबोर्ड में रिडीम करें
एक समर्पित CAPTCHA सॉल्वर किसी बड़े अधिकृत वर्कफ़्लो के अंदर समर्थित वेरिफिकेशन कार्य को संभालता है। एजेंट मूल लक्ष्य के लिए ज़िम्मेदार रहता है, और एप्लिकेशन परिणाम की जाँच के लिए ज़िम्मेदार रहती है।
CapSolver Agent Tools दस्तावेज़ मॉडल निर्णयों, टूल एडेप्टर, और Core निष्पादन लेयर के बीच बँटवारा बताता है। इससे टीमों को दस्तावेज़ित इंटीग्रेशन रूट मिलता है, और उन्हें भाषा मॉडल से किसी स्क्रीनशॉट से सॉल्विंग प्रोटोकॉल निकालने की उम्मीद नहीं रखनी पड़ती।
व्यावहारिक मूल्यांकन को यह क्रम अपनाना चाहिए:
यह ज़िम्मेदारी की चेकलिस्ट है, न कि निष्पादनयोग्य इंटीग्रेशन कोड। अपने चुने हुए फ़्रेमवर्क के लिए आधिकारिक उदाहरण का उपयोग करें और डिप्लॉयमेंट से पहले अपने वातावरण में वेरिफ़ाई करें।
मॉडल को आम तौर पर परिणाम की व्याख्या चाहिए होती है, जैसे पूरा हुआ, अभी लंबित, या समीक्षा के लिए रोका गया। उसे ब्राउज़र कुकीज़ की पूरी सामग्री, सर्विस क्रेडेंशियल, या हर कच्चे रिस्पॉन्स की ज़रूरत नहीं होती।
इससे ट्रबलशूटिंग साफ़ रहती है। देखी गई चुनौती, चुना गया ऑपरेशन, और अंतिम स्टेट को अलग‑अलग रिकॉर्ड करें। यदि कोई टूल कॉल कभी शुरू ही नहीं हुई, तो टूल सिलेक्शन की जाँच करें। यदि सॉल्वर ने परिणाम लौटाया पर एप्लिकेशन ने उसे ठुकरा दिया, तो उस बाद के चरण की जाँच अलग से करें।
स्क्रीनशॉट इनपुट या टोकन API चुनने जैसे अलग इम्प्लीमेंटेशन सवाल के लिए कंप्यूटर‑यूज़ एजेंटों के लिए CAPTCHA हैंडलिंग देखें। वह निर्णय इस पर निर्भर करता है कि रनटाइम क्या देख और निष्पादित कर सकता है।
LLM CAPTCHA सॉल्वर का मूल्यांकन छोटे, अधिकृत टास्क सेट पर स्पष्ट स्वीकृति शर्तों के साथ करें। उद्देश्य आपकी ज़रूरत वाले रोल को जाँचना है, न कि कोई सार्वभौमिक लीडरबोर्ड बनाना।
सिस्टमों की तुलना से पहले इनपुट प्रकार, अनुमत क्रियाएँ, समर्थित चुनौती परिवार, रीट्राइ बजट, और अपेक्षित अंतिम स्टेट लिख लें। सामान्य ब्राउज़र विफलताओं को चुनौती विफलताओं से अलग रखें। नहीं तो धीमी पेज लोडिंग सॉल्विंग परिणाम को ग़लत रूप से बिगाड़ सकती है।
पूरी मूल्यांकित इकाई के लिए परिणामों की गिनती, बीता हुआ समय, प्रयुक्त प्रयास, और लागत की रिपोर्ट करें। यदि इकाई कोई एजेंट जॉब है, तो असफल जॉब और दोहराए गए पेड कॉल्स को शामिल करें। यदि यह इमेज टास्क है, तो यह बात सीधे कहें।
कोई उपयोगी मूल्यांकन रिपोर्ट नकारात्मक केस भी सहेज कर रखती है। इसमें असमर्थित चुनौती, गायब ज़रूरी इनपुट, और ऐसा परिणाम शामिल करें जो जॉब समाप्त होने के बाद पहुँचे। इन मामलों में वांछित व्यवहार अगला प्रयास नहीं, बल्कि स्पष्ट रुकना भी हो सकता है।
किसी मॉडल के कॉन्फिडेंस‑स्टेटमेंट को स्वीकृति की मापी हुई प्रायिकता की तरह न लें। एप्लिकेशन या टेस्ट हार्नेस से देखे गए परिणाम का उपयोग करें। हार्नेस को उन्हीं सिस्टमों और डेटा तक सीमित रखें जिन्हें आप टेस्ट करने के लिए अधिकृत हैं।
छोटा परीक्षण दिखा सकता है कि किसी इंटीग्रेशन ने जाँचे गए मामलों पर इच्छित तरह व्यवहार किया। यह “सब एजेंटों के लिए सबसे अच्छा” या “हर साइट पर काम करता है” जैसे दावों को सही नहीं ठहराता। टेस्ट रिपोर्ट को खरीद निर्णय के साथ जोड़कर रखें ताकि दूसरी टीम इसकी सीमाएँ देख सके।
जब ज़रूरतें बदलें, तो संबद्ध केस दोहराएँ। मॉडल, ब्राउज़र रनटाइम, सॉल्वर टास्क प्रकार, या टार्गेट एप्लिकेशन बदलने से आपके पुराने सबूत की वैधता भी बदल सकती है। सटीक कम्पैटिबिलिटी‑स्टेटमेंट किसी असीमित वादे से ज़्यादा उपयोगी होती है।
केवल पहचान मॉडल तब चुनें जब आवश्यकता एक सीमित इमेज‑अंडरस्टैंडिंग टास्क हो जिसे आप सीधे मूल्यांकित कर सकें। दस्तावेज़ित सॉल्विंग इंटीग्रेशन तब चुनें जब किसी अधिकृत एप्लिकेशन को समर्थित CAPTCHA परिणाम चाहिए। एजेंट तब उपयोग करें जब आसपास के काम को योजना और टूल चयन से लाभ मिलता हो।
CapSolver दस्तावेज़ित सॉल्विंग चरण प्रदान कर सकता है। मौजूदा समर्थित टास्क प्रकार की पुष्टि करें, पूरे अधिकृत वर्कफ़्लो को टेस्ट करें, और एप्लिकेशन स्वीकृति को अलग परिणाम की तरह ट्रीट करें।
आधिकारिक CAPTCHA गेटिंग‑स्टार्टेड गाइड से शुरू करें और वही क्षमता चुनें जो आपकी वास्तविक चुनौती से मेल खाती हो। पहला परीक्षण इतना छोटा रखें कि विस्तार से हर परिणाम को देखने के बाद ही उपयोग बढ़ाएँ।
प्र: क्या LLMs CAPTCHA हल कर सकते हैं?
उपयुक्त विज़ुअल क्षमताओं वाले LLM कुछ मूल्यांकित CAPTCHA टास्क हल कर सकते हैं। परिणाम चुनौती, मॉडल, आसपास की प्रणाली, और सफलता की परिभाषा पर निर्भर करते हैं। सही विज़ुअल उत्तर अपने‑आप सफल वेबसाइट वेरिफिकेशन साबित नहीं करता।
प्र: क्या LLM CAPTCHA सॉल्वर और CAPTCHA API एक ही चीज़ हैं?
नहीं। LLM एक मॉडल घटक है; CAPTCHA API एक दस्तावेज़ित सर्विस ऑपरेशन को एक्सपोज़ करती है। कोई एजेंट इमेज पहचान खुद किए बिना भी उस API को कॉल कर सकता है।
प्र: क्या टेक्स्ट‑ओनली LLM इमेज CAPTCHA हल कर सकता है?
टेक्स्ट‑ओनली LLM सीधे इमेज का निरीक्षण नहीं कर सकता। उसे अलग इमेज‑सक्षम घटक या विज़ुअल जानकारी का दूसरा स्रोत चाहिए, और पूरी प्रणाली का फिर भी मूल्यांकन ज़रूरी होगा।
प्र: क्या एजेंट को CAPTCHA पास होने तक बार‑बार रीट्राइ करते रहना चाहिए?
नहीं। स्पष्ट प्रयास और समय बजट तय करें, फिर बजट ख़त्म होने पर रुक जाएँ या समीक्षा का अनुरोध करें। बार‑बार कोशिशें असमर्थित इनपुट या एप्लिकेशन रिजेक्शन को छुपा नहीं देनी चाहिए।
प्र: क्या कोई शोध बेंचमार्क साबित करता है कि सॉल्वर मेरी वेबसाइट पर चलेगा?
नहीं। बेंचमार्क अपने मूल्यांकित टास्क और शर्तों का वर्णन करता है। ज़रूरी क्षमता को अपनी अधिकृत एनवायरनमेंट में वेलिडेट करें और पहचान परिणामों को एप्लिकेशन की पूर्णता से अलग रखें।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
निर्धारित करें कि आपका कंप्यूटर-उपयोग एजेंट वास्तव में कौन-से CAPTCHA इनपुट प्रदान कर सकता है, और कब ब्राउज़र निरीक्षण पर स्विच करना है या मानवीय इनपुट का अनुरोध करना है।
AI एजेंटों में MCP CAPTCHA रद्दीकरण को संभालें। नई कॉल्स को रोकें, रिमोट टास्क और लोकल वेट के बीच अंतर करें, और देर से आने वाले परिणामों को काम दोबारा शुरू करने से रोकें।
