🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Oct 29, 2026
अद्यतन Oct 29, 2026 · मिनट पढ़ने का समय
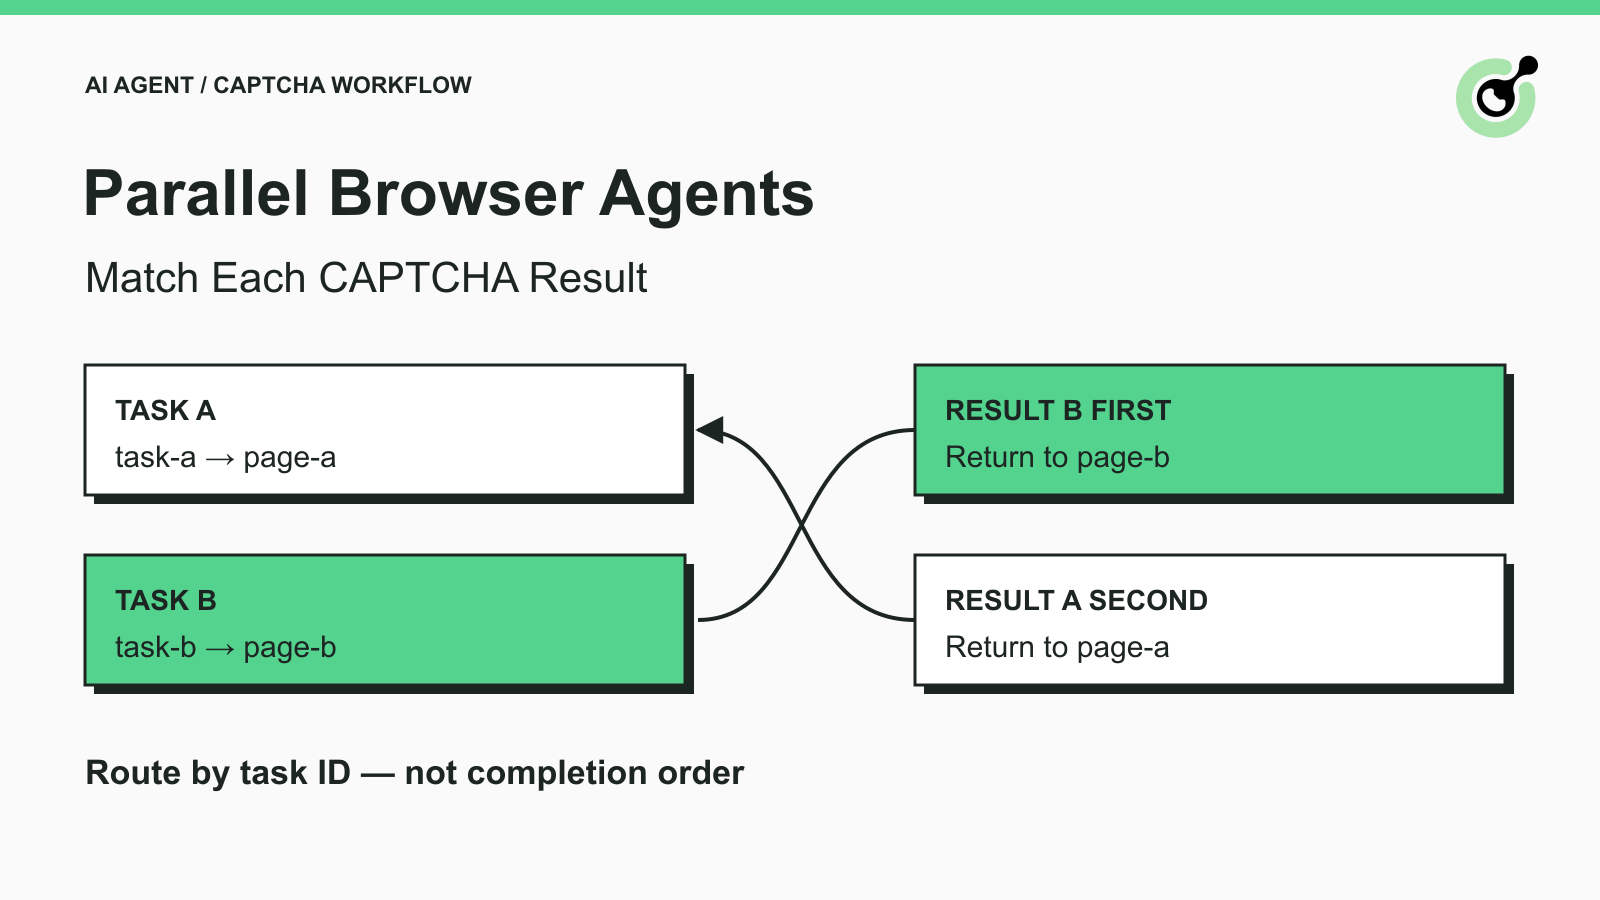
दो ब्राउज़र एजेंट अलग-अलग, अधिकृत टास्क के दौरान समर्थित CAPTCHAs का सामना करते हैं। एजेंट A पहले शुरू होता है, लेकिन एजेंट B को पहले परिणाम मिलता है। यदि एप्लिकेशन बस अगले परिणाम को पहले प्रतीक्षा कर रहे टैब को असाइन कर दे, तो दोनों जॉब प्रभावित हो सकते हैं, जबकि प्रत्येक सॉल्वर रिक्वेस्ट मान्य थी।
यह एक टास्क-कोरिलेशन समस्या है। अधिक रीट्राईज़ भी उस परिणाम को ठीक नहीं कर सकते जो गलत पेज पर पहुँचा दिया गया हो। एप्लिकेशन को यह याद रखना होगा कि किस ब्राउज़र वर्क आइटम ने कौन-सा सॉल्वर टास्क बनाया था, और जब प्रतिक्रिया आती है तब वह वर्क आइटम अब भी करंट है या नहीं।
CapSolver असिंक्रोनस API कार्य के लिए टास्क आइडेंटिफ़ायर लौटाता है। यह गाइड बताता है कि समानांतर एजेंट्स के बीच उस एसोसिएशन को कैसे सुरक्षित रखें, एक छोटे से लोकल उदाहरण के साथ जिसे आप किसी असली सॉल्वर से जोड़ने से पहले चला सकते हैं। यह किसी कंकरेन्सी बेंचमार्क या प्रोडक्शन CAPTCHA सफलता का दावा नहीं करता।
एक ब्राउज़र एजेंट को एक प्रयास के साथ एप्लिकेशन जॉब, पेज ओनर और सॉल्वर टास्क ID को जोड़े रखना चाहिए।
createTask API असिंक्रोनस टास्क के लिए taskId लौटाती है। जब यह क्रिएशन रिस्पॉन्स स्वीकार कर लिया जाए, तब इसे सेव करें। getTaskResult API उसी आइडेंटिफ़ायर को लेकर संबद्ध परिणाम प्राप्त करती है।
आपके एप्लिकेशन को अपना खुद का वर्क-आइटम आइडेंटिफ़ायर और ब्राउज़र ओनर का एक रेफ़रेंस भी चाहिए। ये एप्लिकेशन फ़ील्ड हैं, अतिरिक्त CapSolver रिक्वेस्ट पैरामीटर नहीं। उदाहरण में page-a जैसा पेज लेबल उस वर्कर की पहचान करता है जो पेज का मालिक है; यह कोई पुनः प्रयोज्य ब्राउज़र हैंडल या API क्रेडेन्शियल नहीं है।
एक छोटा प्रयास संस्करण जोड़ें, जिसे नीचे epoch कहा गया है। जब भी कोई नई नेविगेशन या नया चैलेंज प्रयास किसी पुराने पेंडिंग परिणाम को अनुपयुक्त बना दे, तो इसे बढ़ाएँ। केवल URL पर्याप्त नहीं है: दो जॉब एक ही URL पर जा सकते हैं, और एक पेज अपना स्टेट बदले बिना पता बदले लोड कर सकता है।
Playwright के ब्राउज़र‑कॉन्टेक्स्ट डाक्यूमेंटेशन में आइसोलेटेड ब्राउज़र स्टेट समझाया गया है। कॉन्टेक्स्ट आइसोलेशन और टास्क कोरिलेशन अलग समस्याएँ हल करते हैं। अलग कुकीज़ अपने आप सॉल्वर परिणामों को सही वर्कर की ओर रूट नहीं करतीं।
कम्प्लीशन ऑर्डर यह बताता है कि परिणाम कब आते हैं, यह नहीं कि कौन-सा ब्राउज़र जॉब उनका मालिक है।
Python की asyncio.as_completed डाक्यूमेंटेशन यह बताती है कि awaitables को उनके पूरा होने पर कैसे प्रोसेस किया जाए। यदि आपका ऑर्केस्ट्रेशन कम्प्लीशन‑ऑर्डर कॉलबैक्स का उपयोग करता है, तो हर परिणाम को अपना एसोसिएशन खुद साथ लाना चाहिए, न कि प्रतीक्षारत पेजों की लिस्ट में किसी पोज़ीशन पर भरोसा करना चाहिए।
टास्क क्रिएशन और बाइंडिंग को एक ही लोकल हैंडऑफ़ की तरह लें: क्रिएशन रिस्पॉन्स को वैलिडेट करें, लौटाई गई ID को उसके वर्क आइटम के साथ स्टोर करें, फिर परिणाम रिट्रीवल की अनुमति दें। कॉलबैक‑आधारित इम्प्लीमेंटेशन को उन परिणामों के लिए एक समान योजना चाहिए जो उसकी लोकल बाइंडिंग विज़िबल होने से पहले ही आ जाते हैं। उस रेस को “unknown page” कहकर तुरंत नया पेड टास्क बना देना ठीक नहीं है।
Python queue इंटरफ़ेस लोकल वर्करों के बीच एक पूरा वर्क आइटम पास करने में मदद कर सकता है। क्यू मैपिंग का विकल्प नहीं है: आइडेंटिफ़ायर को परिणाम के साथ लेकर पेज ओनर तक पहुँचाएँ।
किसी परिणाम को केवल तभी डिलीवरी के लिए स्वीकार करें जब टास्क ID ज्ञात हो और रिकॉर्ड किया गया प्रयास अब भी सक्रिय पेज से संबंधित हो।
छोटी एप्लिकेशन में इस स्टेट को अपडेट करने के लिए एक ही ओनर का उपयोग करें। वितरित सेवा में ड्यूरेबल स्टोरेज और एटॉमिक क्लेम या समकक्ष कंकरेन्सी नियंत्रण का उपयोग करें। आपस में अनौपचारिक रूप से साझा किया गया Python डिक्शनरी यह गारंटी नहीं दे सकता।
नीचे दिया उदाहरण एक लोकल रूटिंग फ़िक्स्चर है, कोई आधिकारिक SDK मेथड या पूरा सॉल्वर इंटीग्रेशन नहीं। यह काल्पनिक टास्क IDs और एक fixture_marker का उपयोग करता है, जो CAPTCHA टोकन या CapSolver समाधान फ़ील्ड नहीं है। इसे Python 3 के साथ चलाएँ; इसे किसी थर्ड‑पार्टी पैकेज, API key, ब्राउज़र या नेटवर्क रिक्वेस्ट की आवश्यकता नहीं है।
def accept_result(reply, pending, current_epochs):
    task_id = reply.get('taskId')
    if not isinstance(task_id, str) or type(reply.get('errorId')) is not int:
        return 'malformed_reply', None
    job = pending.get(task_id)
    if job is None:
        return 'unknown_or_duplicate', None
    if current_epochs.get(job['page_id']) != job['epoch']:
        pending.pop(task_id)
        return 'stale_page', None
    if reply.get('errorId', 0) != 0:
        pending.pop(task_id)
        return 'solver_error', None
    if reply.get('status') != 'ready':
        return 'pending', None
    if not reply.get('solution'):
        pending.pop(task_id)
        return 'missing_solution', None
    pending.pop(task_id)
    return 'ready_for_owner', (job['page_id'], reply['solution'])

pending = {
    'fixture-task-a': {'page_id': 'page-a', 'epoch': 1},
    'fixture-task-b': {'page_id': 'page-b', 'epoch': 1},
}
epochs = {'page-a': 1, 'page-b': 1}
for task_id in ['fixture-task-b', 'fixture-task-a']:
    reply = {'taskId': task_id, 'errorId': 0, 'status': 'ready',
             'solution': {'fixture_marker': task_id}}
    state, target = accept_result(reply, pending, epochs)
    print(task_id, state, target[0] if target else None)
उदाहरण ये दो लाइनें प्रिंट करता है:
fixture-task-b ready_for_owner page-b
fixture-task-a ready_for_owner page-a
टास्क B पहले पूरा होता है और फिर भी पेज B पर ही लौटता है। यह फ़ंक्शन जानबूझकर पेज को भरे या सबमिट किए बिना परिणाम को ओनर को सौंप देता है। केवल तब फ़िक्स्चर बदलें जब आपके पास किसी टास्क‑स्पेसिफ़िक परिणाम पार्सर और समर्थित ब्राउज़र ऑपरेशन के लिए डाक्यूमेंटेड इम्प्लीमेंटेशन हो।
पोलिंग वर्कर के लिए, रिक्वेस्ट में उपयोग की गई टास्क ID को लोकल वर्क आइटम का हिस्सा बनाए रखें। यदि रिस्पॉन्स में टास्क ID शामिल है, तो जाँचें कि वह मेल खाती है; रिक्वेस्ट को रीलेबल करने के लिए अविश्वसनीय या मिसमैच्ड रिस्पॉन्स ID का उपयोग न करें। फ़िक्स्चर मान लेता है कि accept_result कॉल होने से पहले यह एसोसिएशन पहले ही वैलिडेट किया जा चुका है।
अपना CapSolver बोनस कोड रिडीम करें
अपना ऑटोमेशन बजट तुरंत बढ़ाएँ!
CapSolver अकाउंट में टॉप‑अप करते समय बोनस कोड CAP26 का उपयोग करें और हर रिचार्ज पर अतिरिक्त 5% बोनस पाएँ — बिना किसी लिमिट के।
इसे अभी अपने CapSolver Dashboard में रिडीम करें।
लेट या दोहराए गए परिणामों को किसी भी वर्तमान टैब पर लागू करने के बजाय एक स्पष्ट स्टेट पैदा करना चाहिए।
जब पेज बंद हो जाए, नेविगेट हो जाए, या रिप्लेसमेंट चैलेंज शुरू करे, तो पुराने प्रयास को stale मार्क करें। फ़िक्स्चर स्टोर किए गए epoch की current_epochs से तुलना करता है; बंद किए गए पेज को हटाना भी यह जाँच फ़ेल करा देता है। केवल इसलिए कि होस्टनेम मेल खाता है, पुराने परिणाम को नए प्रयास में ट्रांसफ़र न करें।
आपका पेज ओनर किसी डिलीवर किए गए परिणाम का उपयोग करने से ठीक पहले एक बार फिर प्रयास की जाँच करे। फ़िक्स्चर की जाँच और बाद की ब्राउज़र कार्रवाई अलग ऑपरेशन हैं। पेज नेविगेशन और परिणाम एप्लिकेशन को एक ही ओनर के अधीन रखने से कोई दूसरा वर्कर उनके बीच पेज नहीं बदल सकता।
जब तक सॉल्वर नॉन‑टर्मिनल स्टेट रिपोर्ट करता है, मौजूदा टास्क बाइंडिंग बनाए रखें। मौजूदा टास्क डाक्यूमेंटेशन की पोलिंग गाइडेंस और अपनी जॉब डेडलाइन का पालन करें। हर बार परिणाम ready न होने पर रिप्लेसमेंट टास्क बनाना पेंडिंग वर्क को गुणा कर सकता है, बिना मूल रिक्वेस्ट हल किए।
संबंधित वर्क आइटम पर फ़ेल्यर रिकॉर्ड करें। फ़िक्स्चर सॉल्वर एरर, मालफ़ॉर्म्ड एनवेलप और missing solutions को अलग‑अलग रखता है। प्रोडक्शन पार्सर को चुने गए टास्क टाइप के लिए एक्सैक्ट solution फ़ील्ड्स को अतिरिक्त रूप से वैलिडेट करना होगा; केवल नॉन‑एम्प्टी डिक्शनरी से उपयोगी टोकन साबित नहीं होता।
डिलीवरी एक बार क्लेम करें। लोकल फ़िक्स्चर ready बाइंडिंग को हटा देता है, इसलिए रिपीट को unknown या duplicate के रूप में वर्गीकृत किया जाता है। प्रोडक्शन वर्करों को यदि डिलीवरी या ब्राउज़र एक्जिक्यूशन फ़ेल हो सकते हों, तो ड्यूरेबल टर्मिनल रिकॉर्ड और एक acknowledgements नीति की आवश्यकता होती है। इस इन‑मेमोरी उदाहरण को exactly‑once डिस्ट्रीब्यूटेड क्यू की तरह उपयोग न करें।
थ्रूपुट के बारे में कोई निष्कर्ष निकालने से पहले सही ओनरशिप और रिजेक्शन व्यवहार वेरिफ़ाई करें।
लोकल जाँचों ने रिवर्स कम्प्लीशन ऑर्डर, एक ongoing टास्क, unknown ID, बदला हुआ प्रयास, बंद पेज, एरर रिस्पॉन्स, खाली solution, मालफ़ॉर्म्ड एनवेलप और डुप्लिकेट डिलीवरी परखीं। ये जाँचें प्रकाशित फ़ंक्शन के लिए पास हुईं। इन्होंने असली CAPTCHA solving, ब्राउज़र fill‑back या एप्लिकेशन acceptance की जाँच नहीं की।
अधिकृत end‑to‑end टेस्ट के लिए, असली टास्क क्रिएशन और रिट्रीवल कॉल्स जोड़ें, संवेदनशील परिणामों को ब्राउज़र वर्कर में ही रखें, और डाक्यूमेंटेड solve स्टेप के बाद इच्छित एप्लिकेशन परिणाम कन्फर्म करें। यदि पेज अब भी चैलेंज दिखा रहा हो या अपेक्षित रिकॉर्ड अनुपस्थित हो, तो उस परिणाम को सॉल्वर readiness से अलग रिकॉर्ड करें।
लॉग्स को उपयोगी रखें, लेकिन रॉ टोकन, कुकीज़ या API keys की कॉपी किए बिना। वर्क‑आइटम IDs, टास्क IDs, स्टेज नाम और सैनिटाइज़्ड एरर जानकारी स्टोर करें। मौजूदा API timeout गाइड वेटिंग व्यवहार को संबोधित करता है; इस लेख की चिंता यह है कि अन्तिम परिणाम किस जॉब को मिलता है। concurrencies glossary समानांतर कार्य के बैकग्राउंड देता है, किसी परफ़ॉर्मेंस वादे के बिना।
हर समर्थित solve को उसी वर्क आइटम से जोड़े रखें जिसने उसे रिक्वेस्ट किया था। CapSolver सॉल्वर परिणाम सप्लाई करता है; आपका एप्लिकेशन उस परिणाम को रूट करता है, जाँचता है कि प्रयास अभी भी करंट है, और ब्राउज़र टास्क को वेरिफ़ाई करता है। यह अलगाव समानांतर एजेंटों को स्वतंत्र रहने देता है, भले ही परिणाम out‑of‑order आएँ।
प्रश्न: क्या दो ब्राउज़र एजेंट एक ही pending टास्क वेरिएबल शेयर कर सकते हैं?
यदि बाद का कार्य पहले वाले एसोसिएशन को ओवरराइट कर देता है, तो एक सिंगल mutable वेरिएबल असुरक्षित है। हर सक्रिय सॉल्वर टास्क और उसके पेज ओनर के लिए अलग बाइंडिंग स्टोर करें।
प्रश्न: क्या पेज URL गंतव्य की पहचान के लिए पर्याप्त है?
नहीं। अलग टैब एक ही URL शेयर कर सकते हैं, और एक पेज उसी एड्रेस पर स्टेट बदल सकता है। वर्क‑आइटम आइडेंटिटी और करंट प्रयास संस्करण रखें।
प्रश्न: क्या मैं पेज नेविगेट होने के बाद ready परिणाम को दोबारा उपयोग कर सकता हूँ?
मान कर न चलें कि वह अभी भी लागू है। पुराने प्रयास को stale मानें और किसी भी आगे की अनुमति प्राप्त solve से पहले नए पेज का निरीक्षण करें।
प्रश्न: क्या यह उदाहरण असली CAPTCHA solve या सबमिट करता है?
नहीं। यह काल्पनिक आइडेंटिफ़ायर्स और जड़ परिणामों के साथ लोकल रूटिंग टेस्ट करता है। पेड solving और एप्लिकेशन acceptance के लिए अलग इंटीग्रेशन टेस्ट की आवश्यकता है।
प्रश्न: क्या डिक्शनरी वाला उदाहरण डिस्ट्रीब्यूटेड वर्करों के बीच सुरक्षित है?
नहीं। यह एक ही प्रोसेस में एक सिंगल ओनर मान कर चलता है। डिस्ट्रीब्यूटेड execution के लिए ड्यूरेबल टास्क स्टेट, एटॉमिक डिलीवरी क्लेम और फ़ेल्यर‑हैंडलिंग नीति की आवश्यकता होती है।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
CAPTCHA टूल के परिणामों को सही तरह से पढ़ें: किसी AI एजेंट को आगे बढ़ने देने से पहले ट्रांसपोर्ट एरर, पेंडिंग टास्क, सॉल्वर आउटपुट और ब्राउज़र सक्सेस के बीच अंतर करें।
अपने AI एजेंट के लिए CAPTCHA API या MCP चुनने से पहले, कार्य नियंत्रण, टूल खोज, परिणाम प्रबंधन, और ब्राउज़र की ज़िम्मेदारियों की तुलना करके निर्णय लें।