🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Nikolai Smirnov
Software Development Lead
已发表 Nov 20, 2026
已更新 Nov 20, 2026 · 最小阅读量
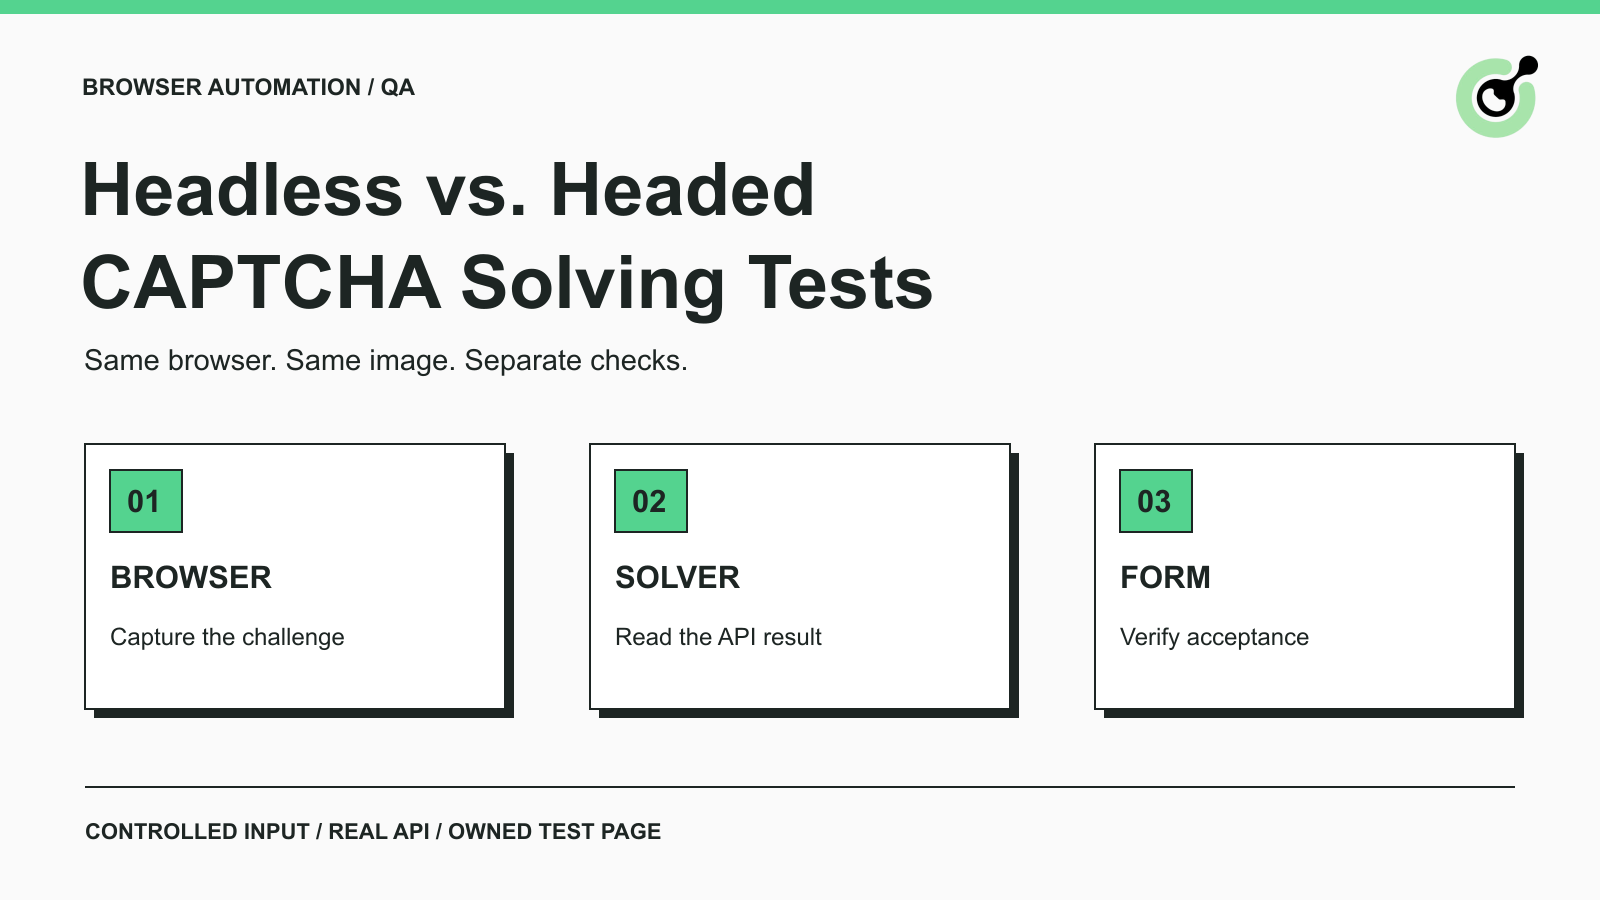
同一套 CAPTCHA 流程,手动盯着浏览器看时可以通过,无人值守时却会失败。因为肉眼可见的区别很明显,浏览器模式常被直接当成嫌疑人,但同时也可能变动了:可执行文件、配置文件、视口、时序或提交的图片。一边切换模式、一边不控制这些变量,只能得到非常薄弱的诊断结论。
本文说明了如何围绕一次真实求解操作来比较两种模式。示例测试使用 CapSolver 识别自有本地页面上的一张图片,然后将返回答案提交给该页面的服务器。目的在于展示一个有用的测试设计和相应的验证检查,而不是针对第三方网站的测试,也不是宣称某种模式能绕过浏览器检测。
无头浏览器 在没有可见窗口的情况下运行;有头模式则会显示浏览器界面。
这个区别只描述执行模式,它并不决定页面上出现的是图片挑战、基于 token 的小组件,还是其他验证步骤。选择求解任务前,需要先识别出实际的挑战类型。
Chrome 的无头模式实现文档说明,现代 Chrome 在无头模式与有头模式之间共享代码。早期“无头 Chrome 必然是完全独立实现”的说法,需要放在具体版本下重新核实。
自动化工具仍然可能选择不同的可执行文件。Playwright 浏览器指南就区分了其常规 Chromium 渠道和单独的 headless shell。不要假设一个布尔选项就是两次运行之间唯一的差异,务必记录测试实际启动了什么。
有头模式适合观察失败现场;一旦工作流有了可靠断言,无头模式适合无人值守地执行。
| 测试需求 | 有头模式 | 无头模式 |
|---|---|---|
| 观察挑战出现的过程 | 可见窗口,序列更易人工检查 | 在关键阶段截屏并记录日志 |
| 重复自有验收测试 | 开发和诊断阶段很有用 | 适合无人值守的重复检查 |
| 确认求解结果被正确应用 | 观看交互并加断言 | 加同样的断言;没有窗口不是豁免理由 |
| 比较两种模式下的失败 | 保持设置和浏览器构建一致 | 保持设置和浏览器构建一致 |
不要因为某次偶然通过的是有头运行,就武断地选择有头模式。先要确认挑战类型、会话条件和提交逻辑是否相同。同理,一次通过的无头测试也不能证明所有线上页面都会表现一致。
有用的对比应当只改变浏览器模式,同时保持与工作流有关的输入不变。
记录自动化工具版本、浏览器版本、选用渠道、视口、语言区域以及每次运行是否使用全新上下文。页面导航和断言逻辑保持一致。避免只在一种模式下加调试延时,因为这同样会改变被测试的“时间行为”。
本次对比使用了 Playwright 1.60.0 和 Chrome for Testing 148.0.7778.96。两种模式都显式选择了 Chromium 渠道,视口为 1280 × 720,语言为 en-US。唯一改变的启动设置是文档化的 headless 选项。Playwright 的浏览器启动参考定义了该选项和渠道选择。
这些是此次运行的事实配置,而非对所有部署环境的“推荐版本”。重复比较时,请使用受支持的环境,并记录其精确版本。
自有夹具展示了一张数字图片,并在本地服务器上验证提交的答案。一个 cookie 将页面访问和服务端校验关联起来。每次提交都会消耗掉这道挑战,因此每次尝试前测试都会加载一个新页面。
固定图片让你可以判断两种浏览器模式是否给求解服务提供了相同输入。它刻意设计得很简单,不应被误认为是真实 CAPTCHA 实现或具有代表性的挑战分布。
你自己的测试,应使用团队可控的预发表单或夹具。将期望答案保存在测试服务器或测试数据中,而不是存在浏览器自动化的识别路径里。运行程序应该从求解服务获取答案,而不是从“期望值变量”里抄答案。
求解服务的凭据应保存在发起 API 请求的进程中。浏览器只需要挑战页面,不需要你的付费 API Key。为诊断目的记录经过脱敏的请求元数据和结果,避免日志中出现凭据,也不要把无关页面数据复制进求解任务。
兑换你的 CapSolver 奖励码
立即提升你的自动化预算!
充值 CapSolver 账号时使用奖励码 CAP26,每次充值可额外获得 5% 奖励——次数不限。
前往你的 CapSolver 控制台 立即兑换。
对比应能指出失败发生在哪个阶段,而不是只记录一个笼统的“成功/失败”。
导航到自有页面,等待挑战图片加载完成后,捕获对应的图片元素。在将图片发给服务前,检查其尺寸和内容。
保存提交给服务的 PNG 原始字节的哈希值。如果两种模式下的哈希不同,就需要比对图片:可能有一方被裁剪、缩放不同,或在加载完成前就被捕获。如果求解输出不同,而服务实际收到的是两张不同的图片,就不能简单归因于“浏览器模式”。
在本次测试中,所有四次最终运行得到的图片元素捕获在字节级完全一致。这只消除了本夹具下的一种歧义来源,并不能证明“所有网页”在渲染上都相同。
测试将每张图片以 Base64 格式通过文档化的 ImageToTextTask API 发送给服务。该任务会直接返回识别结果;运行程序检查了 API 错误字段,并在继续之前要求返回的文本结果非空。
在模式之间保持任务类型和可选设置不变。同时要区分网络层失败、服务端错误和异常的响应结构。仅凭一次 2xx HTTP 响应,不足以证明存在可用答案。
这一阶段是一次真实的远程 API 调用。本地页面及其挑战由受控测试数据构成;求解服务的响应没有被模拟。正是这种区分,使测试能够验证浏览器截图、服务请求和表单处理之间的完整链路。
使用求解服务返回的文本,填入当前挑战对应的表单中。然后检查服务器的校验响应或其他明确的应用结果。按钮点下去没抛异常,并不能算作“通过”。
自有服务器在接受时返回一个标记值,测试要求页面展示 Accepted。每次运行还会先提交一份刻意错误的答案,并要求显示 Rejected。因为夹具会消耗掉每次提交的挑战,所以在真正的求解请求前,必须重新加载一个新挑战。
这种“反向检查”有助于证明正向路径有实际意义。如果错误答案和求解答案都被接受,那说明夹具根本无法区分一个正常的求解流程和完全忽略 CAPTCHA 字段的表单。
在同一套控制条件下,两种浏览器模式都成功走通了最终的图片工作流,且捕获图片一致,并通过了正向和反向断言。
最终执行顺序为:无头、有头、有头、无头。每次运行都启动了全新的浏览器上下文。两次无头和两次有头都返回了可用文本,并达到了服务器的“已接受”状态。四次错误答案检查全部被拒绝。
每次运行捕获的 PNG 的 SHA-256 哈希值完全相同。因此可以支持一个范围很窄的结论:在本次使用的浏览器构建版本、固定图片、任务请求以及自有表单中,实现的流程在两种模式下都能正常工作。
测试准备阶段还暴露出一个图片层面的局限。早期使用 Pillow 默认字体渲染的夹具,在“精确匹配答案”的条件下没有通过。最终对比改用显式选择的 Arial 字体。早期失败没有被算作成功案例,同时也提醒我们:在定位识别问题时应保留最初输入。
对一张重复图片做四次运行,无法估计总体识别准确率。它同样不能证明无头更快、有头挑战更少,或任一模式会改变生产网站的访问决策。这只是一次集成连通性检查,而非性能排行。
有效的诊断应从“最早能观察到的差异”入手。
在修改测试前,应保留通过和失败的两次运行记录。如果你同时修改了视口、加了延时、换了浏览器渠道又刷新了会话,可能会跑出一次通过的结果,但你依然不知道“到底是哪项改动起了作用”。
不要预设“只要 CAPTCHA 失败就是识别问题”。更广泛的说明参见:为什么浏览器自动化会被检测和封锁,那里涵盖了其他类别的信号。本文的对比刻意缩小范围,只关注:在受控条件下,浏览器 → 求解服务 → 表单 这一链路是否可以正常运作。
同样的分阶段思路可以帮助调试基于小组件的工作流,但图片测试结果不能简单迁移到不同的 CAPTCHA 家族上。
对 reCAPTCHA 或 Turnstile,应根据当前任务文档明确所需参数及期望结果。应用仍需对其预期操作做校验。一次图片识别成功不能证明小组件 token 流没问题,更不能靠改动浏览器启动选项来“补上”缺失的任务上下文。
在 CI 中,应使用记录在案的包版本和浏览器版本跑同样的断言。有头运行还需要图形会话;如果 Linux Runner 使用虚拟显示,请将该环境记录为另一项测试条件。本次对比并未包含虚拟显示环境。
浏览器扩展是另一类独立条件。本次测试仅使用了 Python 发起 API 请求,未加载任何扩展。对于扩展,必须在实际使用的浏览器构建上验证其加载与行为,而不是从“只调用 API 的测试结果”中推演扩展一定没问题。
使用有头模式观察工作流,用无头模式在有明确检查点的前提下重复执行。对比时保持输入一致,并在得出结论前验证应用响应。CapSolver 能为文档化的挑战任务提供求解结果;测试则应清楚展示这个结果是如何进入工作流、以及如何确认被正确接受的。
问:无头模式下可以解 CAPTCHA 吗?
可以。本文的受控图片工作流就基于真实 API 请求,在无头模式下完整跑通。该结果只适用于本次测试的夹具和环境,不能保证其他挑战类型或生产网站会有相同表现。
问:有头模式会比无头模式更准确吗?
本文对比并未建立任何准确率差异的结论。在最终运行中,两种模式提交的图片字节完全一致。要做更广泛的准确率比较,需要有代表性的挑战集合、更大的样本量和一致的验收标准。
问:为什么 CAPTCHA 在有头模式通过,在无头模式失败?
原因可能是浏览器构建、输入捕获、时序、会话状态或应用行为发生了变化。应从最早出现差异的证据入手,而不是直接把浏览器模式当作“已证实的根因”。在测试某一改动时,保持工作流其他部分不变。
问:API 返回成功就说明整个 CAPTCHA 流程通过了吗?
不一定。服务必须返回可用结果,应用也必须接受后续操作。本文测试同时检查了返回文本和自有服务器的“接受”响应,并通过错误答案检查验证了“拒绝”路径。
问:是否测试过 reCAPTCHA、Turnstile、浏览器扩展或虚拟显示?
没有。实际执行的对比使用的是一张固定数字图片、ImageToTextTask API 和本地表单,在 macOS 上运行的 Chromium 渠道浏览器(无头和有头)。这些其他环境都需要各自独立的测试。
Nikolai Smirnov
Software Development Lead
Building dependable software for complex automation.
关于作者