

🎉MỚICapSolver cho AI agent-Tích hợp MCP, công cụ agent và SDK
Anh Tuan
Data Science Expert
Đã xuất bản Nov 13, 2026
Đã cập nhật Nov 13, 2026 · đọc tối thiểu
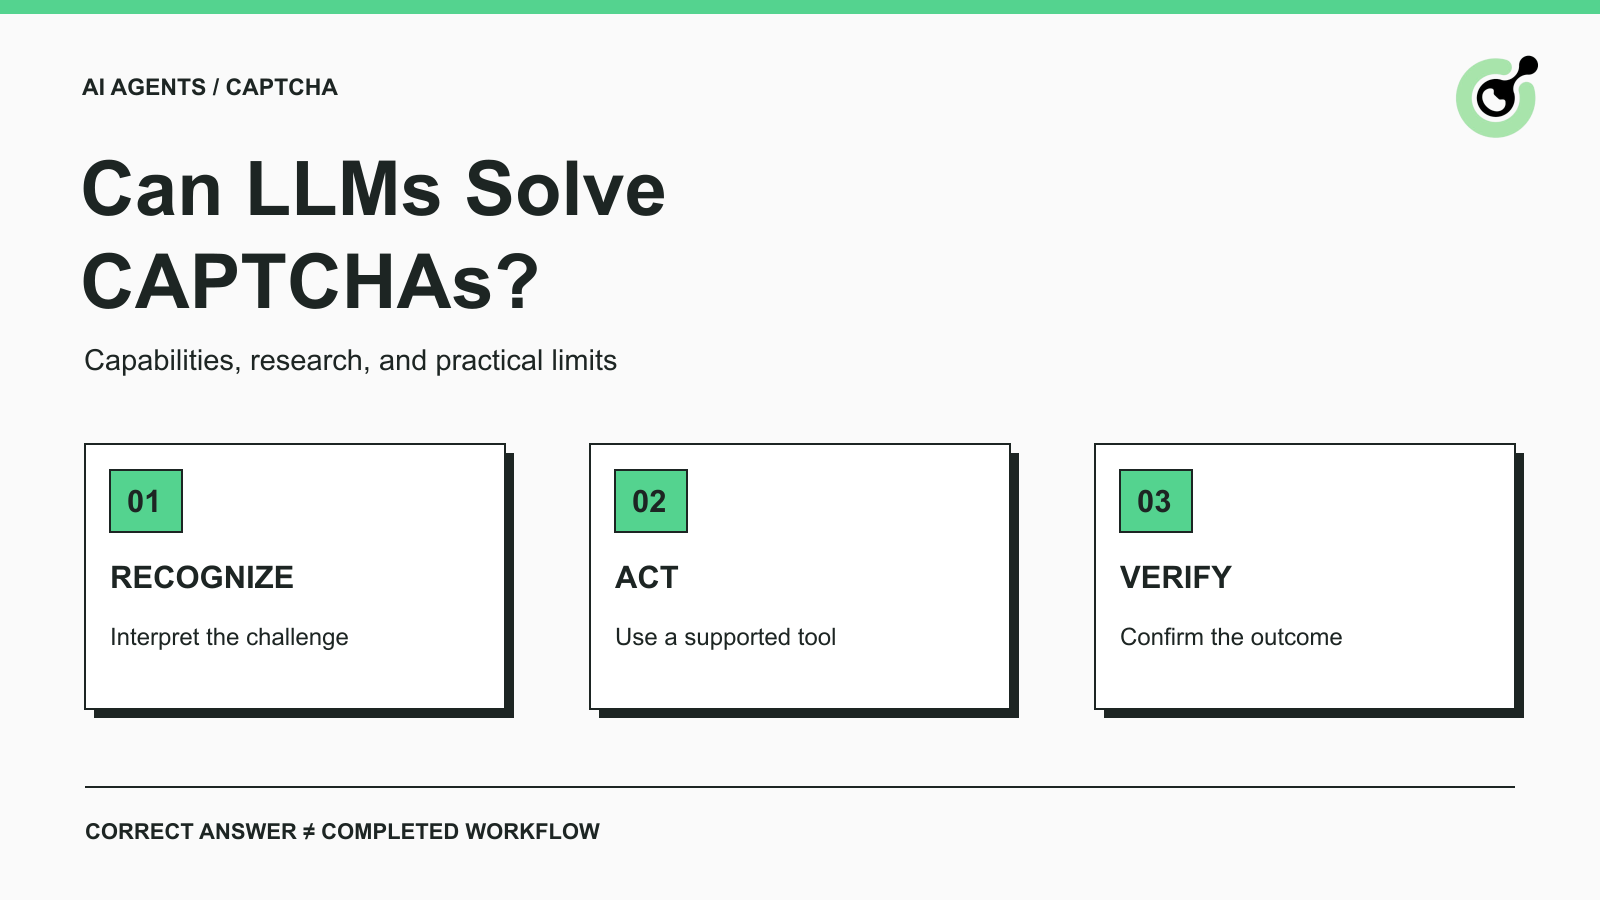
Ảnh chụp màn hình cho thấy một đối tượng được nhận diện đúng là bằng chứng hữu ích về năng lực thị giác của mô hình. Nó để lại một câu hỏi khác chưa được trả lời: ứng dụng có chấp nhận lần xác minh và hoàn tất thao tác được yêu cầu không? Sự khác biệt đó rất quan trọng khi đánh giá một trình giải CAPTCHA dùng LLM cho agent trình duyệt, QA hoặc thu thập dữ liệu được phép.
Hướng dẫn này giải thích thuật ngữ có nghĩa gì, nghiên cứu cho thấy điều gì và những kiểm tra nào nên có trong một đánh giá. Nó cũng chỉ ra dịch vụ như CapSolver phù hợp ở đâu. Trọng tâm là năng lực và lựa chọn sản phẩm, chứ không phải prompt để tấn công một website cụ thể hoặc tuyên bố rằng mọi agent AI đều có thể giải mọi thử thách.
Trình giải CAPTCHA bằng LLM sử dụng một mô hình ngôn ngữ, thường có hiểu biết hình ảnh, để diễn giải một nhiệm vụ CAPTCHA hoặc hỗ trợ điều phối việc hoàn thành nó. Cụm từ này bao phủ nhiều hệ thống khác nhau, nên cần hỏi sản phẩm thực sự nhận gì và trả gì.
Một hệ thống có thể nhận một hình ảnh và sinh câu trả lời dạng văn bản. Hệ thống khác có thể trả về vị trí click đề xuất. Một agent trình duyệt có thể gọi một dịch vụ giải riêng, sau đó tiếp tục nhiệm vụ sau khi mã ứng dụng đáng tin cậy kiểm tra kết quả. Những hệ thống này cần các phương pháp đánh giá khác nhau.
Mục từ LLM trong glossary giải thích loại mô hình nền tảng. Việc bổ sung trình duyệt hoặc công cụ giải mang lại cho mô hình các năng lực bổ sung; nó không khiến mọi kết quả từ công cụ đều là kết quả của suy luận thị giác của riêng mô hình.
Nhận dạng hỏi xem mô hình có diễn giải đúng đầu vào thử thách không. Điều phối hỏi xem agent có chọn và sử dụng công cụ phù hợp tại đúng điểm trong quy trình làm việc hay không.
Một agent ủy thác CAPTCHA cho một API có thể hữu ích dù không tự giải hình ảnh. Ngược lại, một mô hình gán nhãn hình ảnh đúng vẫn có thể thiếu điều khiển trình duyệt, đầu vào nhiệm vụ hoặc phản hồi được chấp nhận để hoàn tất một thao tác web. Hãy đánh giá vai trò mà ứng dụng của bạn thực sự cần.
Các nghiên cứu đã công bố cho thấy hiệu suất thay đổi theo loại thử thách và thiết kế hệ thống. Chúng ủng hộ câu trả lời có điều kiện cho câu hỏi “LLM có thể giải CAPTCHA không?”
Bài báo nghiên cứu Oedipus xem xét các CAPTCHA suy luận và báo cáo khó khăn khi dùng trực tiếp năng lực của LLM. Khung đề xuất của nó bổ sung việc phân rã nhiệm vụ và một biểu diễn đặc thù miền. Vì vậy, kết quả của khung bao gồm cả hệ thống bao quanh, chứ không chỉ một mô hình hoạt động đơn lẻ.
Nghiên cứu COGNITION đánh giá các mô hình đa phương thức trên nhiều loại nhiệm vụ CAPTCHA. Kết quả phân biệt các nhiệm vụ thiên về nhận dạng, tương tác thấp với các nhiệm vụ khó hơn về định vị, suy luận không gian và đa khung. Bài báo cũng xét đến số lần thử lại, độ trễ và chi phí chứ không chỉ độ chính xác.
Những nghiên cứu này không đưa ra một tỉ lệ thành công có thể chuyển giao cho mọi dịch vụ, trình duyệt hoặc triển khai thực tế. Khi đọc một kết quả, hãy gắn tên mô hình được đánh giá, tập nhiệm vụ, số lần thử được cho phép và điểm đo lường với tuyên bố. Chỉ một tên mô hình mới hơn không phải là bằng chứng rằng kết quả đó vẫn giữ nguyên.
Mô tả benchmark hữu ích sẽ cho bạn biết liệu thành công có nghĩa là một nhãn đúng, một chuỗi tương tác được chấp nhận, một phản hồi hợp lệ từ server hay việc hoàn thành công việc ban đầu của ứng dụng.
Đối với một đội QA được ủy quyền, benchmark dạng ảnh–trả lời có thể giúp chọn thành phần nhận dạng. Một đội agent trình duyệt cần thêm bằng chứng về tương tác trang và việc ứng dụng hoàn thành. Cả hai đội đều không nên âm thầm thay thế thước đo này cho thước đo kia.
Cũng hãy kiểm tra xem các lần thử thất bại hoặc hết thời gian có vẫn nằm trong mẫu số hay không. Chỉ báo cáo các đầu ra thành công sẽ che giấu lượng công việc mà người vận hành phải điều tra.
Một câu trả lời thị giác đúng có thể là chưa đủ vì ứng dụng có thể yêu cầu phản hồi xác minh hợp lệ và các kiểm tra chấp nhận riêng. Câu đố hiển thị chỉ là phần mà ảnh chụp màn hình cho thấy.
Ví dụ, tài liệu xác minh phản hồi của Google mô tả một mã token phản hồi mà backend của ứng dụng phải xác minh. Nó ghi rõ thời hạn hiệu lực hai phút và dùng một lần. Mô tả hình ảnh do mô hình sinh ra không phải là phản hồi xác minh đó.
Tương tự, hướng dẫn xác thực Turnstile của Cloudflare yêu cầu xác thực token phía server và mô tả thời hạn sử dụng năm phút với token dùng một lần. Turnstile không nên được đánh giá như thể nó chỉ là một nhiệm vụ gán nhãn hình ảnh.
Những ví dụ này thiết lập lý do tại sao điểm đo lường đánh giá lại quan trọng. Chúng không ngụ ý rằng một trình giải đảm bảo quyền truy cập ứng dụng. Website vẫn kiểm soát logic ứng dụng và quyết định truy cập của mình.
Khi kiểm thử ứng dụng của chính bạn, hãy kiểm tra kết quả xác thực phía server và trạng thái cuối cùng của ứng dụng. Khi làm việc với quy trình của bên thứ ba được cho phép, hãy dùng kết quả quan sát được theo tài liệu mà bạn có quyền truy cập.
Nếu kết quả backend không sẵn có, hãy gắn nhãn là không biết. Một nút đã đổi, một widget bị đóng hoặc một phản hồi API được trả về có thể là tín hiệu hữu ích, nhưng không cái nào nên âm thầm trở thành “server chấp nhận” trong báo cáo.
Nhận Mã Thưởng CapSolver Của Bạn
Tăng ngân sách tự động hóa của bạn ngay lập tức!
Dùng mã thưởng CAP26 khi nạp tiền vào tài khoản CapSolver để nhận thêm 5% tiền thưởng cho mỗi lần nạp — không giới hạn.
Đổi ngay trong Bảng điều khiển CapSolver
Trình giải CAPTCHA chuyên dụng xử lý một nhiệm vụ xác minh được hỗ trợ trong một quy trình làm việc được ủy quyền lớn hơn. Agent vẫn chịu trách nhiệm cho mục tiêu ban đầu, và ứng dụng vẫn chịu trách nhiệm kiểm tra kết quả.
Tài liệu CapSolver Agent Tools mô tả sự phân chia giữa quyết định của mô hình, bộ chuyển đổi công cụ và lớp thực thi Core. Điều đó cho phép các đội có một tuyến tích hợp được ghi chép mà không cần một mô hình ngôn ngữ suy ra giao thức giải từ một ảnh chụp màn hình.
Một đánh giá thực tế nên theo trình tự này:
Đây là danh sách trách nhiệm, không phải mã tích hợp có thể chạy được. Hãy dùng ví dụ chính thức cho framework bạn chọn và xác minh nó trong môi trường của bạn trước khi triển khai.
Mô hình thường cần một giải thích về kết quả, chẳng hạn như đã hoàn tất, vẫn đang chờ hoặc dừng để xem xét. Nó không cần toàn bộ nội dung cookie trình duyệt, thông tin xác thực dịch vụ hoặc mọi phản hồi thô.
Điều này giúp việc khắc phục sự cố rõ ràng hơn. Hãy ghi riêng thử thách đã quan sát, thao tác được chọn và trạng thái cuối cùng. Nếu một lời gọi công cụ không bao giờ bắt đầu, hãy điều tra việc chọn công cụ. Nếu trình giải trả về kết quả nhưng ứng dụng từ chối, hãy điều tra giai đoạn sau đó.
Đối với câu hỏi triển khai riêng về việc chọn đầu vào ảnh chụp màn hình hay API token, xem xử lý CAPTCHA cho agent điều khiển máy tính. Quyết định đó phụ thuộc vào những gì runtime có thể quan sát và thực thi.
Hãy đánh giá trình giải CAPTCHA bằng LLM trên một tập nhiệm vụ nhỏ, được ủy quyền với điều kiện chấp nhận rõ ràng. Mục đích là kiểm thử vai trò bạn cần, chứ không phải tạo ra một bảng xếp hạng phổ quát.
Ghi lại kiểu đầu vào, hành động được cho phép, họ thử thách được hỗ trợ, ngân sách thử lại và trạng thái cuối cùng kỳ vọng trước khi so sánh hệ thống. Giữ riêng các lỗi trình duyệt thông thường khỏi lỗi thử thách. Nếu không, một trang tải chậm có thể bóp méo kết quả giải.
Báo cáo số lượng kết quả, thời gian trôi qua, số lần thử đã dùng và chi phí cho toàn bộ đơn vị được đánh giá. Nếu đơn vị là một công việc agent, hãy bao gồm cả công việc thất bại và các lời gọi mất phí lặp lại. Nếu đó là nhiệm vụ hình ảnh, hãy nói rõ như vậy.
Một báo cáo đánh giá hữu ích cũng giữ lại các trường hợp tiêu cực. Hãy bao gồm một thử thách không được hỗ trợ, một đầu vào bắt buộc bị thiếu và một kết quả đến sau khi công việc đã kết thúc. Hành vi mong muốn trong những trường hợp đó có thể là dừng rõ ràng thay vì thử lại.
Đừng diễn giải tuyên bố độ tự tin của mô hình là xác suất đo lường được của việc được chấp nhận. Hãy dùng kết quả quan sát được từ ứng dụng hoặc bộ thử nghiệm. Giữ bộ thử nghiệm giới hạn ở hệ thống và dữ liệu bạn được phép kiểm tra.
Một bài kiểm tra nhỏ có thể cho thấy tích hợp hoạt động như dự định trên các trường hợp đã kiểm tra. Nó không thể biện minh cho những tuyên bố như “tốt nhất cho mọi agent” hoặc “hoạt động trên mọi site”. Hãy giữ báo cáo kiểm thử gắn với quyết định mua sắm để đội khác có thể thấy giới hạn của nó.
Khi yêu cầu thay đổi, hãy lặp lại các trường hợp liên quan. Thay đổi mô hình, runtime trình duyệt, loại nhiệm vụ trình giải hoặc ứng dụng mục tiêu có thể làm thay đổi những gì bằng chứng trước đó của bạn thiết lập. Một tuyên bố tương thích chính xác hữu ích hơn một lời hứa không giới hạn.
Chọn mô hình nhận dạng khi yêu cầu là nhiệm vụ hiểu hình ảnh có giới hạn mà bạn có thể đánh giá trực tiếp. Chọn tích hợp trình giải đã được ghi trong tài liệu khi ứng dụng được ủy quyền cần kết quả CAPTCHA được hỗ trợ. Dùng agent khi công việc xung quanh được lợi từ việc lập kế hoạch và chọn công cụ.
CapSolver có thể cung cấp bước giải được ghi trong tài liệu. Hãy xác nhận loại nhiệm vụ được hỗ trợ hiện tại, kiểm thử toàn bộ quy trình làm việc được ủy quyền và coi việc ứng dụng chấp nhận là một kết quả riêng.
Bắt đầu với hướng dẫn khởi động CAPTCHA chính thức và chọn năng lực phù hợp với thử thách thực tế của bạn. Giữ bài kiểm thử đầu tiên đủ nhỏ để bạn có thể kiểm tra từng kết quả trước khi mở rộng việc sử dụng.
Hỏi: LLM có thể giải CAPTCHA không?
Các LLM với năng lực thị giác phù hợp có thể giải một số nhiệm vụ CAPTCHA đã được đánh giá. Kết quả phụ thuộc vào thử thách, mô hình, hệ thống bao quanh và định nghĩa “thành công”. Một câu trả lời thị giác đúng không tự động chứng minh việc xác minh website đã thành công.
Hỏi: Trình giải CAPTCHA bằng LLM có giống API CAPTCHA không?
Không. LLM là một thành phần mô hình; API CAPTCHA cung cấp một thao tác dịch vụ được ghi trong tài liệu. Một agent có thể gọi API đó mà không tự thực hiện nhận dạng hình ảnh bên dưới.
Hỏi: LLM chỉ có văn bản có thể giải CAPTCHA hình ảnh không?
LLM chỉ có văn bản không thể kiểm tra hình ảnh trực tiếp. Nó cần một thành phần có khả năng xử lý hình ảnh riêng hoặc nguồn thông tin thị giác khác, và toàn bộ hệ thống vẫn cần được đánh giá.
Hỏi: Agent có nên tiếp tục thử lại cho đến khi CAPTCHA vượt qua không?
Không. Hãy đặt ngân sách rõ ràng cho số lần thử và thời gian, sau đó dừng hoặc yêu cầu xem xét khi ngân sách cạn. Việc thử lại liên tục không nên che giấu đầu vào không được hỗ trợ hoặc việc ứng dụng từ chối.
Hỏi: Một benchmark nghiên cứu có chứng minh trình giải sẽ hoạt động trên website của tôi không?
Không. Một benchmark mô tả các nhiệm vụ và điều kiện đã được đánh giá. Hãy xác thực năng lực cần thiết trong môi trường được ủy quyền của bạn và phân biệt kết quả nhận dạng với việc ứng dụng hoàn tất.
Anh Tuan
Data Science Expert
Turning task outcomes into actionable insights.
GIỚI THIỆU TÁC GIẢ
Quyết định những loại dữ liệu CAPTCHA mà tác nhân sử dụng máy tính của bạn thực sự có thể cung cấp, và khi nào cần chuyển sang chế độ kiểm tra bằng trình duyệt hoặc yêu cầu sự hỗ trợ từ con người.
Xử lý việc hủy CAPTCHA MCP trong các tác nhân AI. Dừng các lời gọi mới, phân biệt tác vụ từ xa với các lần chờ cục bộ và ngăn kết quả đến muộn khởi động lại công việc.
