

🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Nov 20, 2026
Atualizado Nov 20, 2026 · minutos de leitura
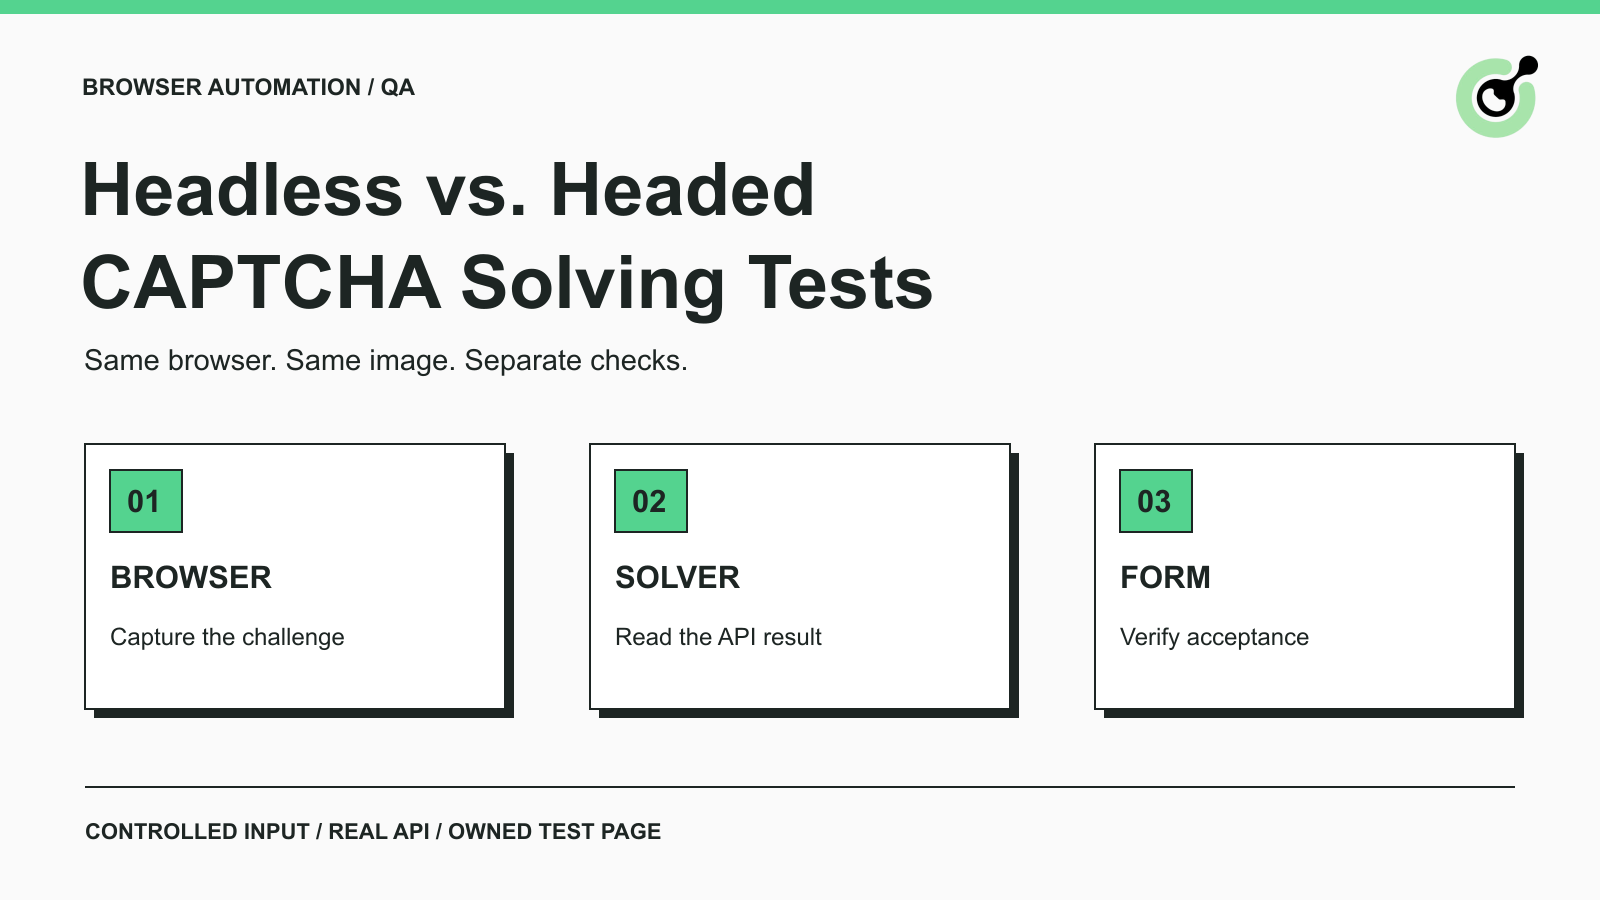
Um fluxo de CAPTCHA pode passar quando você observa o navegador e falhar quando ele roda sem supervisão. A diferença visível torna o modo do navegador um suspeito óbvio, mas várias outras coisas podem ter mudado: o executável, o perfil, o viewport, o timing ou a imagem enviada. Alternar o modo sem controlar essas variáveis produz um diagnóstico fraco.
Este guia explica como comparar os dois modos em torno de uma operação real de solver. O teste prático usou o CapSolver para reconhecer uma imagem em uma página local própria, e então enviou a resposta retornada para o servidor dessa página. O objetivo é mostrar um design de teste útil e seus critérios de aceitação. Não é um teste contra um site de terceiros nem uma afirmação de que um modo derrota detecção de navegador.
Um navegador headless roda sem uma janela visível, enquanto o modo headed exibe a interface do navegador.
Essa diferença descreve o modo de execução. Ela não determina se a página contém um desafio de imagem, um widget baseado em token ou outra etapa de verificação. Identifique o desafio real antes de escolher a operação correspondente no solver.
A documentação de implementação headless do Chrome explica que o Chrome moderno compartilha código entre seus modos headless e headful. Alegações antigas de que o Chrome headless é necessariamente uma implementação de navegador totalmente separada precisam de verificação específica por versão.
Ferramentas de automação ainda podem selecionar executáveis diferentes. O guia de navegadores do Playwright distingue seu canal Chromium regular do shell headless separado. Registre o que o teste realmente inicia, em vez de presumir que um único Boolean é a única diferença entre duas execuções.
O modo headed é útil para observar uma falha, enquanto o modo headless é útil para execução não supervisionada depois que o fluxo tem asserções significativas.
| Necessidade de teste | Modo headed | Modo headless |
|---|---|---|
| Ver o desafio aparecer | Janela visível torna a sequência mais fácil de inspecionar | Capture capturas de tela e logs nos estágios relevantes |
| Repetir um teste de aceitação próprio | Útil durante desenvolvimento e diagnóstico | Adequado para verificações repetidas não supervisionadas |
| Confirmar se o resultado do solver foi aplicado | Observe a interação e faça a asserção do resultado | Faça a mesma asserção; a ausência de janela não é uma exceção |
| Comparar uma falha entre modos | Mantenha configurações e build do navegador alinhados | Mantenha configurações e build do navegador alinhados |
Não escolha o modo headed apenas porque uma execução passou por acaso. Primeiro determine se foram usados o mesmo desafio, condições de sessão e lógica de envio. Da mesma forma, um teste headless que passa não prova que toda página em produção se comportará de forma idêntica.
Uma comparação útil altera o modo do navegador mantendo constantes as entradas relevantes do fluxo.
Registre a versão do pacote de automação, a versão do navegador, o canal selecionado, o viewport, o locale e se cada execução usa um contexto novo. Mantenha iguais a navegação de página e a lógica de asserção. Evite adicionar atrasos de depuração apenas em um modo, pois isso também alteraria o timing em teste.
Nossa comparação usou Playwright 1.60.0 e Chrome for Testing 148.0.7778.96. Ambos os modos selecionaram explicitamente o canal Chromium, com viewport de 1280 × 720 e locale en-US. A única configuração de inicialização que variou foi a opção documentada headless. A referência de inicialização de navegador do Playwright define essa opção e a seleção de canal.
Essas são as versões e configurações desta execução, não versões prescritas para toda implantação. Use um ambiente suportado e registre suas versões exatas ao repetir a comparação.
O fixture próprio exibia uma única imagem numérica e validava a resposta enviada em seu servidor local. Um cookie conectava a visita da página a essa checagem no servidor. Cada envio consumia o desafio, então o teste carregava uma nova página antes da tentativa seguinte.
A imagem fixa permite perguntar se dois modos de navegador produziram a mesma entrada para o solver. Ela é intencionalmente simples e não deve ser confundida com uma implementação de CAPTCHA de produção ou uma distribuição representativa de desafios.
Para o seu próprio teste, use um formulário de homologação ou um fixture que sua equipe controle. Mantenha a resposta esperada no servidor de teste ou nos dados de teste, fora do caminho de reconhecimento da automação de navegador. O runner deve obter a resposta do solver, não da variável de valor esperado.
Mantenha a credencial do solver no processo que faz a requisição de API. O navegador precisa da página de desafio, não da sua chave de API paga. Armazene metadados saneados da requisição e resultados para diagnóstico, sem registrar credenciais ou copiar dados de página não relacionados para dentro de uma tarefa do solver.
Resgate Seu Código de Bônus CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta CapSolver para receber 5% de bônus extra em cada recarga — sem limites.
Resgate agora no seu Painel CapSolver
A comparação deve identificar em qual estágio ocorre a falha, em vez de registrar apenas um único sucesso ou fracasso indiferenciado.
Navegue até a página própria, espere a imagem do desafio carregar e capture o elemento de imagem. Verifique as dimensões e o conteúdo da captura antes de enviá-la ao serviço.
Salve um hash dos bytes exatos do PNG enviado. Se os hashes diferirem entre modos, inspecione as imagens: uma pode estar recortada, com escala diferente ou capturada antes de carregar. Uma diferença na saída do solver não pode ser atribuída somente ao modo do navegador quando o serviço recebeu imagens diferentes.
Neste teste, as capturas do elemento de imagem coincidiram byte a byte em todas as quatro execuções finais. Essa observação remove uma fonte de ambiguidade para este fixture. Ela não estabelece renderização idêntica para toda página web.
O teste enviou cada imagem para a API ImageToTextTask documentada, usando o corpo Base64 da imagem. Essa tarefa retorna diretamente o resultado de reconhecimento; o runner verificou o campo de erro da API e exigiu um resultado de texto não vazio antes de continuar.
Mantenha o tipo de tarefa e as configurações opcionais inalteradas entre os modos. Diferencie também falha de rede de erro de serviço ou de um formato de resposta inesperado. Uma resposta HTTP bem-sucedida, por si só, não é evidência suficiente de que existe uma resposta utilizável.
Este estágio é uma operação real de API remota. A página local e seu desafio são dados de teste controlados; a resposta do solver não é simulada. Essa distinção torna o teste útil para verificar a conexão entre captura do navegador, requisição ao serviço e tratamento do formulário.
Use o texto retornado pelo solver no formulário associado ao desafio atual. Depois, inspecione a resposta de validação do servidor ou outro resultado explícito da aplicação. Um clique em botão concluído sem exceção não é suficiente.
O servidor próprio retornava um valor de aceitação, e o teste exigia que a página exibisse Accepted. Cada execução também enviou primeiro uma resposta propositalmente errada e exigiu Rejected. Um novo desafio era carregado antes da requisição real ao solver, porque o fixture consumia cada envio.
Essa checagem negativa ajuda a demonstrar que o caminho positivo é significativo. Se tanto a resposta errada quanto a resposta do solver forem aceitas, o fixture não consegue distinguir um fluxo de solver funcionando de um formulário que ignora o campo de CAPTCHA.
Ambos os modos de navegador concluíram o fluxo final controlado com imagem, com a mesma imagem capturada e asserções positivas e negativas explícitas.
A ordem final foi headless, headed, headed, headless. Cada execução iniciou um contexto novo de navegador. Duas execuções headless e duas headed retornaram texto utilizável e alcançaram o estado de aceitação do servidor. Cada uma das quatro checagens com resposta errada alcançou o estado de rejeição.
O PNG capturado teve o mesmo hash SHA-256 em todas as execuções finais. O resultado, portanto, apoia uma conclusão estreita: com este build de navegador, imagem fixa, requisição de tarefa e formulário próprio, o fluxo implementado funcionou em ambos os modos.
A preparação do teste também expôs uma limitação de imagem. Um fixture anterior, renderizado com a fonte padrão do Pillow, não passou em uma checagem de resposta exata. A comparação final usou uma fonte Arial selecionada explicitamente. A falha anterior não é incluída como sucesso e é um motivo para reter a entrada original ao investigar problemas de reconhecimento.
Quatro execuções sobre uma imagem repetida não permitem estimar acurácia geral de reconhecimento. Elas também não estabelecem que headless é mais rápido, que headed reduz desafios ou que qualquer configuração altera as decisões de acesso de um site em produção. O resultado é uma checagem de integração, não um ranking de desempenho.
Um diagnóstico útil começa pela diferença observável mais cedo entre as execuções que passam e falham.
Se a imagem do desafio difere, investigue primeiro captura e renderização. Se a imagem coincide, mas a requisição de API falha, inspecione o erro do serviço e as configurações da requisição. Se uma resposta utilizável for retornada, mas o formulário a rejeitar, inspecione o desafio atual, o timing do envio, a associação de cookie e a validação da aplicação.
Preserve ambas as execuções antes de editar o teste. Alterar viewport, adicionar atraso, trocar o canal do navegador e atualizar a sessão simultaneamente pode produzir uma execução que passa, mas não mostrará qual mudança importou.
Evite presumir que uma falha de CAPTCHA é sempre um problema de reconhecimento. A explicação mais ampla de por que automação de navegador é detectada ou bloqueada cobre outras classes de sinais. Esta comparação mantém um foco mais estreito: se a sequência navegador–solver–formulário funciona sob condições controladas.
A mesma separação de estágios ajuda com fluxos baseados em widgets, mas o resultado do teste com imagem não pode ser transferido para uma família diferente de CAPTCHA.
Para reCAPTCHA ou Turnstile, use a documentação atual da tarefa para identificar os parâmetros exigidos e o resultado esperado. A aplicação ainda deve validar sua ação pretendida. Um sucesso em reconhecimento de imagem não demonstra um fluxo de token de widget, e mudar uma opção de inicialização do navegador não fornece contexto de tarefa que esteja faltando.
Para CI, execute as mesmas asserções com as versões de pacote e navegador registradas. Uma execução headed também precisa de uma sessão gráfica funcional; se um runner Linux usar um display virtual, documente esse ambiente como outra condição de teste. Uma execução com display virtual não fez parte desta comparação.
Extensões de navegador são outra condição separada. O teste aqui usou uma requisição de API em Python e nenhuma extensão. Verifique o carregamento e o comportamento da extensão com o build exato do navegador, em vez de inferir suporte a partir do resultado de um teste apenas de API.
Use o modo headed para observar o fluxo e o modo headless para repeti-lo com checagens explícitas. Compare a mesma entrada e verifique a resposta da aplicação antes de tirar conclusões. O CapSolver pode fornecer o resultado para uma tarefa de desafio documentada; o teste deve mostrar exatamente onde esse resultado entra no fluxo e como a aceitação é confirmada.
P: Resolver CAPTCHA funciona em modo headless?
Sim. O fluxo controlado com imagem neste artigo foi concluído em modo headless usando uma requisição real de API. Esse resultado vale para o fixture e ambiente testados; ele não garante que outro tipo de desafio ou site em produção se comportará da mesma forma.
P: O modo headed é mais preciso que o headless?
Esta comparação não estabelece uma diferença de acurácia. Ambos os modos enviaram bytes de imagem idênticos no conjunto final de execuções. Uma afirmação mais ampla de acurácia exigiria desafios representativos, uma amostra maior e critérios de aceitação consistentes.
P: Por que um teste de CAPTCHA passa em headed e falha em headless?
A causa pode ser um build de navegador diferente, captura de entrada, timing, estado de sessão ou comportamento da aplicação. Compare a evidência divergente mais cedo em vez de tratar o modo do navegador como causa comprovada. Mantenha o resto do fluxo fixo enquanto testa uma mudança.
P: Uma resposta de sucesso da API significa que o fluxo de CAPTCHA passou?
Não. O serviço precisa retornar um resultado utilizável, e a aplicação precisa aceitar a ação subsequente. Este teste verificou tanto o texto retornado quanto a resposta de aceitação do servidor próprio, com uma checagem de resposta errada para verificar o comportamento de rejeição.
P: reCAPTCHA, Turnstile, extensões ou display virtual foram testados?
Não. A comparação executada usou uma imagem numérica fixa, a API ImageToTextTask e um formulário local em execuções headless e headed com canal Chromium no macOS. Esses outros ambientes precisam de seus próprios testes.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Aprenda a integrar um resolvedor de CAPTCHA no Laravel com seu cliente HTTP, proteger sua chave de API, reconhecer texto em imagens e lidar com erros da API com segurança.
Adicione um solucionador de CAPTCHA ao Cypress com uma tarefa Node, mantenha as chaves de API fora do código do navegador e verifique um formulário de imagem-CAPTCHA próprio com um exemplo de JavaScript testado.
