🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Nov 16, 2026
更新されました Nov 16, 2026 · 最小読み取り
あるサポートエージェントが製品についての質問を調査し、公式ヘルプセンターへのリンクを開く。自動化処理は CAPTCHA ページを受け取るが、その後続ワークフローは記事を期待したままである。このレスポンスがナレッジ収集に取り込まれると、アシスタントは検証手順を要約してしまったり、「ドキュメントには回答がない」と誤って報告するおそれがある。
CapSolver は、許可されたルックアップ内で提示されるサポート対象のチャレンジを処理できる。その後、サポートワークフローは本来の記事に戻り、それが顧客の利用している製品に適用できることを確認する必要がある。本ガイドは、カスタマーサポート向けリサーチのために公開ヘルプおよび製品ドキュメントを収集することに焦点を当てるものであり、顧客チケットの抽出、アカウントアクセス、顧客への自動応答送信は対象外である。
取得時点で CAPTCHA 検証ページを認識し、それをヘルプ記事として受け入れないようにする。
この問題は現実に起こっている。Zendesk の ヘルプセンター CAPTCHA ガイダンス には、ヘルプセンターへのアクセス中にユーザーやエージェントがこのようなチャレンジに遭遇する事例が記録されている。これは中断が起きうるという証拠であり、「すべてのヘルプセンターページにソルバーが必要」「CapSolver に Zendesk 公認の統合がある」といった証明ではない。
期待される記事コンテンツとチャレンジの兆候の両方を確認する。ナビゲーション、ページタイトル、検証プロンプトを含んだレスポンスは、完全な HTML ドキュメントであり得るが、求めている手順が欠けている場合がある。
起こりうる結果を切り分けること:正しい記事が読み込まれた、サポート対象の CAPTCHA がアクセスを中断した、記事が移動した、あるいは権限が必要になった。これらをすべて「役立つ回答が見つからない」にまとめてはならない。次のステップは、どの結果が発生したかによって異なる。
AI アシスタントには、検証済みのソースコンテンツか、明確な「ソース利用不可」という結果のいずれかを渡すべきである。チャレンジページからモデルに意図されたヘルプ記事を推測させても、取得処理が正しくなるわけではない。
必要な資料が得られる場合、ヘルプセンターがサポートしている API、エクスポート、または承認済みドキュメントフィードを利用する。
必要な記事コンテンツ、言語、アクセスレベルをカバーするエクスポートや API について、ヘルプセンター自身のドキュメントを確認する。訪問者として閲覧可能だからといって、すべてのエンドポイントや再利用方法がサポートされているとは限らない。
組織自身のサポートナレッジを定期的に更新するには、API やエクスポートの方が適している場合がある。一方で、正式なチャネルに存在しない外部製品ガイドやページを扱うには、承認されたブラウザルックアップが必要なこともある。ソルバーを追加する前に、その必要性を明確にする。
このワークフローには 4 つの入力が必要となる:許可されたソース、リクエストされた記事または質問、関連する製品コンテキスト、期待される言語。さらに、受け入れたソースコンテンツの格納先と、解決できなかったルックアップの経路も必要である。
ここでの収集対象は公開ドキュメントである。顧客名、チケット履歴、アカウントトークン、非公開の添付ファイルなどは、取得リクエストや CAPTCHA ペイロードに含めてはならない。
サポート担当者は、顧客との会話全文を送らずともリサーチタスクを表現できる。具体的には、製品名、(分かっていれば)関連バージョン、そして調査対象となる機能やエラーを特定すればよい。顧客固有の判断は、組織のサポートシステム側にとどめる。
公開アクセスがあるからといって、大量再利用が自動的に許可されるわけではない。ソースの収集・再利用条件に従い、利用可能な場合は適切な公式チャネルを使う。
ワークフローがサポート対象のチャレンジを検出した後、記事本文を抽出する前に CAPTCHA 処理を挿入する。
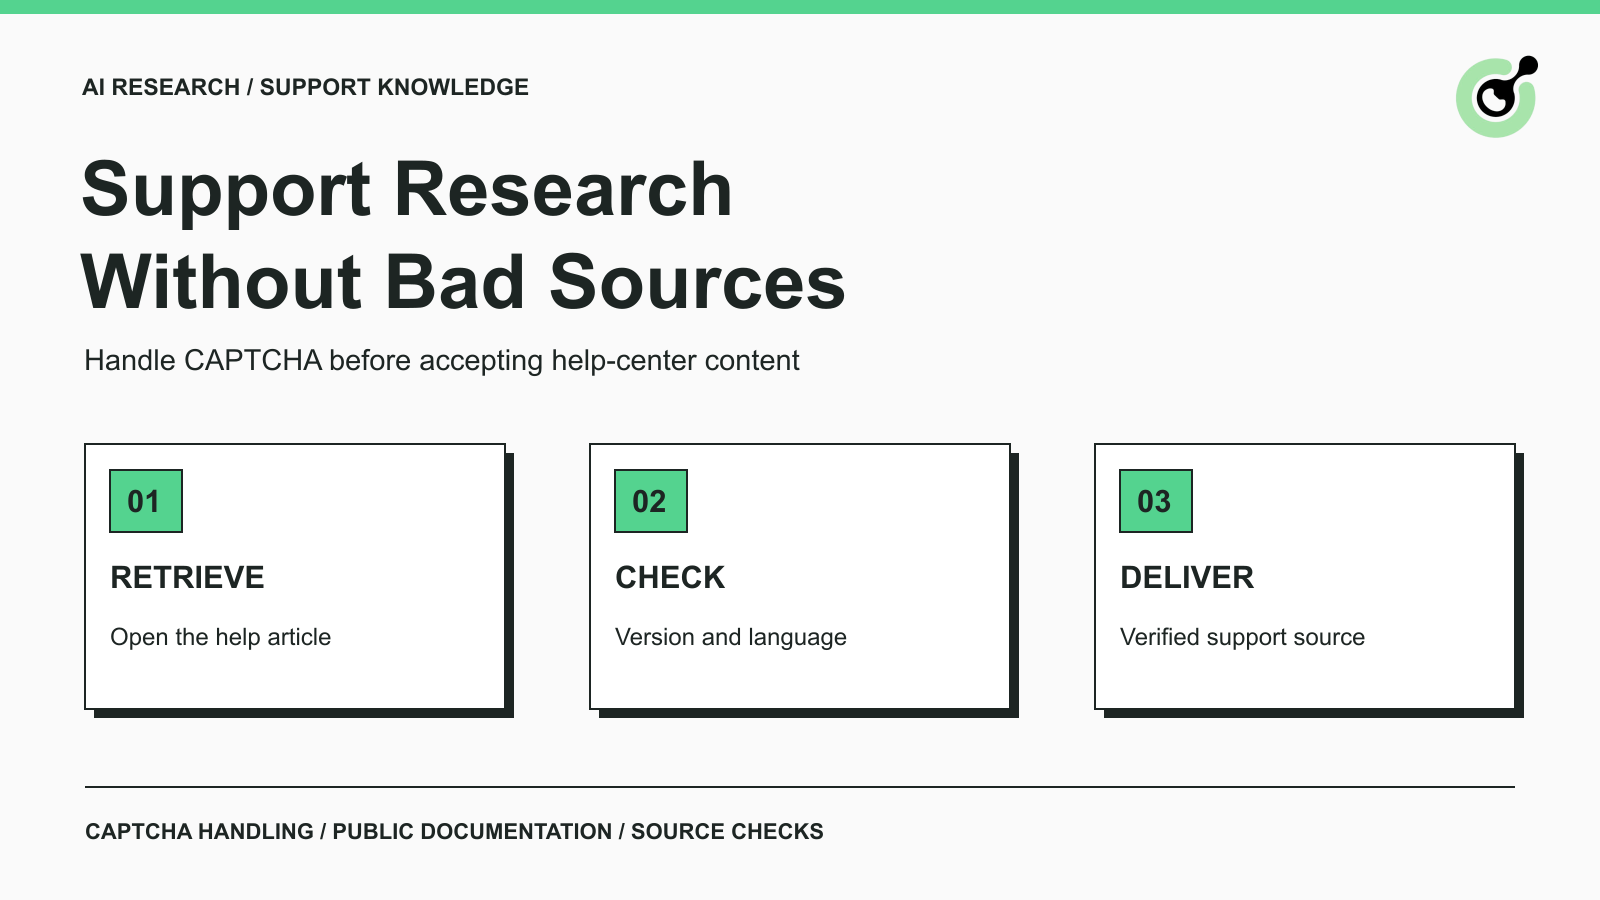
手順は次の通りである:目的のドキュメントページを開く、レスポンスを分類する、適切な場合にサポート対象 CAPTCHA を処理する、記事に戻る、コンテンツを検証する。収集処理は、この一連の流れの間ずっと元のソース URL とサポート質問を保持しておくべきである。
テキスト画像型 CAPTCHA の場合は、ドキュメントに記載された ImageToTextTask の挙動を利用する。reCAPTCHA v2 ウィジェットの場合は、対応する トークンタスク仕様 を使う。いずれのタスクもサポート記事そのものを提供するわけではない。
CapSolver エラーリファレンス を利用すると、サービス側が報告した失敗と、その後に発生したページ側の問題を区別しやすくなる。実際のエラー情報は機密情報を除いたうえで運用記録に残し、「記事セレクタが見つからない」ことをソルバーの失敗の証拠として扱わないようにする。
同じルックアップに紐づく継続処理を維持すること。もしヘルプセンターがトップページや言語選択ページにリダイレクトするのであれば、ロボットはまだ要求された手順を抽出する前に行うべき作業を残している。チャレンジを完了したからといって、正しい目的地に到達したことにはならない。
より広いソース検査パターンについては、既存の AI リサーチ CAPTCHA ガイド を参照のこと。カスタマーサポートにおける追加要件は「適用性」である。同じ回答でも、ある製品バージョンには正しく、別のバージョンには不適切でありうる。
CapSolver ボーナスコードを利用する
自動化予算を今すぐ増強しましょう!
CapSolver アカウントへのチャージ時にボーナスコード CAP26 を入力すると、すべてのチャージ額に対して 5% のボーナス が無制限で付与されます。
CapSolver ダッシュボード から今すぐ利用しましょう。
取得したページは、その手順がリサーチタスクの製品コンテキストに適合する場合にのみ受け入れること。
例えば、Example Console という製品でファイルエクスポート設定を調査しているサポートチームを考える。許可されたヘルプ記事はチャレンジの後に開けるものの、旧管理画面について説明しているとする。この場合、ルックアップは真正のドキュメントに到達しているが、現在の質問に対しては手順が誤りとなる可能性がある。
タイトルや製品ファミリー、バージョンに関する注記、言語をリクエスト内容と照らし合わせて確認する。発行元が更新日を提供している場合、その日付をソース情報として記録し、ロボットがページにアクセスした時刻をもって新しい公開日と「推定」しないこと。
言語についても明示的なチェックが必要である。自動リダイレクトにより記事のロケールが変わりうるからだ。HTML の lang 属性 は要素コンテンツの言語を表すため、有用な証拠となりうるが、ページ全体の値だけを根拠に「記事全文が要求言語と一致している」と決めつけてはならない。記事本文そのものを確認すること。
翻訳版は、明確に識別されている限り有用になりうる。しかし、それを発行元のオリジナルテキストの代わりとしてソースレコードに「こっそり」保存したり、別言語版が同時に更新されたと暗示したりしてはならない。
受け入れたソースは、ヘルプ記事の実質的なコンテンツに焦点を当てる。検証プロンプト、ナビゲーションメニュー、無関係なレコメンド、ページレベルのエラーメッセージなどは除外する。
回答に影響する前提条件やバージョン制限は保持する。特定エディションでのみ利用可能な機能に関する注意書きを削除してしまうと、それ以外は正しい要約であっても誤解を招きやすくなる。
ソースに手順が含まれている場合、各ステップとその条件との関係を保つ必要がある。サポートアシスタントは、ページ内に一致するキーワードがあるというだけで操作を推奨してはならない。
新しい取得結果が内容および適用性のチェックを通過した場合のみ、保存済み記事を置き換える。
ナレッジベースでは、保存済みソースと最新の更新試行を区別する必要がある。今日のリクエストが CAPTCHA で止まったのであれば、既存のソース情報を持つ以前の検証済み記事を保持し、不成功に終わった更新は別途記録する。
ハンドオフがレビュー可能になるよう、以下の情報が揃っていれば十分なソースレコードとなる:
| 項目 | 目的 |
|---|---|
| 公式記事の URL とタイトル | 回答を裏付けるソースの特定 |
| 製品と関連バージョン | どの顧客状況に適用できるかを示す |
| 記事の言語 | 不意のロケール置き換えを防ぐ |
| 発行元が提供する更新日 | ソース自身が示す鮮度シグナルを保持する |
| 最後に検証済みの取得日時 | コンテンツがいつ確認されたかを示す |
| 直近の取得結果 | アクセス中断とコンテンツ変更を分けて記録する |
W3C の Data on the Web Best Practices では、利用者がデータを評価できるよう、来歴およびバージョン情報を推奨している。本件に当てはめると、ソース URL と更新情報は、どのドキュメントが回答を支えているかを説明してくれる。ここで挙げた項目は収集側の提案フィールドであり、CapSolver のレスポンススキーマではない。受け入れた記事は、組織の保存および再利用ポリシーに従って保管し、ソルバーの診断情報はサポートテキストとは分離しておく。
以前のソースが現在の質問には古すぎる場合、最新検証済みであるかのように提示するのではなく、レビュー経路に回す。許容できる古さの基準は製品や質問によって異なり、本ガイドは一律の有効期間を定めるものではない。
ルックアップを完了できなかった場合は、具体的なソース上の制約を返し、サポートエージェントが別の承認ソースを選んだり手動調査したりできるようにする。
例えば、「公式ガイド自体は特定できたが、検証が完了せず現在の内容を取得できなかった」という説明は、空の記事や作り物の回答よりもはるかに有用である。可能であれば、要求されたソースと最後に検証済みだったコンテンツ日付を添付する。
再試行は上限を設けること。ソルバーがリクエストエラーを報告するのであれば、そのリクエストを修正する。解決が成功しているにもかかわらず、ナビゲーションが毎回サインインページで止まるなら、アクセス要件を確認する。追加の解決処理は、欠けている権限を埋めてはくれない。
最終的なサポート回答は、組織のレビュープロセスを通過しなければならない。ドキュメントルックアップに成功したからといって、それだけで顧客アカウントの変更やセンシティブな操作を指示する権限が与えられるわけではない。
CapSolver は、許可されたドキュメントルックアップがサポート対象 CAPTCHA によって中断されたときに利用し、その後で取得された記事が実際の製品質問に答えているかを検証する。成果物は、サポートチームが使えるソース資料であり、最新ソースが依然として利用不能な場合には、その限界を明示したものとなる。
Q: すべてのカスタマーサポート向けナレッジワークフローに CAPTCHA ソルバーは必要ですか?
いいえ。必要な資料が API やエクスポートで提供される場合はそちらを利用する。ソルバーは、必要かつ許可されたブラウザステップでサポート対象 CAPTCHA に遭遇した場合にのみ追加する。
Q: CAPTCHA ページをヘルプ記事としてインデックスしてよいですか?
いいえ。それは不完全なルックアップとして却下すべきである。検証テキストは要求されている製品ドキュメントではなく、回答の根拠となるべきではない。
Q: 最新の更新取得が失敗した場合はどうすべきですか?
保持ポリシーに従って最後の検証済み記事を残し、不成功に終わった更新試行は別に記録する。ソースの古さをサポートエージェントに分かるようにする。
Q: このプロセスはプライベートなチケットや顧客アカウントデータを収集しますか?
いいえ。対象は、許可されたソースからの公開ヘルプおよび製品ドキュメントである。プライベートな顧客レコードは収集ワークフローの外にとどまる。
Q: これは Zendesk との公式な CapSolver 統合ですか?
いいえ。Zendesk のドキュメントは、実運用でヘルプセンターに CAPTCHA による中断が発生しうることを示すものである。本ガイドは、認定統合や Zendesk 顧客サイトに対するライブテストを主張するものではない。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
スケーラブルなRustウェブスクレイピングアーキテクチャを学びましょう。リクエスト、スクレイパー、非同期スクレイピング、ヘッドレスブラウザスクレイピング、プロキシローテーション、およびコンプライアンス対応のCAPTCHA処理で。
2026年のデータ・アズ・ア・サービス(DaaS)を理解する。その利点、ユースケース、およびリアルタイムの洞察と拡張性を通じて企業を変革する方法について探る。