aws wafJul 23, 2026
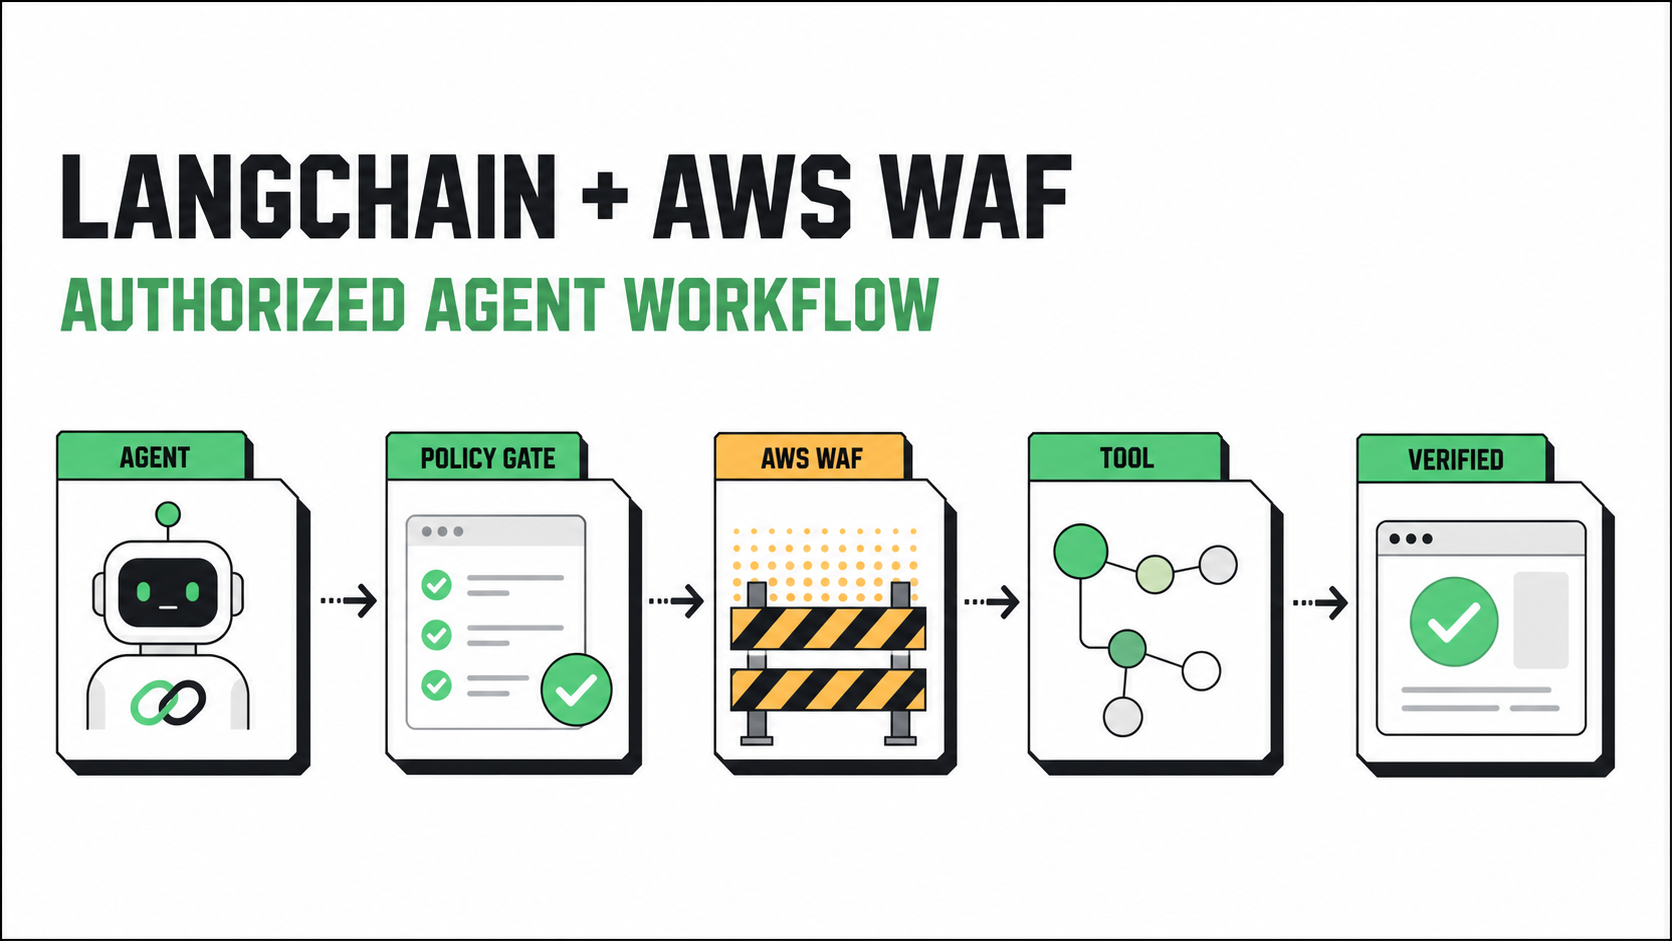
AWS WAFをLangChainで解決する方法 with CapSolver
認可されたAWS WAF LangChainワークフローをCapSolverツール、応答検出、ポリシーゲート、セッション処理、リトライ、および検証を用いて構築してください。
AIJul 23, 2026
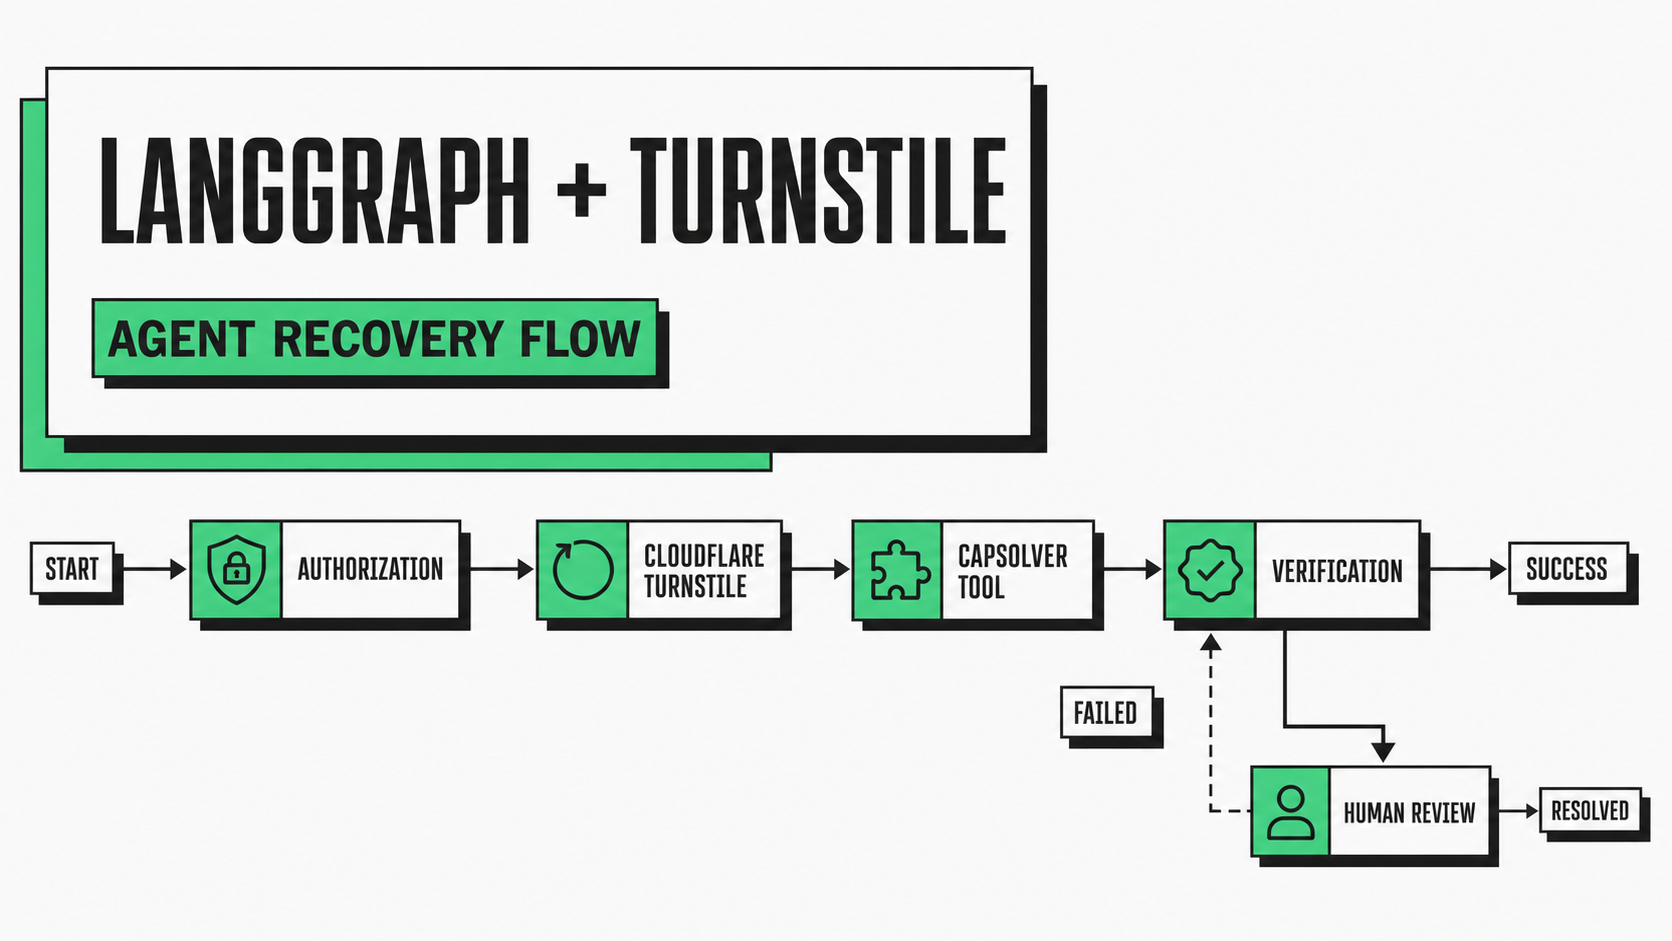
クラウドフレア トゥルネスティールを解決する方法 ラングラフ エージェントで
LangGraph Cloudflare Turnstileソルバーのワークフローを構築するには、CapSolver、Playwrightセッション処理、ポリシーゲート、リトライ、検証、およびレビューを用いてください。
Web ScrapingJul 23, 2026
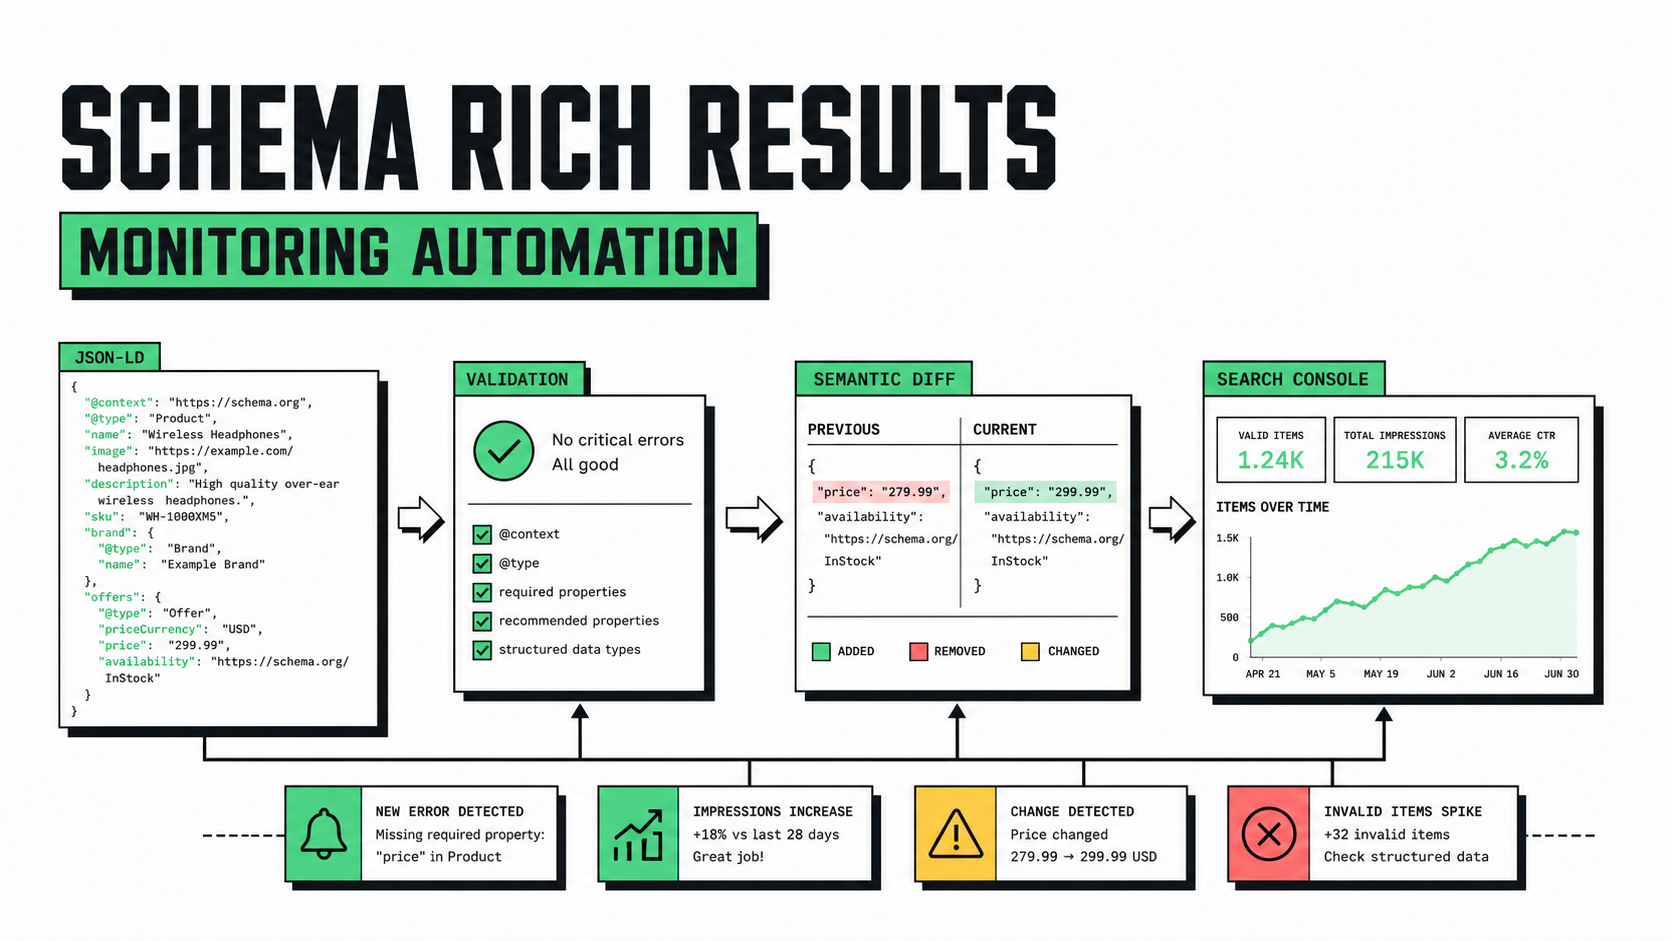
Schemaリッチ結果をモニタリングする方法: 自動化ガイド
JSON-LD抽出、意味的基準、検証、サーチコンソールデータ、および有用なアラートを使用して、スキーマリッチ結果のモニタリングを自動化する方法を学びましょう。

Web ScrapingJul 22, 2026
サイテクニカルSEOレグレッション監視: 自動化パイプライン
技術的SEOの回帰モニタリングをバージョン付きのベースライン、セマンティックな差分、検証済みアラート、およびオプションの認証済みCAPTCHA復元ステップを用いて構築してください。
CloudflareJul 22, 2026
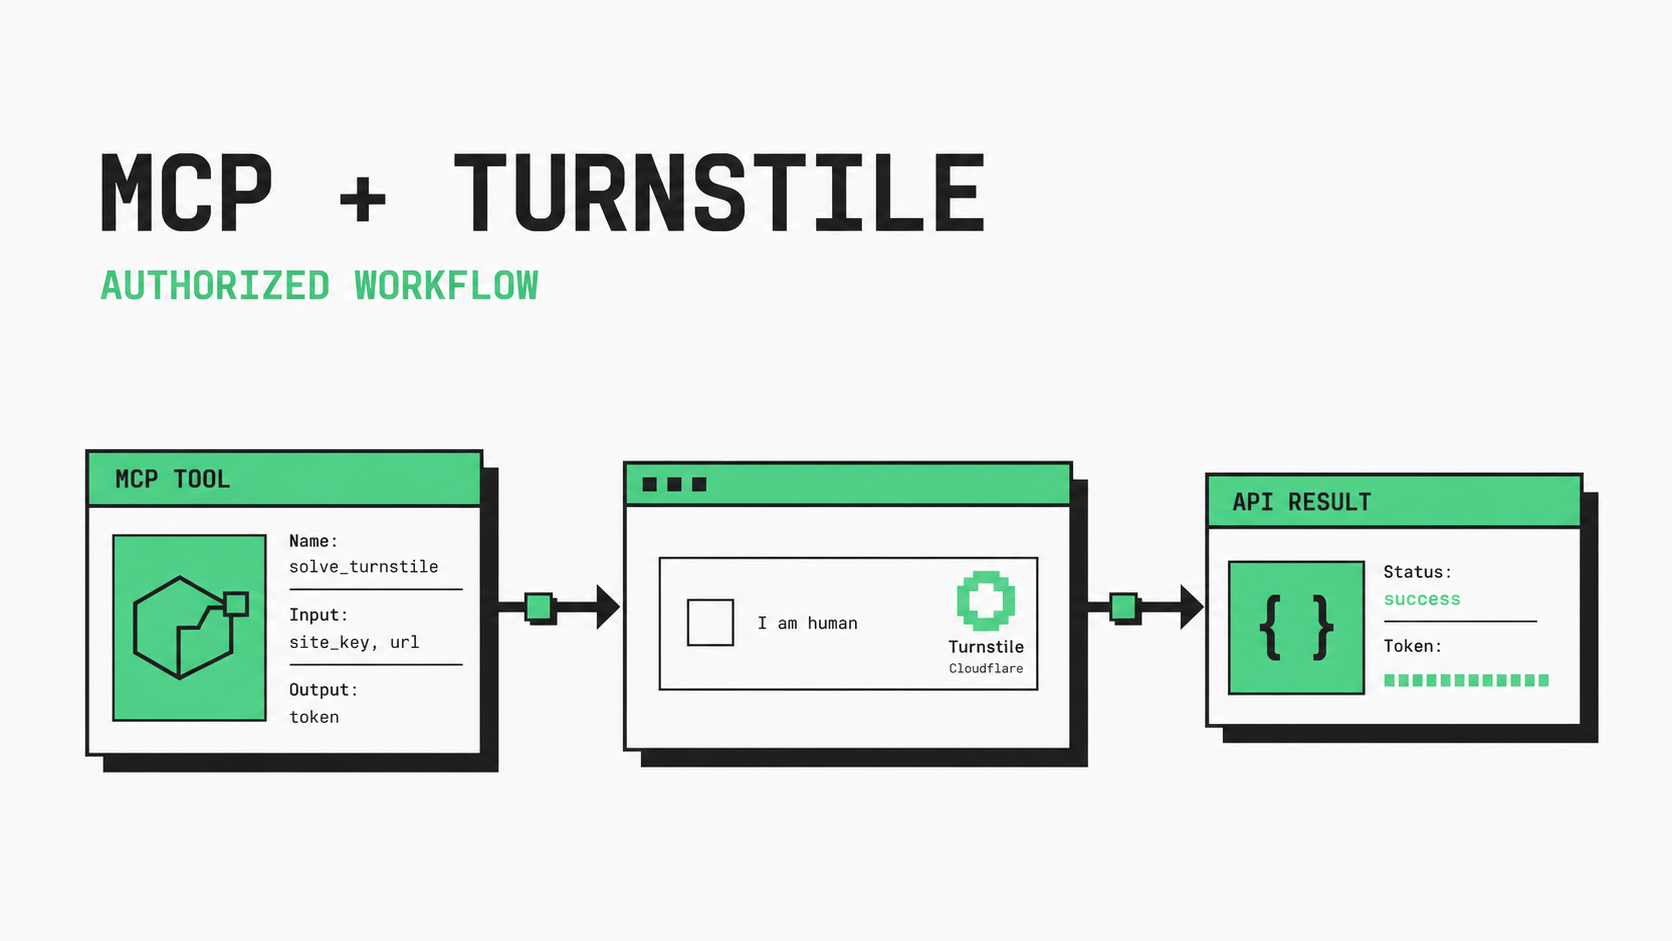
MCP CAPTCHAソルバー:Cloudflare Turnstile 統合ガイド
ポリシー制限付きのMCP Cloudflare TurnstileワークフローをCapSolver、制限付きリトライ、ロギングをマスキングしたセッションチェック、および結果の検証を含むように構築してください。

AIJul 17, 2026
LangChain CAPTCHAソルバーエージェントツール: CapSolverの復旧ワークフローを構築する reCAPTCHAとTurnstile用
LangChainを使用してCapSolverを活用したCAPTCHAソルバーエージェントツールを作成し、セキュアなツールのスキーマ、リトライ予算、およびreCAPTCHAとクラウドフレア・ターニスティールの検証を備えたものです。
CloudflareJul 16, 2026
Scrapy Cloudflare Turnstile ソルバーのガイド: セッションの引き継ぎミドルウェア with CapSolver
Scrapy Cloudflare Turnstileソルバーを、CapSolverセッションハンドオフ、ダウンローダーミドルウェア、リトライ予算、コンテンツ検証を備えて構築してください。
reCAPTCHAJul 16, 2026
reCAPTCHAソルバー作成チュートリアル: ノーコードのCapSolver HTTPシナリオを構築する
このMake reCAPTCHAソルバーのチュートリアルに従って、createTask、getTaskResult、retryブランチ、および検証を含むCapSolver HTTPシナリオを構築してください。

AIJul 16, 2026
クレードコンピュータでCAPTCHAソルバーを使用する: セーフブラウザエージェントワークフローとCapSolver
Claude ComputerでCAPTCHAソルバーワークフローを構築し、CapSolverのガードレール、視覚的証拠ID、ポリシー検証、信頼性のある検証を使用してください。
Web ScrapingJul 14, 2026
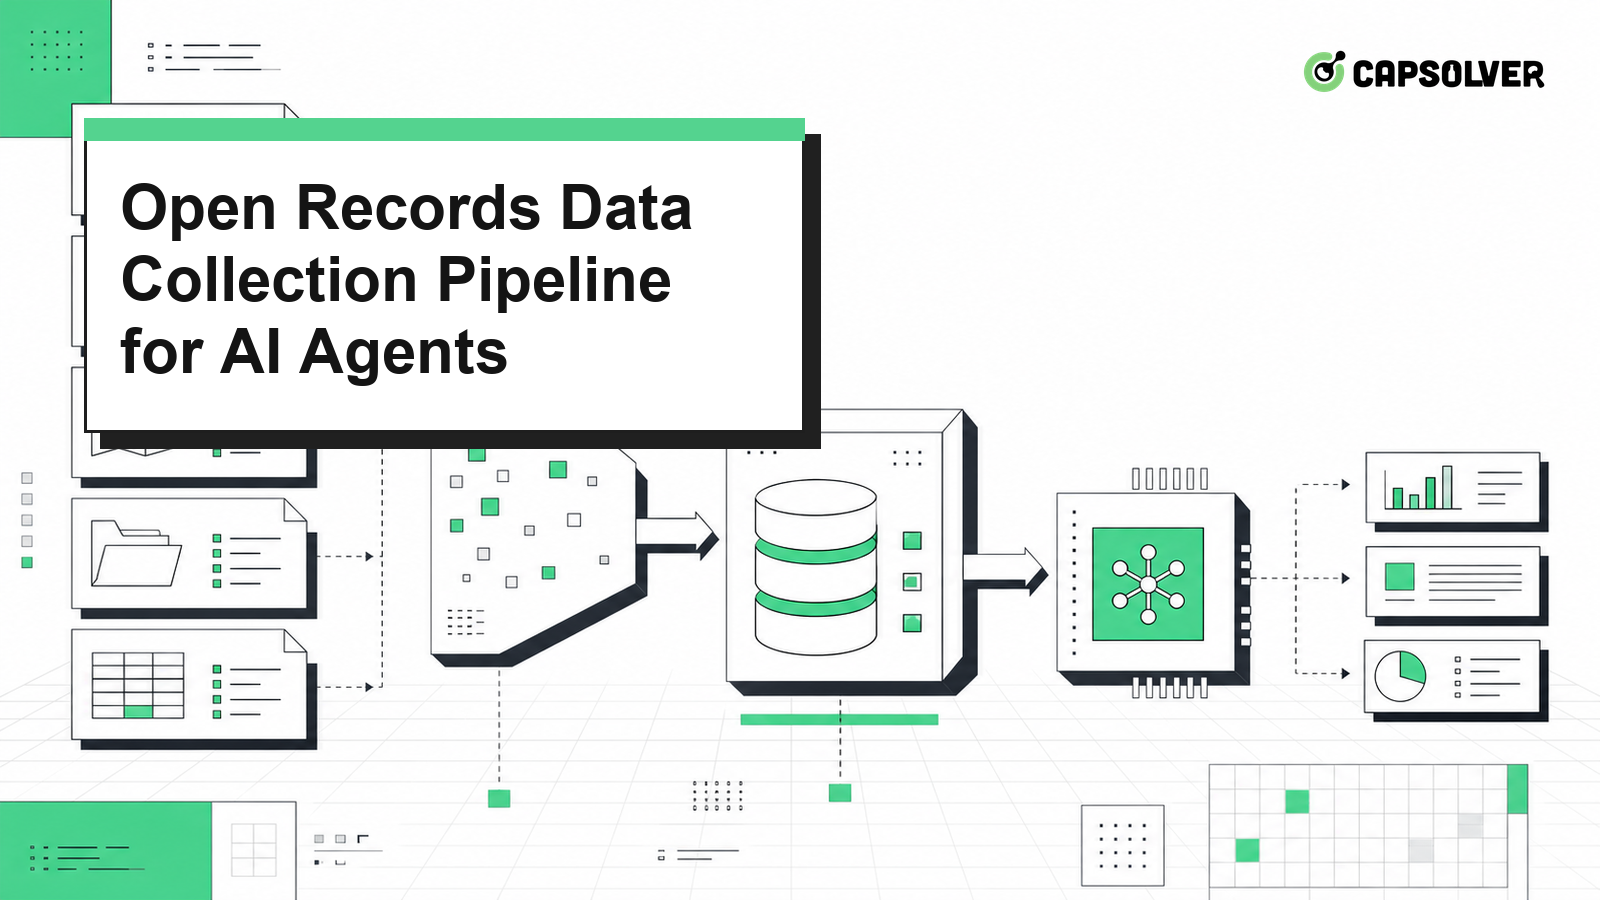
オープンレコードデータ収集パイプライン AIエージェント用
オープンレコードのデータ収集パイプラインは、公開ソースの取得とモデルの推論を分離する必要があります。最初に目に見えるCapSolverの言及は、公開ポータルワークフロー中にブラウザのチャレンジが発生する可能性があるため、CapSolverに指向しています。これらのチェックはドキュメント化されたコードで処理する必要があります。より安全なパターンは、3段階のパイプラインです。まずソースを承認し、許可された公開フィールドのみを収集し、正規化されたレコードをエージェントに供給します。これにより、モデルは記録に焦点を当てることができます。

Web ScrapingJul 13, 2026
入札通知データ抽出の自動化:エージェントコードガイド
入札通知データ抽出の自動化は、明確な状態遷移を持つモニタリングされたエージェントステップとして構築されるべきです。CapSolverは、文書化されたエージェント機能として接続されるべきです。ブラウザまたはモデルが検証チャレンジを検出すると、承認されたツールが処理し、エージェントは元のユーザー承認済みタスクが依然として有効である場合にのみ再開されます。公式のCapSolver AIドキュメンテーションでは、3つの実用的なレイヤーが説明されています。アーキテクチャ用のAIエージェント向けCapSolver、Core SDKブラウザモードのための
Web ScrapingJul 13, 2026
AIエージェント向けの公共調達データ:コードワークフロー
公開入札データのAIエージェントには、エージェントがブラウズできるという曖昧な約束ではなく、繰り返し可能な収集コードが必要です。CapSolverは、ドキュメント化されたエージェント機能として接続されるべきです。ブラウザまたはモデルが検証チャレンジを検出すると、承認されたツールが処理し、エージェントは元のユーザー承認タスクが依然として有効である場合にのみ再開します。公式のCapSolver AIドキュメントには、3つの実用的なレイヤーが記述されています:アーキテクチャ用のCapSolver for AI Agents、Core SDK browser mo