

Cómo extraer números GTIN del código fuente de una página web
Respuesta
Los números GTIN se pueden extraer de una página web inspeccionando el código fuente HTML y extrayendo identificadores de producto estructurados como etiquetas meta, esquema de marcado o atributos ocultos. Los enfoques comunes incluyen el análisis del DOM, coincidencia de expresiones regulares y extracción de JSON-LD donde los valores GTIN/EAN/UPC están integrados.
Explicación Detallada
GTIN (Número de Artículo de Comercio Global) suele estar integrado en páginas de comercio electrónico como un identificador único de producto utilizado para catalogación e indexación de búsquedas. En muchas páginas web modernas, estos datos no siempre son visibles en la interfaz de usuario (UI) renderizada, pero existen en el código fuente HTML subyacente o en bloques de datos estructurados como application/ld+json. Estos bloques suelen seguir definiciones de Producto de Schema.org, donde se incluyen campos como gtin, gtin13, gtin14 o mpn.
Además, los valores GTIN pueden aparecer en etiquetas meta o elementos DOM ocultos, especialmente en páginas de detalles de productos. Debido a que los sitios web utilizan estructuras HTML diferentes, extraer GTIN requiere lógica de extracción flexible que pueda manejar tablas, diseños basados en divs o objetos JSON integrados. En sistemas de scraping a gran escala, identificadores de entidades como GTIN también se utilizan para vincular datos de productos entre múltiples fuentes y mejorar la precisión de la deduplicación.
Soluciones / Métodos
- Análisis del código fuente HTML: Cargar la fuente completa de la página y buscar patrones GTIN dentro de etiquetas meta, atributos o elementos ocultos utilizando un analizador del DOM como BeautifulSoup o Cheerio.
- Extracción de datos estructurados: Extraer GTIN directamente de bloques JSON-LD (
application/ld+json) donde el esquema de producto suele incluir identificadores estandarizados. - Coincidencia de expresiones regulares: Aplicar expresiones regulares para detectar formatos numéricos GTIN (8-14 dígitos) dentro de HTML sin campos estructurados disponibles.
- Infraestructura de scraping automatizado: Para sitios web a gran escala o protegidos, utilizar pipelines de automatización de scraping. Al encontrarse con páginas de bloqueo o verificación, soluciones como CapSolver pueden ayudar a manejar desafíos de captchas y garantizar flujos de trabajo de extracción de datos ininterrumpidos.
Mejores Prácticas / Consejos
Siempre priorizar los datos estructurados (Schema.org) sobre el scraping de HTML crudo, ya que son más estables y menos propensos a romperse. Validar los GTIN extraídos usando reglas de verificación (especialmente para formatos UPC/EAN) para reducir falsos positivos. Al raspar a gran escala, rotar proxies y mantener higiene en las solicitudes para evitar activar sistemas de seguridad o límites de velocidad.
👉 Relacionado:
- ¿Por qué la automatización web falla constantemente en captchas?
- Redimir código de bonificación de CapSolver
Utilice el código
FAQal registrarse en CapSolver para recibir un 5% adicional en su recarga.
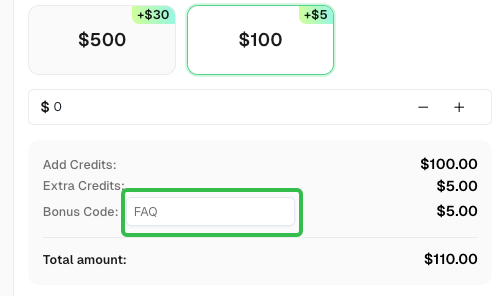
Preguntas Frecuentes de CapSolver — capsolver.com