🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Sep 21, 2026
Actualizado Sep 21, 2026 · min de lectura
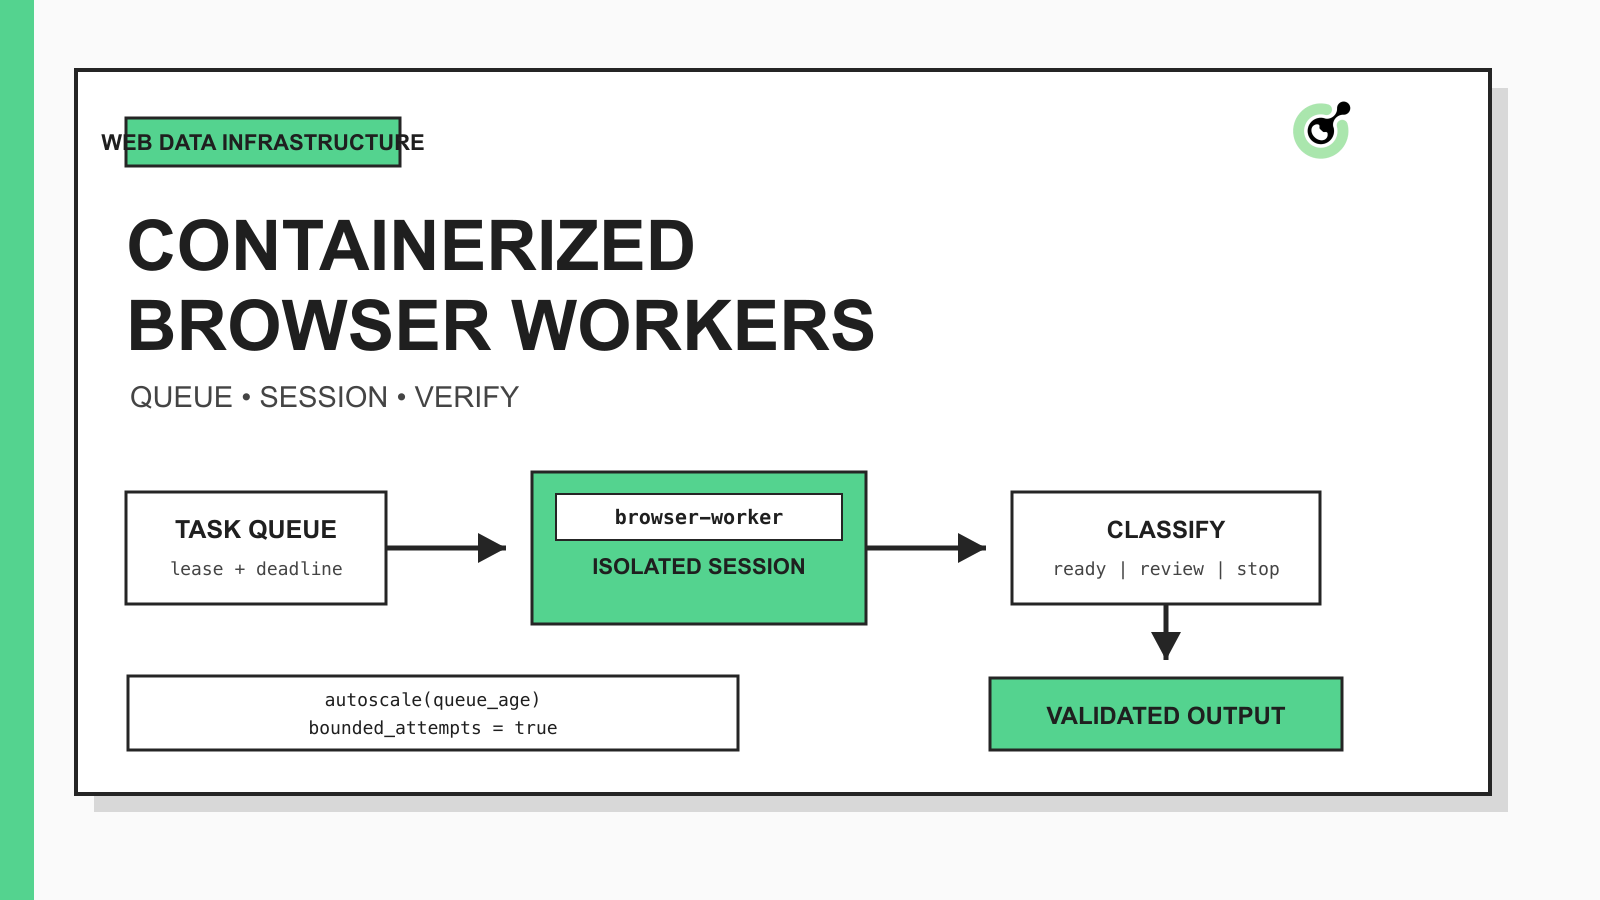
Containers as a Service (CaaS) ofrece a un equipo una forma gestionada de desplegar, ejecutar y escalar trabajadores contenerizados. Para el scraping web, esto suele significar empaquetar un navegador o un trabajador HTTP una vez, alimentarlo con tareas desde una cola y aumentar la cantidad de trabajadores según cambie la demanda. El entorno de ejecución se vuelve repetible, mientras que la plataforma se encarga de gran parte de la programación, verificación de salud y trabajo de ciclo de vida.
Esta definición tiene un límite importante: CaaS escala la ejecución, no la corrección. Cien contenedores sanos aún pueden devolver cien páginas de desafío, duplicar la misma presentación o analizar un documento de error como datos de producto. Por lo tanto, el diseño necesita un contrato de tarea estable, un modelo de estado del navegador, un camino de desafío acotado y un validador después de la extracción.
Cuando un flujo autorizado alcanza un paso de verificación compatible, CapSolver puede proporcionar la tarea de resolución documentada mientras el trabajador sigue siendo responsable de la continuidad de la sesión, los plazos, la aplicación del resultado y las comprobaciones finales del estado de negocio.
Un pipeline de scraping web con CaaS confiable separa la orquestación del acceso web. Cada etapa tiene una pequeña responsabilidad y emite un resultado tipado en lugar de una bandera de éxito ambigua.
| Etapa | Entrada | Operación | Salida | Condición de parada |
|---|---|---|---|---|
| Programador | URL autorizada y política | Crear una tarea idempotente | ID de tarea y plazo | Alcance no válido o plazo caducado |
| Cola | Registro de tarea | Asignar trabajo a un trabajador | Propietario del arrendamiento e intento | No se puede adquirir el arrendamiento |
| Trabajador de navegador | Tarea más referencia de sesión | Navegar y observar | Evidencia de página y clasificación | Presupuesto de navegación o política agotado |
| Manejador de desafío | Registro de desafío elegible | Ejecutar un flujo de tarea documentado | Resultado de resolución tipado | Tipo no compatible o límite de intentos |
| Extractor | Evidencia de página aceptada | Analizar campos requeridos | Registro estructurado | Campos requeridos faltantes |
| Validador | Registro estructurado y evidencia | Verificar esquema y regla de negocio | Registro aceptado o rechazado | Fallo de validación |
Esta división también hace que la escalabilidad automática sea más segura. El orquestador puede agregar trabajadores sin otorgar a cada trabajador permiso para cambiar el alcance, crear tareas de desafío ilimitadas o escribir directamente en sistemas posteriores.
Un trabajador de navegador contenerizado necesita un contrato de tarea duradero antes de necesitar un escalador automático. Como mínimo, almacene el ID de tarea, el objetivo autorizado, la versión de política, la hora de creación, el plazo absoluto, la referencia de sesión, la etapa actual, el recuento de intentos y la clave de idempotencia fuera del contenedor.
El contrato debe hacer tres decisiones explícitas:
Los contenedores son desechables. Las cookies, referencias de estado de almacenamiento, capturas de pantalla, registros de seguimiento y historial de tareas no lo son. Almacene esos artefactos en un sistema duradero aprobado y pase referencias a través de la cola. Playwright documenta que los contextos de navegador aíslan cookies, almacenamiento local y otro estado, lo que hace que un contexto por tarea arrendada sea un predeterminado útil. Si el flujo intencionalmente reutiliza la autenticación, proteja el estado de almacenamiento como credencial y nunca lo incluya en la imagen.
Un trabajador de navegador debe procesar una tarea arrendada a la vez y cerrar su contexto de navegador antes de confirmar el mensaje de la cola. Esto mantiene clara la propiedad de la sesión y evita que las cookies o el estado en memoria se filtren entre trabajos no relacionados.
La imagen debe contener solo el entorno de ejecución, dependencias del navegador, código del trabajador y valores predeterminados no secretos. Inyecte claves de API y credenciales de almacenamiento en tiempo de ejecución desde el gestor de secretos de la plataforma. Fije las versiones del navegador y bibliotecas, luego reconstrúyalo a través de una liberación controlada en lugar de instalar paquetes arbitrarios cuando comience una tarea.
Use tres señales de salud:
No trate una prueba de salud exitosa como prueba de que una tarea de página tuvo éxito. La salud describe el proceso del trabajador; la evidencia de la tarea describe el flujo web.
La clasificación de páginas debe ejecutarse antes de cualquier analizador o escritura posterior. El estado HTTP solo es insuficiente porque una respuesta puede devolver 200 mientras muestra un formulario de inicio de sesión, una página de desafío, una pantalla de consentimiento o un error de aplicación.
Recoja un conjunto de evidencia acotado desde el mismo contexto de navegador: URL final, estado de respuesta, título del documento, marcadores DOM seleccionados, referencia de captura de pantalla, errores de consola y presencia de campos requeridos. Rutee la tarea a uno de un pequeño conjunto de estados como listo, desafío, autenticación_requerida, error_reintentable, error_terminal o revisión_requerida.
La capa de clasificación no debe adivinar cómo resolver cada obstáculo. Solo identifica el estado observado y pasa un registro tipado al siguiente componente autorizado. Esta es la misma separación descrita en la guía de CapSolver sobre la pila de infraestructura de automatización web para agentes de IA: el entorno de ejecución del navegador posee sesiones y evidencia, mientras que el manejo de desafíos es una capa controlada.
El manejo de CAPTCHA debe ser una rama opcional, no un bucle de reintentos general. El trabajador primero comprueba que el objetivo y el desafío estén dentro de la política aprobada, que el tipo de tarea sea compatible, que la sesión del navegador aún sea válida y que quede tiempo antes del plazo absoluto.
El flujo documentado de CapSolver usa createTask para crear una tarea compatible y getTaskResult para resultados asíncronos. Revise el flujo createTask y polling de resultados oficial para los campos de solicitud actuales y reglas de tipo de tarea. Guarde el ID de tarea devuelto en un estado duradero para que un trabajador reiniciado polla la tarea conocida en lugar de crear otra.
Use un presupuesto que sobreviva a reinicios:
Si el tipo de desafío no es compatible, la sesión cambió, el plazo expiró o la aplicación rechaza el resultado, devuelva un estado terminal o de revisión. No permita que un escalador automático convierta una tarea bloqueada en muchas soluciones duplicadas.
Redime tu código de bonificación de CapSolver
¡Aumenta tu presupuesto de automatización instantáneamente!
Use el código de bonificación CAP26 al recargar su cuenta de CapSolver para obtener un 5% adicional en cada recarga — sin límites.
Redímalo ahora en su Panel de CapSolver
La extracción debe comenzar solo después de que la clasificación de página devuelva listo. Analice el esquema más pequeño requerido por la tarea comercial, luego valide tipos, campos requeridos, frescura, unicidad y consistencia de origen antes de escribir en sistemas posteriores.
Mantenga un sobre de evidencia compacto con cada registro:
{
  "task_id": "task-20260921-0042",
  "final_url": "https://example.test/catalog/42",
  "observed_at": "2026-09-21T02:30:00Z",
  "page_state": "ready",
  "session_ref": "session://browser/task-20260921-0042",
  "required_fields_present": true,
  "artifact_refs": ["screenshot://task-20260921-0042/final"]
}
El sobre es ilustrativo, pero su propósito es concreto: los sistemas posteriores pueden distinguir entre evidencia de página fresca y caché obsoleta, salida del analizador y observación del navegador, y datos aceptados de un éxito falso. La retención debe ser breve y regida por políticas, especialmente cuando las capturas de pantalla o el estado del navegador puedan contener información personal o confidencial.
La escalabilidad de CaaS debe responder al trabajo, no solo al uso del procesador. Los trabajadores de navegador a menudo esperan navegación, renderizado, colas o APIs externas, por lo que la CPU puede parecer baja mientras aumenta la latencia de las tareas.
Las entradas útiles para la escalabilidad incluyen la cantidad de tareas pendientes, la edad de la tarea más antigua lista, el tiempo de espera de arrendamiento, la duración media de las tareas y la cantidad de trabajadores en cada estado tipado. Kubernetes documenta que el HorizontalPodAutoscaler puede usar métricas personalizadas, lo que es una mejor opción para trabajos de navegador respaldados por colas que solo por CPU. Kubernetes también proporciona Jobs para tareas finitas que se ejecutan hasta completarse, aunque un consumidor de cola persistente puede ser más eficiente cuando el inicio del navegador es costoso.
Establezca límites rígidos para la cantidad de trabajadores, concurrencia por dominio, tareas de desafío totales y escrituras posteriores. Cuando un objetivo comience a devolver más estados de desafío o rechazo, reduzca o detenga el trabajo en lugar de escalar hacia el fracaso. Una cola en aumento puede ser una señal de capacidad; una tasa de desafío en aumento es una señal de diagnóstico.
La siguiente función de Python modela la capa de decisión sin contactar un objetivo o resolver un CAPTCHA. Acepta un estado de página observado y el presupuesto de tarea duradero, luego devuelve la siguiente acción.
from dataclasses import dataclass
from enum import Enum


class NextAction(str, Enum):
    EXTRACT = "extract"
    HANDLE_CHALLENGE = "handle_challenge"
    RETRY = "retry"
    REVIEW = "review"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    attempts: int
    max_attempts: int
    seconds_remaining: int
    session_matches: bool
    challenge_allowed: bool


def decide(page_state: str, budget: Budget) -> NextAction:
    if budget.seconds_remaining <= 0:
        return NextAction.STOP
    if page_state == "ready":
        return NextAction.EXTRACT
    if page_state == "challenge":
        if not budget.challenge_allowed or not budget.session_matches:
            return NextAction.REVIEW
        if budget.attempts >= budget.max_attempts:
            return NextAction.STOP
        return NextAction.HANDLE_CHALLENGE
    if page_state == "retryable_error":
        return NextAction.RETRY if budget.attempts < budget.max_attempts else NextAction.STOP
    if page_state in {"authentication_required", "review_required"}:
        return NextAction.REVIEW
    return NextAction.STOP
Pruebas locales cubren páginas listas, desafíos elegibles, sesiones cambiadas, plazos caducados, agotamiento de reintentos, estados de revisión y entrada desconocida. El modelo de decisión es intencionalmente pequeño para que un orquestador pueda registrar y auditar cada transición.
Las métricas más útiles conectan el comportamiento de la infraestructura con los resultados de las páginas. Siga la edad de la cola y la saturación de los trabajadores, pero también registre la tasa de desafíos, la tasa de autenticación requerida, la tasa de rechazo del analizador, la tasa de tareas duplicadas, la caducidad de plazos y la aceptación final del estado de negocio.
Use un ID de correlación a través del mensaje de la cola, el registro del navegador, la tarea de desafío, el registro extraído y la escritura posterior. Los registros deben enmascarar claves de API, cookies, tokens y datos personales. Una captura de pantalla es evidencia, no un registro permanente por defecto; mantenga solo lo que requiere el caso de uso autorizado.
Alerte sobre ratios en lugar de fallos aislados. Un desafío puede ser normal. Un aumento rápido para el mismo objetivo, ruta o versión de navegador puede indicar un cambio en el sitio, un defecto de sesión, una autenticación caducada, un problema de política o una regresión de liberación. Pausa la sección afectada mientras el resto de la cola continúa.
La escala de contenedores no expande permisos. Use esta arquitectura solo para flujos de datos públicos, autorizados u otros legales. Respete los términos del objetivo, límites de frecuencia, obligaciones de privacidad, jurisdicción y requisitos de minimización de datos.
No envíe páginas privadas, datos de cuenta o capturas de pantalla sensibles a sistemas externos a menos que el flujo esté explícitamente aprobado para ese dato. Separe los flujos de inicio de sesión e identidad de las tareas de datos públicos ordinarios. Exija revisión humana antes de envíos sensibles, acciones irreversibles o cambios de alcance.
Containers as a Service hace que los trabajadores de navegador sean repetibles y escalables, pero la confiabilidad en producción proviene de los contratos alrededor de esos trabajadores. Asigne a cada tarea un propietario, una sesión aislada, un plazo duradero, una máquina de estados tipada y una salida validada. Escale cuando la cola muestre demanda saludable; pause cuando la evidencia muestre rechazo repetido o estado incierto.
Para flujos autorizados con pasos de verificación compatibles, CapSolver puede encajar detrás de la puerta de elegibilidad mientras su aplicación preserva el contexto del navegador y verifica el resultado final.
Comience con un objetivo aprobado y un trabajador acotado. Registre la clasificación de la página, elegibilidad del desafío, tiempo transcurrido, aceptación final y referencias de evidencia antes de aumentar la concurrencia. Utilice la documentación de CapSolver para seleccionar el flujo de tareas documentado actual, luego revise el resultado en la sesión original del navegador.
P: ¿Resuelve Containers as a Service los problemas de acceso a sitios web?
No. CaaS implementa y escala aplicaciones contenerizadas, mientras que su capa de acceso aún necesita el estado del navegador, enrutamiento, clasificación de desafíos, controles de política y validación de resultados.
P: ¿Debería cada URL ejecutarse en un contenedor separado?
No necesariamente. Un contexto de navegador aislado por tarea arrendada suele ser el límite importante; un contenedor de trabajador puede procesar tareas secuencialmente si cierra cada contexto, elimina la memoria de la tarea y acepta solo después de que se escriba un estado duradero.
P: ¿Qué métrica debe escalar a los trabajadores del navegador?
La profundidad de la cola y la edad de la tarea suelen ser señales primarias más fuertes que el CPU solo. Combínelas con límites de trabajador, concurrencia a nivel de objetivo, tasa de desafío y caducidad del plazo para que la plataforma no escale un flujo de trabajo fallido.
P: ¿Cómo debe manejar un trabajador reiniciado una tarea de CAPTCHA existente?
El trabajador reiniciado debe cargar el ID de tarea del proveedor duradero, el plazo original, el recuento de intentos y la referencia de sesión. Debe consultar la tarea conocida solo cuando la sesión aún coincida y el presupuesto restante lo permita; de lo contrario, debe detenerse o solicitar una revisión.
P: ¿Puede usarse este patrón para datos privados o restringidos?
La capacidad técnica no otorga permiso para recopilar datos privados, restringidos, personales o sensibles. Use el patrón solo dentro de un alcance aprobado y aplique los términos del objetivo, la ley aplicable, la minimización de datos, los controles de retención y los requisitos de revisión humana.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Aprende una arquitectura de raspado web escalable en Rust con reqwest, scraper, raspado asíncrono, raspado con navegador sin cabeza, rotación de proxies y manejo de CAPTCHA conforme.
Automatiza la resolución de CAPTCHA con Nanobot y CapSolver. Utiliza Playwright para resolver reCAPTCHA y Cloudflare autónomamente.