
🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado May 21, 2026
Actualizado May 21, 2026 · min de lectura
En nuestro artículo anterior, exploramos cómo el Agentic Browser se transforma de una herramienta pasiva de “visualización” en un “agente de acción” activo. Examinamos su arquitectura central: comprensión de la intención, percepción del entorno y ejecución de acciones. Sin embargo, a medida que estos agentes digitales navegan por la web real, los puntos de control de CAPTCHA pueden interrumpir flujos de trabajo que por lo demás serían válidos. Este artículo se centra en el “motor invisible”, la infraestructura de resolución de CAPTCHAs, que ayuda a los agentes autorizados a pausar, enviar el contexto de la tarea requerida, verificar el resultado y continuar. Analizaremos por qué los puntos de control de CAPTCHA son un desafío operativo común para la IA y cómo servicios especializados como CapSolver respaldan la próxima generación de automatización web autorizada.
Uso responsable: CapSolver está diseñado solo para automatización legal y autorizada, incluido el testeo de sistemas que posees o para los que tienes permiso de acceso. El uso para fraude, cuentas falsas, compras no autorizadas, spam o abuso de controles de acceso está prohibido según los Términos y Condiciones de CapSolver.
Imagina este escenario: un equipo de QA le pide a un Agentic Browser que complete un formulario de varios pasos en un entorno de staging que posee. El agente abre la página, localiza los campos requeridos y se encuentra con un punto de control de CAPTCHA antes del envío. El flujo de trabajo se pausa hasta que se completa la verificación. Este CAPTCHA, este “Test de Turing” nacido en los primeros días de Internet, se ha convertido en un desafío práctico de fiabilidad para los flujos de trabajo de agentes de IA autorizados.
CAPTCHA significa “Completely Automated Public Turing Test to Tell Computers and Humans Apart”. Su propósito original era simple: mantener fuera a los bots mientras se permite el acceso a los humanos. Pero a medida que la IA ha evolucionado, los CAPTCHAs también lo han hecho, pasando de simples letras distorsionadas a complejos deslizadores, tareas de selección de imágenes y sistemas de análisis del comportamiento. Ya no son solo un problema de reconocimiento de caracteres.
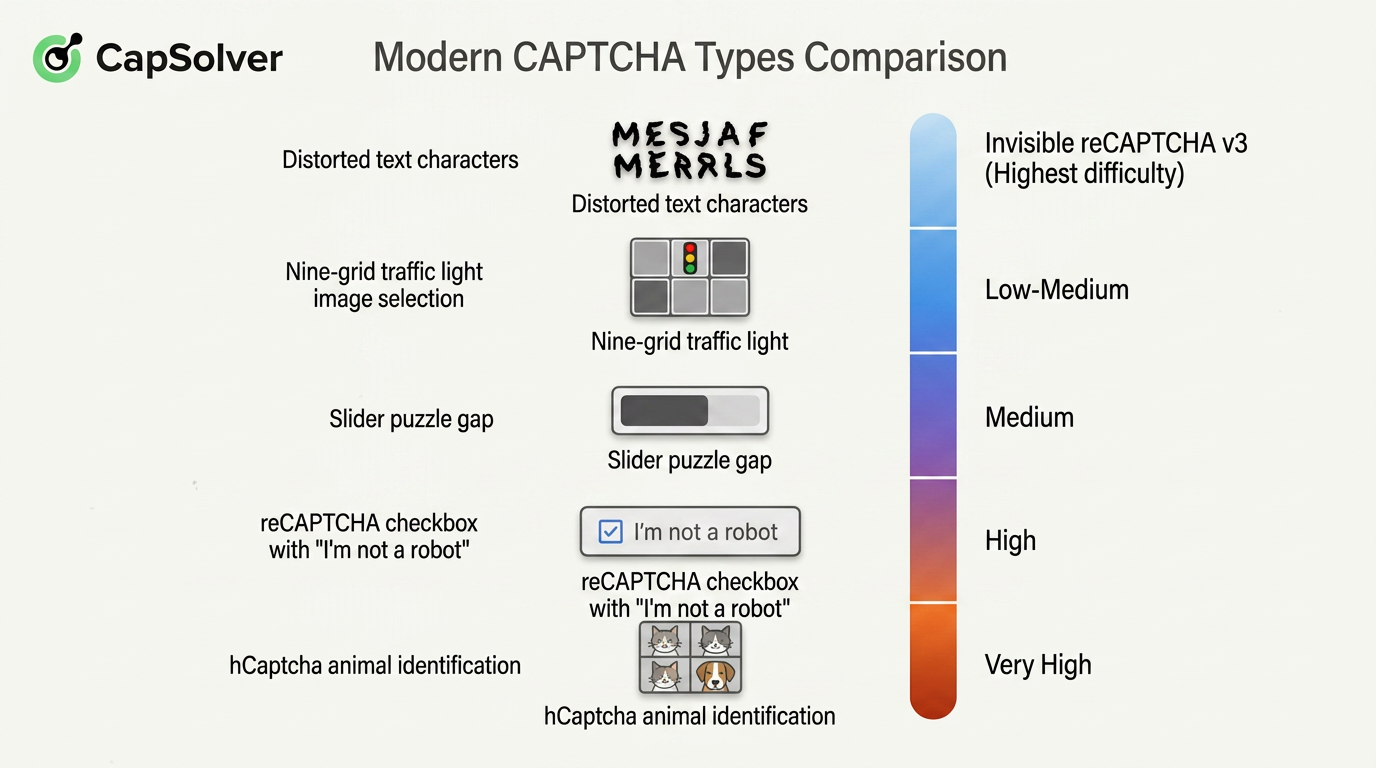
Para los scripts de automatización tradicionales, los puntos de control de CAPTCHA pueden detener un flujo de trabajo. Para los Agentic Browsers, generan tres desafíos operativos principales:
Aumento drástico de la dificultad de percepción: Incluso los modelos multimodales más avanzados tienen dificultades para reconocer de forma fiable texto muy distorsionado, objetos borrosos en imágenes o huecos de deslizadores ocultos en fondos complejos. La IA puede simplemente “verlo mal”, y un solo error puede romper todo el flujo de trabajo.
Señales de verificación en capas: Los CAPTCHAs modernos ya no son solo retos de front-end. Los sitios pueden evaluar trayectorias del ratón, ritmos de tecleo, tiempo de permanencia en la página, contexto del navegador y otras señales de sesión. Cuando una solicitud no satisface las políticas de acceso del sitio, puede requerirse verificación adicional.
Sensibilidad temporal y disrupción contextual: Los CAPTCHAs suelen tener límites de expiración. Cuando un Agentic Browser permanece demasiado tiempo en un punto de control de CAPTCHA durante una tarea de varios pasos, las sesiones de inicio de sesión pueden expirar y la cadena de tareas puede tener que reiniciarse.
En otras palabras, los Agentic Browsers necesitan una forma controlada de pausar en los puntos de control de CAPTCHA, enviar entradas documentadas y reanudar solo después de que la verificación tenga éxito. Por eso la infraestructura de manejo de CAPTCHAs como CapSolver puede formar parte de flujos de trabajo de navegador autorizados.
CapSolver no es una herramienta dirigida a usuarios comunes, sino más bien un “motor de CAPTCHA” oculto profundamente dentro de los kits de herramientas de los desarrolladores. En esencia, es una plataforma inteligente de resolución de CAPTCHAs que proporciona interfaces de API diseñadas específicamente para ayudar a programas de automatización y agentes de IA a gestionar distintos tipos de CAPTCHAs.
Podemos verlo como un equipo de resolución de CAPTCHAs disponible 24/7 que nunca se cansa y opera a una velocidad extremadamente alta, excepto que sus “miembros del equipo” no solo consisten en sofisticados modelos de IA, sino también en algoritmos de estrategia altamente optimizados.
Para entender mejor sus capacidades, la siguiente tabla comparativa ilustra las diferencias entre los enfoques tradicionales y CapSolver frente a los mismos desafíos de CAPTCHA:
| Dimensión de comparación | OCR local / modelos simples | Plataformas humanas de resolución de CAPTCHA | CapSolver |
|---|---|---|---|
| Tipos de CAPTCHA soportados | Solo CAPTCHAs de texto simples; la selección de imágenes es mayormente ineficaz | Teóricamente soporta todos los tipos, pero es lento y costoso | Cubre los tipos de CAPTCHA más comunes |
| Velocidad de reconocimiento | Milisegundos, pero con bajas tasas de éxito | 5–15 segundos por intento | 1–3 segundos por intento |
| Tasa de éxito | Baja (peor en CAPTCHAs complejos) | Relativamente alta, pero afectada por fatiga de los trabajadores y latencia de red | Alta y estable |
| Estructura de costos | Costo de desarrollo único | Pago por tarea con altos costos laborales | Pago por tarea con precios bajos y bajos costos marginales |
| Integración con flujos de trabajo de navegador | Requiere integración personalizada | Requiere coordinación de tareas por separado | Puede integrarse con entornos de navegador y devolver resultados de tarea documentados |
Tabla 1-1 Comparación entre métodos tradicionales de resolución de CAPTCHA y capacidades de CapSolver
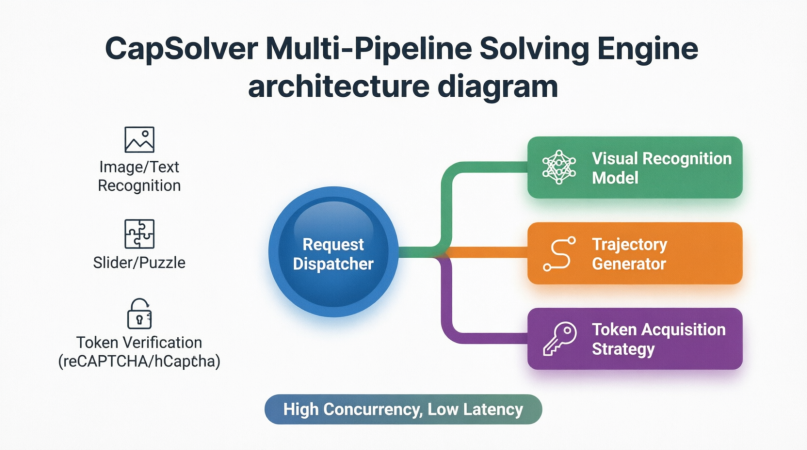
CapSolver usa canales de procesamiento especializados para distintos tipos de CAPTCHA:
CAPTCHAs de reconocimiento de imagen y texto: Usando modelos de visión propios combinados con enormes conjuntos de datos de entrenamiento, CapSolver puede reconocer con precisión texto muy distorsionado, superpuesto o ruidoso.
CAPTCHAs de deslizadores y rompecabezas: CapSolver utiliza el flujo de tarea documentado para el tipo de reto seleccionado y devuelve el resultado correspondiente para que el flujo de trabajo autorizado del cliente lo aplique.
Sistemas de verificación basados en tokens (reCAPTCHA v2/v3, Cloudflare, etc.): Estos sistemas pueden devolver un token de un solo uso después de enviar los parámetros de tarea requeridos. CapSolver utiliza entradas documentadas como la URL del sitio web, la clave del sitio y contexto opcional soportado, luego devuelve el resultado soportado para que el flujo de trabajo autorizado del cliente lo envíe.
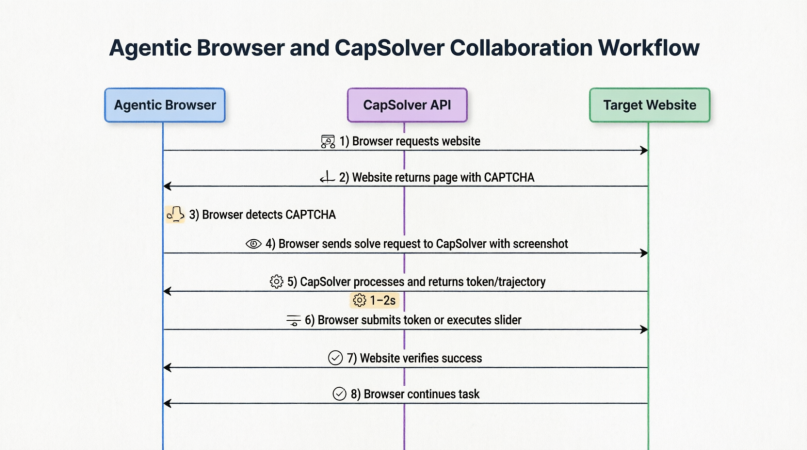
Entonces, ¿cómo colaboran CapSolver y los Agentic Browsers en la práctica? El siguiente diagrama ilustra el proceso completo:
Desde el momento en que el navegador se encuentra con un CAPTCHA, recopila el contexto de tarea requerido, llama a la API de CapSolver, recibe un resultado soportado, envía la verificación y reanuda la tarea original, el flujo de trabajo está estrechamente integrado y normalmente se completa en 1–2 segundos.
Esto significa que, para los Agentic Browsers, los CAPTCHAs dejan de ser problemas que la IA misma deba “ver” y “adivinar”. En su lugar, se convierten en tareas estandarizadas externalizadas a proveedores de infraestructura especializados. El navegador solo necesita capturar el reto, empaquetar el contexto requerido, enviarlo, esperar el resultado y continuar después de verificar el estado de la página.
Ahora conectemos el módulo de adaptación dinámica de un Agentic Browser con CapSolver y examinemos un flujo de trabajo controlado de manejo de CAPTCHAs. Solo utiliza este proceso en sitios que poseas o para los que estés explícitamente autorizado a automatizar.
Mientras el Agentic Browser ejecuta tareas, su capa de percepción del entorno supervisa continuamente la página web. Una vez que se detecta un elemento de CAPTCHA (por ejemplo, una ventana emergente que contiene un iframe de reCAPTCHA), la ejecución de acciones se pausa de inmediato y se activa un subproceso dedicado al manejo de CAPTCHAs.
Este proceso es altamente sofisticado y generalmente incluye los siguientes pasos:
Recopilación de contexto: El Agentic Browser captura capturas de pantalla de la región del CAPTCHA y reúne información contextual como la URL actual, la sitekey, las dimensiones del viewport del navegador y el User-Agent.
Envío de la tarea: Las capturas de pantalla y los parámetros se empaquetan y se envían a CapSolver a través de la API especificando el tipo de CAPTCHA.
Resolución en segundo plano: Tras recibir la tarea, CapSolver la enruta a través del canal de resolución correspondiente. Por ejemplo, al encontrarse con reCAPTCHA v2, invoca un solucionador dedicado para devolver un token g-recaptcha-response válido. Todo el proceso de resolución suele completarse en 1–2 segundos.
Devolución de instrucciones: El Agentic Browser recibe el resultado especificado para el tipo de tarea soportado, como una cadena de token.
Ejecución en el sitio: El Agentic Browser aplica el resultado devuelto mediante el callback, campo o manejador del lado del cliente documentado. Después de que la página confirme la verificación, el flujo de tarea autorizado puede reanudarse.
Verificación de estado: El navegador verifica si la página ha superado con éxito la validación y si los elementos objetivo han reaparecido antes de continuar el flujo de trabajo interrumpido.
Es importante señalar que los CAPTCHAs modernos adoptan muchas formas con distintos niveles de complejidad. El siguiente diagrama clasifica los tipos de CAPTCHA más comunes y marca sus niveles de complejidad correspondientes:
Para los usuarios finales, todo el proceso sigue siendo completamente transparente. En el registro de tareas del Agentic Browser, los usuarios pueden ver solo un mensaje simple como:
“Se detectó reCAPTCHA v2. Resuelto automáticamente en 1,2 segundos.”
Un punto de control que antes habría detenido el flujo de trabajo de automatización puede gestionarse en segundo plano y registrarse en el log de tareas.
Esto mejora la continuidad del flujo de trabajo de los agentes de IA: el agente puede manejar puntos de verificación soportados en entornos autorizados mientras preserva el contexto de la página y de la sesión. La infraestructura de resolución de CAPTCHA funciona como un “motor invisible” dentro de un flujo de trabajo acotado y observable.
Sin una ruta de manejo controlada, una ventana emergente de CAPTCHA aún puede interrumpir una tarea automatizada que por lo demás sería válida.
Si los capítulos anteriores hicieron que esta tecnología pareciera lejana, los siguientes ejemplos pueden cambiar por completo tu perspectiva. Los Agentic Browsers no son conceptos abstractos flotando en el futuro: están entrando rápidamente en tres grandes dominios: productividad personal, automatización empresarial y recopilación de datos. En cada área, están resolviendo problemas prácticos en distintos niveles.
El siguiente diagrama resume los escenarios centrales de aplicación de los Agentic Browsers:
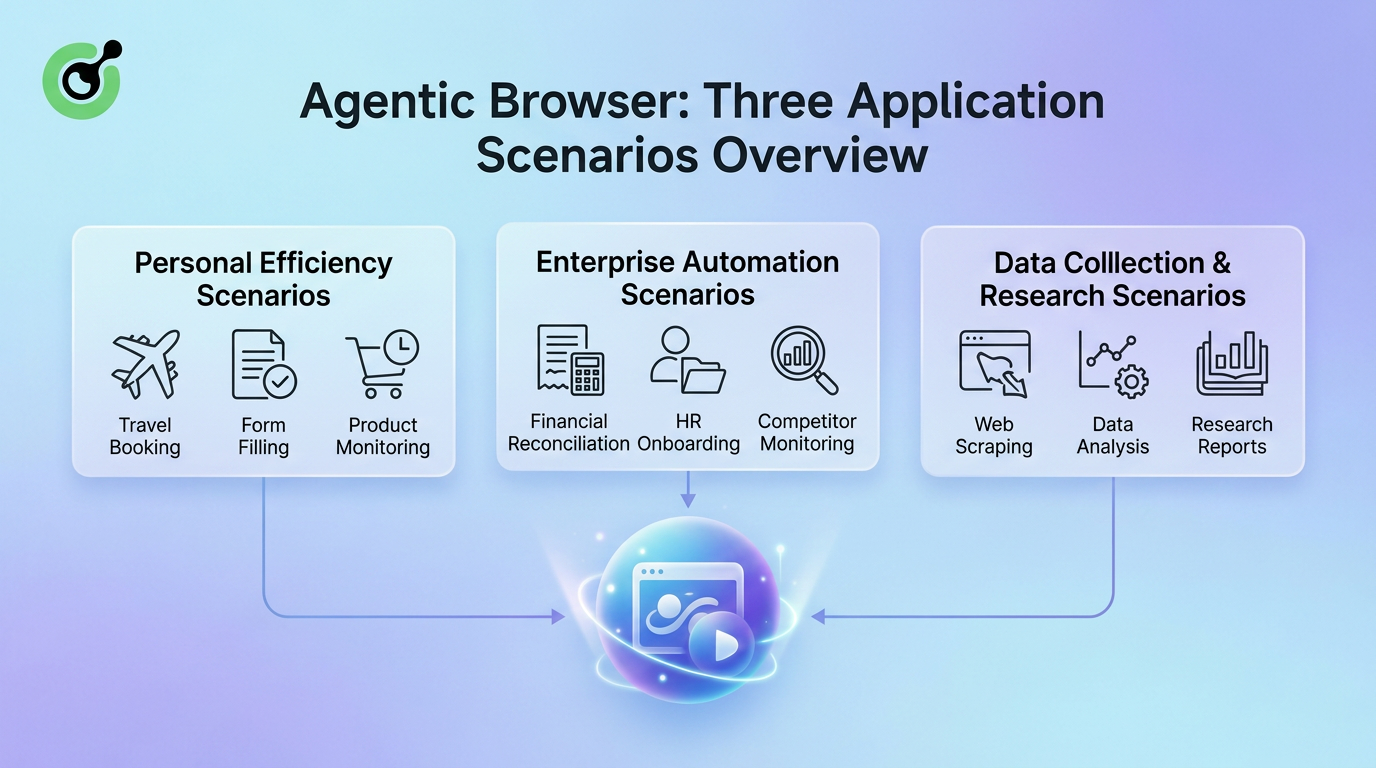
Las aplicaciones de los Agentic Browsers abarcan desde usuarios individuales hasta grandes empresas, y desde tareas diarias hasta flujos de trabajo de investigación profesional. En productividad personal, ayudan a los usuarios a reservar viajes, rellenar formularios repetitivos y monitorear fluctuaciones de precios de productos. En automatización empresarial, gestionan conciliaciones financieras, incorporación de empleados y seguimiento de competidores. En recopilación de datos e investigación, sirven como rastreadores incansables y asistentes de análisis inteligentes.
A continuación, examinaremos estos tres escenarios en detalle para entender cómo los Agentic Browsers realmente “hacen el trabajo”.
Para los usuarios comunes, el valor más inmediato de un Agentic Browser es simple: ahorrar tiempo.
Cada día, las personas realizan innumerables tareas en línea repetitivas y de varios pasos dentro de los navegadores. Estas tareas suelen compartir tres características:
Los Agentic Browsers destacan en hacerse cargo precisamente de este tipo de tareas: situaciones en las que los usuarios saben qué quieren que se haga, pero no quieren realizar manualmente las operaciones.
En escenarios de productividad personal, los Agentic Browsers pueden ayudar con las siguientes tareas típicas:
Por ejemplo, un Agentic Browser puede comparar opciones de vuelos u hoteles, filtrar resultados según hora, preferencias o presupuesto y preparar los detalles seleccionados para que el usuario los revise y confirme.
Tareas como solicitudes de visado, solicitudes escolares o reembolsos de gastos a menudo exigen que los usuarios introduzcan repetidamente la misma información en múltiples formularios.
Un Agentic Browser actúa como un “gestor de información” al recordar de forma segura los datos del usuario, identificar automáticamente los campos de los formularios y mapearlos inteligentemente. Por ejemplo, puede dividir un nombre completo en “Nombre” y “Apellido” automáticamente.
Los Agentic Browsers pueden monitorear en segundo plano el inventario de productos, cambios de precios o lanzamientos de nuevos productos. Una vez que se cumplen las condiciones predefinidas, como una bajada de precio o una reposición de stock, el navegador notifica inmediatamente al usuario para su revisión.
Para ilustrar mejor la transformación en la experiencia del usuario, la siguiente tabla compara flujos de trabajo tradicionales con flujos de trabajo con Agentic Browser:
| Tipo de tarea | Costo de tiempo del flujo de trabajo tradicional | Flujo de trabajo con Agentic Browser | Transformación del rol del usuario |
|---|---|---|---|
| Comparar y reservar un vuelo | 15–30 minutos (navegar manualmente por varios sitios) | 1 minuto (describir requisitos y confirmar recomendaciones) | De ejecutor → tomador de decisiones |
| Rellenar formularios en línea complejos | 20–40 minutos (introducir repetidamente información idéntica) | 2 minutos (revisar resultados de autocompletado y corregir pequeñas diferencias) | De operador de entrada de datos → revisor |
| Monitorear reposición de productos o bajadas de precio | Extremadamente costoso en tiempo (actualización manual y atención constante) | 0 minutos (monitoreo en segundo plano con notificaciones automáticas) | De monitor → receptor |
| Organización de datos entre plataformas | 1–2 horas (copiar, pegar y formatear) | 5 minutos (extracción y formateo automáticos) | De operador manual → analista |
Tabla 2-1 Comparación entre tareas personales tradicionales y eficiencia del Agentic Browser
Como se ve arriba, el Agentic Browser actúa efectivamente como un asistente personal. Libera a los usuarios de ser “operadores de flujos de trabajo” y los transforma en “definidores de objetivos” y “revisores de resultados”.
Si las mejoras en productividad personal tienen que ver con “reducir el esfuerzo”, entonces el valor de los Agentic Browsers en entornos empresariales tiene que ver con la conexión.
Las grandes organizaciones suelen depender de numerosos sistemas heredados desconectados, plataformas SaaS y portales de proveedores que no pueden integrarse fácilmente mediante APIs. Los empleados se ven obligados a convertirse en “pegamento humano”, transfiriendo información manualmente entre sistemas una y otra vez.
Precisamente aquí es donde los Agentic Browsers demuestran sus mayores ventajas.
Con autorización explícita, un Agentic Browser puede acceder a portales financieros o de proveedores controlados por la organización, recuperar registros aprobados, compararlos con los sistemas ERP, generar informes de discrepancias y preparar borradores de notificación para su revisión.
Las organizaciones pueden predefinir paquetes de tareas de onboarding. Dentro de sistemas controlados por la organización y políticas de acceso aprobadas, el Agentic Browser puede preparar o completar pasos autorizados de aprovisionamiento de cuentas en sistemas de RR. HH. y TI.
Los Agentic Browsers pueden funcionar como sistemas de “radar de mercado” visitando páginas públicas que permiten acceso automatizado, identificando cambios relevantes de información y almacenándolos en bases de datos estructuradas, respetando los términos aplicables y los límites de frecuencia.
Para ilustrar mejor el posicionamiento único de los Agentic Browsers en la automatización empresarial, la siguiente tabla los compara con las operaciones manuales y las integraciones tradicionales mediante API:
| Dimensión | Operaciones manuales | Desarrollo de integración por API | Agentic Browser |
|---|---|---|---|
| Sistemas aplicables | Cualquier sistema al que el usuario esté autorizado a acceder | Solo sistemas con APIs abiertas | Sistemas web autorizados, incluidos sistemas heredados controlados por la organización |
| Ciclo de despliegue | No requiere desarrollo, pero consume mucho tiempo | De semanas a meses (depende de los recursos de desarrollo) | De horas a días (configuración y prueba de tareas) |
| Flexibilidad | Alta (los humanos se adaptan dinámicamente) | Baja (se requieren reescrituras de interfaz tras cambios) | Alta (la IA se adapta dinámicamente a cambios en la página) |
| Manejo de CAPTCHA/inicio de sesión | Requiere manejo manual | Generalmente difícil de manejar directamente | Puede invocar soluciones de CAPTCHA configuradas dentro de flujos de trabajo autorizados |
| Escalabilidad | Deficiente | Extremadamente fuerte | Fuerte (es posible la ejecución paralela de tareas) |
| Escenarios típicos de fallo | Fatiga humana y omisiones | Límites de frecuencia de API o incompatibilidad de versiones | Puede requerir confirmación humana en condiciones de página extremadamente caóticas |
Tabla 2-2 Comparación de soluciones de automatización empresarial entre sistemas
Como se muestra arriba, los Agentic Browsers no están diseñados para reemplazar las APIs. En cambio, proporcionan una capa de integración ligera en situaciones donde las APIs no están disponibles o son demasiado costosas de implementar.
Al aprovechar la flexibilidad y capacidad de adaptación de la IA, los Agentic Browsers llenan los vacíos que dejan los enfoques tradicionales de automatización, permitiendo a las empresas lograr una coordinación inteligente entre sistemas sin reconstruir la infraestructura heredada.
A menudo se describe a los datos como el petróleo de la era digital, pero recopilar de forma eficiente datos públicos limpios de la web siempre ha sido difícil.
Los rastreadores tradicionales dependen de reglas de análisis fijas. Una vez que los sitios web de destino rediseñan sus interfaces o requieren verificaciones adicionales, los rastreadores pueden fallar por completo. La recopilación automatizada solo debe continuar cuando el acceso esté autorizado y sea coherente con los términos aplicables del sitio. Los investigadores académicos, las firmas de investigación de mercado y los equipos de periodismo de investigación a menudo necesitan extraer información específica de grandes cantidades de páginas web públicas, lo que vuelve los enfoques tradicionales costosos y que consumen mucho tiempo.
Los Agentic Browsers introducen un paradigma completamente nuevo para la recopilación de datos:
Un cambio de la extracción basada en “reglas de código” a la extracción basada en “objetivos semánticos”.
Su flujo de trabajo generalmente funciona de la siguiente manera:
Los investigadores describen las dimensiones de datos requeridas y los rangos de muestra usando lenguaje natural. Por ejemplo:
“Extraer los títulos de productos, precios, calificaciones y recuentos de reseñas de las 100 principales páginas de productos de comercio electrónico, excluyendo los productos patrocinados.”
El Agentic Browser navega de forma autónoma por las páginas web, identifica los bloques de información relevantes mediante percepción del entorno, extrae y estructura los datos de forma inteligente y maneja interacciones complejas como paginación, desplazamiento infinito y ventanas emergentes.
Cuando los sitios web de destino rediseñan sus interfaces, los rastreadores tradicionales suelen colapsar de inmediato. En cambio, los Agentic Browsers intentan reubicar la información visualmente y continuar la ejecución.
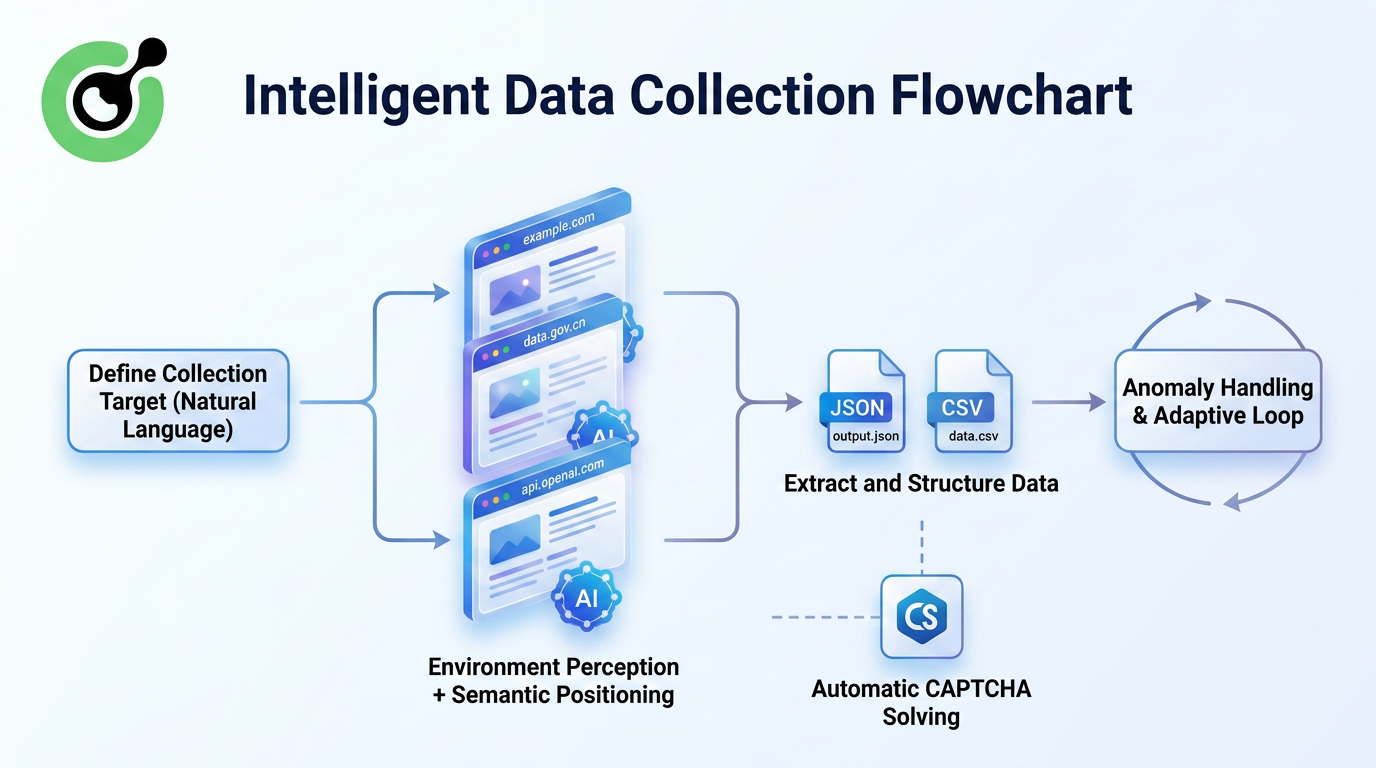
Este enfoque introduce varias mejoras fundamentales:
La IA entiende cómo luce semánticamente un “precio” en lugar de depender de nombres de clases HTML fijos.
Los cambios menores de diseño ya no rompen de inmediato las canalizaciones de extracción.
Para sitios autorizados que requieren inicio de sesión, desplazamiento infinito o cambio de pestañas, los Agentic Browsers pueden usar acciones de navegador compatibles y sesiones aprobadas antes de extraer la información permitida.
Las configuraciones de tareas pueden guardarse y compartirse, haciendo que la recopilación de datos sea estandarizada y reproducible.
Para demostrar mejor las ventajas de resiliencia de los Agentic Browsers en tareas de recopilación de datos, la siguiente figura compara los rastreadores tradicionales y los Agentic Browsers después de múltiples rediseños de sitios web:
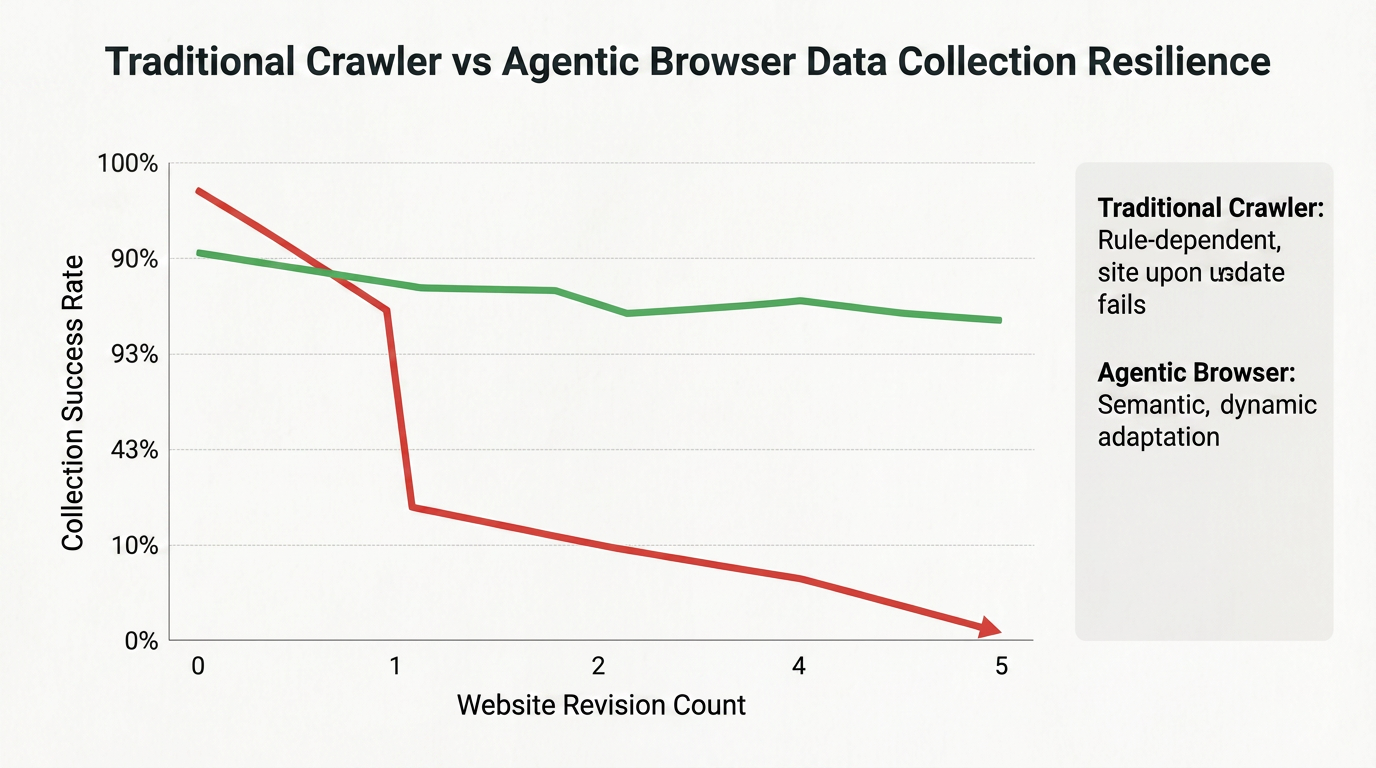
Los rastreadores tradicionales experimentan caídas drásticas en su tasa de éxito después del primer rediseño del sitio, mientras que los Agentic Browsers mantienen tasas de éxito de extracción relativamente altas incluso después de varios rediseños gracias a sus capacidades de localización visual y comprensión semántica.
Esta resiliencia los hace ideales para proyectos de recopilación de datos a gran escala y a largo plazo.
Por ejemplo, imaginemos un equipo de investigación en ciencias sociales que necesita comparar cláusulas políticas específicas en 200 sitios de políticas de 30 países. Tradicionalmente, esto requeriría que asistentes de investigación dedicaran meses a copiar y organizar información manualmente.
Ahora, los investigadores pueden configurar una tarea de Agentic Browser que visite páginas de políticas públicas respetando los términos aplicables y los límites de frecuencia, localice páginas que contengan palabras clave objetivo, extraiga las cláusulas relevantes y las categorice automáticamente.
Los investigadores solo necesitan revisar y analizar los resultados recopilados después, permitiendo que el valioso esfuerzo humano se centre en la verdadera “investigación” en lugar del repetitivo “trabajo de transporte manual”.
El Agentic Browser no representa solo un nuevo producto, sino toda una nueva filosofía de estar en línea. Su lógica central es: el navegador no debería ser solo una interfaz que espera a que hagas clic, sino un agente inteligente que entienda tu intención y te ayude a completar tareas. Desde la perspectiva de la implementación técnica, se basa en la capacidad de razonamiento de los grandes modelos de lenguaje para planificar tareas, en la percepción multimodal para entender las páginas web, en un entorno de navegador real para ejecutar operaciones y en infraestructuras como CapSolver para manejar los puntos de verificación compatibles en automatizaciones autorizadas. La fusión de estas tecnologías está transformando la “ventana de información” que hemos utilizado durante treinta años en una verdadera “plataforma de acción”.
P1: ¿Por qué los modelos de IA generales no pueden resolver CAPTCHAs por sí solos?
R1: Aunque los modelos de IA generales son potentes, los CAPTCHAs están diseñados específicamente para ser adversariales y cambiar constantemente. Resolverlos de forma fiable y rápida requiere una infraestructura especializada como CapSolver, dedicada exclusivamente a esta tarea.
P2: ¿Cómo ayuda CapSolver a los Agentic Browsers?
R2: CapSolver actúa como un “motor invisible” que gestiona los desafíos CAPTCHA compatibles a través de una API documentada. Esto permite que un flujo de trabajo autorizado de Agentic Browser envíe el contexto de la tarea requerido, aplique el resultado, verifique el estado de la página y continúe.
P3: ¿Reemplazarán los Agentic Browsers los trabajos humanos?
R3: Están diseñados para reemplazar “tareas”, no “empleos”. Al encargarse del trabajo digital repetitivo, liberan a las personas para que se centren en la creatividad de mayor nivel y en la toma de decisiones estratégicas.
P4: ¿Cómo puedo empezar a usar un Agentic Browser hoy?
R4: Ya hay disponibles muchos navegadores y extensiones experimentales. Para obtener la mejor experiencia, usa un servicio confiable de resolución de CAPTCHA como CapSolver solo para los puntos de verificación compatibles en sistemas que posees o estás autorizado a automatizar.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Corregir el manejo de CAPTCHA que funciona localmente pero falla en un agente de IA en la nube. Comparar la configuración del navegador, las dependencias, las credenciales, el acceso a la red y el estado de la página.
Configura CapSolver MCP en Claude Code, verifica las herramientas de CAPTCHA disponibles y elige la resolución de token o página para una tarea de navegador compatible y autorizada.