

🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Nov 13, 2026
Actualizado Nov 13, 2026 · min de lectura
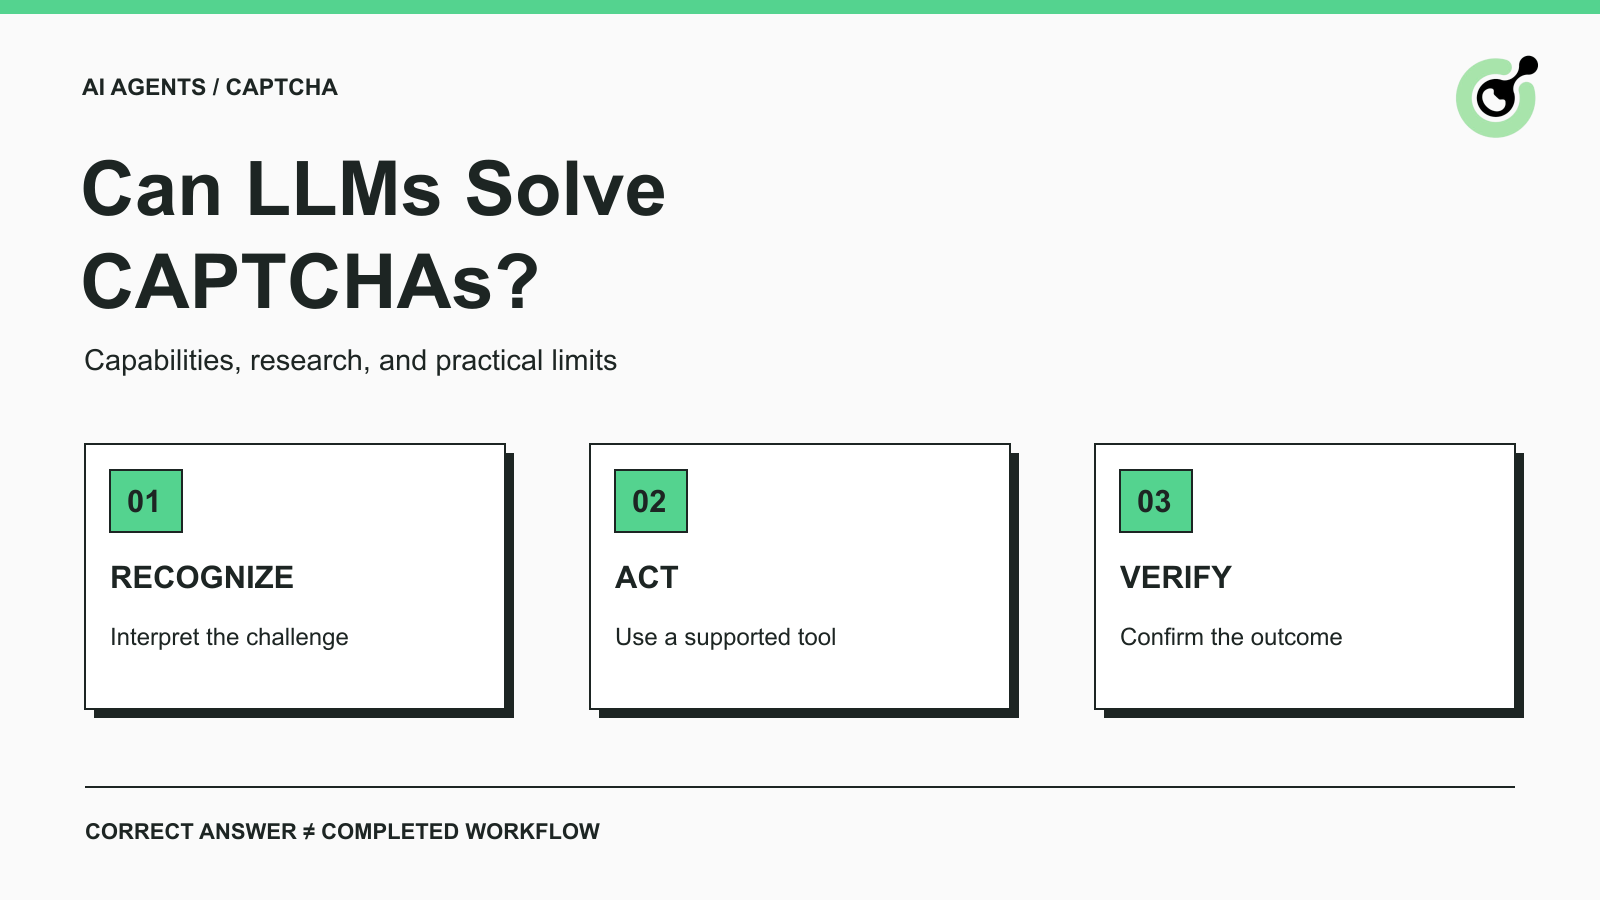
Una captura de pantalla que muestre un objeto correctamente identificado es una prueba útil sobre la capacidad de visión de un modelo. Pero deja sin responder otra pregunta: ¿aceptó la aplicación la verificación y terminó la operación solicitada? Esa distinción importa al evaluar un solucionador de CAPTCHA basado en LLM para agentes de navegador, QA o recopilación de datos permitida.
Esta guía explica qué significa el término, qué demuestra la investigación y qué comprobaciones deben incluirse en una evaluación. También muestra dónde encaja un servicio como CapSolver. El enfoque es la capacidad y la selección de producto, no los prompts para atacar un sitio web en particular ni la afirmación de que todo agente de IA puede resolver cualquier desafío.
Un solucionador de CAPTCHA basado en LLM utiliza un modelo de lenguaje, normalmente con comprensión de imágenes, para interpretar una tarea CAPTCHA o ayudar a coordinar su resolución. La expresión abarca varios sistemas distintos, así que conviene preguntar qué es exactamente lo que el producto acepta y devuelve.
Un sistema puede aceptar una imagen y producir una respuesta en texto. Otro puede devolver una ubicación de clic propuesta. Un agente de navegador puede llamar a un servicio de resolución independiente y luego continuar una tarea después de que código de aplicación de confianza verifique el resultado. Estos sistemas requieren métodos de evaluación diferentes.
La entrada del glosario sobre LLM explica la categoría de modelo subyacente. Añadir un navegador o una herramienta de resolución proporciona capacidades adicionales al modelo; no convierte cada resultado de herramienta en un resultado del propio razonamiento visual del modelo.
El reconocimiento pregunta si un modelo interpreta correctamente la entrada del desafío. La orquestación pregunta si un agente selecciona y usa una herramienta adecuada en el punto correcto de un flujo de trabajo.
Un agente que delega un CAPTCHA a una API puede ser útil sin resolver por sí mismo la imagen. A la inversa, un modelo que etiqueta una imagen correctamente puede seguir careciendo de los controles de navegador, entradas de tarea o respuesta aceptada necesarios para completar una operación web. Evalúa el rol que tu aplicación realmente necesita.
La investigación publicada muestra que el rendimiento varía según el tipo de desafío y el diseño del sistema. Apoya una respuesta condicional a “¿pueden los LLM resolver CAPTCHAs?”.
El artículo de investigación Oedipus examina CAPTCHAs de razonamiento e informa de dificultades al usar las capacidades de los LLM directamente. Su framework propuesto añade descomposición de tareas y una representación específica del dominio. Por lo tanto, un resultado del framework incluye el sistema circundante, en lugar de ser simplemente un modelo sin asistencia.
El estudio COGNITION evalúa modelos multimodales en varios tipos de tareas CAPTCHA. Sus resultados distinguen tareas orientadas al reconocimiento, con baja interacción, de tareas más difíciles de localización, razonamiento espacial y entre fotogramas. El artículo también tiene en cuenta reintentos, latencia y coste, no solo precisión.
Estos estudios no proporcionan una tasa de éxito transferible para cada servicio, navegador o despliegue en producción. Al leer un resultado, mantén asociado al reclamo el modelo evaluado, el conjunto de tareas, la tolerancia a reintentos y el punto de medición. Un nombre de modelo más reciente por sí solo no es evidencia de que el mismo resultado se mantenga.
Una descripción útil de benchmark te indica si el éxito significó una etiqueta correcta, una secuencia de interacciones aceptada, una respuesta válida del servidor o la finalización del trabajo original de la aplicación.
Para un equipo de QA autorizado, un benchmark de imagen-respuesta puede ayudar a seleccionar un componente de reconocimiento. Un equipo de agentes de navegador necesita evidencia adicional sobre interacción con la página y finalización de la aplicación. Ningún equipo debería sustituir silenciosamente una medida por la otra.
Revisa también si los intentos fallidos o que excedieron el tiempo límite permanecen en el denominador. Informar solo de las salidas exitosas oculta el trabajo que un operador tendría que investigar.
Una respuesta visual correcta puede ser insuficiente porque una aplicación puede requerir una respuesta de verificación válida y sus propias comprobaciones de aceptación. El rompecabezas visible es solo la parte que una captura de pantalla expone.
Por ejemplo, la documentación de verificación de respuesta de Google describe un token de respuesta que el backend de la aplicación verifica. Documenta un periodo de validez de dos minutos y un solo uso. Una descripción generada por un modelo sobre una imagen no es esa respuesta de verificación.
De forma similar, la guía de validación de Turnstile de Cloudflare exige validación de token del lado del servidor y describe una vida útil de cinco minutos con tokens de un solo uso. No se debe evaluar Turnstile como si fuera simplemente una tarea de etiquetado de imágenes.
Estos ejemplos establecen por qué importa el punto final de evaluación. No implican que un solucionador garantice acceso a la aplicación. El sitio sigue controlando su lógica de aplicación y sus decisiones de acceso.
Al probar tu propia aplicación, inspecciona el resultado de validación del lado del servidor y el estado final de la aplicación. Cuando trabajes con un flujo de trabajo de terceros autorizado, utiliza el resultado observable documentado que tengas disponible.
Si el resultado del backend no está disponible, márcalo como desconocido. Un botón que cambia, un widget que se cierra o una respuesta devuelta por una API pueden ser señales útiles, pero ninguna debería convertirse silenciosamente en “aceptado por el servidor” en un informe.
Canjea tu código de bonificación de CapSolver
Aumenta tu presupuesto de automatización al instante.
Usa el código de bonificación CAP26 al recargar tu cuenta de CapSolver para obtener un 5% extra de bonificación en cada recarga, sin límites.
Canjéalo ahora en tu Panel de CapSolver
Un solucionador de CAPTCHA dedicado maneja una tarea de verificación compatible dentro de un flujo de trabajo autorizado más amplio. El agente sigue siendo responsable del objetivo original y la aplicación sigue siendo responsable de comprobar el resultado.
La documentación de CapSolver Agent Tools describe una división entre las decisiones del modelo, un adaptador de herramientas y la capa de ejecución Core. Eso ofrece a los equipos una ruta de integración documentada sin exigir que un modelo de lenguaje deduzca el protocolo de resolución a partir de una captura de pantalla.
Una evaluación práctica debería seguir esta secuencia:
Se trata de una lista de responsabilidades, no de código de integración ejecutable. Usa el ejemplo oficial para tu framework elegido y verifícalo en tu entorno antes del despliegue.
El modelo normalmente necesita una explicación del resultado, como completado, aún pendiente o detenido para revisión. No necesita el contenido completo de las cookies del navegador, credenciales de servicio ni cada respuesta en bruto.
Esto hace más clara la resolución de problemas. Registra por separado el desafío observado, la operación seleccionada y el estado final. Si una llamada de herramienta nunca se inició, investiga la selección de herramienta. Si el solucionador devolvió un resultado pero la aplicación lo rechazó, investiga esa fase posterior.
Para la cuestión de implementación aparte de elegir entrada por captura de pantalla o API de token, consulta gestión de CAPTCHAs para agentes de uso de ordenador. Esa decisión depende de lo que el entorno de ejecución pueda observar y ejecutar.
Evalúa un solucionador de CAPTCHA basado en LLM frente a un pequeño conjunto de tareas autorizadas con condiciones de aceptación explícitas. El propósito es probar el rol que necesitas, no fabricar una clasificación universal.
Anota el tipo de entrada, las acciones permitidas, la familia de desafíos soportada, el presupuesto de reintentos y el estado final esperado antes de comparar sistemas. Mantén los fallos ordinarios del navegador separados de los fallos de desafío. De lo contrario, una carga de página lenta puede distorsionar el resultado aparente de resolución.
Informa del recuento de resultados, el tiempo transcurrido, los intentos consumidos y el coste para la unidad completa evaluada. Si la unidad es un trabajo de agente, incluye los trabajos fallidos y las llamadas pagadas repetidas. Si es una tarea de imagen, indícalo directamente.
Un informe de evaluación útil también conserva los casos negativos. Incluye un desafío no compatible, una entrada requerida ausente y un resultado que llega después de que el trabajo haya finalizado. El comportamiento deseado en esos casos puede ser una parada clara en lugar de otro intento.
No interpretes la declaración de confianza de un modelo como una probabilidad medida de aceptación. Utiliza un resultado observado de la aplicación o del entorno de pruebas. Mantén el entorno de pruebas limitado a sistemas y datos que estás autorizado a probar.
Una pequeña prueba puede demostrar que una integración se comporta como se pretende en los casos inspeccionados. No puede justificar afirmaciones como “el mejor para todos los agentes” o “funciona en cualquier sitio”. Mantén el informe de prueba ligado a la decisión de compra para que otro equipo pueda ver sus límites.
Cuando cambien los requisitos, repite los casos relevantes. Cambiar el modelo, el entorno de ejecución del navegador, el tipo de tarea del solucionador o la aplicación de destino puede cambiar lo que tus evidencias anteriores demuestran. Una declaración de compatibilidad precisa es más útil que una promesa sin restricciones.
Elige un modelo de reconocimiento cuando el requisito sea una tarea acotada de comprensión de imágenes que puedas evaluar directamente. Elige una integración de resolución documentada cuando una aplicación autorizada necesite un resultado CAPTCHA compatible. Usa un agente cuando el trabajo que lo rodea se beneficie de la planificación y la selección de herramientas.
CapSolver puede proporcionar el paso de resolución documentado. Confirma el tipo de tarea actualmente soportado, prueba el flujo de trabajo autorizado completo y trata la aceptación de la aplicación como un resultado separado.
Empieza con la guía oficial de introducción a CAPTCHA y elige la capacidad que coincida con tu desafío real. Mantén la primera prueba lo bastante pequeña como para inspeccionar cada resultado antes de ampliar el uso.
P: ¿Pueden los LLM resolver CAPTCHAs?
Los LLM con capacidades visuales adecuadas pueden resolver algunas tareas CAPTCHA evaluadas. Los resultados dependen del desafío, el modelo, el sistema circundante y la definición de éxito. Una respuesta visual correcta no demuestra automáticamente una verificación exitosa en el sitio web.
P: ¿Un solucionador de CAPTCHA basado en LLM es lo mismo que una API de CAPTCHA?
No. Un LLM es un componente de modelo; una API de CAPTCHA expone una operación de servicio documentada. Un agente puede llamar a esa API sin realizar por sí mismo el reconocimiento de imagen subyacente.
P: ¿Puede un LLM solo de texto resolver un CAPTCHA de imagen?
Un LLM solo de texto no puede inspeccionar directamente la imagen. Necesita un componente separado con capacidad de imagen u otra fuente de información visual, y aun así es necesario evaluar el sistema completo.
P: ¿Debe un agente seguir reintentando hasta que pase un CAPTCHA?
No. Define un presupuesto explícito de intentos y tiempo, y después detente o pide revisión cuando el presupuesto se agote. Los intentos repetidos no deberían ocultar entradas no compatibles o un rechazo de la aplicación.
P: ¿Un benchmark de investigación demuestra que un solucionador funcionará en mi sitio web?
No. Un benchmark describe sus tareas y condiciones evaluadas. Valida la capacidad requerida en tu entorno autorizado y distingue los resultados de reconocimiento de la finalización de la aplicación.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Decide qué entradas de CAPTCHA puede realmente proporcionar tu agente de uso de computadora y cuándo cambiar a la inspección del navegador o solicitar intervención humana.
Gestiona la cancelación de CAPTCHA de MCP en agentes de IA. Detén nuevas llamadas, distingue entre tareas remotas y esperas locales, y evita que resultados tardíos reinicien el trabajo.
