🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Oct 29, 2026
Actualizado Oct 29, 2026 · min de lectura
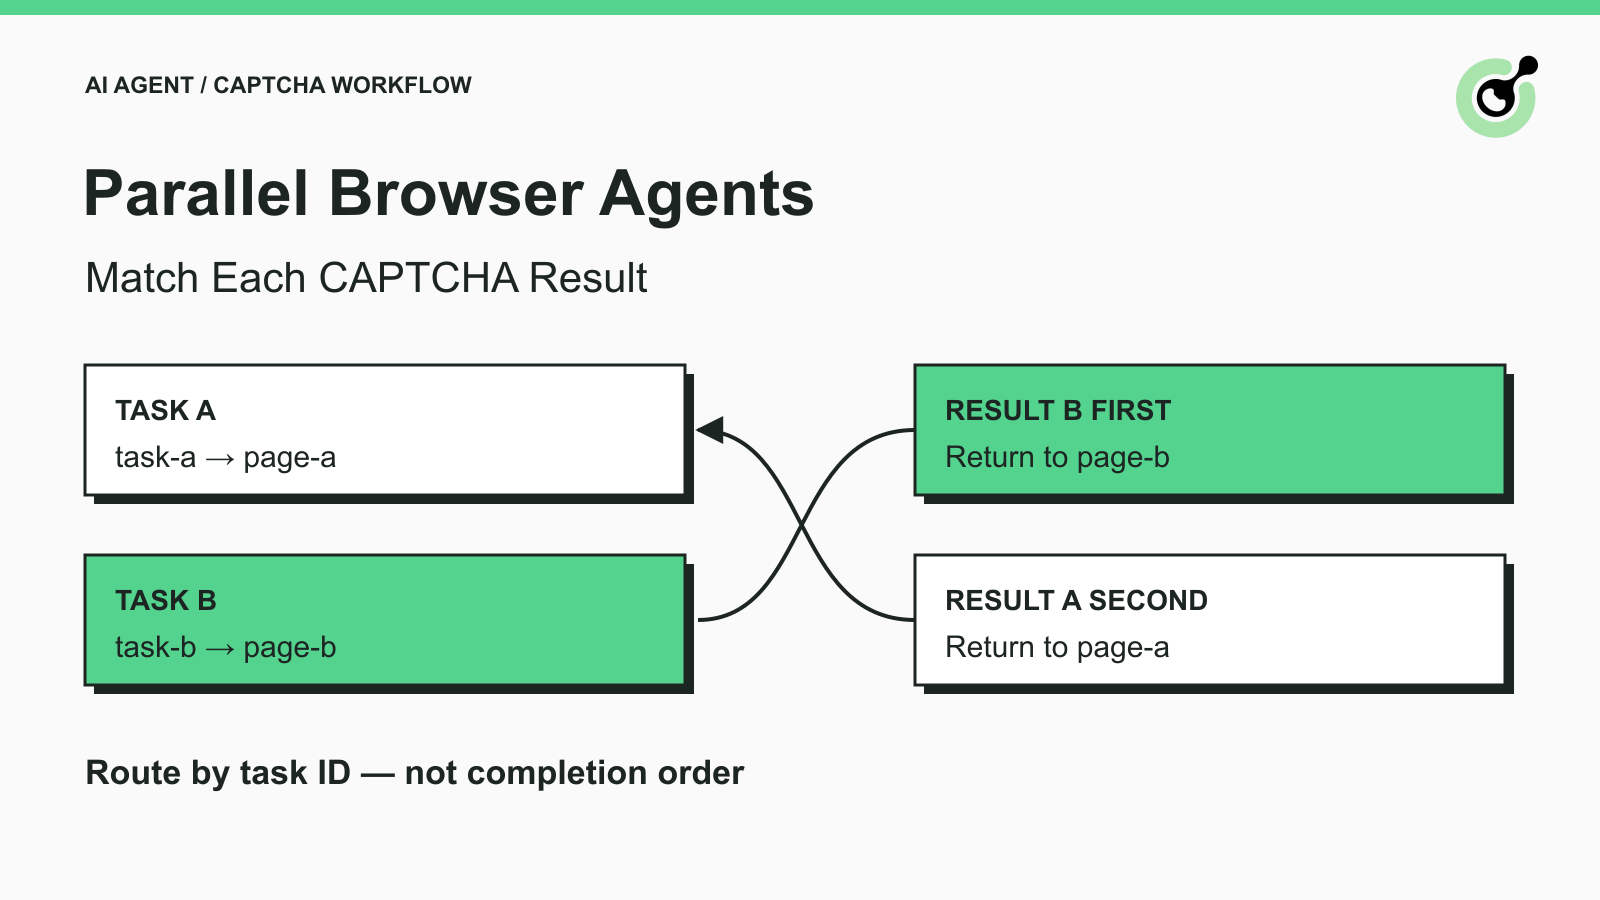
Dos agentes de navegador encuentran CAPTCHAs compatibles durante tareas autorizadas separadas. El agente A comienza primero, pero el agente B recibe un resultado antes. Si la aplicación simplemente asigna el siguiente resultado a la primera pestaña en espera, ambos trabajos pueden verse afectados aunque cada solicitud al solver fuera válida.
Este es un problema de correlación de tareas. Más reintentos no corregirán un resultado entregado a la página equivocada. La aplicación necesita recordar qué elemento de trabajo del navegador creó cada tarea del solver y si ese elemento de trabajo sigue siendo válido cuando llega la respuesta.
CapSolver devuelve identificadores de tarea para trabajo de API asíncrono. Esta guía explica cómo preservar esa asociación entre agentes paralelos, con un pequeño ejemplo local que puedes ejecutar antes de conectar un solver real. No pretende ser un benchmark de concurrencia ni una prueba de éxito de CAPTCHA en producción.
Un agente de navegador debe conservar el trabajo de aplicación, el propietario de la página y el ID de la tarea del solver asociados con un intento.
La API createTask devuelve un taskId para una tarea asíncrona. Guárdalo cuando se acepte esa respuesta de creación. La API getTaskResult recibe ese identificador para recuperar el resultado correspondiente.
Tu aplicación también necesita su propio identificador de elemento de trabajo y una referencia al propietario del navegador. Estos son campos de la aplicación, no parámetros adicionales de solicitud a CapSolver. Una etiqueta de página como page-a en el ejemplo identifica al trabajador que posee la página; no es un handle reutilizable del navegador ni una credencial de API.
Añade una pequeña versión de intento, llamada epoch más abajo. Increméntala cuando una nueva navegación o intento de desafío haga inapropiado un resultado pendiente anterior. Una URL por sí sola es insuficiente: dos trabajos pueden visitar la misma URL y una página puede cargar un estado diferente sin cambiar su dirección.
La documentación de contextos de navegador de Playwright explica el estado aislado del navegador. El aislamiento de contexto y la correlación de tareas resuelven problemas distintos. Las cookies separadas no encaminarán automáticamente los resultados del solver al trabajador correcto.
El orden de finalización describe cuándo llegan los resultados, no qué trabajo de navegador es su dueño.
La documentación de asyncio.as_completed en Python describe cómo procesar objetos esperables conforme terminan. Si tu orquestación usa callbacks basados en orden de finalización, cada resultado debe llevar su propia asociación en lugar de depender de una posición en una lista de páginas en espera.
Trata la creación de la tarea y su enlace como una sola entrega local: valida la respuesta de creación, almacena el ID devuelto con su elemento de trabajo y luego permite la recuperación de resultados. Una implementación basada en callbacks necesita un plan equivalente para resultados que llegan antes de que su enlace local sea visible. No descartes esa carrera como una “página desconocida” para crear inmediatamente otra tarea de pago.
La interfaz de colas de Python puede ayudar a pasar un elemento de trabajo completo entre trabajadores locales. La cola no sustituye al mapeo: lleva el identificador junto con el resultado hasta el propietario de la página.
Acepta un resultado para su entrega solo cuando el ID de tarea sea conocido y el intento registrado siga perteneciendo a la página activa.
Usa un único propietario para actualizar este estado en una aplicación pequeña. En un servicio distribuido, usa almacenamiento duradero y una reclamación atómica o control de concurrencia equivalente. Un diccionario de Python compartido informalmente entre procesos no puede dar esa garantía.
El ejemplo de abajo es un fixture de enrutamiento local, no un método oficial de SDK ni una integración completa con el solver. Usa IDs de tarea inventados y un fixture_marker, que no es un token CAPTCHA ni un campo de solución de CapSolver. Ejecútalo con Python 3; no requiere paquetes de terceros, clave de API, navegador ni solicitudes de red.
def accept_result(reply, pending, current_epochs):
    task_id = reply.get('taskId')
    if not isinstance(task_id, str) or type(reply.get('errorId')) is not int:
        return 'malformed_reply', None
    job = pending.get(task_id)
    if job is None:
        return 'unknown_or_duplicate', None
    if current_epochs.get(job['page_id']) != job['epoch']:
        pending.pop(task_id)
        return 'stale_page', None
    if reply.get('errorId', 0) != 0:
        pending.pop(task_id)
        return 'solver_error', None
    if reply.get('status') != 'ready':
        return 'pending', None
    if not reply.get('solution'):
        pending.pop(task_id)
        return 'missing_solution', None
    pending.pop(task_id)
    return 'ready_for_owner', (job['page_id'], reply['solution'])

pending = {
    'fixture-task-a': {'page_id': 'page-a', 'epoch': 1},
    'fixture-task-b': {'page_id': 'page-b', 'epoch': 1},
}
epochs = {'page-a': 1, 'page-b': 1}
for task_id in ['fixture-task-b', 'fixture-task-a']:
    reply = {'taskId': task_id, 'errorId': 0, 'status': 'ready',
             'solution': {'fixture_marker': task_id}}
    state, target = accept_result(reply, pending, epochs)
    print(task_id, state, target[0] if target else None)
El ejemplo imprime estas dos líneas:
fixture-task-b ready_for_owner page-b
fixture-task-a ready_for_owner page-a
La tarea B termina primero y aun así regresa a la página B. La función entrega deliberadamente el resultado a su propietario sin rellenar ni enviar una página. Sustituye el fixture solo después de tener un parser de resultados específico por tarea, documentado, y una operación de navegador compatible.
Para un trabajador que haga polling, conserva el ID de tarea usado en la solicitud como parte del elemento de trabajo local. Si la respuesta incluye un ID de tarea, verifica que coincida; no uses un ID de respuesta no confiable o no coincidente para reetiquetar la solicitud. El fixture asume que esa asociación ya se ha validado antes de llamar a accept_result.
Canjea tu código de bono de CapSolver
Aumenta tu presupuesto de automatización al instante.
Usa el código de bono CAP26 al recargar tu cuenta de CapSolver para obtener un 5% extra de bono en cada recarga, sin límites.
Canjéalo ahora en tu Panel de CapSolver
Los resultados tardíos o repetidos deben producir un estado explícito, en lugar de aplicarse a cualquier pestaña que esté activa en ese momento.
Marca el intento antiguo como obsoleto cuando su página se cierre, navegue o inicie un desafío de reemplazo. El fixture compara la epoch almacenada con current_epochs; eliminar una página cerrada también hace fallar esa comprobación. No transfieras un resultado antiguo a un nuevo intento solo porque el hostname coincida.
Tu propietario de página debe revisar el intento una vez más inmediatamente antes de usar un resultado entregado. La comprobación del fixture y una acción posterior del navegador son operaciones separadas. Mantener la navegación de la página y la aplicación del resultado bajo el mismo propietario evita que otro trabajador cambie la página entre medias.
Mantén el enlace existente de la tarea mientras el solver informe un estado no terminal. Sigue las indicaciones actuales de documentación de polling de la tarea y el plazo de tu trabajo. Crear una tarea de reemplazo cada vez que un resultado no esté listo puede multiplicar el trabajo pendiente sin resolver la solicitud original.
Registra el fallo en el elemento de trabajo correspondiente. El fixture separa errores del solver, sobres malformados y soluciones ausentes. Un parser de producción debe validar además los campos exactos de la solución para el tipo de tarea elegido; un diccionario no vacío no basta para demostrar un token utilizable.
Reclama la entrega una sola vez. El fixture local elimina un enlace en estado listo, por lo que un duplicado se clasifica como desconocido o duplicado. Los trabajadores en producción necesitan registros terminales duraderos y una política de acuse de recibo si la entrega o la ejecución en el navegador pueden fallar. No uses este ejemplo en memoria como una cola distribuida con entrega exactamente una vez.
Verifica la propiedad correcta y el comportamiento de rechazo antes de sacar conclusiones sobre el rendimiento.
Las comprobaciones locales ejercitaron orden de finalización invertido, una tarea en curso, un ID desconocido, un intento cambiado, una página cerrada, una respuesta de error, una solución vacía, un sobre malformado y una entrega duplicada. Estas comprobaciones pasaron para la función publicada. No probaron resolución real de CAPTCHA, rellenado en el navegador ni aceptación por parte de la aplicación.
Para una prueba autorizada de extremo a extremo, añade las llamadas reales de creación y recuperación de tareas, conserva los resultados sensibles en el trabajador del navegador y confirma el resultado previsto de la aplicación después del paso de resolución documentado. Si la página sigue mostrando un desafío o falta el registro esperado, registra ese resultado por separado de la preparación del solver.
Mantén los registros útiles sin copiar tokens en bruto, cookies o claves de API. Almacena IDs de elementos de trabajo, IDs de tarea, nombres de etapas e información de error saneada. La guía existente sobre timeout de la API trata el comportamiento de espera; la preocupación de este artículo es qué trabajo recibe el resultado final.
El glosario de concurrencias aporta contexto sobre trabajo simultáneo sin implicar una promesa de rendimiento.
Mantén cada resolución compatible unida al elemento de trabajo que la solicitó. CapSolver suministra el resultado del solver; tu aplicación enruta ese resultado, comprueba que el intento siga vigente y verifica la tarea de navegador. Esa separación permite que los agentes en paralelo sigan siendo independientes cuando los resultados llegan desordenados.
P: ¿Pueden dos agentes de navegador compartir una sola variable de tarea pendiente?
Una única variable mutable es insegura si el trabajo posterior sobrescribe la asociación anterior. Almacena un enlace separado para cada tarea de solver activa y su propietario de página.
P: ¿La URL de la página es suficiente para identificar el destino?
No. Pestañas distintas pueden compartir una URL y una página puede cambiar de estado en la misma dirección. Conserva la identidad del elemento de trabajo y una versión vigente del intento.
P: ¿Puedo reutilizar un resultado listo después de que la página navegue?
No asumas que sigue siendo aplicable. Trata el intento antiguo como obsoleto e inspecciona la nueva página antes de decidir cualquier otra resolución permitida.
P: ¿Este ejemplo resuelve o envía un CAPTCHA real?
No. Prueba el enrutamiento local con identificadores inventados y resultados inertes. La resolución de pago y la aceptación por parte de la aplicación requieren pruebas de integración separadas.
P: ¿Es seguro el ejemplo con diccionario en trabajadores distribuidos?
No. Supone un único propietario en un solo proceso. La ejecución distribuida necesita estado de tareas duradero, reclamaciones de entrega atómicas y una política de manejo de fallos.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Leer correctamente los resultados de la herramienta CAPTCHA: distinguir entre errores de transporte, tareas pendientes, salida del solucionador y éxito del navegador antes de permitir que un agente de IA continúe.
Elige una API de CAPTCHA o un MCP para tu agente de IA comparando el control de tareas, el descubrimiento de herramientas, el manejo de resultados y las responsabilidades del navegador antes de integrarlo.