🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Lucas Mitchell
Automation Engineer
已发表 Nov 12, 2026
已更新 Nov 12, 2026 · 最小阅读量
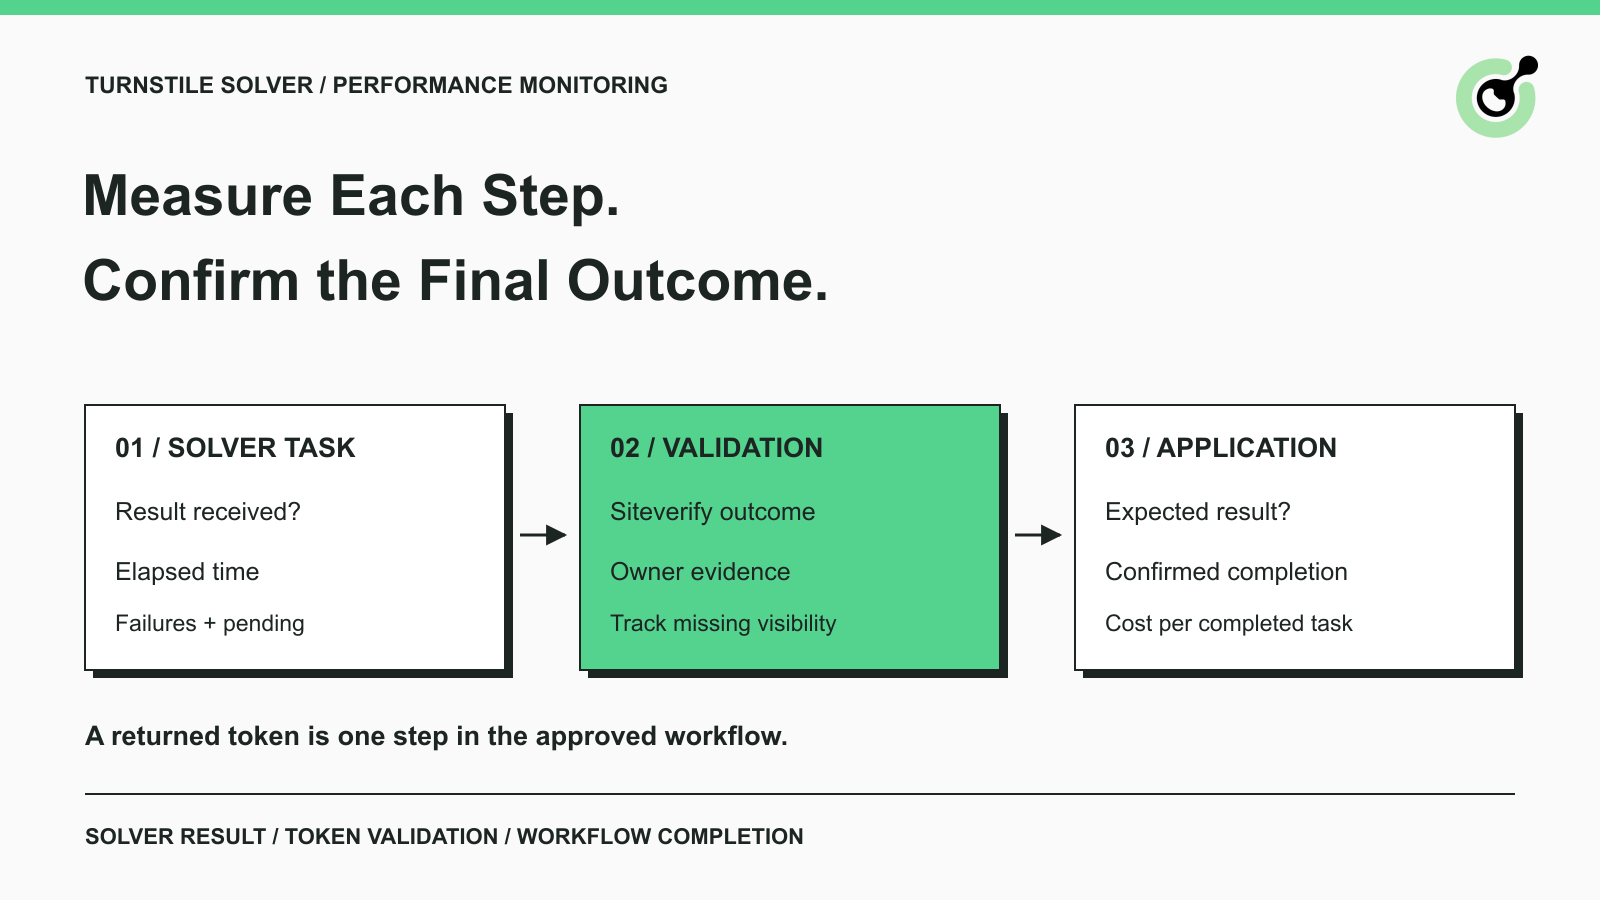
ready 响应才代表求解结果。一个定时浏览器任务拿到了 Turnstile token,但页面从未到达预期的确认界面。求解器控制台一切正常,而运维团队仍在看到失败的任务。他们该信哪一个数字?
两种观察都可能正确。求解器已经返回了结果,但应用并未确认完成。实用的 Cloudflare Turnstile 求解指标会显示这些结果出现分歧的地方。CapSolver 提供求解任务的响应,而你的浏览器流程以及(在可用时)受保护应用的后端则提供剩余的证据。本文说明在既有、已授权的集成中应记录什么,并展示如何用 Python 汇总脱敏日志导出。重点是为 QA 团队和企业自动化服务提供可操作的监控方法,而不假设你能访问第三方网站的私有分析数据。
你的监控范围取决于你是否控制受保护网站、自动化客户端,或两者兼有。
应用所有者可以查看小组件行为、服务端验证,以及应用最终操作。获得批准去跑指定用户路径的自动化服务,可能只能看到自己的求解响应和浏览器结果。在把某个结果标记为“已验证”之前,先与客户确认有哪些后端证据可用。
Cloudflare 的挑战结果分析描述了发出的挑战及其解决情况,包括交互式和非交互式结果。这些都是“小组件层面”的观测,并不是一个关于你的外部 CAPTCHA 求解器接收了多少任务、完成了多少任务的直接报告。
在报表中,将 Turnstile 小组件与整页 Cloudflare 挑战分开。如果团队不确定遇到的是哪个检查点,请先参考这份识别 Turnstile 与 Cloudflare 挑战的指南,再对尝试进行分组。把不同类型挑战混在一起,只会把“工作负载变化”误看成“求解质量变化”。
“求解结果”指标应统计那些返回了预期解答的任务,并使用明确定义的一组提交尝试。
官方的 CapSolver Turnstile API 指南文档了 AntiTurnstileTaskProxyLess,其中 websiteURL 与 websiteKey 是必填参数。可选元数据包括小组件的 action 和 cdata。记录一个安全的配置标识,以便在输入变更后,可以与后续的失败情况进行比较。
CapSolver 使用 createTask 提交任务,用 getTaskResult 获取结果。文档中 Turnstile 结果的特征包括 status: ready 以及 solution.token。只有 taskId 并不代表已完成的解答。结果获取参考解释了你的既有集成应该已经实现的响应处理逻辑。
在监控上,将流程 ID 与求解任务 ID 分开存储。一次获批的浏览器操作可能会创建多个求解尝试。在求解器指标中要单独计数这些尝试,而在流程完成度统计中,只计最初的那次业务操作一次。
为每一批尝试选择一个观测截止时间,并把成功、失败和未决任务一起统计。这里的“批次”指同一组选定的请求,例如在某一小时内提交、并属于同一批准流程的所有任务。
要得到保守的结果率,用该批次中“所有提交的尝试”作为分母,将成功的求解结果作为分子。同时展示未决任务数;在大量任务仍在运行时算出来的结果率只是暂时的。如果你改为计算“已完成任务中的成功率”,请将这个更窄的分母明确标注出来。
根据 CapSolver 文档化的错误响应来对创建失败和结果失败进行归类。被拒绝的配置和求解失败需要不同排查方向。它们都会影响客户端体验,但应该保留各自不同的原因。
“令牌验证”度量的是受保护应用的后端是否通过 Siteverify 接受了 Turnstile token。
Cloudflare 的令牌验证指标统计 Siteverify 请求,以及返回 success: true 或 success: false 的响应。当这些记录可用时,在选定批次中,以“所有验证响应”为分母,“成功响应”为分子进行统计。对没有收到响应的网络失败,单独计数并保持可见。
令牌术语表解释了 token 的一般作用。在本流程里,收到 token 只是中间事件;应用仍然需要验证它,并完成自己的业务操作。
使用一个可观测的应用结果,例如预期的确认页面或请求的受限数据记录。把这一指标标记为“流程已完成”,并注明支持这一判断的证据。
不要从绿色的小组件、HTTP 200 状态码或挑战消失,去推断 Siteverify 的响应。如果客户没有提供验证证据,就把令牌验证标记为“不可用”。清晰标出缺失的观测,比把估算当作实测成功率要更有用。
在给客户的报告中,当最终结果仍未知时,保留最初的失败原因。“求解器返回了 token;在截止时间前未观察到确认”可以帮助下一位工程师快速找到排查起点。
兑换你的 CapSolver 奖励码
立刻提升你的自动化预算!
在给 CapSolver 账户充值时使用奖励码 CAP26,每次充值都可额外获得 5% 奖励金额,不限次数。
现在就前往你的 CapSolver 控制台 兑换
延迟监控应区分:求解等待时间、令牌交接延迟,以及完整流程耗时。
在客户端发送任务请求时启动求解计时器,在客户端收到预期结果或终止失败时停止。这衡量的是客户端观察到的总耗时,包括网络与轮询延迟,而不是求解服务内部处理时间。
从接收到 token 到提交应用请求的间隔要单独统计。一个在求解后还在队列中等待的浏览器任务,即使求解器响应迅速,也可能因为 token 问题而失败。
Cloudflare 的服务端验证参考指出,Turnstile token 有 300 秒有效期,并且为一次性使用。同一参考还解释了验证错误,以及如何检查预期的 hostname 和 action 等字段。你的“接收时间戳”对诊断交接延迟很有用,但不能证明 token 的精确剩余寿命。
对可比的“已完成尝试”,展示中位数和尾部较慢分位(如 p95)。同时标出样本数和超时数。只统计成功的延迟图表,可能会在最慢请求全部超时、被排除在计算之外时看上去“更快”。
保持本地测试、云 Worker、不同页面族群以及集成版本变更之间的可区分性。先对比同一工作流在发布前后的变化,再把问题归因到某个全球服务提供商。
一个有用的“首版控制台”应该让每个指标都能对应到可核查的事件。
| 指标 | 建议定义 | 有助于调查的问题 |
|---|---|---|
| 求解结果率 | 预期求解结果 / 所有提交的求解尝试,并展示未决数 | 请求构造或求解失败 |
| 令牌验证率 | 成功的 Siteverify 响应 / 所有收到的 Siteverify 响应,传输失败单独展示 | 在你运营的应用中发生的验证失败 |
| 流程完成度 | 已确认完成的业务操作 / 所有符合条件且被挑战的业务操作 | 期望的业务任务是否真的完成 |
| 客户端观测到的求解延迟 | 从请求发送到收到结果或失败,按结果类型划分 | 响应慢、轮询与网络影响 |
| 令牌交接延迟 | 从收到 token 到提交应用请求 | 队列或浏览器逻辑导致的 token 使用延迟 |
| 单次完成操作成本 | 可归因的计费求解成本 / 已确认完成的被挑战业务操作 | 未成功尝试和重试对成本的影响 |
这些是“应用层面”的建议定义,而不是声称每个字段都由 CapSolver API 直接提供。只计算你的日志和计费记录所支持的内容。当完成度分母为 0 时,把“单次完成操作成本”标记为不可用,而不是硬算出一个误导性的数字。
Python 可以对你现有求解集成导出的脱敏数据进行汇总,无需发起新的求解请求。
下例只使用 Python 3 标准库,无需安装第三方包或配置 API 凭证。它仅统计你提供的记录;不会收集实时任务、验证 token,也无法单独度量某个服务商的实时表现。
在一个明确的观测截止时刻导出快照。即便任务在 API 返回 task ID 之前创建失败,也要使用内部 attempt_id。在选定的流程批次中,纳入所有尝试,包括创建失败和仍在进行中的任务。不要把每一次轮询响应都当作独立尝试导出。
下列 CSV 字段是“应用报表模式”,并非 CapSolver API 参数:
solver_result:只有在你的集成收到带有预期 token 的成功 ready 结果时才能使用 ready;终止错误用 failed;在快照截止时仍未决的任务用 pending。validation:只有在观察到后端验证响应时才能使用 passed 或 failed。当证据不可用、验证尚未执行或未收到任何响应时,用 unknown。传输错误的具体细节应保留在单独的诊断日志中。workflow_completed:只有在确认了预期应用结果时,才使用 yes。在整个重试过程中使用同一个 workflow_id。将下方示例数据保存为 attempts.csv。这五条记录仅为演示用例,并非真实生产数据或基准结果:
attempt_id,workflow_id,solver_result,validation,workflow_completed
a1,w1,ready,passed,yes
a2,w2,failed,unknown,no
a3,w2,ready,passed,yes
a4,w3,ready,failed,no
a5,w4,pending,unknown,no将以下脚本保存为 summarize_turnstile.py。重复 ID 检查可以防止把重复轮询行的导出静默地算多次。
import csv
import json
import sys
from collections import Counter


def summarize(path):
    with open(path, newline='', encoding='utf-8') as handle:
        rows = list(csv.DictReader(handle))
    seen = set()
    completed = set()
    workflows = set()
    solver = Counter()
    validation = Counter()
    for row in rows:
        attempt = row['attempt_id'].strip()
        workflow = row['workflow_id'].strip()
        if not attempt or attempt in seen or not workflow:
            raise ValueError('Use unique, nonempty attempt IDs and nonempty workflow IDs')
        if row['solver_result'] not in {'ready', 'failed', 'pending'}:
            raise ValueError('Invalid solver_result')
        if row['validation'] not in {'passed', 'failed', 'unknown'}:
            raise ValueError('Invalid validation')
        if row['workflow_completed'] not in {'yes', 'no'}:
            raise ValueError('Invalid workflow_completed')
        seen.add(attempt)
        workflows.add(workflow)
        solver[row['solver_result']] += 1
        validation[row['validation']] += 1
        if row['workflow_completed'] == 'yes':
            completed.add(workflow)

    def percent(numerator, denominator):
        return round(100 * numerator / denominator, 2) if denominator else None

    observed_validation = validation['passed'] + validation['failed']
    return {
        'attempts': len(rows),
        'solver_ready': solver['ready'],
        'solver_failed': solver['failed'],
        'solver_pending': solver['pending'],
        'solver_result_rate_pct': percent(solver['ready'], len(rows)),
        'validation_observed': observed_validation,
        'validation_unknown': validation['unknown'],
        'validation_pass_rate_pct': percent(validation['passed'], observed_validation),
        'workflows': len(workflows),
        'workflows_completed': len(completed),
        'workflow_completion_rate_pct': percent(len(completed), len(workflows)),
    }


if __name__ == '__main__':
    print(json.dumps(summarize(sys.argv[1]), indent=2))
在包含两个文件的目录下运行:
python3 summarize_turnstile.py attempts.csv示例输出为:
{
  "attempts": 5,
  "solver_ready": 3,
  "solver_failed": 1,
  "solver_pending": 1,
  "solver_result_rate_pct": 60.0,
  "validation_observed": 3,
  "validation_unknown": 2,
  "validation_pass_rate_pct": 66.67,
  "workflows": 4,
  "workflows_completed": 2,
  "workflow_completion_rate_pct": 50.0
}
在五次尝试中,有三次产生了求解器结果,因此该样本的求解器结果率为 60%。在观测到的三次验证中,有两次通过,通过率为 66.67%。四个唯一工作流中有两个完成,完成率为 50%。对 w2 的一次失败尝试和一次成功重试算作两次尝试,但只算作一个已完成的工作流。
由于仍有挂起尝试,60% 的结果只是暂时值。待所有未完成的工作结束后重建快照;不要追加一行具有相同 attempt ID 的记录。如果没有任何行,或没有观测到的验证,则对应的比率应为 null,而不是捏造一个 0。
对于时间窗口报表,应先选出工作流,再包含在观测截止时间之前的相关尝试。直接过滤任意的尝试行,可能会漏掉更早的成功或更晚的重试,从而改变工作流分母。单独记录那些从未进入求解器提交阶段的合格工作流计数;这个小脚本无法统计其输入中缺失的操作。
示例中的本地计算无需凭证即可复现。要监控你的服务,可将示例替换为真实集成中已做脱敏处理的记录,并文档化导出的队列定义及观测截止时间。避免在导出中包含 API 密钥、原始令牌、Cookie 或用户表单的原始内容。
在整个过程中始终使用同一批工作流队列,排查第一个结果发生变化的阶段。
如果任务创建错误上升,应先检查配置和凭证,而不是单纯提高重试次数。如果求解器结果保持稳定,但验证失败增多,应检查验证错误类别和令牌交接的时间。如果验证保持稳定,但应用完成率下降,则应检查最终断言、表单响应或允许输出的数据内容。
例如,一个质检服务提供方可能发现:某个客户端的新版在令牌接收和表单提交之间新增了一个后台操作。此时有用的对比,是该客户端在版本发布前后令牌交接延迟和验证结果的变化情况。把所有客户端聚合到一个总体成功率中,会掩盖这一受影响的路径。
将这类场景视作排查路径,而不是因果关系的证据。在修改集成前,先抽查少量具备授权的失败样本及其时间戳。保持重试次数有上限,并保留原始尝试记录,以免重试人为抬高完成计数。
Cloudflare 提供用于受控实现检查的测试 sitekey 和 secret key。使用这些密钥测试你自己的应用在通过和失败分支上的行为。不要把虚拟令牌的测试流量计入真实的求解器性能报表:它们验证的是应用自身行为,而不是生产环境中的求解质量。
避免在监控日志中保存原始解决令牌、API 密钥、Cookie 或不必要的页面内容。工作流标识符、任务标识符、时间戳、结果类别以及安全的配置标签,通常已经是更好的排查起点。
在开始 Turnstile 监控时,先分成三个问题:求解器是否返回结果、在有相应证据时应用是否验证了令牌、以及获批的操作是否完成。
在这些结果有稳定定义之后,再添加时延和成本指标。现有的 CapSolver 集成可以提供求解器任务事件;你的应用提供完成情况的证据。保持这条分界清晰,有助于排障和面向客户的报告,而无需搭建过于庞大的监控系统。
问:我首先应该跟踪哪些 Cloudflare Turnstile 求解器指标?
优先跟踪求解器结果率、工作流完成率以及客户端观测到的结果时间。若你运营受保护的后端,或已获授权访问其日志,则再加入 Siteverify 验证结果的统计。始终展示失败和未解决的尝试。
问:一个就绪的 CapSolver 任务是否意味着网站已经接受了令牌?
不是。具有预期令牌的就绪任务仅表明求解器产生了结果。网站验证以及最终的应用操作是后续事件,需要各自单独的证据。
问:我能在自己不运营的网站上衡量令牌验证的成功率吗?
只有在站点所有者提供了授权的验证证据时才行。否则,就报告你可以观测到的浏览器端结果,并标记后端验证状态为不可用。
问:为什么在求解器快速响应后 Turnstile 验证仍然可能失败?
令牌复用、延迟提交或实现问题仍可能导致验证失败。检查实际错误信息和应用的时间安排;快速交付令牌并不能说明后续每一步都没有问题。
问:示例中的成功率是否代表性能承诺?
不是。示例数值只是用来说明不同的分母。应在可比条件下对你被授权的工作流进行度量,并将测试密钥流量与生产观测流量区分开来。
Lucas Mitchell
Automation Engineer
Helping browser automation recover and continue.
关于作者