🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Nikolai Smirnov
Software Development Lead
已发表 Oct 26, 2026
已更新 Oct 26, 2026 · 最小阅读量
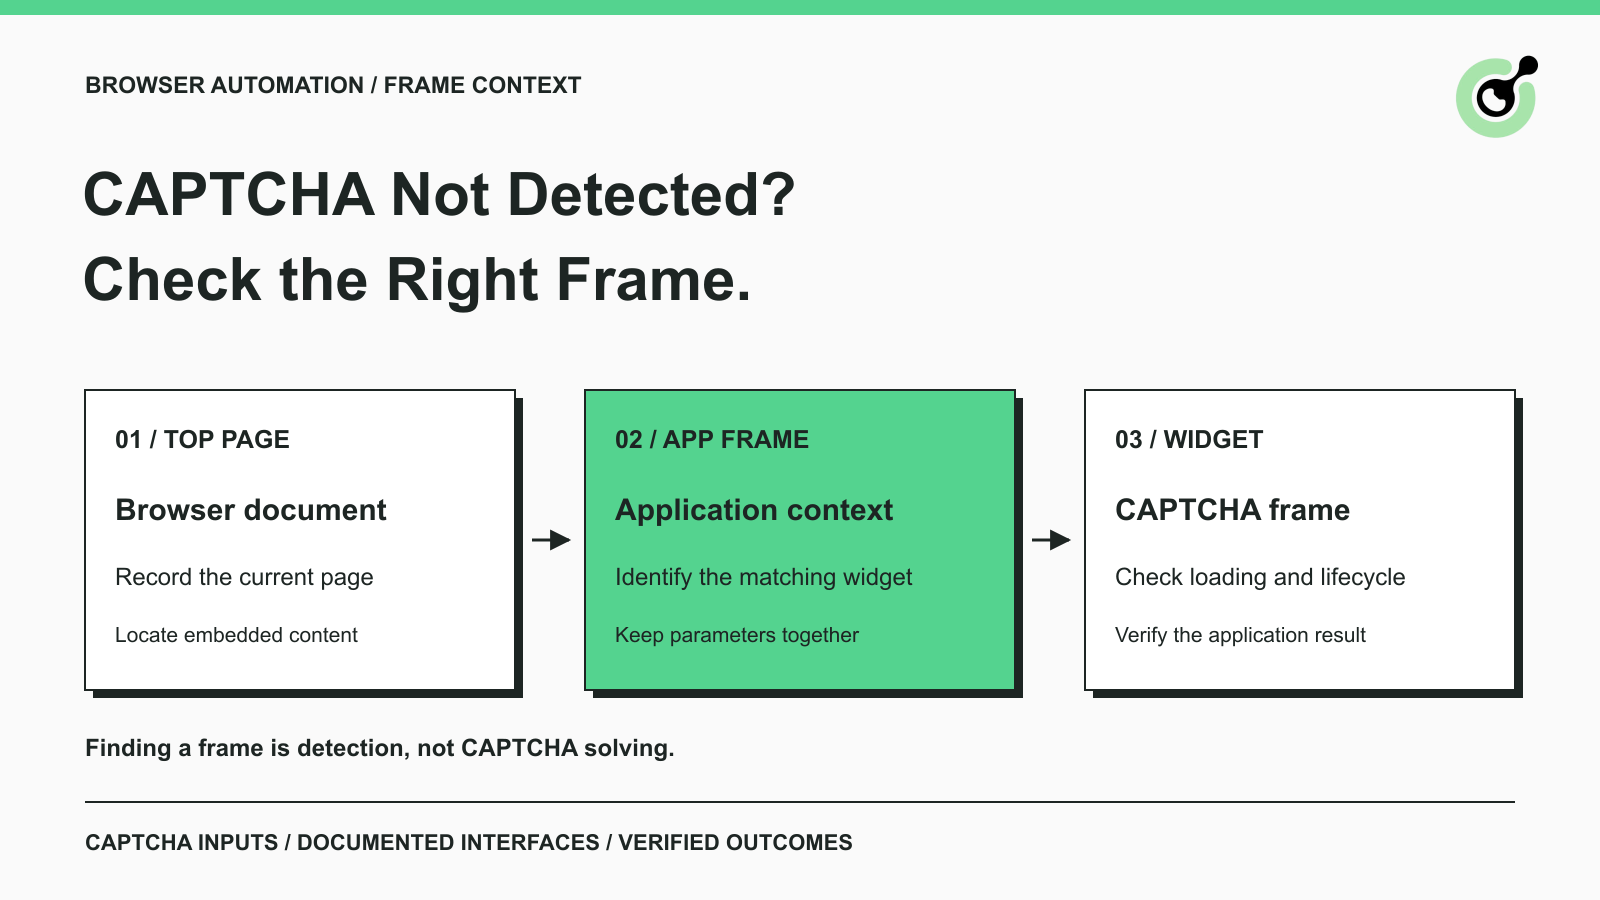
浏览器截图显示有 CAPTCHA,但自动化脚本报告没有找到小部件。下一步通常要检查的是文档上下文。在顶级页面上执行的选择器不会自动搜索所有嵌入文档,而当某个 frame 属于另一个 origin 时,普通页面 JavaScript 会受到访问限制。
在向 CapSolver 提交请求之前,先搞清楚是哪一个页面“拥有”这个挑战,以及相关参数来自哪里。本文介绍这一检查步骤,而不依赖脆弱的内部选择器,也不把浏览器对 frame 的访问当作挑战已被解决的证据。
可见的 CAPTCHA 之所以会被漏检,是因为视觉组合和文档结构是两回事。
浏览器会把多个文档绘制到同一个窗口里。自动化脚本仍然需要针对包含目标元素的那个文档。顶级页面可能嵌入了一个应用,而该应用又可能通过另一个 frame 来渲染 CAPTCHA。
浏览器的 同源策略 会限制页面 JavaScript 对跨源内容的读取。运行在父文档中的脚本因此可能无法直接检查子文档。这个限制不同于选择器写错或者求解器不可用。
把 CAPTCHA 检测 当作一个明确的观察行为。截图只能证明有某个类似小部件的东西是可见的;通过 frame 查找只能证明存在一个嵌入文档。这两者中的任意一个单独存在,都不足以提供求解任务所需的完整、当前参数。
在修改 API 载荷或增加重试次数之前,先绘制文档层级结构。
从浏览器的顶级 URL 开始。找出嵌入的应用 frame,以及其中的 CAPTCHA 小部件。记录哪个文档包含应用表单,哪个 frame 渲染小部件,以及应用从哪里接收验证结果。
对典型的嵌入式流程来说,关键区别在于应用 frame 和提供方小部件 frame 之间。应用拥有用户试图完成的任务。提供方 frame 中可能包含其自身的渲染资源和控件。把提供方 frame 的资源 URL 复制到每一次求解请求中,并不能可靠地替代“识别哪个页面在使用该 CAPTCHA”这个步骤。
以相关的任务参数为权威依据,了解求解器究竟期望什么。若嵌入方式让正确的页面上下文变得不明确,就检查应用的真实配置,或用脱敏示例求助支持团队。不要从一张截图中推导出一个所谓“通用 URL 规则”。
保持检测到的 sitekey、CAPTCHA 类型、页面上下文,以及任何任务特定必需字段,统一归属到同一个小部件实例上。
页面中可能包含多个表单或小部件。从无关 frame 读出的 key 看上去可能是有效的,却描述了错误的挑战。在导航或小部件更换之后,重新执行相关检查,而不是复用旧文档中的数据。
这也是为什么在顶级文档中搜索为空时,不应立刻触发求解。先要确认挑战是否出现在其他 frame 中、仍在加载中,或在当前状态下根本不存在。
使用浏览器自动化库提供的 frame 控制功能,而不是强迫父页面的 JavaScript 去读取不同 origin 的内容。
Playwright 的 frame 文档区分了页面级交互与 frame 内的交互。Frame locator 允许测试脚本访问嵌入文档中的内容。应根据在页面上可验证的稳定属性选择 frame,而不是依赖它在列表中的数字位置。
Selenium 则使用不同的交互模型。其 frame 文档介绍了如何将驱动的上下文切换到某个 frame,以及如何返回默认文档。若测试一直停留在 CAPTCHA frame 中,之后可能就找不到位于其外部的应用提交按钮。
这些都是文档导航机制,它们本身并不会提供 CAPTCHA 解答。保持 frame 检查、求解请求和应用流程继续这三步相互独立,这样一旦失败就能清楚地定位问题所在。
兑换你的 CapSolver 奖励码
立刻提升你的自动化预算!
在为 CapSolver 账户充值时使用奖励码 CAP26,每次充值即可额外获得 5% 奖励——无次数限制。
现在就前往你的 CapSolver 控制台 进行兑换。
在解读“未找到结果”之前,先确认相关文档和小部件是否加载完毕。
frame 元素本身可能已经存在,而其内容仍未就绪。应用还可能在路由变化后替换某个 frame,或在上次尝试之后刷新小部件。先前捕获的引用此时就可能指向一个已不再代表当前可见挑战的上下文。
使用与应用相关的就绪条件:目标 frame 已存在,预期文档已加载完毕,以及相关 CAPTCHA 配置已经可用。到处盲目增加 sleep 只会让测试更慢,并不能证明这些条件被满足。
reCAPTCHA 识别指南能帮助在选择任务之前区分各个变体。把这一步识别与当前 frame 上下文结合使用,而不是根据可见方框的大小或位置来猜测变体。
如果提供方脚本本身加载失败,就应调查加载失败的原因。基于不完整或过期页面数据构造求解请求,并不是修复“小部件脚本缺失”的正确方案。
通过与你的工作流相匹配的求解器接口传递输入,并验证该接口对 frame 的支持情况,而不要想当然。
Core SDK 指南记录了受支持的浏览器集成方式和 CAPTCHA 信息获取方法。遵循已安装版本的契约。某个方法接受 page 对象,并不意味着它在文档中被说明也能接受任意 frame、封装对象、远程句柄或浏览器库对象。
如果你改用 REST API,则应从被允许访问的页面及其配置中收集与对应任务文档匹配的字段。保持 URL、公共 sitekey 与挑战变体之间的原始关联。不要因为字段名字相同,就混用不同标签页里收集来的值。
对于以 token 作为结果的场景,应用侧的集成仍然是必需环节。返回的 token 必须在其有效期内进入正确的应用流程。若结果被写入到无关文档中,或在 frame 重新加载时被丢弃,都不能视为成功。
避免把编辑提供方小部件内部结构作为通用技术手段。内部标记结构可能变化,仅仅找到一个 textarea 或按钮,并不能告诉你应用的文档化验证流程是怎样的。对于你需要的操作,应优先使用官方求解接口和应用接口。
在工作流继续执行的上下文中验证应用结果。
在完成预期的 CAPTCHA 操作后,如果你的框架更改过上下文,先返回到应用文档。检查任务所期望的具体结果,例如所属表单的确认状态。不要把“找到了 iframe”“拿到一个非空 token 字符串”“点过一个按钮”当作等同于应用接受。
为了获得有用的失败记录,应捕获顶级 URL、相关 frame 关系、CAPTCHA 类型、失败的阶段,以及脱敏后的错误描述。不要包含会话密钥和无关页面内容。
这样一份简要记录就能让队友区分 frame 选择错误、加载问题、参数不匹配、求解失败以及应用侧拒绝等不同情形。每种情形需要不同的修复方式。
在反复尝试求解之前,先理清文档上下文。CapSolver 需要的输入和浏览器集成信息,必须准确描述实际挑战。清晰的 frame 结构图能让这些输入更易于验证,并将检测阶段与最终应用结果区分开来。
问:document.querySelector 会搜索所有 iframe 吗?
不会。查询仅在其当前文档上下文中执行。若目标元素属于嵌入文档,请使用自动化框架的 frame 功能。
问:websiteURL 应该是 CAPTCHA iframe 的 src 吗?
不一定。提供方的资源 URL 并不必然是实际使用 CAPTCHA 的页面。请遵循对应任务文档,并核实应用上下文。
问:为什么 Selenium 能找到小部件,却之后找不到表单按钮?
很可能驱动仍处在 frame 上下文中。检查哪个文档拥有该表单按钮,在交互前使用文档化的上下文切换操作。
问:找到 sitekey 就说明 CAPTCHA 已经被解决了吗?
不是。公共 sitekey 只是标识 CAPTCHA 配置的输入参数。检测、求解,以及应用对结果的验证,是三个独立阶段。
问:页面 SDK 的方法是否总能接受 frame 对象?
不会。只传入文档中明确说明受支持的对象类型。方法表面看起来相似,并不能说明一定兼容。
Nikolai Smirnov
Software Development Lead
Building dependable software for complex automation.
关于作者