🎉全新面向 AI Agent 的 CapSolver-MCP、agent 工具和 SDK 集成
Adélia Cruz
MCP Integration Engineer
已发表 Sep 29, 2026
已更新 Sep 29, 2026 · 最小阅读量
大型语言模型可以将不一致的网页内容转化为有用记录,但它们不会消除获取可信页面数据所需的操作工作。生产流程仍需要权限检查、请求限制、JavaScript所需的浏览器执行、对验证检查点的显式处理,以及在记录到达数据库前的确定性验证。
GLM-5.3 在解释层非常有用。其API兼容的工作流可以分类渲染内容、将文本映射到模式、解释字段缺失的原因,并帮助归一化页面间的差异。对于遇到受支持验证任务的授权自动化,CapSolver 可以在提取前放置,同时应用保留对页面会话的控制并验证最终结果。
本指南提供了一个通用架构,而不是针对特定网站的说明。仅用于公共或授权数据,并在工作流达到登录、支付、个人数据或权限边界时停止。
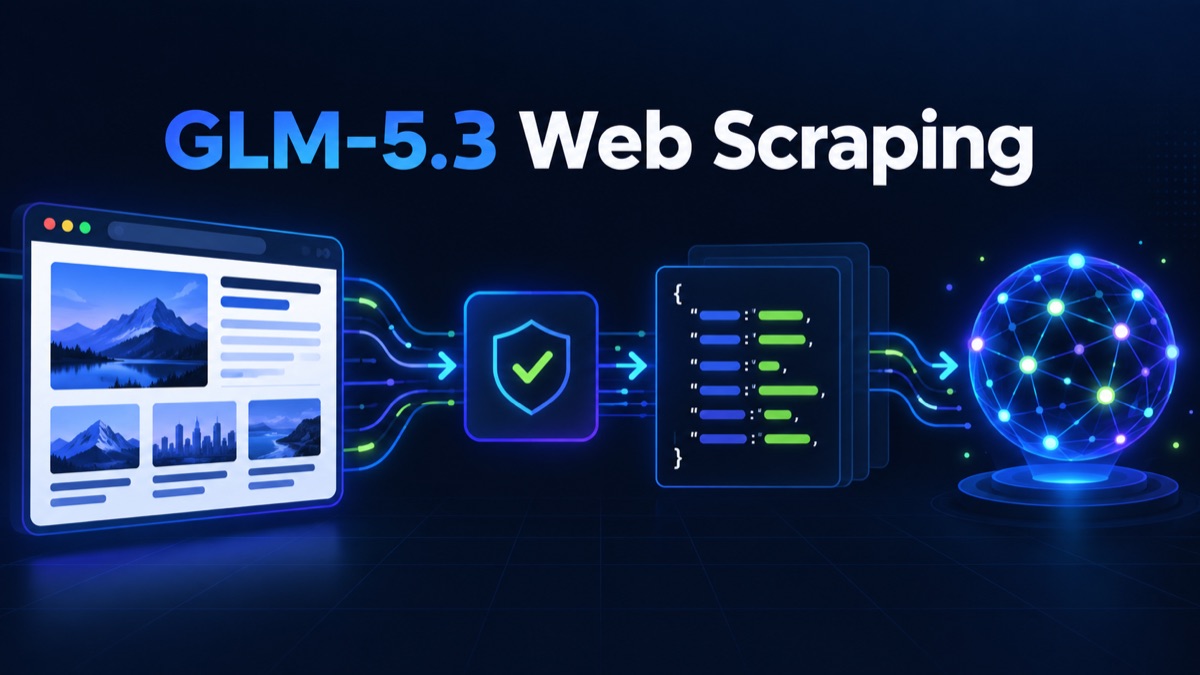
一个强大的GLM-5.3网页抓取系统使用一系列小阶段。每个阶段生成下一个阶段可验证的类型化结果。
| 阶段 | 责任 | 预期输出 | 停止条件 |
|---|---|---|---|
| 权限网关 | 检查目标、数据范围、速率和目的 | 批准的工作定义 | 范围未授权 |
| 访问层 | 获取或渲染页面 | 状态、标头、最终URL、HTML或截图 | 登录、支付、私有数据或访问被拒绝 |
| 响应分类器 | 识别内容、空壳、速率限制或验证页面 | 命名页面状态 | 未知或不支持的状态 |
| 验证适配器 | 在允许时提交一个文档任务 | 准备就绪、处理中或终端错误 | 截止时间或尝试预算已用完 |
| GLM提取 | 将允许内容转换为严格模式 | 候选JSON记录 | 输出无效或无证据支持 |
| 确定性验证 | 检查类型、必填字段、重复项和源证据 | 接受的记录或显式拒绝 | 任何业务规则失败 |
| 存储 | 执行幂等写入 | 稳定记录ID和跟踪链接 | 源键已存在且无新版本 |
最重要的边界是访问和解释之间。如果模型接收挑战页面的HTML,它可能会自信地将该页面描述为目标内容。在提示模型之前分类响应。
编排示例使用Python 3.11或更高版本和requests包。将凭证保存在环境变量中,永远不要在源代码、提示、日志、截图或提交的配置中包含它们。
python -m venv .venv
source .venv/bin/activate
pip install requests

export ZAI_API_KEY="replace-with-your-z-ai-key"
export CAPSOLVER_API_KEY="replace-with-your-capsolver-key"
官方Z.ai API文档使用https://api.z.ai/api/paas/v4/chat/completions的聊天完成端点。在部署前确认GLM-5仓库或Z.ai控制台中的当前模型标识符;本指南使用glm-5.3-flash作为环境可配置的默认值。
不要要求模型“提取所有重要内容”。在收集页面前定义字段、允许的空行为和证据要求。
from dataclasses import dataclass
from datetime import datetime, timezone
from typing import Any

@dataclass(frozen=True)
class ExtractionJob:
    source_url: str
    allowed_host: str
    required_fields: tuple[str, ...]
    max_input_chars: int = 40_000

def validate_record(job: ExtractionJob, record: dict[str, Any]) -> dict[str, Any]:
    missing = [name for name in job.required_fields if not record.get(name)]
    if missing:
        raise ValueError(f"missing_required_fields:{','.join(missing)}")
    if record.get("source_url") != job.source_url:
        raise ValueError("source_url_mismatch")
    record["validated_at"] = datetime.now(timezone.utc).isoformat()
return record模型仅在模式显式允许时才允许返回null。必填值必须通过普通代码与页面证据确认。
访问层应返回一个小状态对象,而不是仅返回HTML字符串。分类器可以使用状态码、最终URL、内容类型、预期选择器和已知检查点标记。
from enum import Enum

class PageState(str, Enum):
    CONTENT = "content"
    JAVASCRIPT_REQUIRED = "javascript_required"
    RATE_LIMITED = "rate_limited"
    LOGIN_REQUIRED = "login_required"
    VERIFICATION = "verification"
    UNKNOWN = "unknown"

def choose_action(state: PageState) -> str:
    return {
        PageState.CONTENT: "extract",
        PageState.JAVASCRIPT_REQUIRED: "render_in_authorized_browser",
        PageState.RATE_LIMITED: "back_off",
        PageState.LOGIN_REQUIRED: "stop_for_operator",
        PageState.VERIFICATION: "evaluate_supported_task",
        PageState.UNKNOWN: "stop_for_review",
    }[state]
HTTP 403和HTTP 429不应进入通用重试循环。被拒绝的请求需要权限和配置审查。速率限制的请求需要全局并发减少,并尊重服务器提供的重试窗口。
CapSolver的官方API使用createTask提交文档任务。异步任务通过getTaskResult检查。应用必须从当前任务文档中选择任务类型,并仅传递该允许检查点所需的字段。
import os
import time
import requests

CAPSOLVER_BASE = "https://api.capsolver.com"

def solve_supported_task(task: dict, *, timeout_seconds: int = 45) -> dict:
    api_key = os.environ["CAPSOLVER_API_KEY"]
    created = requests.post(
        f"{CAPSOLVER_BASE}/createTask",
        json={"clientKey": api_key, "task": task},
        timeout=15,
    ).json()
    if created.get("errorId") != 0:
        raise RuntimeError(created.get("errorCode", "create_task_failed"))
    if created.get("status") == "ready":
        return created["solution"]

    task_id = created.get("taskId")
    if not task_id:
        raise RuntimeError("missing_task_id")

    deadline = time.monotonic() + timeout_seconds
    while time.monotonic() < deadline:
        time.sleep(3)
        result = requests.post(
            f"{CAPSOLVER_BASE}/getTaskResult",
            json={"clientKey": api_key, "taskId": task_id},
            timeout=15,
        ).json()
        if result.get("errorId") != 0:
            raise RuntimeError(result.get("errorCode", "task_failed"))
        if result.get("status") == "ready":
            return result["solution"]
        if result.get("status") not in {"idle", "processing"}:
            raise RuntimeError("unexpected_task_status")

    raise TimeoutError("verification_task_deadline_exceeded")
调用者应默认仅允许一次有限尝试。返回的解决方案必须通过同一浏览器上下文中检测到的文档集成路径应用。如果页面未过渡到预期状态,请返回失败或请求人工审查。
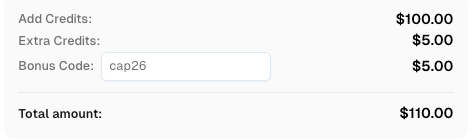
使用您的CapSolver奖金代码
立即提升您的自动化预算!
在充值CapSolver账户时使用奖金代码 CAP26,每次充值可获得额外 5% 奖金 —— 无限制。
立即在您的 CapSolver仪表板 中兑换
一旦页面确认为内容,移除导航噪音、脚本、隐藏元素、重复横幅和无关页面装饰。保留标题、标签、表格和源引用。不要发送浏览器cookie、授权标头、个人数据或原始会话跟踪到模型。
import json
import os
import requests

ZAI_ENDPOINT = "https://api.z.ai/api/paas/v4/chat/completions"

def extract_with_glm(job: ExtractionJob, normalized_text: str) -> dict:
    prompt = {
        "source_url": job.source_url,
        "required_fields": list(job.required_fields),
        "rules": [
            "返回一个JSON对象,不要有散文。",
            "仅使用页面文本中存在的证据。",
            "不要推断缺失的必填值。",
            "按提供的格式包含source_url。",
        ],
        "page_text": normalized_text[: job.max_input_chars],
    }
    response = requests.post(
        ZAI_ENDPOINT,
        headers={
            "Authorization": f"Bearer {os.environ['ZAI_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "model": os.getenv("GLM_MODEL", "glm-5.3-flash"),
            "messages": [
                {"role": "system", "content": "提取有证据支持的结构化数据。"},
                {"role": "user", "content": json.dumps(prompt, ensure_ascii=False)},
            ],
            "temperature": 0,
        },
        timeout=60,
    )
    response.raise_for_status()
    content = response.json()["choices"][0]["message"]["content"]
    return json.loads(content)
将示例视为适配器边界。在生产使用前在官方Z.ai文档中确认当前请求选项和结构化输出功能。如果模型在Markdown中包装JSON或返回合同外的文本,请拒绝响应,而不是尝试静默修复。
需要两种不同的验证。
首先,验证浏览器结果。确认最终URL、预期标题、目标容器和无新错误的缺失与预期工作流匹配。成功的任务响应本身并不能证明页面继续。
其次,验证提取记录。检查必填字符串、数值范围、日期、归一化URL、重复键和证据片段。对于高影响字段,将值与确定性选择器或页面的第二个独立表示进行比较。
def run_extraction(job: ExtractionJob, state: PageState, page_text: str) -> dict:
    action = choose_action(state)
    if action != "extract":
        raise RuntimeError(f"page_not_ready_for_model:{action}")
    candidate = extract_with_glm(job, page_text)
    return validate_record(job, candidate)
此最终关卡可防止挑战页面、模型幻觉或部分渲染进入数据集作为成功抓取。
记录跟踪ID、来源URL、最终URL、页面状态、内容哈希、模型名称、提示版本、模式版本、验证结果和处理时间。存储任务ID和错误代码用于短期操作调试,但不要存储解决方案令牌、秘密或无关会话数据。
在整个任务上应用一个预算。计算HTTP尝试次数、浏览器导航、验证尝试、GLM调用、输入字符和经过时间。当预算耗尽时,返回类型化失败,而不是允许一个组件重新启动工作流。
有用的指标集包括:
| 症状 | 可能原因 | 正确操作 |
|---|---|---|
| GLM返回验证页面的详细信息 | 在提示前未分类响应 | 停止模型调用并修复页面状态检测 |
| JSON解析但必填字段为空 | 提示或源证据不完整 | 拒绝记录并检查归一化内容 |
| 任务就绪但页面仍被阻止 | 浏览器上下文或任务参数不匹配 | 比较URL、会话、用户代理、时间和文档要求 |
| 成本上升但接受记录保持不变 | 浏览器或模型升级过于广泛 | 添加确定性过滤器和每任务预算 |
| 重试后出现重复行 | 存储不是幂等的 | 按稳定来源键和内容版本进行插入或更新 |
| HTTP 429重复 | 并发控制按工作线程而非全局 | 引入共享速率预算并遵守重试指南 |
GLM-5.3可以使网页数据提取更灵活,但可靠性来自周围的系统。保持访问控制、渲染、页面状态分类、验证处理、模式验证和存储为显式阶段。在应用确认其正在查看目标内容后,仅使用模型。
对于具有受支持验证任务的授权浏览器工作流,CapSolver 可提供文档任务边界。应用仍需负责权限、会话连续性、有限重试、秘密处理和证明原始工作流完成。
Q: GLM-5.3 能否在网页抓取中替代浏览器?
不能。它能够解析文本、截图或标准化记录,但浏览器或 HTTP 客户端仍需负责导航、渲染、状态、权限和最终结果验证。
Q: 是否应直接将原始 HTML 发送给 GLM-5.3?
通常不应如此。首先对响应进行分类,移除脚本和重复的布局噪声,保留有意义的标签和结构,并将输入限制在提取模式所需的数据范围内。
Q: 何时应调用 CapSolver?
仅在检测到受支持的任务且处于允许的工作流中时调用。使用当前记录的任务类型,保留所需的浏览器上下文,设置截止时间,并验证页面实际继续运行。
Q: 有效的 JSON 是否意味着提取的记录是正确的?
不。JSON 语法不能证明事实准确性。仍需在代码中检查必填字段、类型、URL、日期、数值范围、重复项和来源证据。
Q: 当页面状态未知时应如何处理?
停止并请求审核。不要将未知内容发送给模型,或通过额外的浏览器和验证步骤重试。
Q: 此设计能否用于私有或受限数据?
该设计不会创建权限。仅用于公共或已授权的数据,尽量减少收集的信息,并遵守适用的条款、合同和法律。
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
关于作者