🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Sep 21, 2026
Atualizado Sep 21, 2026 · minutos de leitura
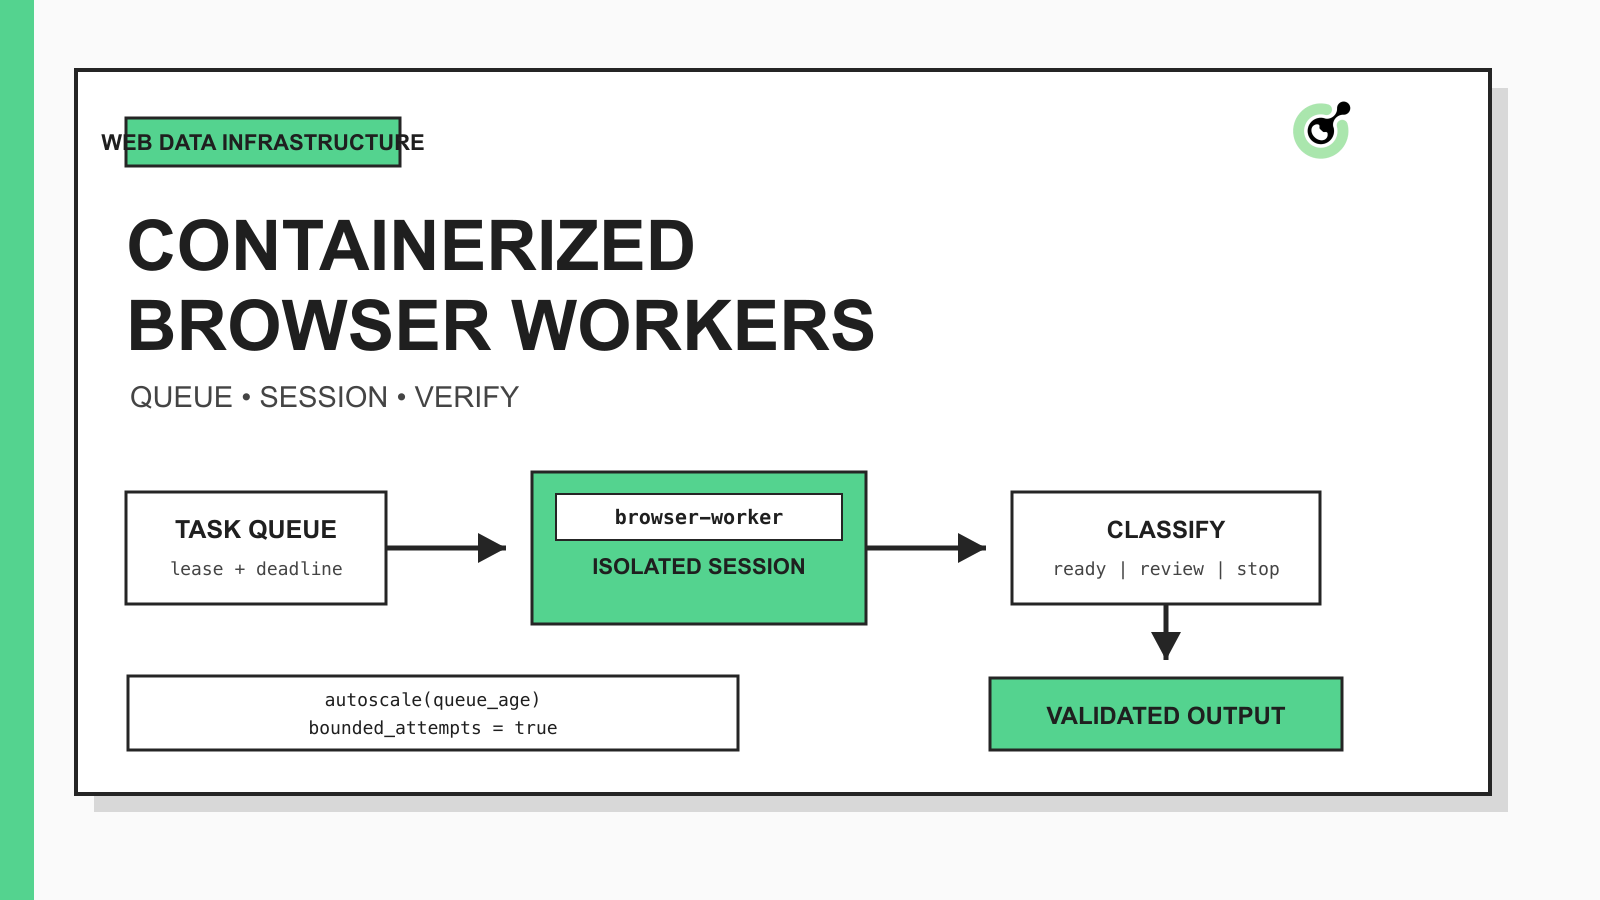
Containers como Serviço (CaaS) fornece uma maneira gerenciada para uma equipe implantar, executar e escalar workers contêinerizados. Para raspagem de web, isso geralmente significa embalar um navegador ou worker HTTP uma vez, alimentá-lo com tarefas de uma fila e aumentar a quantidade de workers conforme a demanda muda. O runtime se torna repetível, enquanto a plataforma cuida de grande parte da agendamento, verificação de saúde e trabalho de ciclo de vida.
Essa definição tem uma fronteira importante: CaaS escala execução, não correção. Cem containers saudáveis ainda podem retornar cem páginas de desafio, duplicar a mesma submissão ou analisar um documento de erro como dados de produto. Portanto, o design precisa de um contrato de tarefa estável, um modelo de estado do navegador, um caminho de desafio limitado e um validador após a extração.
Quando um fluxo autorizado atinge um passo de verificação suportado, CapSolver pode fornecer a tarefa de resolução documentada enquanto o worker permanece responsável pela continuidade da sessão, prazos, aplicação do resultado e verificações finais de estado de negócio.
Um pipeline de raspagem de web com CaaS confiável separa orquestração de acesso à web. Cada estágio tem uma pequena responsabilidade e emite um resultado tipado em vez de um sinal ambíguo de sucesso.
| Etapa | Entrada | Operação | Saída | Condição de parada |
|---|---|---|---|---|
| Scheduler | URL autorizada e política | Criar uma tarefa idempotente | ID da tarefa e prazo | Escopo inválido ou prazo expirado |
| Fila | Registro da tarefa | Atribuir trabalho a um worker | Proprietário da concessão e tentativa | Concessão não pode ser adquirida |
| Worker de navegador | Tarefa mais referência de sessão | Navegar e observar | Evidência da página e classificação | Orçamento de navegação ou política esgotado |
| Handler de desafio | Registro de desafio elegível | Executar um fluxo de tarefa documentado | Resultado de resolução tipado | Tipo não suportado ou limite de tentativas excedido |
| Extrator | Evidência da página aceita | Analisar campos necessários | Registro estruturado | Campos necessários ausentes |
| Validador | Registro estruturado e evidência | Verificar schema e regra de negócio | Registro aceito ou rejeitado | Falha na validação |
Essa divisão também torna o autoscaling mais seguro. O orquestrador pode adicionar workers sem dar a cada worker permissão para mudar escopo, criar tarefas de desafio ilimitadas ou gravar diretamente em sistemas downstream.
Um worker de navegador contêinerizado precisa de um contrato de tarefa durável antes de precisar de um autoscaler. No mínimo, armazene o ID da tarefa, o alvo autorizado, a versão da política, o horário de criação, o prazo absoluto, a referência da sessão, o estágio atual, a contagem de tentativas e a chave de idempotência fora do container.
O contrato deve explicitar três decisões:
Contêineres são descartáveis. Cookies, referências de estado de armazenamento, capturas de tela, rastreamentos e histórico de tarefas não são. Armazene esses artefatos em um sistema durável aprovado e passe referências através da fila. Playwright documenta que contextos de navegador isolam cookies, armazenamento local e outro estado, o que torna um contexto por tarefa licenciada um padrão útil. Se o fluxo reutilizar intencionalmente autenticação, proteja o estado de armazenamento como credencial e nunca o embale na imagem.
Um worker de navegador deve processar uma tarefa licenciada por vez e fechar seu contexto de navegador antes de reconhecer a mensagem da fila. Isso mantém a propriedade da sessão clara e evita que cookies ou estado em memória vazem entre trabalhos não relacionados.
A imagem deve conter apenas o runtime, dependências do navegador, código do worker e padrões não secretos. Injete chaves de API e credenciais de armazenamento em tempo de execução a partir do gerenciador de segredos da plataforma. Fixe as versões do navegador e bibliotecas, e reconstrua através de uma liberação controlada, em vez de instalar pacotes arbitrários quando uma tarefa começa.
Use três sinais de saúde:
Não trate uma sonda de saúde bem-sucedida como prova de que uma tarefa de página foi bem-sucedida. Saúde descreve o processo do worker; evidência da tarefa descreve o fluxo da web.
A classificação da página deve ocorrer antes de qualquer analisador ou gravação downstream. O status HTTP sozinho é insuficiente porque uma resposta pode retornar 200 enquanto exibe um formulário de login, página de desafio, tela de consentimento ou erro de aplicação.
Colete um conjunto de evidência limitado do mesmo contexto de navegador: URL final, status da resposta, título do documento, marcadores DOM selecionados, referência de captura de tela, erros do console e presença de campos necessários. Roteie a tarefa para um dos pequenos conjuntos de estados, como pronto, desafio, autenticação necessária, erro repetível, erro terminal ou necessita de revisão.
A camada de classificação não deve adivinhar como resolver cada obstáculo. Ela apenas identifica o estado observado e passa um registro tipado para o próximo componente autorizado. Essa é a mesma separação descrita no guia do CapSolver sobre a pilha de infraestrutura de automação web para agentes de IA: o runtime do navegador possui sessões e evidência, enquanto o tratamento de desafio é uma camada controlada.
O tratamento de CAPTCHA deve ser uma ramificação opcional, não um loop de tentativa geral. O worker primeiro verifica se o alvo e o desafio estão dentro da política aprovada, se o tipo de tarefa é suportado, se a sessão do navegador ainda é válida e se há tempo restante antes do prazo absoluto.
O fluxo documentado do CapSolver usa createTask para criar uma tarefa suportada e getTaskResult para resultados assíncronos. Revise o fluxo createTask e polling de resultados oficial para os campos de solicitação atuais e regras de tipo de tarefa. Mantenha o ID da tarefa retornado em estado durável para que um worker reiniciado faça polling da tarefa conhecida em vez de criar outra.
Use um orçamento que sobreviva a reinícios:
Se o tipo de desafio for não suportado, a sessão mudou, o prazo expirou ou a aplicação rejeitar o resultado, retorne um estado terminal ou de revisão. Não deixe um autoscaler transformar uma tarefa bloqueada em muitas tentativas de resolução duplicadas.
Resgate seu Código de Bônus do CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta do CapSolver para obter um bônus extra de 5% em cada recarga — sem limites.
Resgate-o agora em seu Painel do CapSolver
A extração deve começar apenas após a classificação da página retornar pronto. Analise o esquema mínimo necessário pela tarefa de negócio, depois valide tipos, campos necessários, frescor, unicidade e consistência da fonte antes de gravar downstream.
Mantenha um envelope de evidência compacto com cada registro:
{
  "task_id": "task-20260921-0042",
  "final_url": "https://example.test/catalog/42",
  "observed_at": "2026-09-21T02:30:00Z",
  "page_state": "ready",
  "session_ref": "session://browser/task-20260921-0042",
  "required_fields_present": true,
  "artifact_refs": ["screenshot://task-20260921-0042/final"]
}
O envelope é ilustrativo, mas seu propósito é concreto: sistemas downstream podem distinguir evidência de página fresca de cache antigo, saída do analisador de observação do navegador e dados aceitos de um sucesso falso. A retenção deve ser curta e orientada por política, especialmente quando capturas de tela ou estado do navegador puderem conter informações pessoais ou confidenciais.
A escalabilidade do CaaS deve responder ao trabalho, não apenas ao uso de processamento. Workers de navegador frequentemente esperam navegação, renderização, filas ou APIs externas, então a CPU pode parecer baixa enquanto a latência da tarefa aumenta.
Entradas úteis para escalonamento incluem a quantidade de tarefas pendentes, idade da tarefa mais antiga, tempo de espera da concessão, duração média da tarefa e número de workers em cada estado tipado. Kubernetes documenta que o HorizontalPodAutoscaler pode usar métricas personalizadas, o que é uma melhor opção para trabalho de navegador baseado em fila do que apenas CPU. O Kubernetes também fornece Jobs para tarefas finitas que executam até a conclusão, embora um consumidor de fila persistente possa ser mais eficiente quando a inicialização do navegador for cara.
Defina limites rígidos para a quantidade de workers, concorrência por domínio, total de tarefas de desafio e gravações downstream. Quando um alvo começa a retornar mais estados de desafio ou rejeição, reduza ou pause o trabalho em vez de escalar para a falha. Uma fila crescente pode ser um sinal de capacidade; uma taxa crescente de desafio é um sinal de diagnóstico.
A seguinte função Python modela a camada de decisão sem contatar um alvo ou resolver um CAPTCHA. Ela aceita um estado de página observado e o orçamento da tarefa durável, então retorna a próxima ação.
from dataclasses import dataclass
from enum import Enum


class NextAction(str, Enum):
    EXTRACT = "extract"
    HANDLE_CHALLENGE = "handle_challenge"
    RETRY = "retry"
    REVIEW = "review"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    attempts: int
    max_attempts: int
    seconds_remaining: int
    session_matches: bool
    challenge_allowed: bool


def decide(page_state: str, budget: Budget) -> NextAction:
    if budget.seconds_remaining <= 0:
        return NextAction.STOP
    if page_state == "ready":
        return NextAction.EXTRACT
    if page_state == "challenge":
        if not budget.challenge_allowed or not budget.session_matches:
            return NextAction.REVIEW
        if budget.attempts >= budget.max_attempts:
            return NextAction.STOP
        return NextAction.HANDLE_CHALLENGE
    if page_state == "retryable_error":
        return NextAction.RETRY if budget.attempts < budget.max_attempts else NextAction.STOP
    if page_state in {"authentication_required", "review_required"}:
        return NextAction.REVIEW
    return NextAction.STOP
Testes locais cobrem páginas prontas, desafios elegíveis, sessões alteradas, prazos expirados, exaustão de tentativas, estados de revisão e entrada desconhecida. O modelo de decisão é intencionalmente pequeno para que um orquestrador possa registrar e auditar cada transição.
As métricas mais úteis conectam o comportamento da infraestrutura aos resultados da página. Monitore a idade da fila e a saturação do worker, mas também registre a taxa de desafio, taxa de autenticação necessária, taxa de rejeição do analisador, taxa de tarefas duplicadas, expiração de prazo e aceitação final do estado de negócio.
Use um ID de correlação entre a mensagem da fila, rastreamento do navegador, tarefa de desafio, registro extraído e gravação downstream. Os logs devem mascarar chaves de API, cookies, tokens e dados pessoais. Uma captura de tela é evidência, não um registro permanente padrão; mantenha apenas o que o caso de uso autorizado requer.
Avisos sobre proporções, não falhas isoladas. Um desafio pode ser normal. Um aumento rápido para o mesmo alvo, rota ou versão de navegador pode indicar uma mudança no site, defeito de sessão, autenticação expirada, problema de política ou regressão de versão. Pausar a fatia afetada enquanto o restante da fila continua.
A escala de contêineres não expande permissões. Use essa arquitetura apenas para fluxos de dados públicos, autorizados ou de outra forma legais. Respeite os termos do alvo, limites de taxa, obrigações de privacidade, jurisdição e requisitos de minimização de dados.
Não envie páginas privadas, dados de conta ou capturas de tela sensíveis para sistemas externos, a menos que o fluxo seja explicitamente aprovado para esse dado. Separe fluxos de login e identidade de tarefas de dados públicos ordinários. Requer revisão humana antes de submissões sensíveis, ações irreversíveis ou mudanças de escopo.
Containers como Serviço tornam workers de navegador repetíveis e escaláveis, mas a confiabilidade em produção vem dos contratos ao redor desses workers. Dê a cada tarefa um proprietário, uma sessão isolada, um prazo durável, uma máquina de estado tipada e uma saída validada. Escalone quando a fila mostrar demanda saudável; pause quando a evidência mostrar rejeições repetidas ou estado incerto.
Para fluxos autorizados com passos de verificação suportados, CapSolver pode se encaixar atrás da porta de elegibilidade enquanto seu aplicativo preserva o contexto do navegador e verifica o resultado final.
Comece com um alvo aprovado e um trabalhador limitado. Registre a classificação da página, a elegibilidade do desafio, o tempo decorrido, a aceitação final e as referências de evidência antes de aumentar a concorrência. Use a documentação do CapSolver para selecionar o fluxo de tarefa documentado atual, depois revise o resultado na sessão original do navegador.
Q: O Containers como Serviço resolve problemas de acesso a sites?
Não. O CaaS implanta e escala aplicações containerizadas, enquanto a sua camada de acesso ainda precisa de estado do navegador, roteamento, classificação de desafio, controles de política e validação de resultados.
Q: Cada URL deve ser executada em um contêiner separado?
Não necessariamente. Um contexto de navegador isolado por tarefa alugada geralmente é o limite importante; um contêiner de trabalhador pode processar tarefas sequencialmente se fechar cada contexto, limpar a memória da tarefa e reconhecer apenas após o estado durável ser gravado.
Q: Qual métrica deve escalar os trabalhadores de navegador?
A profundidade da fila e a idade da tarefa geralmente são sinais primários mais fortes do que o CPU sozinho. Combine-as com limites de trabalhador, concorrência ao nível do alvo, taxa de desafio e expiração do prazo para que a plataforma não escale um fluxo com falha.
Q: Como um trabalhador reiniciado deve lidar com uma tarefa CAPTCHA existente?
O trabalhador reiniciado deve carregar o ID da tarefa do provedor durável, o prazo original, o número de tentativas e a referência de sessão. Ele deve pesquisar a tarefa conhecida apenas quando a sessão ainda corresponder e o orçamento restante permitir; caso contrário, deve parar ou solicitar revisão.
Q: Este padrão pode ser usado para dados privados ou restritos?
A capacidade técnica não concede permissão para coletar dados privados, restritos, pessoais ou sensíveis. Use o padrão apenas dentro de um escopo aprovado e aplique os termos do alvo, a lei aplicável, a minimização de dados, os controles de retenção e os requisitos de revisão humana.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Aprenda arquitetura de raspagem web escalável em Rust com reqwest, scraper, raspagem assíncrona, raspagem de navegador headless, rotação de proxies e tratamento de CAPTCHA compatível.
Compare o Selenium vs Puppeteer para resolver CAPTCHA. Descubra benchmarks de desempenho, notas de estabilidade e como integrar o CapSolver para o máximo de sucesso.