

🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Nov 13, 2026
Atualizado Nov 13, 2026 · minutos de leitura
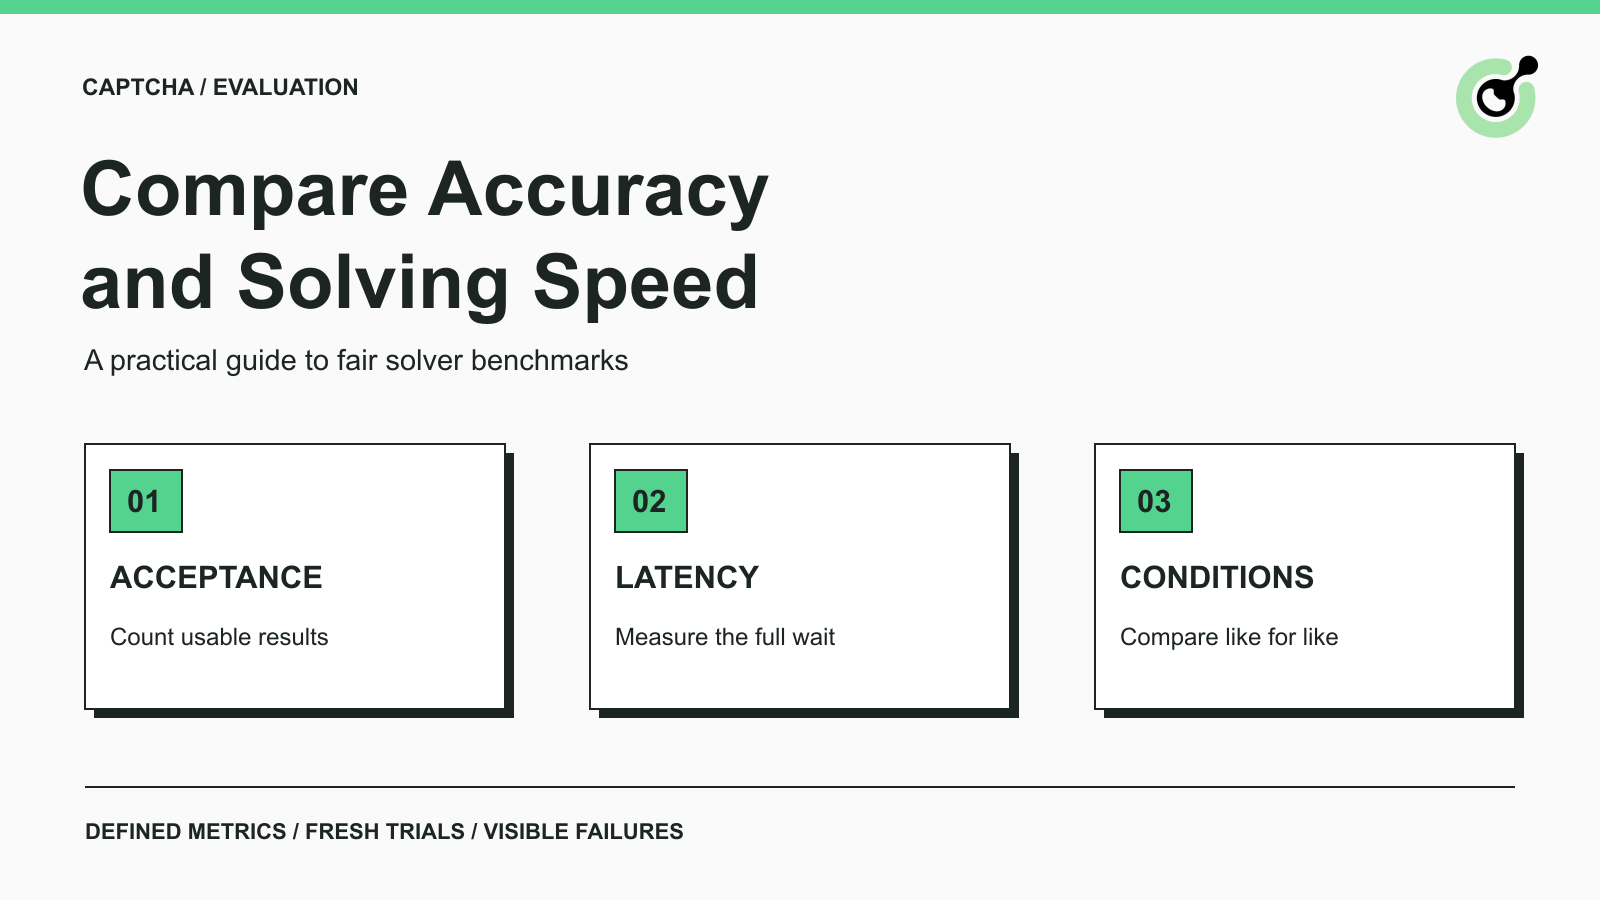
“Rápido” e “preciso” são afirmações úteis apenas quando a forma de medição está clara. Um resolvedor de CAPTCHA pode anunciar o tempo para retornar uma resposta de API, enquanto outro informa o tempo para completar uma etapa de navegador. Uma porcentagem de sucesso pode contar tokens retornados, desafios aceitos ou trabalhos concluídos após várias tentativas.
Este guia explica como comparar essas medições para sua própria carga de trabalho permitida. O CapSolver é um serviço que pode ser avaliado por meio de interfaces de tarefa documentadas. O método abaixo não apresenta um ranking medido de provedores nem supõe qual serviço terá melhor desempenho.
A precisão de um resolvedor de CAPTCHA deve descrever resultados corretos ou aceitos para um tipo de desafio especificado e um denominador claramente declarado.
Para uma tarefa de imagem para texto com respostas conhecidas, o reconhecimento exato é uma medida útil. Conte se o texto retornado corresponde aos caracteres esperados segundo as regras do aplicativo que o recebe. Se o aplicativo considera maiúsculas e minúsculas significativas, uma avaliação que ignora o caso mede um problema diferente.
Para uma tarefa baseada em token, o resultado mais útil é se o aplicativo que recebe o desafio aceita a resposta. Um provedor que retorna um token não vazio estabelece a entrega de uma saída, não sua aceitação. O guia de validação do reCAPTCHA do Google descreve a checagem de backend que verifica a resposta.
Mantenha três quantidades separadas:
| Medição | Numerador | Denominador | Pergunta respondida |
|---|---|---|---|
| Taxa de solução da API | Tarefas que retornam a solução documentada | Todas as tarefas válidas enviadas | O resolvedor retornou uma saída? |
| Aceitação na primeira tentativa | Desafios aceitos na primeira tentativa | Todas as primeiras tentativas planejadas | O resultado inicial funcionou? |
| Conclusão eventual do trabalho | Trabalhos concluídos dentro das tentativas permitidas e do prazo | Todos os trabalhos planejados | O fluxo de trabalho completo terminou? |
Solicitações de teste malformadas devem ser relatadas como falhas de configuração. Não as remova silenciosamente do relatório, mas evite atribuir uma chave de site errada à precisão de reconhecimento. Informe se um denominador publicado inclui ou exclui falhas de configuração e por quê.
A velocidade do resolvedor deve ser medida entre dois eventos nomeados usando um relógio consistente e a mesma definição para cada provedor.
Registre quando o cliente envia a tarefa, recebe uma solução utilizável e observa a aceitação pelo aplicativo. Esses carimbos de tempo distinguem a latência da API do trabalho adicional exigido pelo aplicativo. Se a recuperação da tarefa usar polling, registre também a política de polling: o momento em que seu cliente percebe a conclusão pode ser posterior ao instante em que o serviço terminou.
O contrato getTaskResult do CapSolver distingue resultados pendentes e prontos para tarefas assíncronas. Sua ImageToTextTask retorna o reconhecimento diretamente na criação da tarefa. Não imponha o modelo de medição assíncrono a uma tarefa síncrona nem compare tipos de tarefa diferentes em uma única coluna de velocidade.
Use pelo menos a mediana e um percentil de cauda, como p95, para tentativas bem-sucedidas. A mediana descreve o meio da distribuição observada; o percentil de cauda mostra quanto tempo a mais demoraram as tentativas bem-sucedidas mais lentas. A orientação de SRE do Google sobre distribuições de latência explica por que médias podem ocultar o comportamento na cauda.
Publique também a contagem de timeouts e o prazo. Um provedor que retorna cinco sucessos rápidos e dá timeout em muitas outras tentativas não deve parecer superior apenas porque as falhas foram excluídas da média de latência.
Uma comparação útil agrupa desafios semelhantes e mantém as principais condições de operação estáveis.
Separe reCAPTCHA v2, reCAPTCHA v3, Turnstile e reconhecimento de texto em imagem. Dentro de uma família, mantenha variantes e parâmetros relevantes. Um resultado em uma categoria não estabelece desempenho em outra. A documentação da tarefa reCAPTCHA v2 é um exemplo de por que campos de requisição específicos da variante são importantes.
Para cada grupo, registre o ambiente aprovado, localização do cliente, concorrência, prazo da requisição, política de polling, permissão de novas tentativas e período de teste. Não faça um provedor receber uma requisição de cada vez e outro receber um estouro de trabalho simultâneo para então atribuir toda a diferença ao resolvedor.
Use propriedades de teste próprias ou fluxos de trabalho com permissão explícita para essa avaliação. Comece com uma carga pequena que o ambiente suporte. Uma página publicamente acessível não é uma licença para conduzir um teste de desempenho irrestrito.
Ensaios equivalentes precisam de condições de desafio comparáveis, não da reutilização de um token já usado. O Google documenta respostas do reCAPTCHA como de uso único, com tempo de vida de dois minutos. A referência de validação do Turnstile da Cloudflare da mesma forma exige validação no servidor e descreve um tempo de vida de token de cinco minutos com uso único.
Planeje testes independentes sob as mesmas condições permitidas. Quando possível, alterne a ordem dos provedores ao longo do período de teste em vez de testar um serviço apenas durante um intervalo tranquilo e outro apenas em um intervalo movimentado. Mantenha o plano de atribuição antes de olhar os resultados.
Para reconhecimento de imagem offline, o mesmo conjunto de imagens rotuladas autorizadas pode ser útil. Para um desafio dinâmico ao vivo, descreva como amostras comparáveis foram atribuídas e reconheça a variação restante. Não declare um experimento perfeitamente controlado se a população de desafios mudou durante a execução.
Resgate Seu Código de Bônus do CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta CapSolver para obter 5% de bônus extra em cada recarga — sem limites.
Resgate agora no seu Painel do CapSolver
Um registro de benchmark deve manter uma linha por tentativa e um identificador de trabalho estável que ligue quaisquer novas tentativas.
Os campos a seguir formam um modelo editorial de relatório, não um esquema de API de provedor:
| Campo | O que registrar |
|---|---|
| Identificadores de trabalho e tentativa | A qual desafio planejado esta tentativa pertence |
| Família e variante do desafio | A categoria exata de tarefa sendo comparada |
| Provedor e versão do cliente | O serviço e a integração usados |
| Horários de envio e resultado | Informação suficiente para calcular a latência da API |
| Horário e evidência de aceitação | Quando o aplicativo aceitou a resposta, se observável |
| Resultado final | Aceito, rejeitado, timeout, erro de API ou falha de configuração |
| Número da tentativa | Se esta foi a tentativa original ou uma posterior |
| Valor cobrado | Custo real quando disponível, com sua base de cobrança |
Não armazene chaves de API, tokens de resposta brutos ou informações pessoais não relacionadas em um relatório de benchmark compartilhado. Mantenha evidências de diagnóstico restritas separadamente quando necessário. Uma referência de tarefa redigida e o resultado geralmente são mais úteis do que copiar a requisição completa em uma planilha.
Use asserções de teste de API para tornar a definição de resultado repetível. Se o backend estiver fora da sua visibilidade, registre o sinal observável do aplicativo e chame-o de aceitação pelo aplicativo em vez de alegar acesso a uma pontuação interna de validação.
Um resultado útil explica o trade-off entre aceitação, atraso, novas tentativas e tamanho da amostra em vez de comprimir tudo em uma única pontuação.
Considere este exemplo aritmético hipotético, não uma comparação medida de serviços reais:
| Primeiras tentativas planejadas | Aceitas na primeira tentativa | Aceitação na primeira tentativa | Trabalhos adicionais concluídos após nova tentativa | Trabalhos eventualmente concluídos |
|---|---|---|---|---|
| 100 | 90 | 90% | 5 | 95 |
A taxa de aceitação na primeira tentativa é 90 dividido por 100, ou 90%. A conclusão eventual é 95 dividido por 100, ou 95%. Nenhum dos dois números informa quanto tempo as novas tentativas levaram ou quantas tentativas extras foram cobradas. Isso precisa de colunas separadas em um relatório real.
Agora considere um conjunto hipotético de 20 durações de tentativas bem-sucedidas: 18 levam dois segundos e duas levam 20 segundos. A média é 3,8 segundos, enquanto a mediana é dois segundos. Usando a definição de posto mais próximo, p95 é 20 segundos. As três afirmações podem ser verdadeiras; uma única média esconde as longas esperas.
Declare o método de cálculo de percentil ao relatar amostras pequenas. Softwares diferentes podem interpolar percentis de forma diferente, então diferenças decimais sem explicação não devem ser apresentadas como uma vantagem significativa de um provedor.
Evite tratar uma pequena diferença vinda de um teste curto como um ranking permanente. Repita as medições ao longo de um período relevante e mostre o número de casos avaliados em cada grupo. Se um serviço foi testado apenas em uma família de desafios, informe isso ao lado do resultado.
Uma pontuação do reCAPTCHA v3 descreve uma interação avaliada e não deve ser renomeada como porcentagem de precisão do resolvedor.
O guia do reCAPTCHA v3 do Google descreve decisões baseadas em pontuação e a verificação da ação esperada no backend. O aplicativo que recebe decide como usar essa avaliação. Um campo de pontuação, portanto, tem um significado diferente de “90 de 100 trabalhos planejados foram aceitos”.
Para um aplicativo próprio, registre a regra de aceitação usada no teste e mantenha-a consistente entre provedores. Informe a distribuição de pontuações separadamente se tiver acesso legítimo a ela. Se você apenas observa se o fluxo de trabalho continuou, não invente a pontuação oculta nem presuma que todo resultado aceito atingiu o mesmo limiar.
Escolha um resolvedor cuja aceitação observada e distribuição de tempo de resposta se encaixem no fluxo de trabalho que você realmente precisa executar.
Defina os critérios de decisão antes do teste. Um fluxo de trabalho interativo pode ter um orçamento de espera mais rígido que um processamento em lote offline. Um lote pode tolerar esperas mais longas, mas exigir uma meta clara de conclusão eventual e limite de custo. Esses são requisitos de carga de trabalho, não motivos para declarar um provedor universalmente mais rápido.
Para fluxos de trabalho dirigidos por agentes, o guia de avaliação de chamadas de ferramenta de CAPTCHA cobre uma questão relacionada porém separada: se o agente escolhe e chama a ferramenta corretamente. Mantenha essa avaliação separada da comparação de desempenho de resolvedores descrita aqui.
Avalie o CapSolver com as mesmas definições de tarefa e critérios de aceitação que qualquer outro candidato. Um benchmark útil deixa o leitor capaz de explicar o que deu certo, quanto tempo levou e onde a evidência termina.
P: Qual é uma boa taxa de precisão para resolvedores de CAPTCHA?
Um alvo útil depende da família de desafios e dos requisitos do fluxo de trabalho. Compare resultados aceitos em amostras representativas e declare o denominador antes de julgar qualquer porcentagem.
P: A resposta de API mais rápida é a solução utilizável mais rápida?
Nem sempre. Um recebimento de submissão, uma solução retornada e a aceitação pelo aplicativo são eventos diferentes. Meça o evento que corresponde ao requisito do leitor.
P: Tentativas falhas devem ser excluídas dos percentis de latência?
A latência de tentativas bem-sucedidas pode ser relatada separadamente, mas falhas e prazos de timeout devem permanecer visíveis ao lado dela. Caso contrário, o subconjunto rápido pode representar mal a carga de trabalho completa.
P: Posso testar provedores reutilizando o mesmo token?
Não. Tokens de verificação de uso único são inadequados para comparações baseadas em replay. Use testes novos, equivalentes e permitidos para fluxos de trabalho baseados em token.
P: Este artigo classifica serviços de resolução de CAPTCHA?
Não. Ele fornece um método de comparação e exemplos aritméticos explicitamente hipotéticos. Um ranking de desempenho exige medições reais sob condições declaradas e comparáveis.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Corrija erros de CAPTCHA verificando o carregamento do widget, as respostas da API do solucionador, a validação do token e os resultados da aplicação. Siga um caminho de solução de problemas claro para cada etapa.
Combine os módulos do VisionEngine com as entradas de imagem documentadas e leia o resultado de ângulo ou distância da resposta da tarefa.
