
🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Apr 24, 2025
Atualizado Sep 23, 2026 · minutos de leitura
CAPTCHAs baseados em imagem são agora um dos maiores obstáculos na automação do navegador, resolução de CAPTCHA por IA e raspagem de web. De acordo com um relatório da Web Data Lab de 2024, 61% dos projetos de automação listam CAPTCHAs baseados em imagem como sua principal fonte de falha — mais do que banimentos de IP ou problemas de script.
Muitas grandes plataformas de comércio eletrônico e outras adotaram sliders complexos, rotações e quebra-cabeças visuais que não podem ser resolvidos com OCR básico ou modelos de análise de imagem genéricos. Essas defesas exigem mais do que solvers tradicionais — elas demandam sistemas de reconhecimento de imagem específicos para tarefas, alimentados por aprendizado de máquina, capazes de se adaptar à complexidade do mundo real.
É por isso que criamos o Vision Engine — o solucionador avançado de CAPTCHA de IA da CapSolver, oferecendo altas taxas de sucesso, resposta rápida e personalização completa para cenários de automação desafiadores.
Nos últimos anos, o reconhecimento de imagem baseado em IA fez progressos significativos em tarefas como detecção de objetos, classificação de imagem e segmentação de múltiplos objetos. Arquiteturas CNN tradicionais se saem bem com dados estruturados, enquanto modelos baseados em transformadores oferecem forte generalização e compreensão contextual. No entanto, ao lidar com desafios complexos e diversos de CAPTCHA baseados em imagem, um enfoque híbrido é essencial — um que combine processamento clássico de imagem, modelos de aprendizado profundo e raciocínio por meio de modelos de linguagem grandes (LLMs).
O Vision Engine da CapSolver é construído com base nesse princípio exato. No núcleo do Vision Engine da CapSolver está um modelo de IA poderoso, treinado especificamente para resolver desafios modernos de CAPTCHA baseados em imagem. Diferente de OCR genérico ou modelos de visão, o Vision Engine é otimizado para alta precisão, desempenho em tempo real e adaptabilidade em uma ampla gama de tarefas de verificação visual.
Ganhe seu código de bônus CapSolver: VISION. Após resgatá-lo, você obterá um bônus adicional de 5% após cada recarga, ilimitado
Especializamos-nos em soluções altamente personalizáveis. Com base na complexidade, frequência de atualização e urgência da tarefa, entregamos um modelo inicial em 1–5 dias úteis. Embora a primeira versão não seja perfeita, ela é rápida, eficiente e suporta respostas em tempo real. Ao mesmo tempo, coletamos automaticamente amostras resolvidas/não resolvidas e acionamos treinamento aprimorado assim que houver dados suficientes. Após 1–3 ciclos de atualização, os modelos normalmente atingem mais de 90% de precisão. (Veja os tipos de imagem suportados abaixo para mais detalhes.)
Com o Vision Engine, a CapSolver oferece mais do que apenas reconhecimento de IA — é uma solução rápida e escalável projetada para evoluir com suas necessidades e mantê-lo à frente das defesas modernas de CAPTCHA.
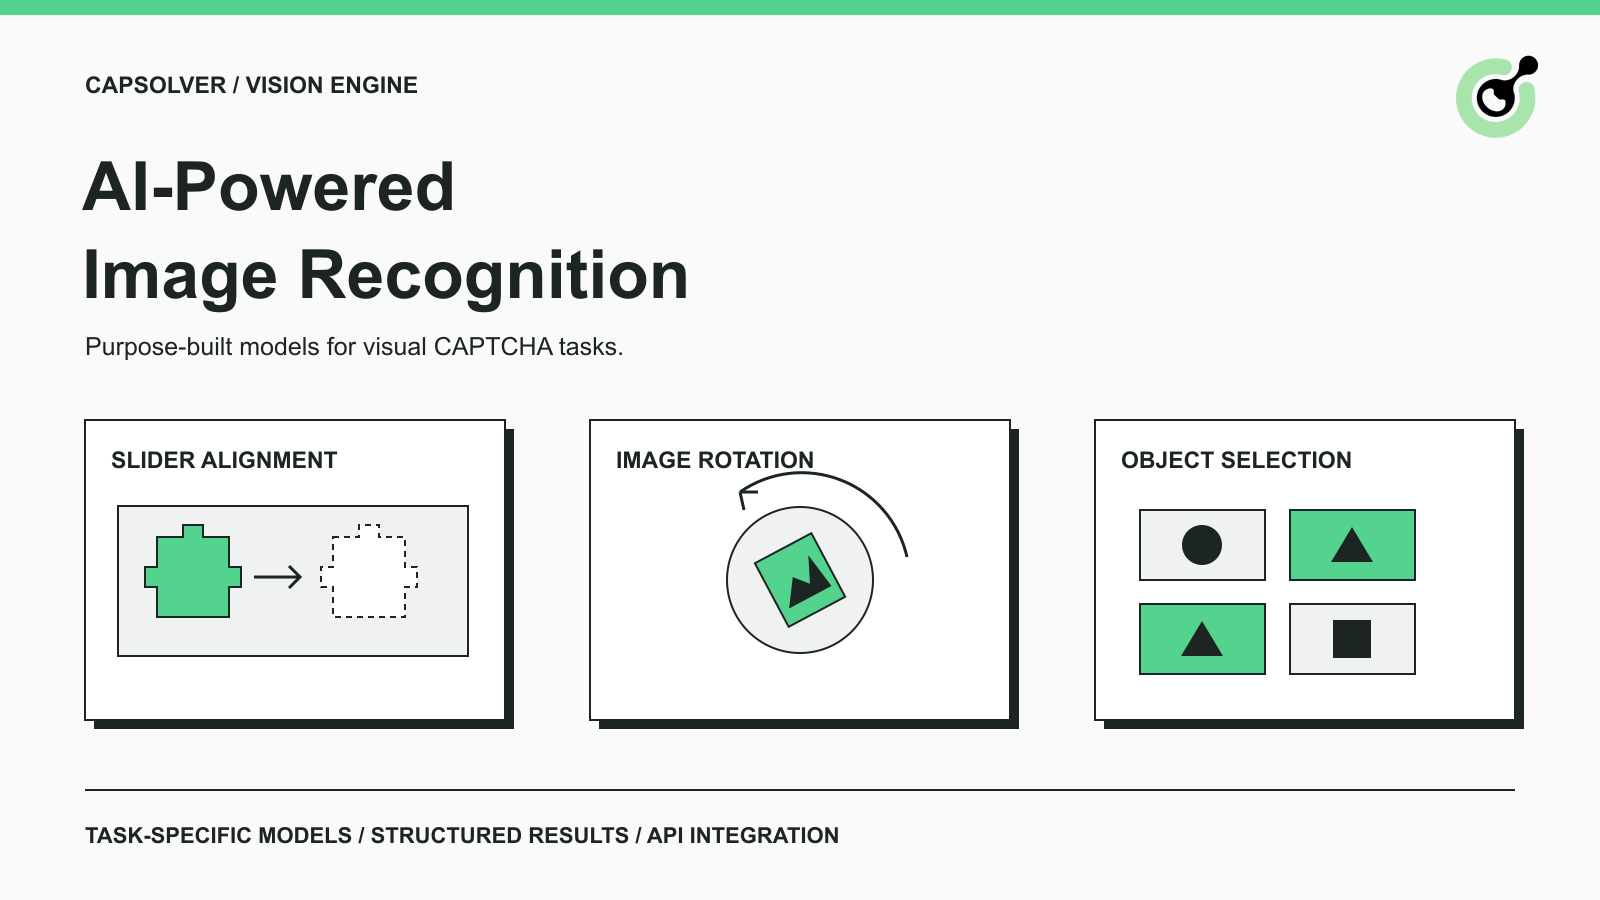
Para lidar com o crescente complexidade dos sistemas de CAPTCHA baseados em imagem, o Vision Engine foi treinado para lidar com uma ampla gama de formatos visuais usados em aplicações web modernas. Sua força reside na ampla adaptabilidade — suporte a múltiplos tipos de imagem personalizados para diferentes cenários de interação.
slider_1 – CAPTCHAs de quebra-cabeça de deslizamento padrão
rotate_1 – Desafios de rotação que exigem alinhamento de imagens inclinadas.
shein- Desafios de CAPTCHA estilizados após o site SHEIN. Normalmente tarefas baseadas em imagem como clicar em itens de moda específicos (ex.: bolsas ou sapatos). Foca no reconhecimento visual dentro de imagens relacionadas à moda
space_detection – Quebra-cabeças de raciocínio espacial que exigem detectar posições de objetos.
slider_temu_plus – Sliders personalizados com complexidade e variações de estilo aprimoradas.
select_temu – Tarefas de seleção de objeto a partir de várias escolhas de imagem, simulando cliques de usuários.👉 Para formatos completos de tarefa e exemplos de solicitação, consulte nossa documentação
Para atender à crescente demanda por diversos tipos de CAPTCHA baseados em imagem, o Vision Engine da CapSolver usa múltiplas arquiteturas de modelo especializadas. Esses modelos permitem soluções rápidas e escaláveis, garantindo um alto nível de precisão e desempenho em várias situações.
Arquiteturas de Modelo Personalizadas: Com mais de 5 arquiteturas de modelo já em uso, garantimos que o Vision Engine seja adaptável a uma ampla gama de tipos de CAPTCHA.
Treinamento Eficiente e Coleta de Dados: Implementamos uma abordagem semi-automática, totalmente automática ou híbrida com base nas necessidades do usuário, volume de tráfego e frequência de atualização do site, garantindo coleta rápida de dados, melhoria do modelo e atualizações contínuas.
Soluções Rápidas de Ponta a Ponta: Nossa abordagem minimiza o custo de comunicação do usuário ao oferecer soluções rápidas e personalizadas, entregando modelos para teste em 1–5 dias úteis, dependendo da complexidade da tarefa.
O Vision Engine da CapSolver suporta três categorias principais de desafios de CAPTCHA baseados em imagem, cada uma exigindo abordagens diferentes para desenvolvimento e personalização de modelo:
| Categoria | Tipos de Tarefa Incluídos | Descrição | Tempo de Desenvolvimento | Precisão do Modelo | Velocidade do Modelo |
|---|---|---|---|---|---|
| 1. Imagem Única de Alta Precisão | slider_1, rotate_1 |
Requer alinhamento ou posicionamento altamente preciso para um elemento de imagem único. | 1–3 dias úteis | > 95% | 0–200 ms |
| 2. Conteúdo Variável, Tipo Fixo | space_detection, shein |
O formato da imagem permanece consistente, mas o conteúdo (objetos, texto ou alvos visuais) varia conforme o desafio. | 3–5 dias úteis | > 80% | 200–600 ms |
| 3. Conteúdo e Tipo Variáveis | slider_temu_plus, select_temu |
Os formatos e o conteúdo das tarefas variam. Geralmente envolvem múltiplas respostas possíveis ou seleções de imagem. | 3–5 dias úteis (confirmado) | > 80% | 200–1000 ms (depende) |
Com o Vision Engine da CapSolver, você obtém mais do que apenas uma solução confiável. Nossa tecnologia se adapta às suas necessidades, melhorando com cada interação, garantindo a solução mais eficiente e precisa para resolução de CAPTCHA.
O Vision Engine da CapSolver foi projetado para integrar-se sem problemas aos seus fluxos de trabalho de raspagem e automação de navegador. Com suporte robusto de API, os desenvolvedores podem automatizar tarefas de resolução de CAPTCHA com facilidade e integrar facilmente o Vision Engine a vários projetos. Seja você trabalhando com Python, JavaScript ou outras linguagens, o processo de integração permanece simples e eficiente.
O exemplo oficial do Vision Engine em Python usa slider_1 para reconhecer um quebra-cabeça de deslizamento. Você precisa de Python, do pacote capsolver, de uma chave de API e de imagens de slider e fundo de um desafio no qual você tem autorização para processar.
Instale o pacote com pip install --upgrade capsolver. O seguinte é o exemplo oficial com seus marcadores de posição originais; substitua-os antes de executá-lo:
# pip install --upgrade capsolver
# export CAPSOLVER_API_KEY='...'

import capsolver

capsolver.api_key = "..."

solution = capsolver.solve({
    "type": "VisionEngine",
    "module": "slider_1",
    "image": "/9j/4AAQSkZJRgABA......",
    "imageBackground": "/9j/4AAQSkZJRgABA......"
})
print(solution)
Substitua capsolver.api_key pela sua chave, image pelo conteúdo completo em Base64 da imagem do slider e imageBackground pela correspondente imagem de fundo. As strings de imagem abreviadas acima não são imagens utilizáveis. Remova quebras de linha e qualquer prefixo de dados-URL dos seus valores em Base64. Salve o exemplo concluído como vision_slider.py e execute python vision_slider.py.
Para slider_1, o resultado documentado contém distance, a distância do deslizamento calculada a partir das imagens enviadas. O exemplo da API mostra solution.distance como 213; esse é um valor ilustrativo, não um valor fixo para cada quebra-cabeça.
O Vision Engine retorna dados de reconhecimento. Seu automação de navegador deve realizar a interação correspondente e verificar se a página a aceita. Para chamadas diretas da API, createTask retorna o resultado do reconhecimento sem etapa de polling separada getTaskResult.
O Vision Engine se destaca pela capacidade de entregar rapidamente modelos de reconhecimento de imagem personalizados para desafios visuais únicos. Seja você lidando com CAPTCHAs complexos de comércio eletrônico ou formatos especializados, nossa equipe pode tomar suas exigências e implantar uma API funcional em até 3–7 dias.
Em um caso recente, entregamos um modelo de CAPTCHA de deslizamento pronto para produção para uma grande plataforma de varejo em 3 dias, alcançando alta precisão e estabilidade.
Para garantir uma integração suave, a CapSolver oferece:
Aqui está como trazemos seu modelo personalizado online — rapidamente:
graph TD
  A[Submissão de Requisito] --> B[Avaliação do Modelo]
  B --> C[Preparação do Conjunto de Dados]
  C --> D[Treinamento do Modelo]
  D --> E[Implantação da API]
  E --> F[Suporte de Integração]

  classDef stage fill:#e0f7fa,stroke:#00acc1,stroke-width:2px;
class A,B,C,D,E,F stage;O CapSolver's Vision Engine não é apenas uma ferramenta — é uma solução inteligente e em evolução para desenvolvedores que enfrentam desafios de automação do mundo real. Seja você resolvendo sliders ou quebra-cabeças espaciais, nosso motor de IA se torna mais forte com cada tarefa, entregando precisão, escalabilidade e amigabilidade ao desenvolvedor sem precedentes.
Q1: Como a IA é usada no reconhecimento de imagem?
A IA usa aprendizado profundo (especialmente redes neurais convolucionais) para analisar imagens reconhecendo padrões, formas e contextos semânticos. Em cenários de CAPTCHA, os modelos de IA são treinados para entender texto, layout, posição de objetos e posicionamento lógico em quebra-cabeças visuais complexos.
Q2: A IA pode resolver CAPTCHAs baseados em imagem?
Sim. A IA agora pode resolver uma ampla gama de CAPTCHAs baseados em imagem, de quebra-cabeças de deslizamento a perguntas visuais de múltiplas etapas. O Vision Engine é treinado em grandes conjuntos de dados para lidar com isso com alta precisão.
Q3: Posso solicitar um modelo personalizado?
Absolutamente. A CapSolver pode entregar soluções de reconhecimento de imagem personalizadas. Da solicitação à implantação, pode levar alguns dias, dependendo da complexidade e da disponibilidade do conjunto de dados.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Conectar o CapSolver MCP ao rtrvr com nomes de ferramentas qualificados, tratamento do modo token, limites de sessão, orquestração testada e verificações de estado final.
Trate CAPTCHAs não resolvidos em fluxos de trabalho de agentes de IA com limites claros de tentativas de repetição, transferências humanas úteis, controle da propriedade do navegador e retomada de tarefas verificada.
