Como Integrar Soluções reCAPTCHA v2 em Python para Extração de Dados
Aloísio Vítor
Image Processing Expert

Introdução
Com o crescimento da internet, o web scraping e a extração de dados são amplamente utilizados para coletar informações de sites para diversos fins, incluindo inteligência de negócios, agregação de conteúdo e análise de mercado. No entanto, à medida que os bots se tornaram mais sofisticados, os sites implementaram ferramentas para diferenciar usuários humanos de programas automatizados. Uma dessas ferramentas é o reCAPTCHA. Neste blog, exploraremos o que é o reCAPTCHA, as diferentes versões disponíveis e como resolver desafios do reCAPTCHA v2 usando o Capsolver em Python. Por fim, percorreremos um código de exemplo simples para integrar o reCAPTCHA v2 em seu projeto de extração de dados.
O que é reCAPTCHA?
O reCAPTCHA é um serviço gratuito desenvolvido pelo Google que ajuda a proteger sites contra spam e abuso, garantindo que uma pessoa real (em vez de um bot automatizado) esteja interagindo com o site. Quando os usuários visitam um site que implementa o reCAPTCHA, eles podem ser solicitados a concluir um desafio para verificar se são humanos.
Diferentes Versões do reCAPTCHA
Existem várias versões do reCAPTCHA, cada uma com seus próprios pontos fortes e casos de uso:
-
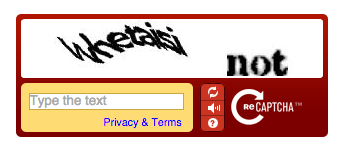
reCAPTCHA v1: A versão mais antiga, agora desativada. Exigia que os usuários transcrevessem texto distorcido de imagens.
-
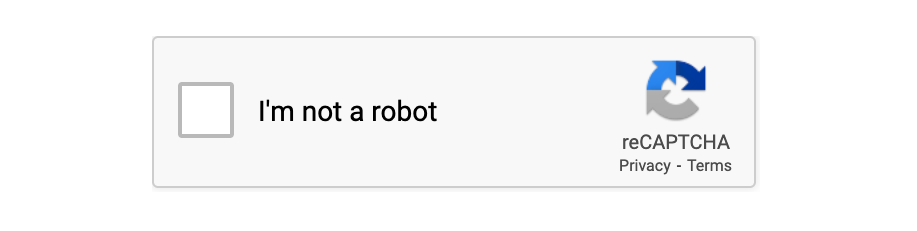
reCAPTCHA v2: Uma versão mais avançada que apresenta aos usuários uma caixa de seleção ("Não sou um robô"). Se necessário, também desafia os usuários a selecionar certas imagens (como semáforos ou faixas de pedestres). Esta versão é a mais utilizada hoje em dia.
-
reCAPTCHA v3: Esta versão analisa o comportamento do usuário e a interação com o site para atribuir uma pontuação de 0 a 1, onde 0 indica um bot e 1 indica um humano. É mais suave para os usuários, pois não requer desafios interativos.
-
reCAPTCHA invisível: Esta versão opera nos bastidores e só apresenta desafios quando atividades suspeitas são detectadas. É projetado para ser invisível para usuários legítimos.
O que é Extração de Dados?
Extração de dados refere-se ao processo de recuperar dados estruturados de fontes não estruturadas, como páginas da web, bancos de dados ou outros formatos digitais. É comumente usado em web scraping, onde programas automatizados coletam grandes quantidades de informações de sites para análise ou agregação.
Casos de Uso Comuns para Extração de Dados
-
Pesquisa de Mercado: As empresas extraem dados de preços de concorrentes e avaliações de clientes para ajustar suas estratégias de marketing e vendas.
-
Inteligência de Negócios: As organizações raspam relatórios financeiros, notícias e outros recursos para tomar decisões de negócios informadas.
-
Agregação de Conteúdo: Sites que curam e exibem informações de várias fontes geralmente extraem dados de outras páginas da web.
-
Análise de SEO: Extrair conteúdo, palavras-chave e meta tags de sites concorrentes ajuda a otimizar as estratégias de SEO.
Integrando a Solução reCAPTCHA v2 em Python
Ao extrair dados de sites, você pode encontrar desafios do reCAPTCHA. Isso representa um obstáculo para a raspagem automatizada. Felizmente, ferramentas como o Capsolver podem resolver os desafios do reCAPTCHA v2 programaticamente, permitindo que você continue com suas tarefas de extração de dados.
Aqui está uma implementação Python para resolver o reCAPTCHA v2 usando o pacote Capsolver.
Passos:
-
Instale a biblioteca
capsolverexecutando:bashpip install capsolver -
Use o seguinte código Python para resolver o desafio do reCAPTCHA v2:
python
import capsolver

# Considere o uso de variáveis de ambiente para informações confidenciais
capsolver.api_key = "Your Capsolver API Key"
PAGE_URL = "PAGE_URL"
PAGE_KEY = "PAGE_SITE_KEY"

def solve_recaptcha_v2(url,key):
    solution = capsolver.solve({
        "type": "ReCaptchaV2TaskProxyless",
        "websiteURL": url,
        "websiteKey":key,
    })
    return solution

def main():
    print("Resolvendo reCaptcha v2")
    solution = solve_recaptcha_v2(PAGE_URL, PAGE_KEY)
    print("Solução: ", solution)

if __name__ == "__main__":
    main()
Explicação do Código
-
Configuração da API do Capsolver: No código, definimos o
capsolver.api_keyque deve conter sua chave de API do Capsolver. Esta chave autenticará suas solicitações ao serviço Capsolver. -
Função Resolver: A função
solve_recaptcha_v2aceita aurlda página e asite_key(que é a chave do reCAPTCHA presente no site). Ele envia uma solicitação ao Capsolver para resolver o desafio do reCAPTCHA. -
Função Principal: A função principal executa o solucionador e imprime a solução.
-
Variáveis de Ambiente: É recomendável usar variáveis de ambiente para armazenar informações confidenciais como chaves de API para melhor segurança. No exemplo acima, você deve substituir
Your Capsolver API Key,PAGE_URLePAGE_SITE_KEYpelos seus valores reais.
Código Bônus
Reivindique seu Código Bônus para as melhores soluções de captcha; CapSolver: scrape. Após resgatá-lo, você receberá um bônus extra de 5% após cada recarga, Ilimitado
Para mais informações, leia este blog
Conclusão
O reCAPTCHA é uma ferramenta essencial para proteger sites contra bots, mas pode criar desafios para fins de automação legítimos, como extração de dados. O uso de ferramentas como o Capsolver permite que os desenvolvedores resolvam programaticamente os desafios do reCAPTCHA v2, permitindo a extração de dados ininterrupta. Sempre certifique-se de que suas atividades de extração de dados estejam em conformidade com os termos de serviço e diretrizes legais do site para evitar problemas.
Ao integrar a solução fornecida acima em seus projetos Python, você pode continuar a coletar dados valiosos de sites enquanto supera os obstáculos do reCAPTCHA.
Ver mais
Web ScrapingDec 11, 2025
Melhores APIs de Raspagem de Web em 2026: Melhores Ferramentas Comparadas & Classificadas
Descubra as melhores APIs de raspagem de web para 2026. Comparamos as melhores ferramentas com base em taxa de sucesso, velocidade, recursos de IA e preços para ajudar você a escolher a solução certa para suas necessidades de extração de dados.
AISep 01, 2026
Revisão do CloakBrowser 2026: Funcionalidades, Preços, Vantagens e Desvantagens
Avaliação do CloakBrowser para 2026 que abrange recursos, preços, licenciamento, opções de implantação, vantagens, limitações, alternativas e casos de uso ideais.