

🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Nov 13, 2026
更新されました Nov 13, 2026 · 最小読み取り
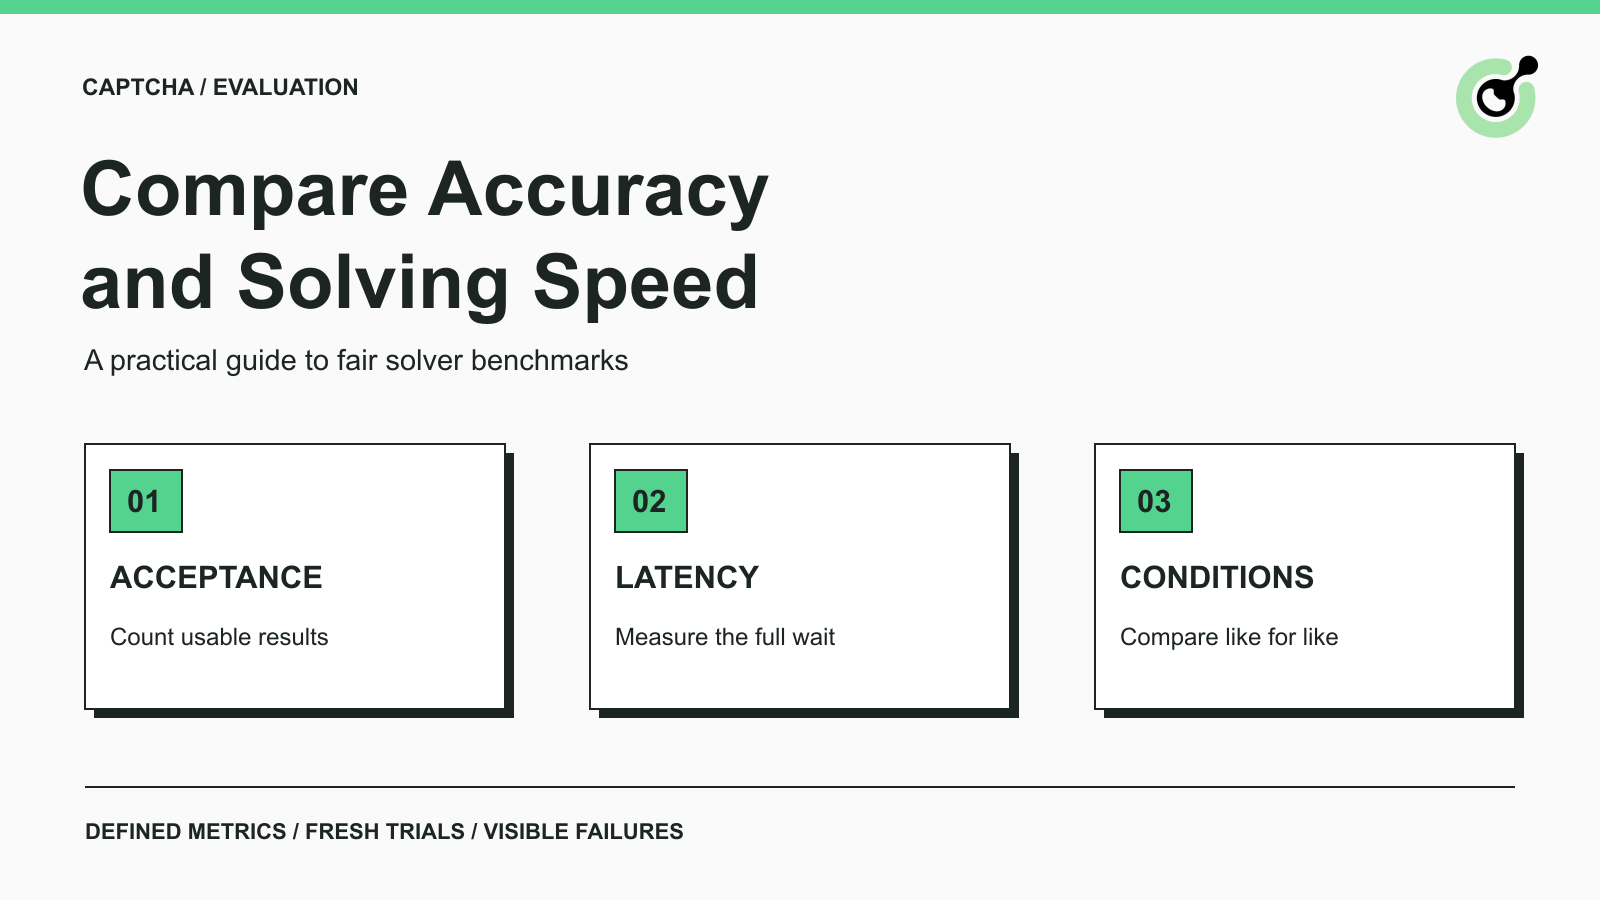
「高速」「高精度」という主張は、その裏にある測定方法が明確なときにだけ意味を持つ。ある CAPTCHA ソルバーは API 応答が返るまでの時間を宣伝し、別のソルバーはブラウザの一連のステップ完了までの時間を報告しているかもしれない。成功率も、「トークンを返した割合」「チャレンジが受け入れられた割合」「複数回の試行の末に完了したジョブの割合」など、何を数えるかで意味が変わる。
このガイドは、自分の許可されたワークロードに対して、これらの測定を比較する方法を説明する。CapSolver は、ドキュメント化されたタスクインターフェースを通じて評価できるサービスの一例である。以下の手法は、計測済みのプロバイダー順位表を提示したり、どのサービスが最良と仮定したりするものではない。
CAPTCHA ソルバーの精度は、特定のチャレンジタイプに対して、何が「正解」または「受け入れ」とみなされるか、および明確な分母に対して定義されるべきである。
既知の正解がある画像から文字を起こすタスクでは、厳密な認識が有用な指標になる。返されたテキストが、受け側アプリケーションのルールに従って期待される文字列と一致するかを数える。アプリケーションが大文字小文字を区別しているのに、評価がそれを無視した場合、全く別の問題を測っていることになる。
トークンタスクでは、より有用なのは「受け側アプリケーションがチャレンジ応答を受け入れたかどうか」である。プロバイダーが空でないトークンを返したことは、あくまで出力が返送されたことを示すだけであり、そのトークンが受け入れられたことは保証しない。Google の reCAPTCHA 検証ガイドは、応答を検証するバックエンドチェックについて説明している。
次の 3 つの量は分けて扱うこと:
| 測定指標 | 分子 | 分母 | 答える問い |
|---|---|---|---|
| API 解答率 | ドキュメントどおりの解答を返したタスク数 | 送信された全ての有効タスク数 | ソルバーは出力を返したか? |
| 初回試行受け入れ率 | 初回試行で受け入れられたチャレンジ数 | 計画された全初回試行数 | 最初の結果は動いたか? |
| 最終ジョブ完了率 | 許可された試行回数と期限内に完了したジョブ数 | 計画された全ジョブ数 | ワークフロー全体は完了したか? |
不正なテストリクエストはセットアップ失敗として報告すること。レポートから黙って除外したりせず、ただし誤ったサイトキーを認識精度の問題として扱わないようにする。公表する分母にセットアップ失敗を含めるのか除外するのか、その理由とともに明記する。
ソルバーの速度は、2 つの名前付きイベント間を、同じ時計と定義で各プロバイダーについて一貫して測定するべきである。
クライアントがタスクを送信した時刻、利用可能な解答を受け取った時刻、アプリケーション側で受け入れを観測した時刻を記録する。これらのタイムスタンプにより、API レイテンシと、アプリケーション側で追加で必要な作業とを区別できる。タスク取得にポーリングを用いる場合は、そのポーリングポリシーも記録すること。クライアントが完了に気づく時刻は、サービス側が処理を終えた時刻より遅くなりうる。
CapSolver の getTaskResult コントラクト は、非同期タスクにおける pending と ready の結果を区別している。ImageToTextTask はタスク作成時に直接認識結果を返す。同期タスクに非同期の測定モデルを当てはめたり、単一の速度カラムの中で異なるタスクタイプを比較したりしないこと。
成功した試行については、最低でも中央値と、p95 のような末尾パーセンタイルを用いる。中央値は観測された分布の真ん中を示し、末尾パーセンタイルは遅い成功試行がどれだけ長引いたかを示す。Google の レイテンシ分布に関する SRE ガイダンスは、平均値が末尾の挙動をどのように隠しうるかを説明している。
また、タイムアウト件数と締め切りも公表すること。あるプロバイダーが 5 件の成功を素早く返し、他の多くの試行でタイムアウトしていても、失敗をレイテンシ平均から除外してしまえば、見かけ上優れているように見えてしまう。
有用な比較のためには、類似したチャレンジをグループ化し、主要な運用条件を一定に保つ必要がある。
reCAPTCHA v2、reCAPTCHA v3、Turnstile、テキスト入り画像認識などは分けて扱う。同じファミリー内でも、関連するバリアントやパラメータを保持する。あるカテゴリでの結果は、別カテゴリでの性能を保証しない。reCAPTCHA v2 タスクのドキュメントは、バリアント固有のリクエストフィールドがなぜ重要かの一例である。
各グループについて、承認された環境、クライアントのロケーション、同時実行数、リクエスト締め切り、ポーリングポリシー、リトライ許容量、テスト期間を記録する。一方のプロバイダーには常に 1 件ずつリクエストを送り、もう一方には同時に大量のリクエストを送りつつ、その差をすべてソルバーの性能差とみなすようなことはしない。
この評価には自分が所有するテスト用プロパティや、明示的に許可されたワークフローを使う。環境が支えられる小さな負荷から始めること。公開されているページであっても、無制限の性能テストを行う権利があるわけではない。
等価なトライアルに必要なのは、同じトークンの再利用ではなく、同等のチャレンジ条件である。Google は reCAPTCHA 応答を 2 分間の有効期間を持つ「1 回限り」のものとして定義している。Cloudflare の Turnstile 検証リファレンス も同様にサーバーサイド検証を要求し、5 分間の有効期間と 1 回限りの使用を説明している。
同じ許可条件の下で独立したトライアルを計画する。可能であれば、テスト期間全体にわたってプロバイダーの試験順序を交互に入れ替え、一方は空いている時間帯だけ、もう一方は混んでいる時間帯だけ、といった偏りを避ける。結果を見る前に割当計画を決めておくこと。
オフラインの画像認識であれば、同じ権限のあるラベル付き画像セットが有用になりうる。変化し続けるライブチャレンジの場合、サンプルをどのように等価に割り当てたかを説明し、残るばらつきについても認めること。チャレンジの母集団がテスト期間中に変化しているのに、「完全に制御された実験」と主張してはならない。
CapSolver ボーナスコードを利用しよう
自動化用の予算を今すぐブースト!
チャージ時にボーナスコード CAP26 を利用すると、チャージ額の 5% 分のボーナス を毎回追加で獲得できます — 上限なし。
今すぐ CapSolver ダッシュボード で引き換えてください。
ベンチマーク記録は、試行 1 回ごとに 1 行を持ち、リトライと紐づく安定したジョブ ID を保持するべきである。
以下のフィールドは、プロバイダーの API スキーマではなく、編集用の報告テンプレートである:
| フィールド | 記録内容 |
|---|---|
| ジョブ ID と試行 ID | この試行がどの計画されたチャレンジに属するか |
| チャレンジファミリーとバリアント | 比較対象の正確なタスクカテゴリ |
| プロバイダーとクライアントのバージョン | 使用したサービスと連携部分 |
| 送信時刻と結果時刻 | API レイテンシの算出に必要な情報 |
| 受け入れ時刻とその証拠 | 観測可能なら、アプリケーションが応答を受け入れた時刻 |
| 最終結果 | 受け入れ、拒否、タイムアウト、API エラー、セットアップ失敗など |
| リトライ番号 | 初回試行か、後続の試行か |
| 課金額 | 入手できる場合は実際のコストと、その課金基準 |
共有ベンチマークレポートには、API キー、生の応答トークン、無関係な個人情報を保存しないこと。必要な場合は制限付きの診断情報を別途保持する。通常は、完全なリクエストそのものをスプレッドシートにコピーするよりも、マスクされたタスク参照と結果の方が役に立つ。
API テスト のアサーションを用いて、結果の定義を再現可能にする。バックエンドが可視範囲外にある場合は、観測可能なアプリケーション側のシグナルを記録し、それを「アプリケーション受け入れ」と呼ぶにとどめ、内部の検証スコアにアクセスしているかのような主張はしないこと。
有用な結果とは、受け入れ率、待ち時間、リトライ、サンプル数のトレードオフを、単一スコアに押し込めずに説明しているものである。
次の 仮定の計算例 を考える(実在サービスの比較ではない):
| 計画された初回試行数 | 初回で受け入れられた件数 | 初回試行受け入れ率 | リトライ後に追加で完了したジョブ数 | 最終的に完了したジョブ数 |
|---|---|---|---|---|
| 100 | 90 | 90% | 5 | 95 |
初回試行受け入れ率は 90 ÷ 100 で 90%。最終完了率は 95 ÷ 100 で 95%。どちらの数字も、リトライにどれだけ時間がかかったか、何回分が追加で課金されたかは教えてくれない。実際のレポートには、それらを示す別カラムが必要である。
次に、20 回の成功試行時間があったとする:18 回は 2 秒、2 回は 20 秒かかった。平均値は 3.8 秒、中央値は 2 秒になる。最近傍順位の定義を用いると、p95 は 20 秒である。3 つの文はいずれも同時に成り立ちうるが、単一の平均値だけでは長い待ち時間が隠されてしまう。
小さなサンプルを報告する際は、どのパーセンタイル計算方法を用いたかを明示する。ソフトウェアによってはパーセンタイルを補間する方法が異なるため、説明のない小数点以下の差を「意味のあるプロバイダー優位」として扱うべきではない。
短期トライアルから得られる僅差を、恒久的な順位付けとして扱わないこと。関連する期間にわたって測定を繰り返し、すべてのグループについて評価件数を示す。あるサービスを 1 種類のチャレンジファミリーでしかテストしていないなら、その結果の横に必ず明記する。
reCAPTCHA v3 のスコアは「インタラクションに対する評価」であり、ソルバーの「パーセンテージ精度」としてラベルを付け替えるべきではない。
Google の reCAPTCHA v3 ガイドは、スコアに基づく判断や、バックエンドでの expected action の確認について説明している。どのように評価を利用するかは、受信側アプリケーションが決める。そのため、このスコアフィールドは「100 件の計画ジョブのうち 90 件が受け入れられた」という値とは意味が異なる。
自分の所有するアプリケーションであれば、トライアルで用いた受け入れルールを記録し、プロバイダー間で一貫して保つ。正当なアクセス権がある場合は、スコア分布を別途報告する。ワークフローが継続したかどうかだけを観測しているなら、隠れたスコアを想像したり、すべての受け入れ結果が同じしきい値に達していると仮定したりしてはならない。
実際に運用するワークフローに適合する受け入れ率と応答時間分布を示すソルバーを選ぶ。
判断基準はトライアル前に設定する。インタラクティブなワークフローは、オフラインバッチよりも厳しい待ち時間制約を持つかもしれない。バッチ処理であれば、待ち時間は多少長くてもかまわない代わりに、明確な最終完了目標やコスト上限が重要になる。これはワークロードの要件であり、「あるプロバイダーを普遍的に最速」と宣言する理由にはならない。
エージェント駆動のワークフローについては、CAPTCHA ツールコール評価ガイド が関連する別の論点、すなわちエージェントがツールを正しく選択・呼び出せているかを扱っている。ここで説明したソルバー性能比較とは分けて評価すること。
CapSolver を含むすべての候補を、同じタスク定義と受け入れ基準で評価する。有用なベンチマークとは、「何が成功したのか」「どれくらい時間がかかったのか」「どこまでが証拠として確認できるのか」を読者が説明できるようにするものである。
Q: 良い CAPTCHA ソルバーの精度率とは?
有用な目標値は、チャレンジファミリーとワークフロー要件によって変わる。代表的なサンプルで「受け入れられた結果」を比較し、どの分母を用いたかを明示したうえでパーセンテージを評価すること。
Q: 最も速い API 応答が、最も速い「利用可能な解答」になるのか?
そうとは限らない。送信受理、解答の返却、アプリケーション側での受け入れは別々のイベントである。読者の要件に合致するイベントを測定すること。
Q: 失敗した試行はレイテンシのパーセンタイル計算から除外すべき?
成功試行のレイテンシを別途報告することはできるが、失敗やタイムアウトの締め切りも、それと並べて見えるようにしておく必要がある。さもないと、速いサブセットだけがワークロード全体を誤って代表してしまう。
Q: 同じトークンを再利用してプロバイダーをテストできる?
いいえ。1 回限りの検証トークンは、再生ベースの比較には不適切である。トークンワークフローには、新規で等価かつ許可されたトライアルを使用すること。
Q: この記事は CAPTCHA 解決サービスを順位付けしている?
いいえ。ここで示しているのは比較手法と、あくまで仮想的な算術例だけである。性能ランキングには、明示された可比条件の下での実測値が必要になる。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
ウィジェットの読み込み状況、ソルバーAPIのレスポンス、トークンの検証、そしてアプリケーション側の結果を確認することでCAPTCHAエラーを修正してください。各段階ごとに明確なトラブルシューティング手順に従いましょう。
VisionEngineモジュールを、文書化された画像入力に対応付け、タスク応答から角度または距離の結果を読み取ります。
