🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Sep 29, 2026
更新されました Sep 29, 2026 · 最小読み取り
大規模言語モデルは、不一貫したウェブコンテンツを有用な記録に変換できますが、信頼できるページデータを取得するために必要な運用作業を削除しません。プロダクションパイプラインには、許可チェック、リクエスト制限、JavaScriptが必要な場合のブラウザ実行、検証チェックポイントの明示的な処理、データベースに記録が到達する前の決定論的な検証が必要です。
GLM-5.3は、解釈レイヤーで役立ちます。API互換性のあるワークフローにより、レンダリングされたコンテンツを分類し、テキストをスキーマにマッピングし、フィールドが欠如している理由を説明し、ページ間の違いを正規化するのに役立ちます。認可された自動化がサポートされている検証タスクに遭遇した場合、CapSolverは抽出の前に配置され、アプリケーションがページセッションを保持し、最終結果を検証する責任を負います。
このガイドは特定のウェブサイトの指示ではなく、一般的なアーキテクチャを提示しています。公開データまたは他の方法で認可されたデータにのみ使用し、ワークフローがログイン、支払い、個人データ、または承認されていない範囲の権限境界に達した場合は停止してください。
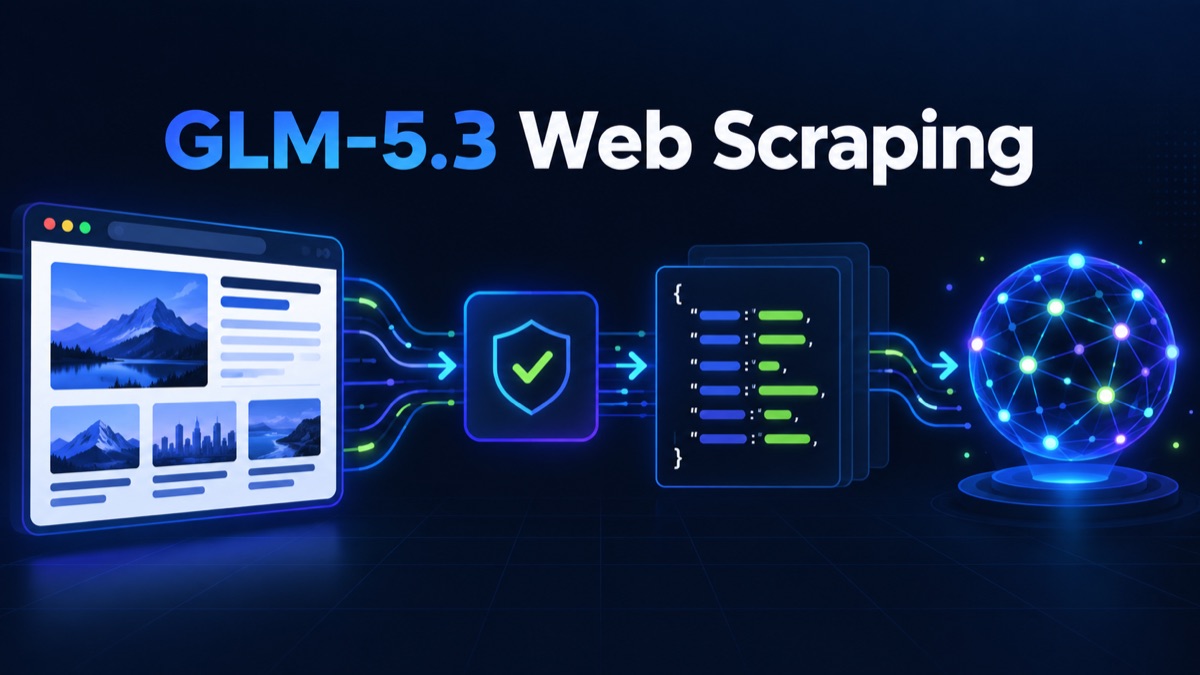
信頼性の高いGLM-5.3ウェブスクレイピングシステムは、小さなステージのシーケンスを使用します。各ステージは、次のステージが検証できるタイプの出力を生成します。
| ステージ | 責任 | 期待される出力 | ストップ条件 |
|---|---|---|---|
| 許可ゲート | ターゲット、データ範囲、レート、目的の確認 | 承認されたジョブ定義 | 範囲が認可されていない |
| アクセスレイヤー | ページの取得またはレンダリング | ステータス、ヘッダー、最終URL、HTMLまたはスクリーンショット | ログイン、支払い、プライベートデータ、またはアクセス拒否 |
| レスポンス分類器 | コンテンツ、空のシェル、レートリミット、または検証ページの識別 | 名前付きページ状態 | 知らないまたはサポートされていない状態 |
| 検証アダプター | 許可された場合に1つのドキュメント済みタスクを送信 | 準備完了、処理中、または終了エラー | デッドラインまたはリトライ予算に達した |
| GLM抽出 | 許可されたコンテンツを厳密なスキーマに変換 | 候補JSON記録 | 出力が無効または証拠によってサポートされていない |
| 決定論的検証 | タイプ、必須フィールド、重複、およびソース証拠の確認 | 受け入れられた記録または明示的な拒否 | 任意のビジネスルールが失敗 |
| ストレージ | 非破壊的な書き込みを実行 | 安定した記録IDとトレースリンク | ソースキーが既に存在し、新しいバージョンがない |
アクセスと解釈の間の最も重要な境界は、モデルがチャレンジページのHTMLを受信した場合、それがターゲットコンテンツとして自信を持って説明される可能性があることです。モデルにプロンプトを送信する前に、応答を分類してください。
オーケストレーションの例では、Python 3.11以降とrequestsパッケージを使用します。資格情報を環境変数に保持し、ソースコード、プロンプト、ログ、スクリーンショット、またはコミットされた構成に含めないでください。
python -m venv .venv
source .venv/bin/activate
pip install requests

export ZAI_API_KEY="replace-with-your-z-ai-key"
export CAPSOLVER_API_KEY="replace-with-your-capsolver-key"
公式Z.ai APIドキュメントでは、https://api.z.ai/api/paas/v4/chat/completionsでチャットコンプリーションエンドポイントを使用します。デプロイメント前にGLM-5リポジトリまたはZ.aiコンソールで現在のモデル識別子を確認してください。このガイドでは、環境設定可能なデフォルトとしてglm-5.3-flashを使用します。
モデルに「すべての重要な情報を抽出する」ように依頼しないでください。ページを収集する前に、フィールド、許可されたnullの動作、および証拠の要件を定義してください。
from dataclasses import dataclass
from datetime import datetime, timezone
from typing import Any

@dataclass(frozen=True)
class ExtractionJob:
    source_url: str
    allowed_host: str
    required_fields: tuple[str, ...]
    max_input_chars: int = 40_000

def validate_record(job: ExtractionJob, record: dict[str, Any]) -> dict[str, Any]:
    missing = [name for name in job.required_fields if not record.get(name)]
    if missing:
        raise ValueError(f"missing_required_fields:{','.join(missing)}")
    if record.get("source_url") != job.source_url:
        raise ValueError("source_url_mismatch")
    record["validated_at"] = datetime.now(timezone.utc).isoformat()
return recordモデルは、スキーマが明示的に許可した場合にのみnullを返すことができます。必須値は通常のコードでページ証拠に対して確認する必要があります。
アクセスレイヤーは、単なるHTML文字列ではなく、小さな状態オブジェクトを返す必要があります。分類器は、ステータスコード、最終URL、コンテンツタイプ、予期されるセレクター、および既知のチェックポイントマーカーを使用できます。
from enum import Enum

class PageState(str, Enum):
    CONTENT = "content"
    JAVASCRIPT_REQUIRED = "javascript_required"
    RATE_LIMITED = "rate_limited"
    LOGIN_REQUIRED = "login_required"
    VERIFICATION = "verification"
    UNKNOWN = "unknown"

def choose_action(state: PageState) -> str:
    return {
        PageState.CONTENT: "extract",
        PageState.JAVASCRIPT_REQUIRED: "render_in_authorized_browser",
        PageState.RATE_LIMITED: "back_off",
        PageState.LOGIN_REQUIRED: "stop_for_operator",
        PageState.VERIFICATION: "evaluate_supported_task",
        PageState.UNKNOWN: "stop_for_review",
    }[state]
HTTP 403とHTTP 429は、ジェネリックなリトライループに入れないでください。拒否されたリクエストには、許可と構成のレビューが必要です。レートリミットされたリクエストには、グローバルな並行性の削減と、サーバーが提供するリトライウィンドウの尊重が必要です。
CapSolverの公式APIは、ドキュメント済みタスクを送信するためにcreateTaskを使用します。非同期タスクはgetTaskResultで確認されます。アプリケーションは、現在のタスクドキュメントからタスクタイプを選択し、その許可されたチェックポイントに必要なフィールドのみを渡す必要があります。
import os
import time
import requests

CAPSOLVER_BASE = "https://api.capsolver.com"

def solve_supported_task(task: dict, *, timeout_seconds: int = 45) -> dict:
    api_key = os.environ["CAPSOLVER_API_KEY"]
    created = requests.post(
        f"{CAPSOLVER_BASE}/createTask",
        json={"clientKey": api_key, "task": task},
        timeout=15,
    ).json()
    if created.get("errorId") != 0:
        raise RuntimeError(created.get("errorCode", "create_task_failed"))
    if created.get("status") == "ready":
        return created["solution"]

    task_id = created.get("taskId")
    if not task_id:
        raise RuntimeError("missing_task_id")

    deadline = time.monotonic() + timeout_seconds
    while time.monotonic() < deadline:
        time.sleep(3)
        result = requests.post(
            f"{CAPSOLVER_BASE}/getTaskResult",
            json={"clientKey": api_key, "taskId": task_id},
            timeout=15,
        ).json()
        if result.get("errorId") != 0:
            raise RuntimeError(result.get("errorCode", "task_failed"))
        if result.get("status") == "ready":
            return result["solution"]
        if result.get("status") not in {"idle", "processing"}:
            raise RuntimeError("unexpected_task_status")

    raise TimeoutError("verification_task_deadline_exceeded")
呼び出し元は、デフォルトで1回の制限付き試行のみを許可する必要があります。返された解決策は、同じブラウザコンテキストでチェックポイントを検出したドキュメントされた統合経路を通じて適用される必要があります。ページが予期された状態に遷移しない場合、失敗を返すか、人間のレビューを要求してください。
CapSolverのボーナスコードを取得
自動化予算を即座に増やす!
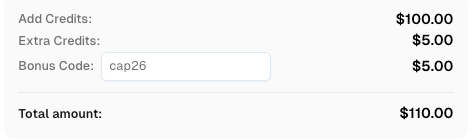
CapSolverアカウントにチャージするときにボーナスコードCAP26を使用すると、すべてのチャージで5%のボーナスを取得できます—制限なし。
CapSolverダッシュボードで今すぐ利用してください
ページがコンテンツとして確認されたら、ナビゲーションノイズ、スクリプト、非表示要素、繰り返されるバナー、および関係のないページの装飾を削除してください。見出し、ラベル、テーブル、ソース参照を保持してください。ブラウザクッキー、認証ヘッダー、個人データ、またはローカルセッショントレースをモデルに送信しないでください。
import json
import os
import requests

ZAI_ENDPOINT = "https://api.z.ai/api/paas/v4/chat/completions"

def extract_with_glm(job: ExtractionJob, normalized_text: str) -> dict:
    prompt = {
        "source_url": job.source_url,
        "required_fields": list(job.required_fields),
        "rules": [
            "1つのJSONオブジェクトを返し、説明文は含めないでください。",
            "ページテキストに存在する証拠のみを使用してください。",
            "欠落した必須値を推測しないでください。",
            "source_urlを提供された通りに含めてください。",
        ],
        "page_text": normalized_text[: job.max_input_chars],
    }
    response = requests.post(
        ZAI_ENDPOINT,
        headers={
            "Authorization": f"Bearer {os.environ['ZAI_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "model": os.getenv("GLM_MODEL", "glm-5.3-flash"),
            "messages": [
                {"role": "system", "content": "証拠に基づく構造化されたデータを抽出してください。"},
                {"role": "user", "content": json.dumps(prompt, ensure_ascii=False)},
            ],
            "temperature": 0,
        },
        timeout=60,
    )
    response.raise_for_status()
    content = response.json()["choices"][0]["message"]["content"]
    return json.loads(content)
この例をアダプタ境界として扱ってください。プロダクション使用前に、公式Z.aiドキュメントで現在のリクエストオプションと構造化出力機能を確認してください。モデルがJSONをMarkdownでラップしている場合や、契約外のテキストを返している場合、静かに修復しようとせず、応答を拒否してください。
2つの異なる検証が必要です。
まず、ブラウザの結果を検証してください。最終URL、予期される見出し、ターゲットコンテナ、および新しいエラーの不在が意図されたワークフローに一致していることを確認してください。成功したタスク応答だけでは、ページが継続した証拠とはなりません。
次に、抽出された記録を検証してください。必須文字列、数値範囲、日付、正規化されたURL、重複キー、証拠スニペットを確認してください。高影響フィールドの場合、値を決定論的なセレクターまたはページの2つの独立した表現と比較してください。
def run_extraction(job: ExtractionJob, state: PageState, page_text: str) -> dict:
    action = choose_action(state)
    if action != "extract":
        raise RuntimeError(f"page_not_ready_for_model:{action}")
    candidate = extract_with_glm(job, page_text)
    return validate_record(job, candidate)
この最終的なゲートは、チャレンジページ、モデルの誤認、または部分的なレンダリングがデータセットに成功したスクレイピングとして入力されることを防ぎます。
トレースID、ソースURL、最終URL、ページ状態、コンテンツハッシュ、モデル名、プロンプトバージョン、スキーマバージョン、検証結果、処理時間を記録してください。一時的な運用デバッグのためにタスクIDとエラーコードを保存してくださいが、解決トークン、シークレット、または関係のないセッションデータは保存しないでください。
ジョブ全体に1つの予算を適用してください。HTTP試行回数、ブラウザナビゲーション、検証試行回数、GLM呼び出し、入力文字数、経過時間をカウントしてください。予算が使い切られた場合、1つのコンポーネントがワークフローを再起動するのではなく、タイプ付きの失敗を返してください。
役立つメトリックのセットには以下が含まれます:
| 症状 | おそらくの原因 | 正しい対応 |
|---|---|---|
| GLMが検証ページの詳細を返す | プロンプトの前に応答が分類されていない | モデル呼び出しを停止し、ページ状態検出を修正 |
| JSONはパース可能だが必須フィールドが空 | プロンプトまたはソース証拠が不完全 | 記録を拒否し、正規化されたコンテンツを検査 |
| タスクは準備完了だがページはブロックされたまま | ブラウザコンテキストまたはタスクパラメータが一致しない | URL、セッション、ユーザーエージェント、タイミング、ドキュメント済み要件を比較 |
| コストが増加するが受け入れられた記録は変化しない | ブラウザまたはモデルのエスカレーションが広すぎる | 決定論的なフィルターとジョブごとの予算を追加 |
| リトライ後に重複行が表示される | ストレージが非破壊的ではない | 安定したソースキーとコンテンツバージョンでアップサート |
| HTTP 429が繰り返される | 並行性はワーカーごとに制御され、グローバルには制御されない | シェアされたレート予算を導入し、リトライガイドラインを尊重 |
GLM-5.3はウェブデータ抽出をより柔軟にしますが、信頼性は周囲のシステムから得られます。アクセス制御、レンダリング、ページ状態分類、検証処理、スキーマ検証、ストレージを明示的なステージとして保持してください。アプリケーションが意図したコンテンツを見ていることを確認した後で、モデルを使用してください。
認可されたブラウザワークフローでサポートされている検証タスクがある場合、CapSolverはドキュメントされたタスク境界を提供できます。アプリケーションは、許可、セッションの継続、制限付きリトライ、シークレットの処理、および元のワークフローが完了したことを証明する責任を負います。
Q: GLM-5.3はWebスクレイピングでブラウザを置き換えることができますか?
A: いいえ。テキスト、スクリーンショット、または正規化されたレコードを解釈できますが、ナビゲーション、レンダリング、状態、権限、最終結果の検証はブラウザやHTTPクライアントが担当しています。
Q: 生のHTMLをGLM-5.3に直接送るべきですか?
A: 通常はいきません。応答をまず分類し、スクリプトや繰り返しのレイアウトノイズを削除し、意味のあるラベルと構造を保持し、抽出スキーマに必要なデータに制限してください。
Q: ワークフローがCapSolverを呼び出すのはいつですか?
A: 許可されたワークフローでサポートされているタスクを検出した後のみです。現在のドキュメントに記載されているタスクタイプを使用し、必要なブラウザコンテキストを保持し、期限を設定し、ページが実際に続いていることを確認してください。
Q: 有効なJSONは抽出されたレコードが正しいことを意味しますか?
A: いいえ。JSONの構文は事実の正確性を証明しません。必須フィールド、型、URL、日付、数値範囲、重複、およびソースの証拠はすべてコードで確認する必要があります。
Q: ページの状態が不明な場合どうすればよいですか?
A: 停止し、レビューを要求してください。不明なコンテンツをモデルに送信したり、追加のブラウザと検証ステップで再試行したりしないでください。
Q: この設計はプライベートまたは制限されたデータに使用できますか?
A: この設計は権限を生成しません。公開されているまたは他の方法で承認されたデータにのみ使用してください。収集される情報を最小限に抑え、適用可能な条項、契約、および法律に従ってください。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について