
🎉新着AI エージェント向け CapSolver-MCP、エージェントツール、SDK 統合
Sora Fujimoto
AI Solutions Architect
発行済み Apr 24, 2025
更新されました Sep 23, 2026 · 最小読み取り
画像ベースのCAPTCHAは、ブラウザのオートメーション、AIベースのCAPTCHA解決、およびウェブスクリーニングにおいて現在、最大の障壁の一つとなっています。2024年のWeb Data Labのレポートによると、オートメーションプロジェクトの61%が画像ベースのCAPTCHAを失敗の最大の要因として挙げており、IPのブロックやスクリプティングの問題よりも多いです。
多くの大手ECプラットフォームや他の企業は、基本的なOCRや一般的なAI画像分析モデルでは解決できない複雑なスライダー、回転、視覚的パズルを採用しています。これらの防御は従来のソルバーでは対応できません。リアルワールドの複雑さに適応できる、機械学習を駆動するタスク固有の画像認識システムが必要です。
そのため、私たちはVision Engineを構築しました。これは、CapSolver の高度なAIベースのCAPTCHAソルバーであり、高い成功確率、高速なレスポンス、そして困難なオートメーションシナリオに合わせた完全なカスタマイズを提供します。
近年、AIベースの画像認識は、オブジェクト検出、画像分類、マルチオブジェクトセグメンテーションなどのタスクで大きな進歩を遂げました。従来のCNNアーキテクチャは構造化されたデータで優れた性能を発揮しますが、新しいトランスフォーマーに基づくモデルは強力な一般化能力と文脈理解を提供します。しかし、複雑で多様な画像ベースのCAPTCHAチャレンジを解決するには、古典的な画像処理、ディープラーニングモデル、そして大規模言語モデル(LLM)を介した推論を組み合わせたハイブリッドアプローチが不可欠です。
CapSolverのVision Engineは、この原則に基づいて構築されています。CapSolverのVision Engineのコアには、現代の画像ベースのCAPTCHAチャレンジを解決するために特別に訓練された強力なAIモデルが含まれています。汎用的なOCRやビジョンモデルとは異なり、Vision Engineは高精度、リアルタイム性能、そして幅広い視覚的検証タスクへの適応性に最適化されています。
トップのCAPTCHAソリューションを取得してください - CapSolver: VISION。利用すると、各チャージ後に5%のボーナスが追加されます。無制限
私たちは高度にカスタマイズ可能なソリューションに特化しています。タスクの複雑さ、更新頻度、緊急性に基づいて、1〜5営業日以内に初期モデルを提供します。最初のバージョンは完璧ではありませんが、高速で効率的で、リアルタイムレスポンスをサポートしています。一方、私たちは自動的に解決済み/未解決のサンプルを収集し、十分なデータが集まると強化トレーニングをトリガーします。1〜3回の更新サイクル後、モデルは通常90%以上の精度に達します。(詳細は下記のサポートされる画像タイプをご覧ください。)
Vision Engineにより、CapSolverは単なるAI認識を越えて、あなたのニーズに合わせて進化し、現代のCAPTCHA防御を乗り越える高速でスケーラブルなソリューションを提供します。
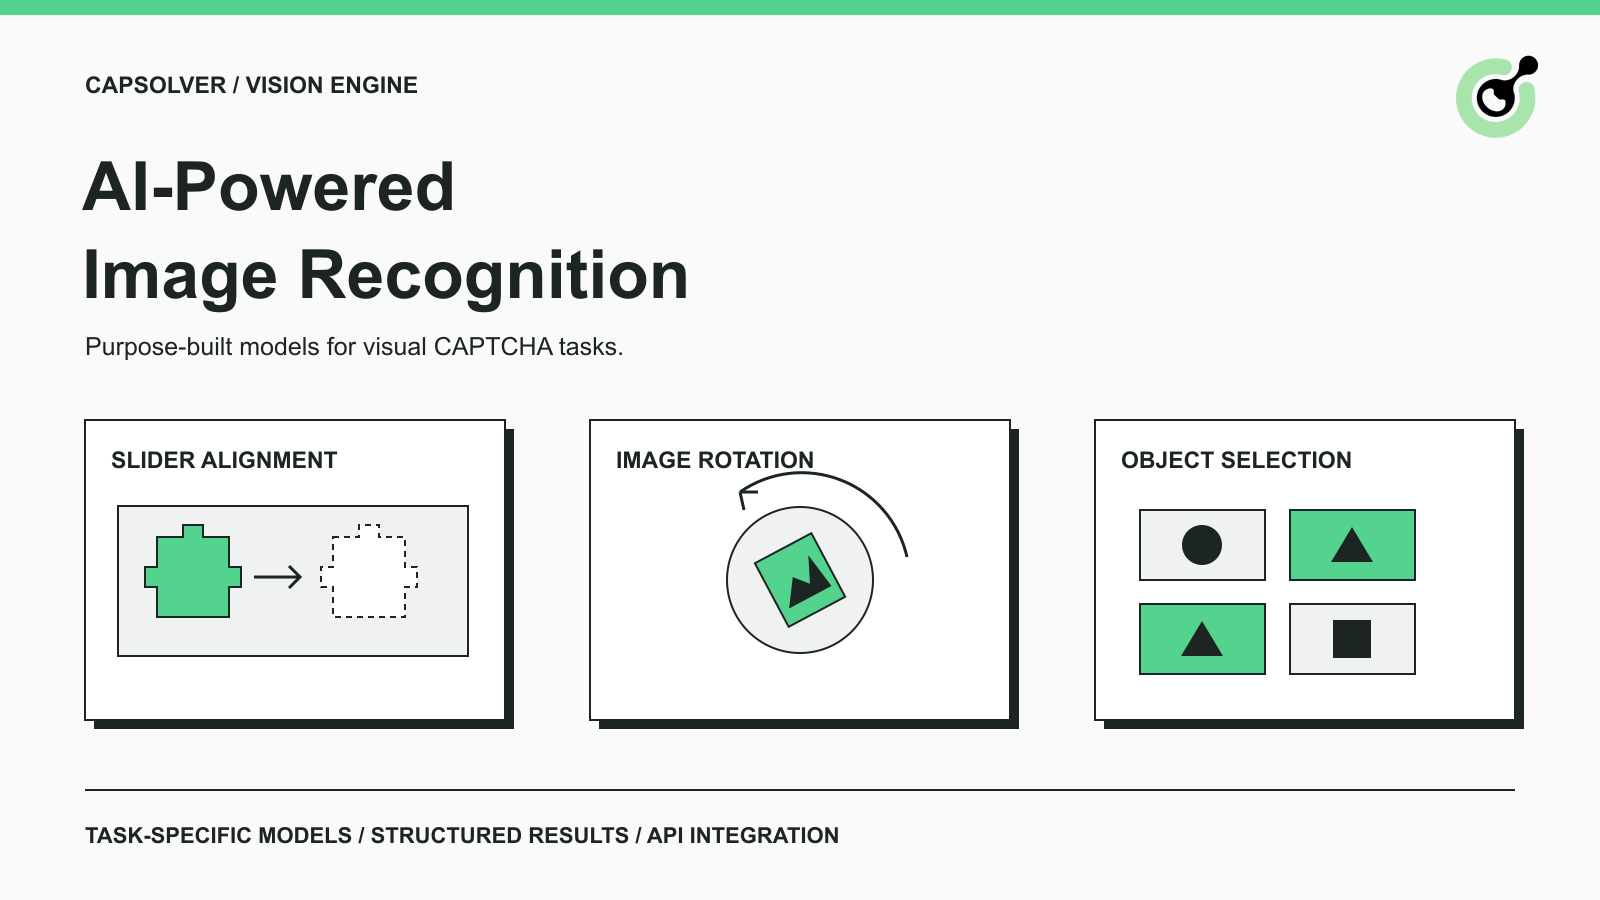
画像ベースのCAPTCHAシステムの増加する複雑さに対応するため、Vision Engineは現代のウェブアプリケーションで使用される幅広い視覚形式を処理するようにトレーニングされています。その強みは、さまざまな相互作用シナリオに特化した複数の画像タイプをサポートすることにあります。
slider_1 – 標準的なスライダーパズルCAPTCHA
rotate_1 – 傾いた画像の整列が必要な回転チャレンジ。
shein- SHEINウェブサイトを模したCAPTCHAチャレンジ。通常、特定のファッションアイテム(例:バッグや靴)をクリックする画像ベースのタスク。ファッション関連の画像内の視覚的認識に焦点を当てています。
space_detection – オブジェクトの位置を検出する空間的推論パズル。
slider_temu_plus – 拡張された複雑さとスタイルの変化を持つカスタマイズされたスライダー。
select_temu – 複数の画像選択からオブジェクト選択タスクを実行し、ユーザーのクリックをシミュレートします。各カテゴリは、Vision Engineのモジュールベースの認識モデルを通じて特に最適化されており、すべての形式でミリ秒単位の応答速度と一貫した高い成功確率を確保しています。👉 完全なタスク形式とリクエスト例については、ドキュメントを参照してください。
多様な画像ベースのCAPTCHAの需要が増加する中、CapSolverのVision Engineは複数の専門的なモデルアーキテクチャを使用しています。これらのモデルは、さまざまなシナリオで高い精度とパフォーマンスを確保しながら、高速でスケーラブルなソリューションを提供します。
カスタムモデルアーキテクチャ: すでに5種類以上のモデルアーキテクチャが使用されており、Vision Engineが幅広いCAPTCHAタイプに適応可能であることを保証します。
効率的なトレーニングとデータ収集: ユーザーのニーズ、トラフィック量、サイトの更新頻度に基づいて、半自動、完全自動、またはハイブリッドアプローチを実装し、迅速なデータ収集、モデルの向上、継続的な更新を確保します。
高速なエンドツーエンドソリューション: ユーザーとのコミュニケーションコストを最小限に抑えるために、迅速でカスタマイズされたソリューションを提供し、タスクの複雑さに応じて1〜5営業日でテスト用モデルを提供します。
CapSolverのVision Engineは、画像ベースのCAPTCHAチャレンジの3つの主要なカテゴリをサポートしており、それぞれ開発とモデルカスタマイズに異なるアプローチが必要です:
| カテゴリ | 含まれるタスクタイプ | 説明 | 開発時間 | モデル精度 | モデル速度 |
|---|---|---|---|---|---|
| 1. 高精度単一画像 | slider_1, rotate_1 |
単一の画像要素の高精度な画像の整列または配置が必要です。 | 1–3営業日 | > 95% | 0–200 ms |
| 2. 変動コンテンツ、固定タイプ | space_detection, shein |
画像形式は一貫していますが、コンテンツ(オブジェクト、テキスト、または視覚的ターゲット)はチャレンジごとに異なります。 | 3–5営業日 | > 80% | 200–600 ms |
| 3. 変動コンテンツとタイプ | slider_temu_plus, select_temu |
タスク形式とコンテンツの両方が変化します。通常、複数の可能な答えや画像選択を含みます。 | 3–5営業日(確認済み) | > 80% | 200–1000 ms(依存) |
CapSolverのVision Engineを使用すると、信頼性の高いソリューションだけでなく、あなたのニーズに合わせて進化する技術を提供します。すべての相互作用を通じて改善し、最も効率的で正確なCAPTCHA解決ソリューションを確保します。
CapSolverのVision Engineは、スクリーニングやブラウザオートメーションワークフローにシームレスに統合されるように設計されています。強力なAPIサポートにより、開発者はCAPTCHA解決タスクを簡単に自動化し、Vision Engineをさまざまなプロジェクトに簡単に統合できます。Python、JavaScript、その他の言語で作業している場合でも、統合プロセスは簡単で効率的です。
公式Vision Engine Python例は、slider_1を使用してスライダーパズルを認識します。この例では、Python、capsolverパッケージ、APIキー、およびチャレンジに認可されたスライダーと背景画像が必要です。
pip install --upgrade capsolverでパッケージをインストールします。以下は、元のプレースホルダーを含む公式の例です。実行する前に置き換えてください:
# pip install --upgrade capsolver
# export CAPSOLVER_API_KEY='...'

import capsolver

capsolver.api_key = "..."

solution = capsolver.solve({
    "type": "VisionEngine",
    "module": "slider_1",
    "image": "/9j/4AAQSkZJRgABA......",
    "imageBackground": "/9j/4AAQSkZJRgABA......"
})
print(solution)capsolver.api_keyをあなたのキーに置き換え、imageをスライダー画像の完全なBase64コンテンツに、imageBackgroundを対応する背景に置き換えてください。上記の短縮された画像文字列は使用できません。Base64値から改行とデータURLの接頭辞を削除してください。完成した例をvision_slider.pyとして保存し、python vision_slider.pyを実行してください。
slider_1の場合、ドキュメントに記載された結果には、提出された画像から計算されたスライダーの変位であるdistanceが含まれます。APIの例ではsolution.distanceが213と表示されていますが、これはあくまで例示的な値であり、すべてのパズルに固定された設定ではありません。
Vision Engineは認識データを返します。ブラウザオートメーションは、そのページが受け入れるかどうかを確認するために対応する操作を実行する必要があります。直接APIを呼び出す場合、createTaskは別途getTaskResultをポーリングするステップなしに認識結果を返します。
Vision Engineは、ユニークな視覚的チャレンジ用のカスタム画像認識モデルを迅速に提供する能力で際立っています。複雑なECサイトのCAPTCHAやニッチな形式に取り組んでいる場合でも、私たちのチームはあなたの要件を引き受けて、最短3〜7日で動作するAPIをデプロイできます。
最近のケースでは、大規模小売プラットフォーム向けに3日以内に運用可能なスライダーキャプチャモデルを提供し、高い精度と安定性を達成しました。
スムーズな統合を確保するために、CapSolverは以下を提供します:
以下は、あなたのカスタムモデルを迅速にオンラインにする方法です:
graph TD
  A[要件提出] --> B[モデル評価]
  B --> C[データセット準備]
  C --> D[モデルトレーニング]
  D --> E[APIデプロイ]
  E --> F[統合サポート]

  classDef stage fill:#e0f7fa,stroke:#00acc1,stroke-width:2px;
class A,B,C,D,E,F stage;CapSolver のVision Engineは、ツールにとどまらず、現実世界のオートメーションの課題に直面する開発者にとってスマートで進化し続けるソリューションです。スライダーまたは空間的パズルを解決する場合でも、私たちのAI駆動エンジンはタスクごとに強化され、類を見ない正確性、スケーラビリティ、開発者フレンドリーさを提供します。
Q1: 画像認識でAIはどのように使用されますか?
AIは、深層学習(特に畳み込みニューラルネットワーク)を使用して、画像のパターン、形状、文脈的コンテキストを認識することで画像を分析します。CAPTCHAのシナリオでは、AIモデルは複雑な視覚的パズルにおけるテキスト、レイアウト、オブジェクト配置、論理的な配置を理解するようにトレーニングされます。
Q2: AIは画像ベースのCAPTCHAを解決できますか?
はい。AIは現在、スライダーパズルからマルチステップの視覚的質問に至るまで、幅広い画像ベースのCAPTCHAを解決できます。Vision Engineは大規模なデータセットでトレーニングされており、これらを高い精度で処理できます。
Q3: カスタムモデルをリクエストできますか?
もちろんです。CapSolverはカスタムに調整された画像認識ソリューションを提供できます。リクエストからデプロイメントまで、複雑さとデータセットの可用性に応じて数日で完了します。
Sora Fujimoto
AI Solutions Architect
Connecting agents, browsers, and APIs into one workflow.
著者について
