🎉BARUCapSolver untuk agen AI-Integrasi MCP, alat agen, dan SDK
Ethan Collins
AI Agent Workflow Engineer
Diterbitkan Nov 13, 2026
Diperbarui Nov 13, 2026 · min baca
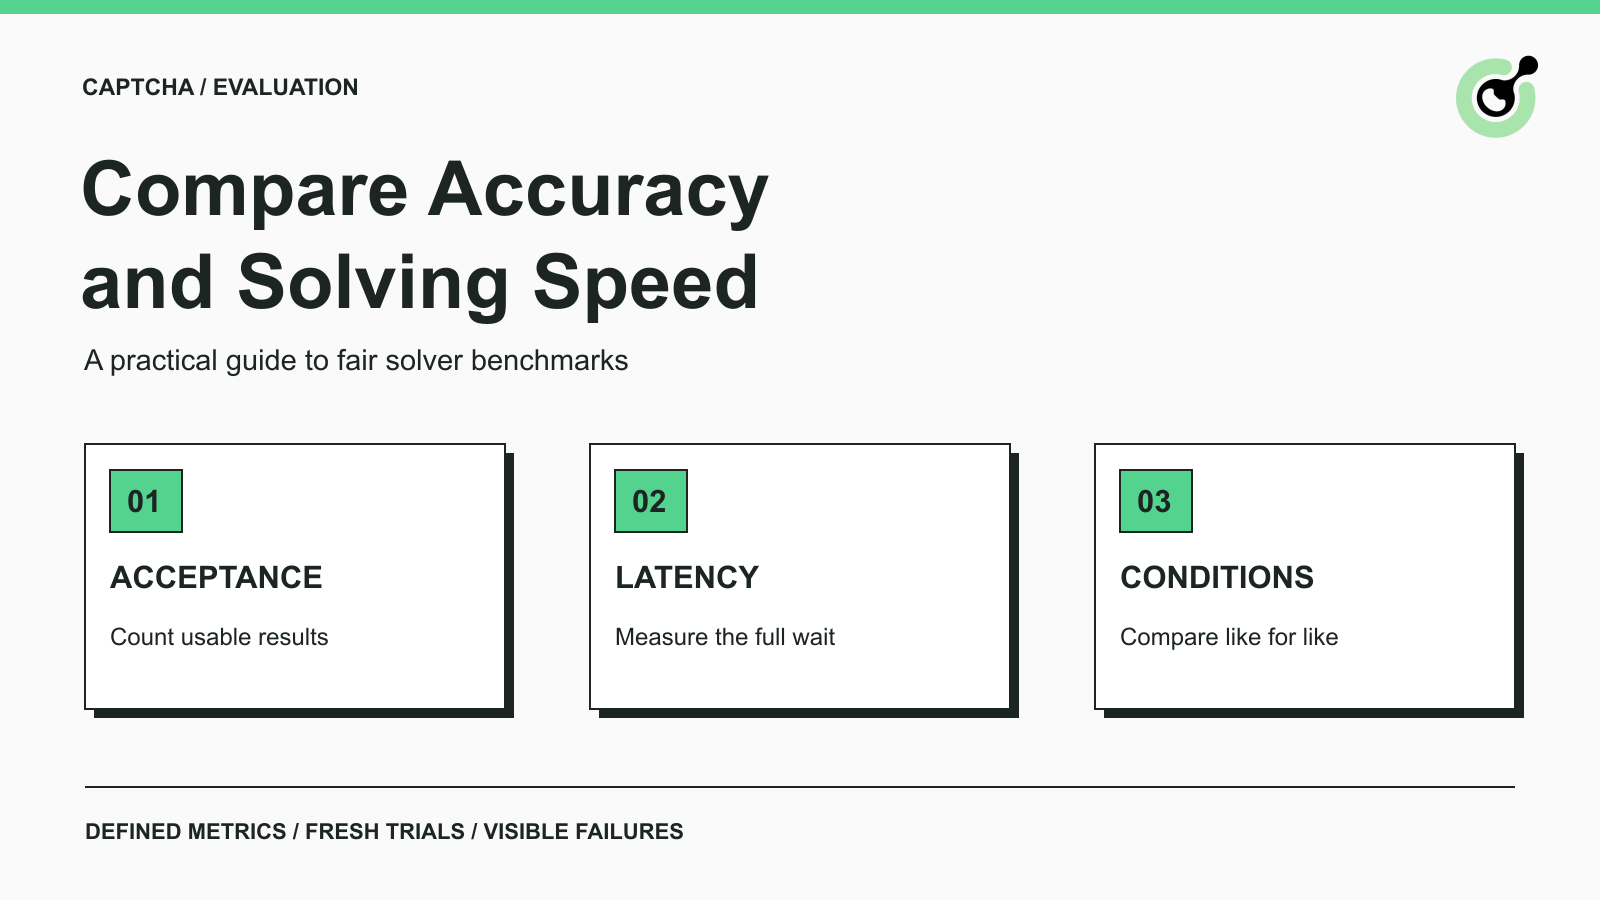
“Kilat” dan “akurat” hanya berguna bila pengukuran di balik klaim tersebut jelas. Satu solver CAPTCHA mungkin mengiklankan waktu untuk mengembalikan respons API, sementara yang lain melaporkan waktu untuk satu langkah browser yang lengkap. Persentase keberhasilan bisa menghitung token yang dikembalikan, tantangan yang diterima, atau pekerjaan yang diselesaikan setelah beberapa kali percobaan.
Panduan ini menjelaskan cara membandingkan pengukuran tersebut untuk beban kerja Anda sendiri yang diizinkan. CapSolver adalah salah satu layanan yang dapat dievaluasi melalui antarmuka task yang terdokumentasi. Metode di bawah ini tidak menyajikan papan peringkat penyedia yang terukur atau mengasumsikan layanan mana yang akan berkinerja terbaik.
Akurasi solver CAPTCHA harus menggambarkan hasil yang benar atau diterima untuk jenis tantangan tertentu dan penyebut yang dijelaskan dengan jelas.
Untuk tugas image-to-text dengan jawaban yang diketahui, pengenalan yang tepat adalah pengukuran yang berguna. Hitung apakah teks yang dikembalikan cocok dengan karakter yang diharapkan berdasarkan aturan aplikasi penerima. Jika aplikasi memperlakukan huruf besar/kecil sebagai signifikan, evaluasi yang mengabaikan huruf besar/kecil mengukur masalah yang berbeda.
Untuk tugas token, hasil yang lebih berguna adalah apakah aplikasi penerima menerima respons tantangan. Penyedia yang mengembalikan token tidak kosong hanya membuktikan pengiriman keluaran, bukan penerimaannya. Panduan validasi reCAPTCHA Google menjelaskan pengecekan backend yang memverifikasi respons tersebut.
Pisahkan tiga kuantitas berikut:
| Pengukuran | Pembilang | Penyebut | Pertanyaan yang dijawab |
|---|---|---|---|
| Tingkat solusi API | Task yang mengembalikan solusi yang terdokumentasi | Semua task valid yang dikirimkan | Apakah solver mengembalikan keluaran? |
| Penerimaan percobaan pertama | Tantangan yang diterima pada percobaan pertama | Semua percobaan pertama yang direncanakan | Apakah hasil awal berhasil? |
| Penyelesaian pekerjaan pada akhirnya | Pekerjaan yang selesai dalam jumlah percobaan dan tenggat yang diizinkan | Semua pekerjaan yang direncanakan | Apakah alur kerja lengkap terselesaikan? |
Permintaan uji yang salah bentuk harus dilaporkan sebagai kegagalan penyiapan. Jangan diam-diam menghapusnya dari laporan, tetapi hindari mengatribusikan kunci situs yang salah ke akurasi pengenalan. Nyatakan apakah penyebut yang dipublikasikan memasukkan atau mengecualikan kegagalan penyiapan dan alasannya.
Kecepatan solver harus diukur antara dua peristiwa yang diberi nama menggunakan jam yang konsisten dan definisi yang sama untuk setiap penyedia.
Catat ketika klien mengirimkan task, menerima solusi yang dapat digunakan, dan mengamati penerimaan oleh aplikasi. Stempel waktu ini membedakan latensi API dari pekerjaan tambahan yang diperlukan oleh aplikasi. Jika pengambilan task menggunakan polling, catat juga kebijakan polling: waktu ketika klien Anda menyadari penyelesaian bisa lebih lambat dari saat layanan sebenarnya selesai.
Kontrak getTaskResult CapSolver membedakan hasil pending dan ready untuk task asinkron. ImageToTextTask mengembalikan pengenalan secara langsung dari pembuatan task. Jangan memaksakan model pengukuran asinkron pada task sinkron atau membandingkan tipe task yang berbeda dalam satu kolom kecepatan.
Gunakan setidaknya median dan persentil ekor, seperti p95, untuk percobaan yang berhasil. Median menggambarkan tengah distribusi yang diamati; persentil ekor menunjukkan seberapa jauh lebih lama percobaan sukses yang lebih lambat berlangsung. Panduan SRE Google tentang distribusi latensi menjelaskan mengapa rata-rata dapat menyembunyikan perilaku di ekor.
Publikasikan juga jumlah timeout dan tenggat waktunya. Penyedia yang mengembalikan lima keberhasilan cepat dan timeout pada banyak percobaan lain tidak boleh tampak lebih unggul hanya karena kegagalan dikeluarkan dari rata-rata latensinya.
Perbandingan yang berguna mengelompokkan tantangan serupa dan menahan kondisi operasi utama tetap.
Pisahkan reCAPTCHA v2, reCAPTCHA v3, Turnstile, dan pengenalan teks-dalam-gambar. Di dalam satu keluarga, pertahankan varian dan parameter yang relevan. Hasil dari satu kategori tidak menetapkan kinerja pada kategori lain. Dokumentasi task reCAPTCHA v2 adalah contoh mengapa field permintaan yang spesifik varian itu penting.
Untuk setiap grup, catat lingkungan yang disetujui, lokasi klien, tingkat konkurensi, tenggat permintaan, kebijakan polling, jatah percobaan ulang, dan periode pengujian. Jangan memberikan satu penyedia satu permintaan pada satu waktu dan penyedia lain lonjakan pekerjaan simultan, lalu mengatribusikan seluruh perbedaan kepada solver.
Gunakan properti uji milik sendiri atau alur kerja dengan izin eksplisit untuk evaluasi ini. Mulailah dengan beban kecil yang didukung lingkungan. Halaman yang dapat diakses publik bukanlah lisensi untuk melakukan uji kinerja tanpa batas.
Uji yang setara membutuhkan kondisi tantangan yang sebanding, bukan penggunaan kembali token yang sudah dipakai. Google mendokumentasikan respons reCAPTCHA sebagai sekali pakai dengan masa hidup dua menit. Referensi validasi Turnstile Cloudflare secara serupa mengharuskan validasi sisi server dan menjelaskan masa hidup token lima menit dengan penggunaan sekali.
Rencanakan uji coba independen di bawah kondisi yang sama dan diizinkan. Jika memungkinkan, ubah urutan penyedia sepanjang periode uji alih-alih menguji satu layanan hanya saat interval sepi dan lainnya hanya saat interval sibuk. Pertahankan rencana penugasan sebelum melihat hasil.
Untuk pengenalan gambar offline, set gambar berlabel yang sama dan berizin dapat berguna. Untuk tantangan live yang berubah, jelaskan bagaimana sampel yang sebanding ditugaskan dan akui variasi yang tersisa. Jangan mengklaim eksperimen yang sepenuhnya terkontrol jika populasi tantangan berubah selama uji berjalan.
Redeem Your CapSolver Bonus Code
Tingkatkan anggaran otomasi Anda secara instan!
Gunakan kode bonus CAP26 saat mengisi saldo akun CapSolver Anda untuk mendapatkan bonus 5% tambahan pada setiap pengisian — tanpa batas.
Tukarkan sekarang di Dashboard CapSolver
Catatan benchmark harus mempertahankan satu baris per percobaan dan pengenal pekerjaan yang stabil yang menghubungkan percobaan ulang.
Field berikut membentuk template pelaporan editorial, bukan skema API penyedia:
| Field | Apa yang dicatat |
|---|---|
| Pengenal pekerjaan dan percobaan | Tantangan terencana mana yang menjadi milik percobaan ini |
| Keluarga dan varian tantangan | Kategori task tepat yang dibandingkan |
| Versi penyedia dan klien | Layanan dan integrasi yang digunakan |
| Waktu pengiriman dan hasil | Cukup informasi untuk menghitung latensi API |
| Waktu dan bukti penerimaan | Kapan aplikasi menerima respons, jika terlihat |
| Hasil akhir | Diterima, ditolak, timeout, error API, atau kegagalan penyiapan |
| Nomor percobaan ulang | Apakah ini percobaan awal atau percobaan berikutnya |
| Jumlah tagihan | Biaya aktual bila tersedia, dengan dasar penagihannya |
Jangan menyimpan kunci API, token respons mentah, atau informasi pribadi yang tidak terkait di laporan benchmark bersama. Simpan bukti diagnostik terbatas secara terpisah bila diperlukan. Referensi task yang disunting dan hasilnya biasanya lebih berguna daripada menyalin seluruh permintaan ke dalam spreadsheet.
Gunakan asersi pengujian API untuk membuat definisi hasil menjadi dapat diulang. Jika backend berada di luar jangkauan visibilitas Anda, catat sinyal aplikasi yang terlihat dan sebut sebagai penerimaan aplikasi alih-alih mengklaim akses ke skor validasi internal.
Hasil yang berguna menjelaskan trade-off antara penerimaan, penundaan, percobaan ulang, dan ukuran sampel alih-alih memampatkan semuanya menjadi satu skor.
Pertimbangkan contoh aritmetika hipotetis berikut, bukan perbandingan terukur layanan nyata:
| Percobaan pertama yang direncanakan | Diterima pada percobaan pertama | Penerimaan percobaan pertama | Pekerjaan tambahan selesai setelah percobaan ulang | Pekerjaan yang akhirnya selesai |
|---|---|---|---|---|
| 100 | 90 | 90% | 5 | 95 |
Tingkat penerimaan percobaan pertama adalah 90 dibagi 100, atau 90%. Penyelesaian pada akhirnya adalah 95 dibagi 100, atau 95%. Tidak satu pun angka tersebut memberi tahu Anda berapa lama percobaan ulang diperlukan atau berapa banyak percobaan tambahan yang ditagih. Hal-hal itu membutuhkan kolom terpisah dalam laporan nyata.
Sekarang pertimbangkan set hipotetis berisi 20 durasi percobaan sukses: 18 membutuhkan dua detik dan dua membutuhkan 20 detik. Rata-ratanya adalah 3,8 detik, sementara mediannya adalah dua detik. Dengan definisi nearest-rank, p95 adalah 20 detik. Ketiga pernyataan ini bisa benar; satu rata-rata saja menyembunyikan waktu tunggu yang panjang.
Nyatakan metode perhitungan persentil saat melaporkan sampel kecil. Perangkat lunak yang berbeda dapat menginterpolasi persentil secara berbeda, jadi perbedaan desimal yang tidak dijelaskan tidak boleh dipresentasikan sebagai keunggulan berarti suatu penyedia.
Hindari memperlakukan perbedaan kecil dari uji coba singkat sebagai peringkat permanen. Ulangi pengukuran selama periode yang relevan dan tampilkan jumlah kasus yang dievaluasi di setiap grup. Jika suatu layanan hanya diuji pada satu keluarga tantangan, nyatakan hal itu di samping hasilnya.
Skor reCAPTCHA v3 menggambarkan suatu interaksi yang dinilai dan tidak boleh diberi label ulang sebagai persentase akurasi solver.
Panduan reCAPTCHA v3 Google menjelaskan keputusan berbasis skor dan pengecekan aksi yang diharapkan di backend. Aplikasi penerima yang memutuskan cara menggunakan penilaian itu. Karena itu, field skor memiliki makna berbeda dari “90 dari 100 pekerjaan yang direncanakan diterima.”
Untuk aplikasi milik sendiri, catat aturan penerimaan yang digunakan dalam uji coba dan jaga konsistensinya di seluruh penyedia. Laporkan distribusi skor secara terpisah jika Anda memiliki akses sah ke sana. Jika Anda hanya mengamati apakah alur kerja berlanjut, jangan mengarang skor tersembunyi atau mengasumsikan setiap hasil yang diterima mencapai ambang batas yang sama.
Pilih solver yang distribusi penerimaan dan waktu respons yang diamati cocok dengan alur kerja yang benar-benar perlu Anda jalankan.
Tetapkan kriteria keputusan sebelum uji coba. Alur kerja interaktif mungkin memiliki anggaran waktu tunggu yang lebih ketat dibandingkan batch offline. Batch mungkin mentoleransi waktu tunggu lebih lama tetapi membutuhkan target penyelesaian akhir dan batas biaya yang jelas. Ini adalah kebutuhan beban kerja, bukan alasan untuk menyatakan satu penyedia sebagai yang tercepat secara universal.
Untuk alur kerja yang digerakkan agen, panduan evaluasi tool call CAPTCHA membahas pertanyaan terkait namun terpisah: apakah agen memilih dan memanggil tool dengan benar. Jaga evaluasi itu terpisah dari perbandingan kinerja solver yang dijelaskan di sini.
Evaluasi CapSolver dengan definisi task dan kriteria penerimaan yang sama seperti kandidat lainnya. Benchmark yang berguna membuat pembaca mampu menjelaskan apa yang berhasil, berapa lama waktu yang dibutuhkan, dan di mana bukti berakhir.
T: Berapa tingkat akurasi solver CAPTCHA yang bagus?
Target yang berguna bergantung pada keluarga tantangan dan kebutuhan alur kerja. Bandingkan hasil yang diterima pada sampel yang representatif, dan nyatakan penyebutnya sebelum menilai persentase apa pun.
T: Apakah respons API tercepat adalah solusi yang dapat digunakan paling cepat?
Belum tentu. Pengakuan pengiriman, solusi yang dikembalikan, dan penerimaan oleh aplikasi adalah peristiwa yang berbeda. Ukur peristiwa yang sesuai dengan kebutuhan pembaca.
T: Haruskah percobaan gagal dikeluarkan dari persentil latensi?
Latensi percobaan sukses dapat dilaporkan secara terpisah, tetapi kegagalan dan tenggat timeout harus tetap terlihat di sampingnya. Jika tidak, subset yang cepat dapat salah merepresentasikan beban kerja lengkap.
T: Dapatkah saya menguji penyedia dengan menggunakan kembali token yang sama?
Tidak. Token verifikasi sekali pakai tidak cocok untuk perbandingan berbasis replay. Gunakan uji coba baru, setara, dan diizinkan untuk alur kerja berbasis token.
T: Apakah artikel ini memberi peringkat layanan pemecahan CAPTCHA?
Tidak. Artikel ini menyediakan metode perbandingan dan contoh aritmetika yang secara eksplisit hipotetis. Peringkat kinerja membutuhkan pengukuran aktual di bawah kondisi yang dinyatakan dan dapat dibandingkan.
Ethan Collins
AI Agent Workflow Engineer
Building clearer handoffs between AI agents and tools.
TENTANG PENULIS
Perbaiki kesalahan CAPTCHA dengan memeriksa pemuatan widget, respons API pemecah, validasi token, dan hasil aplikasi. Ikuti jalur pemecahan masalah yang jelas untuk setiap tahap.
Cocokkan modul VisionEngine dengan masukan gambar yang didokumentasikan dan baca hasil sudut atau jarak dari respons tugas.