
🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Sep 21, 2026
अद्यतन Sep 21, 2026 · मिनट पढ़ने का समय
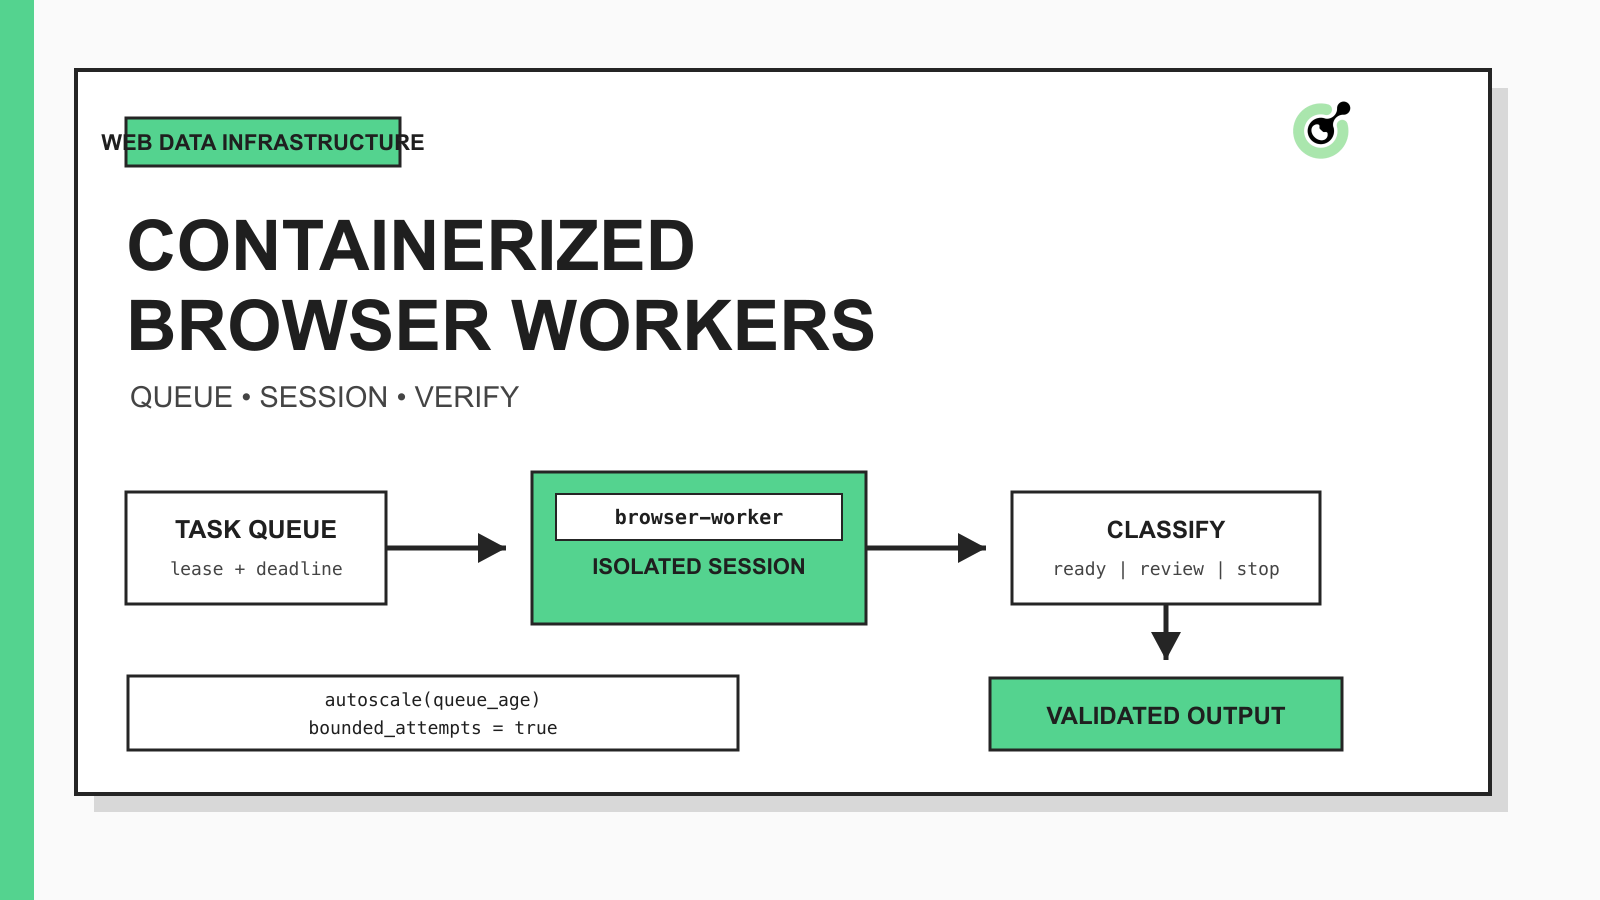
कंटेनर्स एस एस (CaaS) एक टीम के लिए एक प्रबंधित तरीका प्रदान करता है जो कंटेनराइज्ड वर्कर को डेप्लॉय करने, चलाने और स्केल करने के लिए उपयोग करता है। वेब स्क्रैपिंग के लिए, यह आमतौर पर एक ब्राउजर या HTTP वर्कर को एक बार पैकेज करता है, जिसे एक क्यू से कार्य दिया जाता है, और मांग के बदलाव के साथ वर्कर की संख्या बढ़ाई जाती है। रनटाइम दोहराया जा सकता है, जबकि प्लेटफॉर्म बहुत सारे योजना, स्वास्थ्य जांच और जीवन चक्र कार्यों को निपटाता है।
इस परिभाषा में एक महत्वपूर्ण सीमा है: CaaS एक्सीक्यूशन को स्केल करता है, न कि सहीता। एक सौ स्वस्थ कंटेनर अभी भी एक सौ चुनौती पृष्ठ, एक ही उपस्थिति को दोहरा सकते हैं, या एक त्रुटि दस्तावेज को उत्पाद डेटा के रूप में विश्लेषण कर सकते हैं। इसलिए डिज़ाइन के पास एक स्थिर कार्य संवाद, एक ब्राउजर-स्थिति मॉडल, एक सीमित चुनौती पथ, और निकालने के बाद एक वैधता होनी चाहिए।
जब एक अधिकृत वर्कफ़्लो एक समर्थित जांच चरण तक पहुंचता है, तो CapSolver कार्य के लिए दस्तावेज़ी समाधान कार्य कर सकता है जबकि वर्कर सत्र निरंतरता, समय सीमा, परिणाम लागू करना और अंतिम व्यावसायिक-स्थिति जांच के लिए जिम्मेदार रहता है।
एक विश्वसनीय CaaS वेब स्क्रैपिंग पाइपलाइन ओर्केस्ट्रेशन को वेब एक्सेस से अलग करता है। प्रत्येक चरण के पास छोटी जिम्मेदारी होती है और अस्पष्ट सफलता बैनर के बजाय एक टाइप किए गए परिणाम उत्पन्न करता है।
| चरण | पुराना | ऑपरेशन | आउटपुट | बंद करने की शर्त |
|---|---|---|---|---|
| स्केड्यूलर | अधिकृत URL और नीति | एक अद्वितीय कार्य बनाएं | कार्य ID और समय सीमा | अमान्य स्कोप या अवधि समाप्त |
| क्यू | कार्य रिकॉर्ड | एक वर्कर को कार्य लीज | लीज मालिक और प्रयास | लीज प्राप्त नहीं की जा सकती |
| ब्राउजर वर्कर | कार्य और सत्र संदर्भ | नेविगेशन और अवलोकन | पृष्ठ साक्ष्य और वर्गीकरण | नेविगेशन या नीति बजट समाप्त |
| चुनौती हैंडलर | पात्र चुनौती रिकॉर्ड | एक दस्तावेज़ी कार्य प्रवाह चलाएं | टाइप किए गए समाधान परिणाम | असमर्थित प्रकार या प्रयास सीमा |
| निकालना | स्वीकृत पृष्ठ साक्ष्य | आवश्यक क्षेत्रों को विश्लेषण करें | संरचित रिकॉर्ड | आवश्यक क्षेत्र अनुपलब्ध |
| वैधता | संरचित रिकॉर्ड और साक्ष्य | स्कीमा और व्यावसायिक नियम की जांच करें | स्वीकृत या अस्वीकृत रिकॉर्ड | वैधता विफलता |
इस विभाजन ने स्वायत्त स्केलिंग को सुरक्षित बनाया। ओर्केस्ट्रेटर कार्यक्रम के बिना कार्यकर्ता जोड़ सकता है जो प्रत्येक कार्यकर्ता को स्कोप बदलने, असीमित चुनौती कार्य बनाने या नीचे के प्रणालियों में सीधे लिखने की अनुमति नहीं देता है।
एक कंटेनरीकृत ब्राउजर कार्यकर्ता को एक दृढ़ कार्य संवाद की आवश्यकता होती है जब तक कि एक ऑटोस्केलर की आवश्यकता न हो। न्यूनतम, कार्य ID, अधिकृत लक्ष्य, नीति संस्करण, बनाए गए समय, निर्धारित समाप्ति, सत्र संदर्भ, वर्तमान चरण, प्रयास संख्या और अद्वितीयता कुंजी को कंटेनर के बाहर संग्रहीत करें।
संवाद को तीन निर्णयों को स्पष्ट करना चाहिए:
कंटेनर अस्थायी होते हैं। कुकीज, स्टोरेज-स्थिति संदर्भ, स्क्रीनशॉट, ट्रेस और कार्य इतिहास नहीं होते हैं। इन कल्पनाओं को एक मान्य दृढ़ प्रणाली में संग्रहीत करें और क्यू में संदर्भ पारित करें। Playwright ने ब्राउजर संदर्भों के अलगाव के बारे में दस्तावेज़ किया है, जो एक लीज कार्य के लिए एक संदर्भ उपयोगी मानक बनाता है। यदि वर्कफ़्लो बार-बार ऑथेंटिकेशन का उपयोग करता है, तो स्टोरेज स्थिति को एक प्रमाण के रूप में सुरक्षित करें और कभी-कभी इसे छवि में बेक न करें।
एक ब्राउजर वर्कर को एक लीज कार्य के साथ एक समय में प्रक्रिया करना चाहिए और क्यू संदेश की पुष्टि करने से पहले अपने ब्राउजर संदर्भ को बंद कर देना चाहिए। यह सत्र के मालिक को स्पष्ट रखता है और असंबंधित कार्यों के बीच कुकीज या मेमोरी में स्थिति के रिसाव को रोकता है।
छवि केवल रनटाइम, ब्राउजर निर्भरता, वर्कर कोड और गैर-गोपनीय डिफ़ॉल्ट में होना चाहिए। रनटाइम से API कुंजी और स्टोरेज प्रमाण पत्र निकालें। ब्राउजर और लाइब्रेरी संस्करण को निश्चित करें, फिर एक नियंत्रित रिलीज के माध्यम से पुनः निर्माण करें, जब एक कार्य शुरू होता है तो अनियमित पैकेज स्थापित करने के बजाय।
तीन स्वास्थ्य संकेत उपयोग करें:
एक सफल स्वास्थ्य प्रॉब को एक पृष्ठ कार्य के सफल होने के प्रमाण के रूप में नहीं मानें। स्वास्थ्य कार्यकर्ता प्रक्रिया के बारे में है; कार्य साक्ष्य वेब वर्कफ़्लो के बारे में है।
निकालने से पहले पृष्ठ वर्गीकरण होना चाहिए। HTTP स्थिति अकेले पर्याप्त नहीं है क्योंकि एक उत्तर 200 वापस कर सकता है जबकि लॉगिन फॉर्म, चुनौती पृष्ठ, सहमति स्क्रीन या एप्लिकेशन त्रुटि प्रदर्शित करता है।
एक ही ब्राउजर संदर्भ से एक सीमित साक्ष्य सेट एकत्र करें: अंतिम URL, उत्तर स्थिति, डॉक्यूमेंट शीर्षक, चयनित DOM मार्कर, स्क्रीनशॉट संदर्भ, कंसोल त्रुटियां और आवश्यक क्षेत्र उपस्थिति। कार्य को छोटे सेट में एक राज्य में राउट करें जैसे कि ready, challenge, authentication_required, retryable_error, terminal_error, या review_required।
वर्गीकरण परत हर Obstacle के बारे में अनुमान नहीं लगाती है। यह केवल अवलोकित स्थिति की पहचान करता है और अगले अधिकृत घटक के लिए टाइप किए गए रिकॉर्ड पारित करता है। यही वह अलगाव है जो CapSolver के द्वारा AI एजेंट के लिए वेब ऑटोमेशन इंफ्रास्ट्रक्चर स्टैक में वर्णित है: ब्राउजर रनटाइम सत्र और साक्ष्य के मालिक है, जबकि चुनौती हैंडलिंग एक नियंत्रित परत है।
कैप्चा हैंडलिंग एक सामान्य पुनरावृत्ति लूप के बजाय एक वैकल्पिक शाखा होनी चाहिए। कार्यकर्ता पहले यह जांचता है कि लक्ष्य और चुनौती स्वीकृत नीति में हैं, कार्य प्रकार समर्थित है, ब्राउजर सत्र अभी भी वैध है, और निर्धारित समाप्ति से पहले समय बचा है।
दस्तावेज़ी CapSolver प्रवाह createTask का उपयोग समर्थित कार्य बनाने के लिए करता है और getTaskResult असीमित परिणाम के लिए उपयोग करता है। createTask और परिणाम-पॉलिंग कार्य प्रवाह के वर्तमान अनुरोध क्षेत्र और कार्य-प्रकार नियमों के लिए आधिकारिक दस्तावेज़ की समीक्षा करें। दृढ़ स्थिति में वापस आए कार्य के आईडी को रखें ताकि एक फिर से शुरू किए गए कार्यकर्ता ज्ञात कार्य के बजाय एक और बनाए।
रीस्टार्ट के साथ बजट रखें:
अगर चुनौती प्रकार असमर्थित है, सत्र बदल गया है, समाप्ति समाप्त हो गई है, या एप्लिकेशन परिणाम को अस्वीकृत कर देता है, तो एक अंतिम या समीक्षा स्थिति लौटाएं। एक ऑटोस्केलर के द्वारा एक ब्लॉक किए गए कार्य को बहुगुणा समाधान प्रयास में न बदलें।
CapSolver बोनस कोड का उपयोग करें
अपने ऑटोमेशन बजट को तुरंत बढ़ाएं!
CapSolver खाता में अपने खाता को बढ़ाते समय बोनस कोड CAP26 का उपयोग करें ताकि प्रत्येक भरोसा पर 5% बोनस मिले — कोई सीमा नहीं।
अपने CapSolver डैशबोर्ड में अब इसे लागू करें
निकालना केवल पृष्ठ वर्गीकरण ready लौटता है जब शुरू होता है। व्यावसायिक कार्य द्वारा आवश्यक सबसे छोटा स्कीमा पार्स करें, फिर लिखने से पहले प्रकार, आवश्यक क्षेत्र, ताजगी, अद्वितीयता और स्रोत संगतता की जांच करें।
हर रिकॉर्ड के साथ एक संक्षिप्त साक्ष्य लेपेट रखें:
{
  "task_id": "task-20260921-0042",
  "final_url": "https://example.test/catalog/42",
  "observed_at": "2026-09-21T02:30:00Z",
  "page_state": "ready",
  "session_ref": "session://browser/task-20260921-0042",
  "required_fields_present": true,
  "artifact_refs": ["screenshot://task-20260921-0042/final"]
}
एंवेलॉप एक उदाहरण है, लेकिन इसका उद्देश्य वास्तविक है: नीचे के प्रणालियां ताजा पृष्ठ साक्ष्य को जीरो कैश से अलग कर सकती हैं, पार्सर आउटपुट को ब्राउजर अवलोकन से अलग कर सकती हैं, और स्वीकृत डेटा को झूठी सफलता से अलग कर सकती हैं। अवधि छोटी होनी चाहिए और नीति के आधार पर होनी चाहिए, विशेष रूप से जब स्क्रीनशॉट या ब्राउजर स्थिति में निजी या गोपनीय जानकारी होती है।
CaaS स्केलिंग कार्य पर प्रतिक्रिया करनी चाहिए, न कि केवल प्रक्रिया उपयोग। ब्राउजर वर्कर अक्सर नेविगेशन, रेंडरिंग, क्यू या बाहरी API पर प्रतीक्षा करते हैं, इसलिए CPU कम दिख सकता है जबकि कार्य देरी बढ़ रही है।
उपयोगी स्केलिंग इनपुट में प्रतीक्षा कर रहे कार्य की संख्या, सबसे पुराने तैयार कार्य की उम्र, लीज वाइट समय, माध्य कार्य अवधि और प्रत्येक प्रकार के कार्यकर्ता की संख्या शामिल हैं। Kubernetes ने यह दस्तावेज़ किया है कि HorizontalPodAutoscaler कस्टम मीट्रिक का उपयोग कर सकता है, जो क्यू-बैकेड ब्राउजर कार्य के लिए CPU के साथ एक बेहतर फिट है। Kubernetes ने समाप्त हो जाने वाले कार्य के लिए Jobs प्रदान किए हैं, यद्यपि ब्राउजर शुरू होने के खर्च के कारण एक स्थायी क्यू उपभोक्ता अधिक कुशल हो सकता है।
कार्यकर्ता संख्या, प्रति डोमेन समकालिकता, कुल चुनौती कार्य और नीचे के लिखने के लिए कठोर सीमाएं सेट करें। जब एक लक्ष्य अधिक चुनौती या अस्वीकृति स्थिति लौटाने लगता है, तो स्केलिंग के बजाय कार्य कम करें या रोक दें। एक बढ़ता क्यू एक क्षमता संकेत हो सकता है; एक बढ़ता चुनौती दर एक निदान संकेत हो सकता है।
निम्नलिखित पायथन फ़ंक्शन लक्ष्य या कैप्चा हल न करते हुए निर्णय परत का मॉडल बनाता है। यह एक अवलोकित पृष्ठ स्थिति और दृढ़ कार्य बजट स्वीकार करता है, फिर अगली कार्रवाई लौटाता है।
from dataclasses import dataclass
from enum import Enum


class NextAction(str, Enum):
    EXTRACT = "extract"
    HANDLE_CHALLENGE = "handle_challenge"
    RETRY = "retry"
    REVIEW = "review"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    attempts: int
    max_attempts: int
    seconds_remaining: int
    session_matches: bool
    challenge_allowed: bool


def decide(page_state: str, budget: Budget) -> NextAction:
    if budget.seconds_remaining <= 0:
        return NextAction.STOP
    if page_state == "ready":
        return NextAction.EXTRACT
    if page_state == "challenge":
        if not budget.challenge_allowed or not budget.session_matches:
            return NextAction.REVIEW
        if budget.attempts >= budget.max_attempts:
            return NextAction.STOP
        return NextAction.HANDLE_CHALLENGE
    if page_state == "retryable_error":
        return NextAction.RETRY if budget.attempts < budget.max_attempts else NextAction.STOP
    if page_state in {"authentication_required", "review_required"}:
        return NextAction.REVIEW
    return NextAction.STOP
स्थानीय परीक्षण तैयार पृष्ठ, योग्य चुनौती, बदले सत्र, समाप्त समय, पुनर्प्रयास थकावट, समीक्षा स्थिति और अज्ञात इनपुट को कवर करते हैं। निर्णय मॉडल इरादत से छोटा है ताकि ओर्केस्ट्रेटर लगातार प्रत्येक संक्रमण को लॉग और सत्यापित कर सके।
सबसे उपयोगी मीट्रिक्स इंफ्रास्ट्रक्चर व्यवहार को पृष्ठ परिणामों से जोड़ती हैं। क्यू उम्र और वर्कर संतृप्ति का ट्रैक रखें, लेकिन साथ ही चुनौती दर, प्राधिकरण-आवश्यक दर, पार्सर अस्वीकृति दर, दोहराए गए कार्य दर, समाप्ति समय और अंतिम व्यावसायिक-स्थिति स्वीकृति के रिकॉर्ड करें।
क्यू संदेश, ब्राउजर ट्रेस, चुनौती कार्य, निकाला रिकॉर्ड और नीचे के लिखने में एक संबंध आईडी का उपयोग करें। लॉग में API कुंजी, कुकीज, टोकन और निजी डेटा को मास्क करें। एक स्क्रीनशॉट साक्ष्य है, न कि एक डिफ़ॉल्ट स्थायी रिकॉर्ड; अनुमति उपयोग मामले की आवश्यकता के अनुसार केवल आवश्यक चीजें रखें।
अकेली विफलता के बजाय अनुपात पर चेतावनी दें। एक चुनौती सामान्य हो सकती है। एक ही लक्ष्य, रास्ता या ब्राउजर संस्करण के लिए तेजी से बढ़ता अनुपात एक साइट परिवर्तन, सत्र दोष, समाप्त प्राधिकरण, नीति समस्या या रिलीज विपरीतता का संकेत हो सकता है। अन्य क्यू जारी रखते हुए असर वाले खंड को रोक दें।
कंटेनर स्केल अनुमति नहीं बढ़ाता है। इस व्यवस्था केवल सार्वजनिक, अधिकृत या अन्यथा कानूनी डेटा वर्कफ़्लो के लिए उपयोग करें। लक्ष्य शर्तों, दर सीमा, गोपनीयता के दायित्व, अधिकार क्षेत्र और डेटा-अनुप्रयोग आवश्यकताओं का सम्मान करें।
निजी पृष्ठ, खाता डेटा या संवेदनशील स्क्रीनशॉट केवल जब वर्कफ़्लो के लिए उस डेटा के लिए स्पष्ट अनुमोदन हो तभी बाहरी प्रणालियों को भेजें। लॉगिन और पहचान वर्कफ़्लो को सामान्य सार्वजनिक-डेटा कार्यों से अलग करें। संवेदनशील जमा, अपरिहार्य कार्रवाई या स्कोप बदलाव से पहले मानव समीक्षा की आवश्यकता होती है।
कंटेनर्स एस एस ब्राउजर वर्कर को दोहराया और स्केल करने योग्य बनाता है, लेकिन उत्पादन विश्वसनीयता उन वर्कर के आसपास संवादों पर निर्भर करती है। प्रत्येक कार्य के एक मालिक, एक अलगाव सत्र, एक दृढ़ समाप्ति, एक टाइप किए गए स्थिति मशीन और एक वैधता आउटपुट होना चाहिए। जब क्यू स्वस्थ मांग दिखाती है तो स्केल करें; जब साक्ष्य दोहराए गए अस्वीकृति या अनिश्चित स्थिति दिखाता है तो रोक दें।
अधिकृत वर्कफ़्लो के लिए समर्थित जांच चरणों के साथ, CapSolver अपने एप्लिकेशन ब्राउजर संदर्भ बनाए रखते हुए एक पात्रता गेट के पीछे फिट हो सकता है और अंतिम परिणाम की जांच करता है।
शुरू करें एक अनुमोदित लक्ष्य और एक सीमित कार्यकर्ता के साथ। समय के साथ बदले गए लक्ष्य, चुनौती योग्यता, बीता समय, अंतिम स्वीकृति और साक्ष्य संदर्भों को रिकॉर्ड करें जब तक कि समानांतरता बढ़ाई न जाए। CapSolver दस्तावेज़ का उपयोग करके वर्तमान दस्तावेज़ीकृत कार्य प्रवाह का चयन करें, फिर मूल ब्राउज़र सत्र में परिणाम की समीक्षा करें।
प्रश्न: क्या कंटेनर्स एंड एस एस (CaaS) वेबसाइट एक्सेस समस्याओं को हल करता है?
नहीं। CaaS कंटेनरीकृत एप्लिकेशन डेप्लॉय करता है और स्केल करता है, जबकि आपके एक्सेस लेयर के लिए अभी भी ब्राउज़र स्थिति, रूटिंग, चुनौती वर्गीकरण, नीति नियंत्रण और परिणाम पुष्टि की आवश्यकता होती है।
प्रश्न: क्या हर URL को अलग कंटेनर में चलाना चाहिए?
आवश्यक नहीं। आमतौर पर एक लीज़्ड टास्क के लिए एक अलग ब्राउज़र संदर्भ आमतौर पर महत्वपूर्ण सीमा होती है; एक कार्यकर्ता कंटेनर तब तक कार्य अनुक्रम में प्रक्रिया कर सकता है जब तक कि यह प्रत्येक संदर्भ को बंद न करे, कार्य स्मृति को साफ़ न करे और निश्चित स्थिति लिखे जाने के बाद ही स्वीकृति के लिए अधिसूचित न करे।
प्रश्न: ब्राउज़र कार्यकर्ताओं को कौन सा मापदंड स्केल करना चाहिए?
कतार की गहराई और कार्य की उम्र आमतौर पर CPU की तुलना में मजबूत प्राथमिक संकेत होते हैं। उन्हें कार्यकर्ता सीमाओं, लक्ष्य स्तर की समानांतरता, चुनौती दर और मेयाद समाप्ति के साथ जोड़ें ताकि प्लेटफॉर्म विफल प्रवाह को स्केल न करे।
प्रश्न: एक पुनः आरंभ किए गए कार्यकर्ता के लिए मौजूदा CAPTCHA कार्य कैसे निपटाएं?
पुनः आरंभ किए गए कार्यकर्ता को स्थायी प्रदाता कार्य पहचान, मूल मेयाद, प्रयास गणना और सत्र संदर्भ लोड करना चाहिए। जब तक सत्र मेल खाता है और शेष बजट अनुमति देता है, तब तक ज्ञात कार्य की जांच करें; अन्यथा इसे बंद कर दें या समीक्षा मांगें।
प्रश्न: क्या इस पैटर्न का निजी या सीमित डेटा के लिए उपयोग किया जा सकता है?
तकनीकी क्षमता निजी, सीमित, व्यक्तिगत या संवेदनशील डेटा के संग्रह की अनुमति नहीं देती है। इस पैटर्न का केवल अनुमोदित सीमा के भीतर उपयोग करें और लक्ष्य के शर्तों, लागू कानून, डेटा न्यूनीकरण, बनाए रखने नियंत्रण और मानव समीक्षा आवश्यकताओं के साथ लागू करें।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
Rust में वेब स्क्रैपिंग के स्केलेबल आर्किटेक्चर सीखें, reqwest, scraper, असिंक्रोनस स्क्रैपिंग, हेडलेस ब्राउज़र स्क्रैपिंग, प्रॉक्सी रोटेशन, और संगत CAPTCHA का निपटारा।
CapSolver के साथ RoxyBrowser के एकीकरण करें ताकि ब्राउज़र के कार्यों को स्वचालित किया जा सके और reCAPTCHA, Turnstile और अन्य CAPTCHAs को बायपास किया जा सके।
