🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Dec 28, 2023
अद्यतन Oct 13, 2025 · मिनट पढ़ने का समय
कैप्चा वेबसाइटों द्वारा मानव उपयोगकर्ताओं और स्वचालित बॉट्स के बीच अंतर बताने के लिए एक सुरक्षा उपाय है। इसमें उपयोगकर्ताओं को एक चुनौती प्रस्तुत की जाती है, जैसे कि विकृत पाठ, चित्र या पहेलियां, जिन्हें सत्यापित करने के लिए हल करना होता है। हालांकि, जब वेब स्क्रैपिंग करते समय कैप्चा का सामना करना पड़ता है, तो यह एक महत्वपूर्ण चुनौती हो सकती है। इस लेख में, हम वेब स्क्रैपिंग के दौरान मिलने वाले कैप्चा प्रकारों का अध्ययन करेंगे और पहले से ही कैप्चा हल करने के सबसे अच्छे तरीकों पर चर्चा करेंगे।
कैप्चा, "पूरी तरह से स्वचालित सार्वजनिक ट्यूरिंग परीक्षण जो कंप्यूटर और मनुष्यों के बीच अंतर बताता है," के लिए संक्षिप्त रूप है, जो स्वचालित बॉट्स के वेबसाइटों तक पहुंचने और इंटरैक्ट करने से रोकने के लिए डिज़ाइन किया गया है। इसका उद्देश्य केवल मानव उपयोगकर्ताओं को विशिष्ट कार्य जैसे फॉर्म भरना, खाता बनाना या विशिष्ट सामग्री तक पहुंचने की अनुमति देना है।
कैप्चा हल किए जा सकते हैं, हालांकि उन्हें पूरी तरह से हल करना कठिन हो सकता है। सिफारिश किया गया तरीका उन्हें दिखाई देने से रोकना है, जैसे कि दर्जे सीमा लगाना, सत्र प्रबंधन, प्रॉक्सी घूमाना और उपयोगकर्ता-एजेंट यादृच्छिकता के माध्यम से। हालांकि, यदि कैप्चा अभी भी दिखाई देते हैं, तो उन्हें हाथ से हल करने, कैप्चा-हल करने वाली सेवाओं या मशीन लर्निंग एल्गोरिथ्म के माध्यम से हल किया जा सकता है।
इसके आगे की चर्चा में, हम पायथन या किसी अन्य प्रोग्रामिंग भाषा के लिए लागू दोनों दृष्टिकोणों का अध्ययन करेंगे, जो आपको कैप्चा हल करने में अच्छी तरह से समझ प्रदान करेगा और आवश्यक डेटा प्राप्त करने में सक्षम बनाएगा।
वेब स्क्रैपिंग वेबसाइटों से डेटा निकालने की प्रक्रिया है, और प्रक्रिया के दौरान विभिन्न प्रकार के कैप्चा मिल सकते हैं। कुछ सामान्य कैप्चा प्रकार निम्नलिखित हैं:
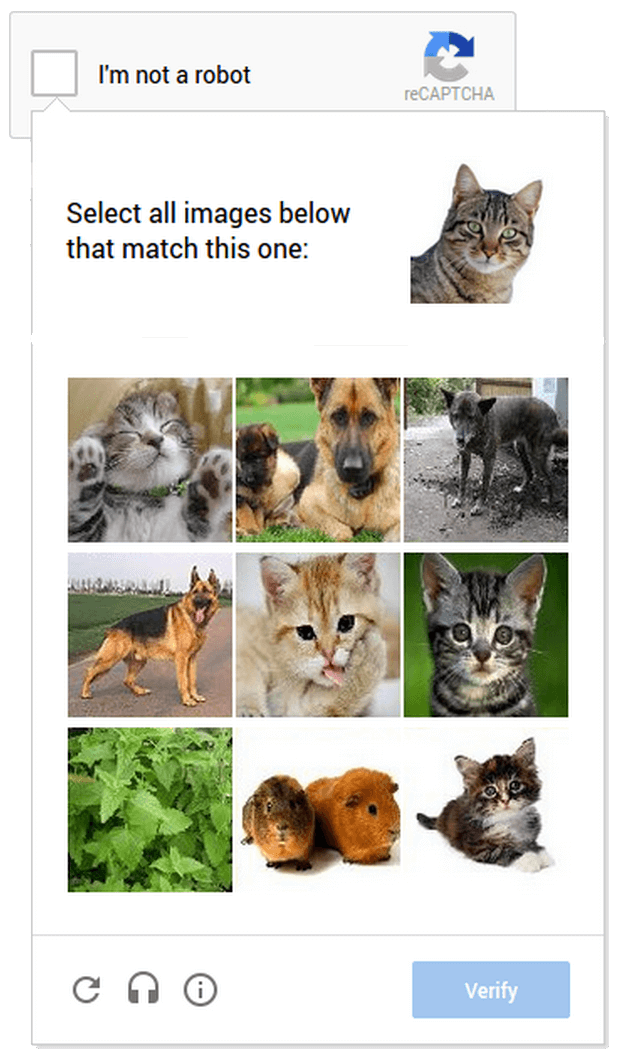
ReCaptcha V2&v3: ReCaptcha गूगल द्वारा विकसित एक व्यापक रूप से उपयोग किए जाने वाले कैप्चा प्रणाली है। इसमें विभिन्न प्रकार शामिल हैं, जैसे कि दिए गए विवरण के अनुरूप चित्र चुनना या पहेलियां हल करना।
इस लेख में अधिक जानकारी के लिए यहां क्लिक करें
वेब स्क्रैपिंग, वेबसाइटों से डेटा निकालने की प्रक्रिया है, जो सामग्री के संरक्षण के लिए कैप्चा का उपयोग करता है। इस बाधा को पार करने के लिए, वेब स्क्रैपिंग कैप्चा समाधान काम करते हैं। इन समाधानों में उन्नत छवि पहचान एल्गोरिथ्म और मशीन लर्निंग मॉडल के उपयोग के माध्यम से कैप्चा को सटीक रूप से हल करने के विभिन्न तकनीक शामिल हैं। कैप्चा को बिना किसी अड़चन के हल करके, ये समाधान दक्ष और अव्यवहित डेटा निकासी को सुविधाजनक बनाते हैं।
अगर कैप्चा अनिवार्य है या आपकी वेब स्क्रैपिंग सेटअप वेबसाइट के सुरक्षा तंत्र को हल करने में पर्याप्त उन्नत नहीं है, तो आप प्रत्यक्ष रूप से चुनौती को हल करने की कोशिश कर सकते हैं। एक सीधा तरीका एक कैप्चा-हल करने वाली सेवा, जैसे Capsolver, का उपयोग करना है, जो एक प्रमुख समाधान प्रदाता के रूप में उभरा है। यह विविध कैप्चा बाधाओं को आसानी से और तेजी से हल करता है, कैप्चा समस्याओं से परेशान व्यक्तियों के लिए त्वरित समाधान प्रदान करता है।
वेब स्क्रैपिंग में, कैप्चा का सामना करना चुनौतिपूर्ण हो सकता है। यद्यपि कैप्चा पूरी तरह से हल करना कठिन हो सकता है, लेकिन इन्हें प्रभावी ढंग से हल करने के कई तरीके हैं। इनमें कैप्चा-हल करने वाली सेवाओं का उपयोग, जैसे कि Capsolver, IP रोटेशन और उपयोगकर्ता-एजेंट रोटेशन के उपयोग, पाठ और छवि पहचान के लिए मशीन लर्निंग एल्गोरिथ्म का उपयोग, और छवि-आधारित कैप्चा के लिए एक्सेसिबिलिटी मोड का उपयोग शामिल है। इन रणनीतियों के उपयोग से, वेब स्क्रैपर कैप्चा के माध्यम से गुजर सकते हैं और आवश्यक डेटा सफलतापूर्वक प्राप्त कर सकते हैं।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
CapSolver MCP के आधिकारिक MCP पंजीकरण में खोजें, uvx या pip के साथ 0.1.3 संस्करण स्थापित करें, एक स्थानीय क्लाइंट को कॉन्फ़िगर करें, और stdio टूल्स की पुष्टि करें।
पायडैंटिक एआई में कैप्चा टूल्स जोड़ें, आधिकारिक कैपसॉल्वर एडेप्टर का उपयोग करें, टूल एक्सीक्यूशन को स्थानीय रूप से परीक्षण करें, और टाइप किए गए इनपुट और संरचित सॉल्वर परिणामों को संभालें।