

🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Nov 13, 2026
Actualizado Nov 13, 2026 · min de lectura
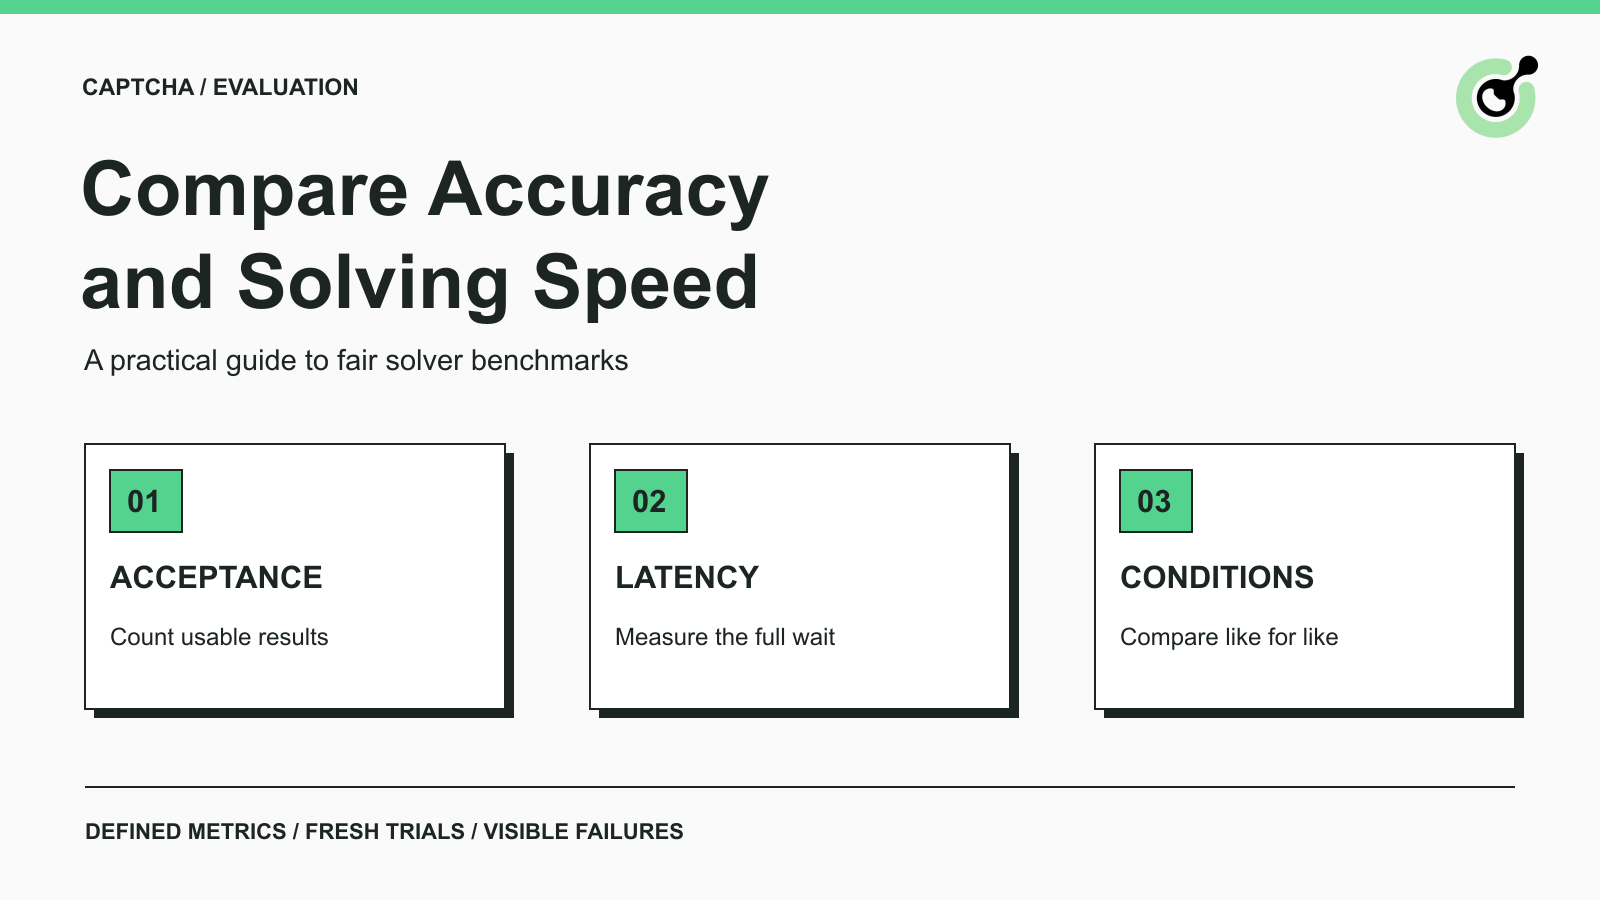
“Rápido” y “preciso” solo son afirmaciones útiles cuando la medición que las respalda es clara. Un resolutor de CAPTCHA puede publicitar el tiempo que tarda en devolver una respuesta de API, mientras que otro informa el tiempo de un paso completo de navegador. Un porcentaje de éxito puede contar tokens devueltos, desafíos aceptados o trabajos completados tras varios intentos.
Esta guía explica cómo comparar esas mediciones para tu propia carga de trabajo permitida. CapSolver es un servicio que puede evaluarse mediante interfaces de tareas documentadas. El método siguiente no presenta una tabla de clasificación medida ni supone qué servicio rendirá mejor.
La precisión de un resolutor de CAPTCHA debe describir resultados correctos o aceptados para un tipo de desafío especificado y con un denominador claramente declarado.
Para una tarea de imagen a texto con respuestas conocidas, el reconocimiento exacto es una medición útil. Cuenta si el texto devuelto coincide con los caracteres esperados según las reglas de la aplicación receptora. Si la aplicación considera que las mayúsculas y minúsculas son significativas, una evaluación que las ignore mide un problema distinto.
Para una tarea basada en token, el resultado más útil es si la aplicación receptora acepta la respuesta del desafío. Un proveedor que devuelve un token no vacío solo establece la entrega de una salida, no su aceptación. La guía de validación de reCAPTCHA de Google describe la comprobación en el backend que verifica la respuesta.
Mantén separadas tres cantidades:
| Medición | Numerador | Denominador | Pregunta respondida |
|---|---|---|---|
| Tasa de solución de la API | Tareas que devuelven la solución documentada | Todas las tareas válidas enviadas | ¿El resolutor devolvió una salida? |
| Aceptación en el primer intento | Desafíos aceptados en el primer intento | Todos los primeros intentos previstos | ¿El resultado inicial funcionó? |
| Finalización eventual del trabajo | Trabajos completados dentro de los intentos permitidos y el plazo | Todos los trabajos previstos | ¿Se completó el flujo de trabajo completo? |
Las solicitudes de prueba malformadas deben informarse como fallos de configuración. No las elimines silenciosamente del informe, pero evita atribuir a la precisión de reconocimiento un site key incorrecto. Indica si un denominador publicado incluye o excluye fallos de configuración y por qué.
La velocidad del resolutor debe medirse entre dos eventos nombrados utilizando un reloj coherente y la misma definición para cada proveedor.
Registra cuándo el cliente envía la tarea, cuándo recibe una solución utilizable y cuándo observa la aceptación por parte de la aplicación. Estas marcas temporales distinguen la latencia de la API del trabajo adicional requerido por la aplicación. Si la obtención de la tarea se hace mediante sondeo (polling), registra también la política de sondeo: el momento en que tu cliente observa la finalización puede ser posterior al momento en que el servicio terminó.
El contrato getTaskResult de CapSolver distingue resultados pendientes y listos para tareas asíncronas. Su ImageToTextTask devuelve el reconocimiento directamente al crear la tarea. No impongas el modelo de medición asíncrono a una tarea síncrona ni compares tipos de tarea distintos en una misma columna de velocidad.
Usa al menos la mediana y un percentil de cola, como p95, para los intentos exitosos. La mediana describe el centro de la distribución observada; el percentil de cola muestra cuánto más tardaron los intentos exitosos más lentos. La guía SRE de Google sobre distribuciones de latencia explica por qué los promedios pueden ocultar el comportamiento en la cola.
Publica también el número de timeouts y el plazo límite. Un proveedor que devuelve cinco éxitos rápidos y agota el tiempo en muchos otros intentos no debe parecer superior solo porque se excluyeron los fallos de su promedio de latencia.
Una comparación útil agrupa desafíos similares y mantiene constantes las principales condiciones de operación.
Separa reCAPTCHA v2, reCAPTCHA v3, Turnstile y reconocimiento de texto en imágenes. Dentro de una familia, conserva las variantes y parámetros relevantes. Un resultado de una categoría no establece el rendimiento en otra. La documentación de tareas de reCAPTCHA v2 es un ejemplo de por qué los campos específicos de cada variante son importantes.
Para cada grupo, registra el entorno aprobado, la ubicación del cliente, la concurrencia, el plazo de la solicitud, la política de sondeo, la tolerancia a reintentos y el periodo de prueba. No envíes a un proveedor una sola solicitud a la vez y a otro una ráfaga de trabajo simultáneo para luego atribuir toda la diferencia al resolutor.
Utiliza propiedades de prueba propias o flujos de trabajo con permiso explícito para esta evaluación. Comienza con una carga pequeña que el entorno soporte. Que una página sea públicamente accesible no es una licencia para realizar una prueba de rendimiento sin restricciones.
Pruebas equivalentes necesitan condiciones de desafío comparables, no la reutilización de un token ya resuelto. Google documenta que las respuestas de reCAPTCHA son de un solo uso y con una vida útil de dos minutos. La referencia de validación de Turnstile de Cloudflare requiere igualmente validación en el servidor y describe una vida útil del token de cinco minutos y de un solo uso.
Planifica pruebas independientes bajo las mismas condiciones permitidas. Cuando sea posible, alterna el orden de los proveedores a lo largo del periodo de prueba en lugar de probar un servicio solo en un intervalo tranquilo y otro solo en un intervalo de alta carga. Mantén el plan de asignación antes de ver los resultados.
Para reconocimiento de imágenes offline, puede resultar útil el mismo conjunto de imágenes etiquetadas y autorizado. Para un desafío dinámico en vivo, describe cómo se asignaron muestras comparables y reconoce la variación restante. No afirmes que el experimento estuvo perfectamente controlado si la población de desafíos cambió durante la ejecución.
Canjea tu código de bono de CapSolver
Aumenta tu presupuesto de automatización al instante.
Usa el código de bono CAP26 al recargar tu cuenta de CapSolver para obtener un 5% de bono extra en cada recarga, sin límites.
Canjéalo ahora en tu Panel de CapSolver
Un registro de benchmark debe conservar una fila por intento y un identificador de trabajo estable que vincule cualquier reintento.
Los siguientes campos forman una plantilla editorial de informe, no un esquema de API de proveedor:
| Campo | Qué registrar |
|---|---|
| Identificadores de trabajo e intento | A qué desafío previsto pertenece este intento |
| Familia y variante del desafío | La categoría exacta de tarea que se está comparando |
| Versión de proveedor y cliente | El servicio y la integración utilizados |
| Tiempos de envío y resultado | Suficiente información para calcular la latencia de la API |
| Momento y evidencia de aceptación | Cuándo aceptó la aplicación la respuesta, si es observable |
| Resultado final | Aceptado, rechazado, timeout, error de API o fallo de configuración |
| Número de reintento | Si fue el intento original o un intento posterior |
| Importe facturado | Coste real cuando esté disponible, con su base de facturación |
No almacenes claves de API, tokens de respuesta sin procesar ni información personal no relacionada en un informe de benchmark compartido. Conserva por separado la evidencia diagnóstica restringida cuando sea necesario. Una referencia de tarea redactada y su resultado suelen ser más útiles que copiar la solicitud completa en una hoja de cálculo.
Usa aserciones de pruebas de API para hacer que la definición de resultado sea repetible. Si el backend está fuera de tu visibilidad, registra la señal observable de la aplicación y llámalo aceptación de la aplicación en lugar de afirmar que tienes acceso a una puntuación interna de validación.
Un resultado útil explica la compensación entre aceptación, demora, reintentos y tamaño de la muestra en lugar de comprimir todo en una sola puntuación.
Considera este ejemplo aritmético hipotético, no una comparación medida de servicios reales:
| Primeros intentos previstos | Aceptados en el primer intento | Aceptación en el primer intento | Trabajos adicionales completados tras reintento | Trabajos completados eventualmente |
|---|---|---|---|---|
| 100 | 90 | 90% | 5 | 95 |
La tasa de aceptación en el primer intento es 90 dividido entre 100, o 90%. La finalización eventual es 95 dividido entre 100, o 95%. Ninguno de los dos números indica cuánto tardaron los reintentos ni cuántos intentos extra se facturaron. Esos datos necesitan columnas separadas en un informe real.
Ahora considera un conjunto hipotético de 20 duraciones de intentos exitosos: 18 tardan dos segundos y dos tardan 20 segundos. La media es 3,8 segundos, mientras que la mediana es de dos segundos. Usando la definición de rango más cercano, p95 es 20 segundos. Las tres afirmaciones pueden ser ciertas; un único promedio oculta las esperas largas.
Indica el método de cálculo de percentiles al informar sobre muestras pequeñas. Distintos programas pueden interpolar percentiles de forma diferente, por lo que diferencias decimales sin explicación no deben presentarse como una ventaja significativa de un proveedor.
Evita tratar una pequeña diferencia de una prueba corta como un ranking permanente. Repite las mediciones durante un periodo relevante y muestra el número de casos evaluados en cada grupo. Si un servicio solo se probó en una familia de desafíos, indícalo junto al resultado.
La puntuación de reCAPTCHA v3 describe una interacción evaluada y no debe rebautizarse como el porcentaje de precisión del resolutor.
La guía de reCAPTCHA v3 de Google describe decisiones basadas en puntuación y la comprobación de la acción esperada en el backend. La aplicación receptora decide cómo emplear esa evaluación. Por tanto, un campo de puntuación tiene un significado diferente de “90 de 100 trabajos previstos fueron aceptados”.
Para una aplicación propia, registra la regla de aceptación utilizada en la prueba y mantenla constante entre proveedores. Informa por separado de la distribución de puntuaciones si tienes acceso legítimo a ella. Si solo observas si el flujo de trabajo continuó, no inventes la puntuación oculta ni supongas que cada resultado aceptado alcanzó el mismo umbral.
Elige un resolutor cuya aceptación observada y distribución de tiempos de respuesta encajen con el flujo de trabajo que realmente necesitas ejecutar.
Establece los criterios de decisión antes de la prueba. Un flujo de trabajo interactivo puede tener un margen de espera más estricto que un proceso por lotes offline. Un lote puede tolerar esperas más largas pero necesitar un objetivo claro de finalización eventual y un límite de coste. Estos son requisitos de la carga de trabajo, no razones para declarar que un proveedor es universalmente el más rápido.
Para flujos de trabajo dirigidos por agentes, la guía de evaluación de herramientas de CAPTCHA cubre una cuestión relacionada pero distinta: si el agente elige y llama a la herramienta correctamente. Mantén esa evaluación separada de la comparación de rendimiento del resolutor descrita aquí.
Evalúa CapSolver con las mismas definiciones de tarea y criterios de aceptación que cualquier otro candidato. Un benchmark útil deja al lector en condiciones de explicar qué funcionó, cuánto tardó y dónde se detiene la evidencia.
P: ¿Cuál es una buena tasa de precisión de un resolutor de CAPTCHA?
Un objetivo útil depende de la familia de desafíos y de los requisitos del flujo de trabajo. Compara resultados aceptados en muestras representativas e indica el denominador antes de juzgar cualquier porcentaje.
P: ¿La respuesta de API más rápida es la solución utilizable más rápida?
No necesariamente. Un acuse de recibo de envío, una solución devuelta y la aceptación por la aplicación son eventos distintos. Mide el evento que coincide con el requisito del lector.
P: ¿Deben excluirse los intentos fallidos de los percentiles de latencia?
La latencia de los intentos exitosos puede informarse por separado, pero los fallos y los plazos de timeout deben seguir siendo visibles junto a ella. De lo contrario, el subconjunto rápido puede representar de forma inexacta toda la carga de trabajo.
P: ¿Puedo probar proveedores reutilizando el mismo token?
No. Los tokens de verificación de un solo uso no sirven para comparaciones basadas en replay. Utiliza pruebas nuevas, equivalentes y permitidas para los flujos de trabajo basados en tokens.
P: ¿Este artículo clasifica los servicios de resolución de CAPTCHA?
No. Proporciona un método de comparación y ejemplos aritméticos explícitamente hipotéticos. Un ranking de rendimiento requiere mediciones reales bajo condiciones declaradas y comparables.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Corrige los errores de CAPTCHA comprobando la carga del widget, las respuestas de la API del solucionador, la validación del token y los resultados de la aplicación. Sigue una ruta de resolución de problemas clara para cada etapa.
Asocia los módulos de VisionEngine con las entradas de imagen documentadas y lee el resultado de ángulo o distancia de la respuesta de la tarea.
