🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Nov 16, 2026
Atualizado Nov 16, 2026 · minutos de leitura
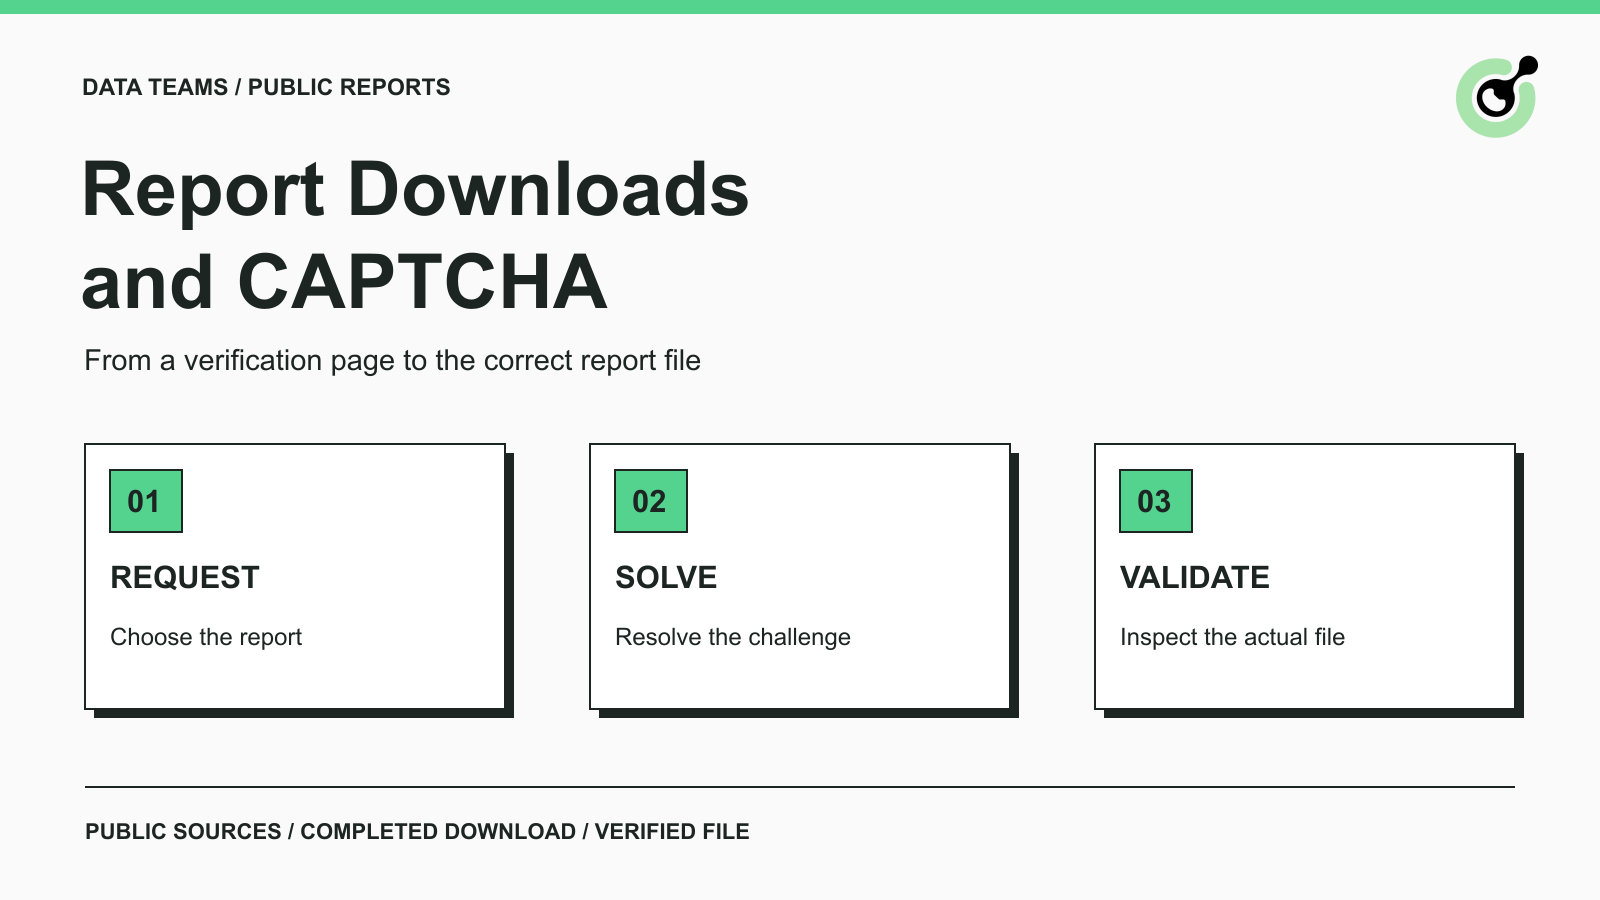
Uma equipe de pesquisa abre um relatório setorial público, seleciona Download e recebe uma página de verificação em vez de um PDF. Um usuário em navegador consegue ver a interrupção. Um coletor automatizado pode salvar essa resposta com o nome de arquivo esperado e passá‑la para a próxima etapa de processamento, onde o erro se manifesta como documento corrompido ou resumo vazio.
A correção começa antes da extração do documento. O CapSolver pode fornecer a etapa de resolução para um CAPTCHA compatível em um fluxo de download autorizado. Seu coletor ainda precisa concluir o download e conferir o arquivo. Este guia segue essa sequência para relatórios públicos e publicações de empresas, com atenção especial ao limite entre o resultado da verificação e um documento real.
Identifique a página retornada pela tentativa de download antes de repeti‑la ou chamar um solver.
Interrupções por CAPTCHA durante a recuperação de PDFs são um problema documentado. A orientação da Paperpile para download de PDFs diferencia downloads bloqueados por CAPTCHA de acesso restrito pelo editor e arquivos ausentes. A distinção é útil mesmo que você use um coletor de documentos diferente. Isso não implica integração do CapSolver com o Paperpile.
Inspecione a resposta no navegador em busca de um prompt visível de verificação e do componente de desafio esperado. Se o conteúdo pedir assinatura ou login institucional, um resultado de solver não fornece esse direito de acesso. Se o documento foi movido, encontre sua página oficial de publicação atual em vez de tratar toda solicitação falha como CAPTCHA.
Mantenha a investigação vinculada ao relatório público pretendido. Um resultado de busca, uma landing page da publicação e o arquivo para download são recursos diferentes. A landing page pode carregar normalmente enquanto o pedido do arquivo encontra uma checagem adicional.
Registre o título do relatório, o editor, a edição ou período de referência e a landing page oficial antes de tentar a recuperação. A URL do arquivo pode mudar sem alterar a identidade da publicação.
Para um relatório de mercado ilustrativo, a tarefa pode ser “o último relatório trimestral público do setor, em inglês, do editor”. Se um desafio interromper a solicitação, mantenha esse requisito ligado à tentativa. Um download posterior de uma edição anterior não é um substituto bem‑sucedido apenas porque abre corretamente.
Use um feed compatível, exportação de repositório ou API de documentos quando isso atender ao requisito do relatório. Use o caminho via navegador apenas quando for necessário e permitido pelo editor.
Antes de adicionar o solver, estabeleça o seguinte:
Um CAPTCHA pode aparecer antes do envio de um formulário ou durante a navegação até um documento. Identifique em qual ponto houve falha. Resolver um desafio na homepage geral não estabelece que um pedido de download separado foi aceito.
Este é um guia de fluxo de recuperação de arquivo, não um coletor específico de um site. Ele não prescreve seletores para um editor não testado nem afirma que todas as fontes de PDF aceitam a mesma integração.
Resolva o CAPTCHA observado e suportado e, em seguida, continue a solicitação original do relatório pelo fluxo de página aprovado.
Para uma imagem contendo caracteres, a referência ImageToTextTask define a interface de reconhecimento. Sua saída é o texto do desafio, não o texto extraído do relatório. Mantenha esses dois trabalhos de reconhecimento separados.
Um widget reCAPTCHA precisa da configuração de tarefa reCAPTCHA v2 correspondente, incluindo o contexto de página relevante. Não envie uma captura de tela arbitrária para uma tarefa de imagem esperando que um widget baseado em token aceite a resposta.
Quando uma tarefa assíncrona é usada, o contrato getTaskResult distingue uma tarefa em processamento de um resultado pronto. Criar a tarefa não é o sinal para começar a fazer o parse de um arquivo.
Após obter o resultado apropriado, retome a operação de página pretendida e observe o que acontece. O download pode começar, um formulário pode exibir outro erro, ou o editor pode retornar à sua lista de publicações. Um solver bem‑sucedido deve avançar o fluxo para a verificação do download, não diretamente para “relatório armazenado”.
Não descarte o relatório selecionado nem o estado do navegador enquanto espera o resultado do solver. Uma aba recém‑aberta apenas com a URL da landing page pode não conter a seleção de idioma atual ou o estado do formulário de download.
Se a página for atualizada e apresentar um novo desafio, inspecione a nova tentativa antes de reutilizar qualquer resultado. Mantenha limites explícitos de re‑tentativas. Resolver repetidamente enquanto a aplicação aguarda um campo obrigatório ausente não resolve o problema subjacente.
Resgate Seu Código de Bônus do CapSolver
Aumente instantaneamente o seu orçamento de automação!
Use o código de bônus CAP26 ao recarregar sua conta CapSolver para ganhar 5% de bônus extra em cada recarga — sem limites.
Resgate agora no seu Dashboard do CapSolver
Aceite o download apenas quando o arquivo existir, for legível e corresponder à publicação solicitada.
Um response HTTP bem‑sucedido e um nome de arquivo terminando em .pdf são observações úteis, mas nenhum deles é suficiente por si só. Um coletor pode salvar uma página HTML de verificação usando um nome de arquivo PDF. A falha então aparece depois, em um leitor de PDF ou na etapa de OCR, distante da solicitação que a causou.
Use vários checks em conjunto:
| Verificação | O que ela estabelece |
|---|---|
| Conclusão do download | O navegador ou cliente concluiu a recuperação da resposta |
| Tipo de mídia da resposta | O servidor identifica o conteúdo retornado como um formato esperado |
| Legibilidade do arquivo | Um leitor adequado consegue abrir a estrutura do documento |
| Identidade da publicação | Título, editor, idioma e edição correspondem à solicitação |
| Conexão com a fonte | O arquivo pode ser rastreado até a página de publicação pretendida |
A referência de Content-Type no MDN explica como uma resposta identifica seu tipo de mídia. Trate esse header como evidência a combinar com a inspeção do arquivo, e não como garantia incondicional de que o corpo contém o relatório correto.
O header Content-Disposition pode descrever o tratamento de anexos e um nome de arquivo sugerido. Ele não certifica o conteúdo do documento. Um nome de arquivo plausível nunca deve sobrepor‑se a uma verificação de arquivo que falhou.
Deixe o download terminar e salve o arquivo no local durável pretendido antes de limpar o contexto do navegador.
A documentação de downloads do Playwright explica que arquivos baixados pertencem ao contexto do navegador e são apagados quando o contexto é fechado, a menos que sejam salvos adequadamente. A mesma lição de fluxo se aplica a qualquer coletor: o tratamento temporário do download deve terminar antes de o sessão de recuperação encerrar.
Isto é uma referência ao comportamento documentado do navegador, não uma afirmação de que uma nova integração Playwright–CapSolver foi testada para este artigo.
Armazene um novo relatório somente depois que suas verificações de recuperação e identidade forem aprovadas; então, disponibilize‑o para extração ou sumarização.
Se uma edição válida anterior já existir, mantenha‑a com suas datas originais de publicação e recuperação enquanto a nova tentativa estiver inconclusa. Registre que a atualização falhou; não renomeie silenciosamente o documento anterior como se fosse a edição mais recente.
Para um serviço de pesquisa, isso impede que um problema de acesso se transforme em uma afirmação de conteúdo. “O último relatório não pôde ser recuperado” é diferente de “o editor não tem novo relatório”. O coletor deve comunicar o que de fato observou.
Antes de gerar um resumo por IA, confirme que sua entrada é o relatório aceito ou texto extraído verificado. O guia existente para manter páginas de CAPTCHA fora da pesquisa por IA trata do problema mais amplo de qualidade de fonte. Aqui, a verificação decisiva recai sobre o próprio arquivo baixado, antes que ele entre nessa etapa de pesquisa.
Use o último estágio verificado para escolher a próxima ação quando um relatório ainda estiver indisponível.
Se o desafio permanecer na tela, inspecione o tipo de tarefa, os parâmetros atuais e o erro retornado. Se o desafio tiver sido concluído, mas nenhum arquivo chegou, inspecione a ação de download, os redirects ou a mensagem de validação da página. Se um arquivo chegou, mas não pode ser lido, inspecione seu conteúdo real antes de gastar com outra resolução.
Um arquivo legível com o período de referência errado é um problema de seleção de documento. Uma extração de texto vazia a partir de um PDF escaneado válido pertence ao estágio de processamento de documento. Nenhum desses resultados, isoladamente, prova que a solução de CAPTCHA falhou.
Não repita indefinidamente nem procure rotas alternativas em torno da decisão de acesso do editor. Preserve a tentativa com falha e use uma recuperação manual aprovada ou um canal fornecido pelo editor quando necessário.
Use o CapSolver no checkpoint de CAPTCHA suportado e, em seguida, verifique o documento que chega ao armazenamento. O resultado útil para uma equipe de pesquisa é o relatório correto, com fonte e edição claras, pronto para análise.
P: Um solver de CAPTCHA pode baixar o PDF para mim?
A tarefa de resolução documentada fornece o resultado do desafio. Seu navegador ou aplicação deve continuar o download aprovado e verificar o arquivo retornado.
P: Por que um PDF baixado contém uma página de verificação?
O coletor pode ter salvo uma resposta HTML com um nome de arquivo PDF. Inspecione o conteúdo da resposta e retome o fluxo de verificação suportado antes de aceitar um novo arquivo.
P: Resolver o CAPTCHA concede acesso a um relatório pago?
Não. Assinatura, login, licenciamento e permissão do editor continuam sendo requisitos separados.
P: Devo substituir o relatório armazenado após qualquer download bem‑sucedido?
Substitua somente depois de verificar o arquivo e a identidade da publicação. Preserve a última cópia válida quando a recuperação mais recente estiver incompleta ou ambígua.
P: Isso é o mesmo que extrair metadados do documento?
Não. Este fluxo estabelece que o arquivo do relatório pretendido foi realmente recuperado. Extração de metadados, OCR e sumarização vêm depois dessa etapa de aceitação.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Aprenda arquitetura de raspagem web escalável em Rust com reqwest, scraper, raspagem assíncrona, raspagem de navegador headless, rotação de proxies e tratamento de CAPTCHA compatível.
Compare o Selenium vs Puppeteer para resolver CAPTCHA. Descubra benchmarks de desempenho, notas de estabilidade e como integrar o CapSolver para o máximo de sucesso.