ImageToTextTask vs VisionEngine: Escolha um Solucionador de CAPTCHA de Imagem

Lucas Mitchell
Automation Engineer
TL;DR
- Escolha uma tarefa CAPTCHA de imagem com base em sua entrada e saída documentadas, em vez de pelo fato de que o desafio contenha uma imagem.
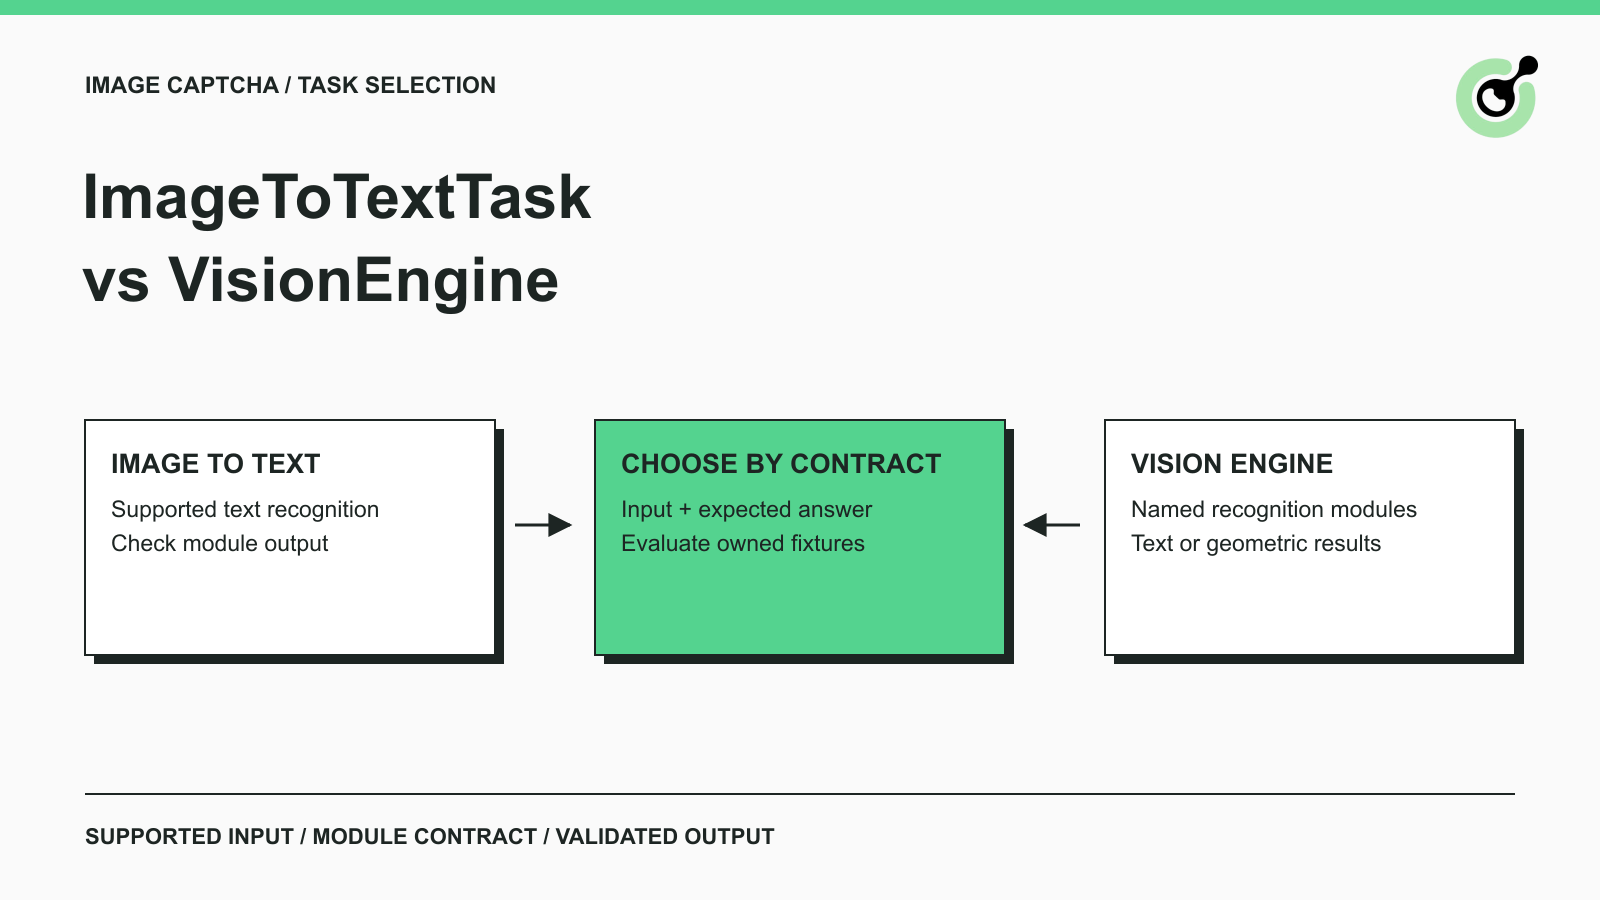
- ImageToTextTask é o ponto de partida para reconhecimento de texto suportado; VisionEngine fornece módulos nomeados com diferentes formatos de resultado.
- VisionEngine não é exclusivamente geométrico: seu exemplo documentado
ocr_gifretorna texto. - Ambas as famílias de tarefas retornam resultados de reconhecimento diretamente de
createTask; não adicione uma etapa de polling por padrão. - Valide o reconhecimento separadamente da utilização da resposta pela aplicação, especialmente quando envolver coordenadas, dimensões da imagem ou desafios atualizados.
Qual a diferença entre ImageToTextTask e VisionEngine?
ImageToTextTask e VisionEngine são famílias de tarefas de reconhecimento de imagem com campos de solicitação diferentes e respostas específicas de módulo. A escolha correta depende do formato do desafio suportado por sua aplicação autorizada e da resposta que sua aplicação precisa em seguida.
Na CapSolver, selecionar a família correta significa mais do que mudar o nome da tarefa. Um parser esperando caracteres reconhecidos não pode consumir com segurança uma distância ou um ângulo. Por outro lado, uma resposta geométrica é desnecessária quando a próxima etapa da aplicação simplesmente compara uma string reconhecida com um conjunto de testes conhecido.
Reconhecimento óptico de caracteres, ou OCR, extrai texto de uma imagem. Isso ajuda a explicar uma categoria de reconhecimento de CAPTCHA, mas "CAPTCHA de imagem" é mais amplo que OCR. Um desafio pode pedir texto, uma posição ou outra relação visual suportada.
Este guia compara contratos documentados e escolhas de avaliação. Seus cenários envolvem fixtures de CAPTCHA próprios e QA permitidos. Ele não apresenta um script genérico para interagir com sites arbitrários ou afirma que um resultado de reconhecimento completa um desafio de navegador por si só.
Compare os contratos de tarefa antes de escolher
O contrato de tarefa determina qual dados de imagem você envia e como interpreta o resultado.
| Comparação | ImageToTextTask | VisionEngine |
|---|---|---|
| Campo principal de imagem de solicitação | body |
image |
| Seleção de tarefa | ImageToTextTask, com opções de módulo documentadas |
VisionEngine mais um módulo nomeado suportado |
| Saída esperada | Texto ou respostas específicas de módulo | Resultados de texto ou geométricos específicos de módulo |
| Entrega de resultado | Resposta direta de createTask | Resposta direta de createTask |
| Pergunta de integração principal | A moda de reconhecimento selecionada corresponde à resposta esperada? | O módulo exato corresponde ao formato da imagem e ao contrato de saída? |
| Suposição perigosa | Toda resposta é uma única string de texto | Toda imagem pode usar o mesmo módulo ou parser |
A referência ImageToTextTask documenta conteúdo de imagem em Base64 em body, sem quebras de linha ou prefixo data-URI. Seus exemplos distinguem text de answers específicos de módulo. Leia a resposta do módulo selecionado em vez de aplanar todos os resultados bem-sucedidos em uma única string.
A referência VisionEngine documenta módulos nomeados: exemplos incluem slider_1 retornando distance, módulos de rotação retornando angle e botdeflector retornando points. O exemplo ocr_gif retorna text. A tabela geral lista imageBackground como necessário, enquanto vários exemplos de módulo o omitem. Resolva essa diferença contra o exemplo exato do módulo e confirme qualquer ambiguidade restante antes da implementação.
Esses exemplos estabelecem contratos suportados, não entendimento de imagem universal. Um nome de tarefa não é permissão para inventar um módulo, adicionar um prompt livre-forma ou esperar um tipo de resposta que o módulo selecionado não documente.
Quando você deve começar com ImageToTextTask?
Comece com ImageToTextTask quando a resposta útil do desafio suportado for texto reconhecido e o módulo documentado se encaixe no seu input.
Suponha que sua equipe mantenha um formulário de contato legado e tenha um conjunto de testes permitido de imagens de caracteres. A pergunta de avaliação é específica: o caminho de reconhecimento retorna os caracteres esperados pelo conjunto de testes? Você pode comparar a string retornada com a etiqueta do teste sem envolver coordenadas do navegador ou movimento do ponteiro.
Defina as regras de texto da aplicação antes de avaliar o solver. Sua própria forma distingue maiúsculas e minúsculas? Preserva zeros à esquerda? Aceita espaços? Essas são propriedades da aplicação que você controla. Elas não devem ser alteradas silenciosamente por uma função de limpeza genérica de resultados.
Por exemplo, um conjunto etiquetado como "007A" deve permanecer uma string durante a comparação. Tratá-lo como um número faria com que o parser da aplicação fosse responsável por um erro evitável. Este é um exemplo de validação ilustrativo, não um resultado de solver relatado.
Mantenha resultados vazios e formatos de resposta incorretos distinguíveis. Um campo esperado ausente é um problema de integração para inspecionar. Uma resposta corretamente formatada, mas incorreta, pertence à avaliação de reconhecimento. Combiná-los em um único número "precisão" esconde se a escolha da tarefa ou o reconhecimento de imagem precisa de atenção.
Quando VisionEngine merece avaliação?
Avalie VisionEngine quando um módulo documentado corresponder ao formato do desafio e sua estrutura retornada for a informação que sua aplicação precisa.
Em um teste de imagem controlado, um ângulo e uma lista de pontos representam afirmações diferentes. Um ângulo pode ser comparado com a orientação esperada pelo conjunto de testes. Uma lista de pontos precisa de suas próprias regras de interpretação. Nenhum deles deve passar por um parser escrito para reconhecimento de caracteres.
Prepare um adaptador específico de módulo com uma responsabilidade deliberadamente estreita: aceite o formato de resultado documentado, valide-o e entregue a resposta interpretada à aplicação própria. Não faça com que esse adaptador decida qual controle do navegador irrelevante operar. Manter a interpretação de reconhecimento separada torna falhas mais fáceis de reproduzir com fixtures armazenados.
A presença de um módulo OCR também evita uma regra simplista como "texto sempre significa ImageToTextTask". Para entrada de texto animado, inspecione o formato e o módulo suportado documentado antes de escolher. O formato da resposta sozinho não estabelece que duas tarefas aceitem os mesmos inputs ou performem igualmente neles.
Se nenhum módulo documentado corresponder ao desafio, registre-o como não suportado ou não resolvido. Alterar rótulos de solicitação até que uma API aceite a carga útil não é um método confiável de avaliação. A aceitação de uma solicitação não estabelece que seu modelo de reconhecimento se encaixe na imagem.
Resgate seu código de bônus da CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta na CapSolver para obter um bônus adicional de 5% em cada recarga — sem limites.
Resgate-o agora em seu Painel da CapSolver

Como a preparação da imagem afeta a comparação?
A preparação da imagem deve preservar as evidências que cada tarefa candidata precisa, para que a avaliação meça o ajuste da tarefa em vez de diferenças acidentais de pré-processamento.
Base64 é uma representação de bytes. A especificação Base64 RFC 4648 define essa codificação; ela não estabelece que o arquivo codificado seja a imagem correta para um módulo de reconhecimento. Um payload pode ser sintaticamente codificado e ainda conter um desafio obsoleto, uma área incorreta ou um formato de imagem não suportado.
Para cada fixture próprio, mantenha uma referência à imagem original e anote quais transformações foram feitas antes da submissão. Exemplos incluem redimensionamento, planificação de animação ou mudança de área de corte. Evite aplicar silenciosamente a mesma transformação a todas as famílias de tarefas: remover frames de animação pode mudar as informações disponíveis para uma tarefa destinada a entrada animada.
Se um módulo avaliado precisar de imagens de primeiro plano e fundo, certifique-se de que pertençam à mesma instância de fixture. Combinar um primeiro plano de uma atualização com um fundo de outra cria uma entrada incompatível. Essa falha não deve ser contada como evidência de que um módulo válido é impreciso.
Use imagens de teste sintéticas ou aprovadas sem informações pessoais irrelevantes. Uma captura de tela de uma página de suporte inteira pode conter mais do que o desafio. Limitar a imagem submetida ao input permitido torna o teste mais claro e reduz a exposição de dados desnecessários.
Por que resultados de coordenadas são mais difíceis de integrar do que texto?
Resultados de coordenadas exigem acordo sobre o quadro de referência da imagem e do layout antes que a aplicação os utilize corretamente.
Um ponto medido contra uma imagem original não é automaticamente um ponto na viewport do navegador. A definição de retângulo de limite do navegador descreve um retângulo relativo à viewport e inclui a borda e o padding do elemento. Isso é diferente de assumir que o elemento exibido corresponde exatamente às dimensões da imagem bruta.
Em um conjunto de QA próprio, teste a interpretação de coordenadas como um componente separado. Registre as dimensões do fixture, as dimensões realmente apresentadas ao solver e a representação usada pela aplicação para avaliar a resposta. Se essas representações diferirem, a aplicação precisa de um mapeamento explícito, testado, apropriado à sua própria interface.
Não use uma resposta de reconhecimento bem-sucedida como prova de que esse mapeamento é correto. Um teste útil pode comparar o resultado interpretado com o fixture etiquetado antes de qualquer ação do navegador. Um segundo teste pode verificar se o componente próprio consome esse resultado interpretado como pretendido.
Essa separação também ajuda com desafios atualizados. Se a UI substituir uma imagem enquanto o reconhecimento está em execução, a resposta ainda pertence ao fixture original. Sua aplicação deve descartar essa associação obsoleta em vez de aplicar o resultado à imagem substituída.
Como comparar precisão e custo operacional de forma justa?
Uma comparação justa agrupa os resultados por família de desafio suportada e conta os resultados de aplicação concluídos separadamente dos resultados de API válidos.
Comece com um conjunto de fixtures representativo e autorizado. Inclua as variações de imagem que sua aplicação realmente produz, como suas dimensões normais e o intervalo esperado de caracteres. Mantenha um conjunto de teste separado para avaliação para que ajustes no pré-processamento não sejam julgados apenas pelos mesmos exemplos que os motivaram.
Registre essas categorias separadamente:
| Categoria de avaliação | O que isso lhe diz |
|---|---|
| Entrada rejeitada | A solicitação ou formato precisa de atenção |
| Formato de resposta esperado retornado | O contrato do parser é satisfeito |
| Resposta corresponde ao fixture | O reconhecimento atende ao critério do fixture |
| Aplicação própria aceita a resposta | A integração preserva o significado pretendido da resposta |
| Resultado chega após substituição do fixture | O tempo ou ciclo de vida tornou o resultado inválido |
Não compare tarefas não relacionadas usando uma única pontuação de precisão. Um fixture de texto e um fixture geométrico testam saídas diferentes. Onde duas opções documentadas se encaixam verdadeiramente na mesma família de inputs, mantenha o conjunto de fixtures e a definição de sucesso constantes.
Para custo, meça o gasto total contra resultados bem-sucedidos e relevantes e considere o trabalho de engenharia. Um parser que requer investigação manual frequente pode custar tempo mesmo quando as taxas de tarefa forem modestas. Nenhum vencedor universal de preço ou desempenho é estabelecido apenas pelos nomes dos campos da API.
Essas são recomendações de avaliação, não resultados de benchmark. Execute-as contra sua aplicação autorizada antes de fazer uma afirmação de precisão, velocidade ou economia.
O que deve conter uma checklist final de seleção de tarefa?
Uma checklist de seleção de tarefa deve identificar o input suportado, a resposta esperada, o comportamento de entrega e o teste de aceitação da aplicação.
Para cada família de CAPTCHA suportada, documente a tarefa e o módulo selecionados, as regras de preparação da imagem, o campo de solução esperado e o que acontece se a resposta tiver outro formato. Atribua um responsável para revisar essas suposições quando sua aplicação mudar sua implementação de CAPTCHA.
Mantenha a revisão de acessibilidade separada da avaliação de reconhecimento. A discussão da W3C sobre inacessibilidade de CAPTCHA explica barreiras criadas pelos mecanismos de desafio. Adicionar um solver a um fluxo de QA automatizado não demonstra que o formulário público oferece uma experiência acessível. O proprietário do site ainda precisa avaliar alternativas apropriadas para o usuário.
Para uma explicação mais ampla da camada de reconhecimento, veja como uma API de reconhecimento de imagem se encaixa na automação de CAPTCHA personalizada. Volte para essa comparação ao escolher o contrato de tarefa exato.
Comece com uma tarefa CapSolver suportada, um pequeno conjunto de testes etiquetado e um parser que preserva o resultado documentado. Amplie a cobertura apenas após cada nova família de input ter seus próprios critérios de aceitação claros.
Perguntas frequentes
Q: O VisionEngine substitui ImageToTextTask?
O VisionEngine não é uma substituição universal. Escolha a tarefa cujo módulo documentado suporte o input e forneça o resultado que sua aplicação espera. Formatos de resposta diferentes e requisitos de imagem podem exigir adaptadores diferentes.
Q: O VisionEngine sempre retorna coordenadas?
O VisionEngine não sempre retorna coordenadas. Seus exemplos de módulo incluem resultados geométricos e um exemplo de OCR retornando texto. Leia o contrato de resposta do módulo selecionado em vez de inferi-lo pelo nome da família de tarefas.
Q: Essas famílias de tarefas precisam de polling em getTaskResult?
Ambas as referências de família de tarefas vinculadas descrevem resultados retornados diretamente por meio de createTask. Um wrapper de API compartilhado deve preservar essa solução direta em vez de iniciar automaticamente um loop de polling.
Q: Uma resposta reconhecida pode provar que um formulário CAPTCHA funciona?
Uma resposta reconhecida não prova roteamento correto de resultado nem conclusão do formulário. Valide a resposta contra um fixture, depois verifique se a aplicação própria a consome para o desafio pretendido e atinge o resultado esperado.
Ver mais
The Other CAPTCHASep 15, 2026
Resolutor de CAPTCHA: Polling vs Webhooks – Como escolher um fluxo de resultados
Escolha o solucionador de CAPTCHA de polling ou webhooks, considerando o status da tarefa, requisitos do receptor, atualidade dos resultados e o fluxo de conclusão documentado da API CapSolver.
The Other CAPTCHASep 09, 2026
Segurança da Integração do CAPTCHA do Selenium: Proteger Chaves e Sessões
Aprenda como proteger chaves, sessões, registros e ambientes de teste em integrações Selenium CAPTCHA, com verificações práticas de revisão para automação autorizada.