🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
Adélia Cruz
MCP Integration Engineer
Publicado Sep 29, 2026
Atualizado Sep 29, 2026 · minutos de leitura
Modelos de linguagem grandes podem transformar conteúdo web inconsistente em registros úteis, mas não eliminam o trabalho operacional necessário para obter dados de página confiáveis. Uma pipeline de produção ainda precisa de verificações de permissão, limites de solicitação, execução do navegador quando o JavaScript for necessário, tratamento explícito para checkpoints de verificação e validação determinística antes que um registro chegue a um banco de dados.
GLM-5.3 é útil na camada de interpretação. Seu fluxo de trabalho compatível com API pode classificar conteúdo renderizado, mapear texto para um esquema, explicar por que um campo está ausente e ajudar a normalizar diferenças entre páginas. Para automação autorizada que encontre uma tarefa de verificação suportada, CapSolver pode ser colocado antes da extração enquanto a aplicação mantém o controle da sessão da página e verifica o resultado final.
Este guia apresenta uma arquitetura genérica, não instruções para um site específico. Use-o apenas para dados públicos ou de outra forma autorizados e pare quando um fluxo atingir limites de login, pagamento, dados pessoais ou permissões fora do escopo aprovado.
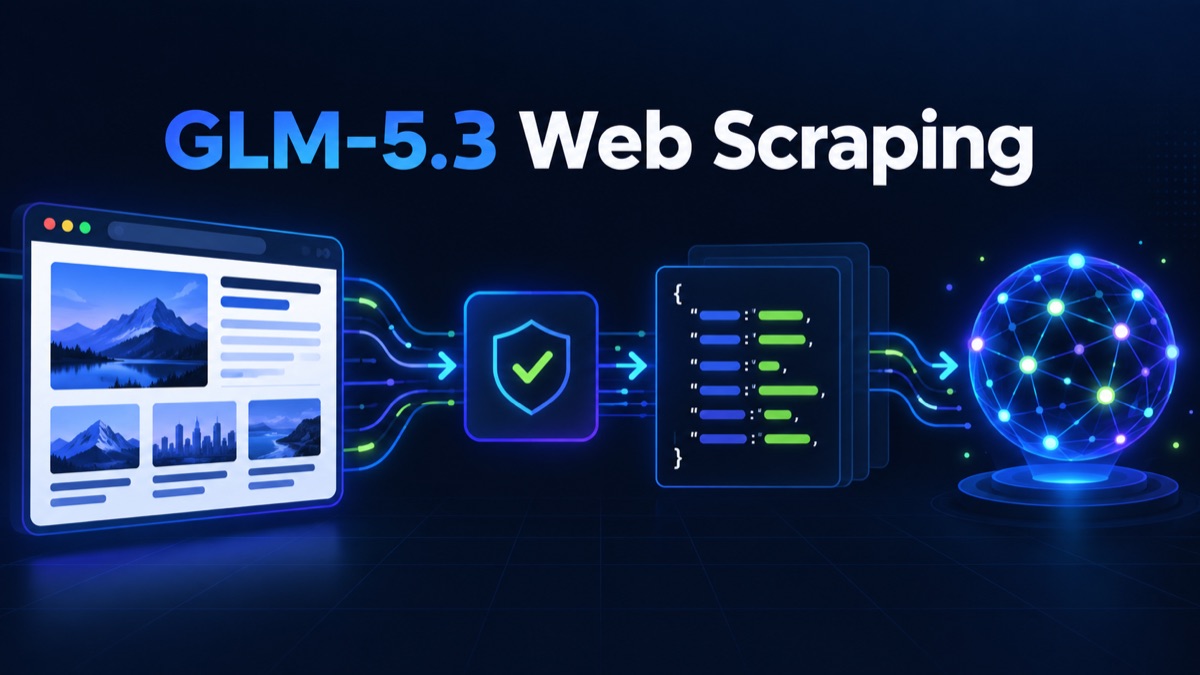
Um sistema robusto de raspagem de web com GLM-5.3 usa uma sequência de estágios pequenos. Cada estágio produz um resultado tipado que o próximo estágio pode verificar.
| Estágio | Responsabilidade | Saída esperada | Condição de parada |
|---|---|---|---|
| Porta de permissão | Verificar destino, escopo de dados, taxa e propósito | Definição de trabalho aprovada | Escopo não autorizado |
| Camada de acesso | Buscar ou renderizar a página | Status, cabeçalhos, URL final, HTML ou captura de tela | Login, pagamento, dados privados ou acesso negado |
| Classificador de resposta | Identificar conteúdo, página vazia, limite de taxa ou página de verificação | Estado da página nomeado | Estado desconhecido ou não suportado |
| Adaptador de verificação | Submeter uma tarefa documentada quando permitido | Pronto, processando ou erro terminal | Prazo ou orçamento de tentativas atingido |
| Extração do GLM | Converter conteúdo permitido em um esquema estrito | Registro JSON candidato | Saída inválida ou não suportada por evidência |
| Validação determinística | Verificar tipos, campos obrigatórios, duplicatas e evidência de origem | Registro aceito ou rejeição explícita | Qualquer regra de negócio falhar |
| Armazenamento | Realizar gravação idempotente | ID de registro estável e link de rastreamento | Chave de origem já existe sem nova versão |
A fronteira mais importante é entre acesso e interpretação. Se um modelo receber o HTML de uma página de desafio, ele pode descrever confiantemente essa página como o conteúdo alvo. Classifique a resposta antes de acionar o modelo.
O exemplo de orquestração usa Python 3.11 ou superior e o pacote requests. Mantenha credenciais em variáveis de ambiente e nunca as inclua em código-fonte, prompts, logs, capturas de tela ou configuração comprometida.
python -m venv .venv
source .venv/bin/activate
pip install requests

export ZAI_API_KEY="replace-with-your-z-ai-key"
export CAPSOLVER_API_KEY="replace-with-your-capsolver-key"
A documentação oficial da API Z.ai usa o ponto final chat-completions em https://api.z.ai/api/paas/v4/chat/completions. Confirme o identificador do modelo atual no repositório GLM-5 ou no seu console Z.ai antes da implantação; este guia usa glm-5.3-flash como padrão configurável por ambiente.
Não peça ao modelo para "extrair tudo importante". Defina os campos, comportamento permitido de nulos e requisitos de evidência antes de coletar uma página.
from dataclasses import dataclass
from datetime import datetime, timezone
from typing import Any

@dataclass(frozen=True)
class ExtractionJob:
    source_url: str
    allowed_host: str
    required_fields: tuple[str, ...]
    max_input_chars: int = 40_000

def validate_record(job: ExtractionJob, record: dict[str, Any]) -> dict[str, Any]:
    missing = [name for name in job.required_fields if not record.get(name)]
    if missing:
        raise ValueError(f"missing_required_fields:{','.join(missing)}")
    if record.get("source_url") != job.source_url:
        raise ValueError("source_url_mismatch")
    record["validated_at"] = datetime.now(timezone.utc).isoformat()
    return record
O modelo só pode retornar null quando o esquema permitir explicitamente. Valores obrigatórios devem ser confirmados contra evidência da página por código comum.
A camada de acesso deve retornar um pequeno objeto de estado em vez de apenas uma string de HTML. O classificador pode usar códigos de status, URL final, tipo de conteúdo, seletores esperados e marcadores conhecidos de checkpoint.
from enum import Enum

class PageState(str, Enum):
    CONTENT = "content"
    JAVASCRIPT_REQUIRED = "javascript_required"
    RATE_LIMITED = "rate_limited"
    LOGIN_REQUIRED = "login_required"
    VERIFICATION = "verification"
    UNKNOWN = "unknown"

def choose_action(state: PageState) -> str:
    return {
        PageState.CONTENT: "extract",
        PageState.JAVASCRIPT_REQUIRED: "render_in_authorized_browser",
        PageState.RATE_LIMITED: "back_off",
        PageState.LOGIN_REQUIRED: "stop_for_operator",
        PageState.VERIFICATION: "evaluate_supported_task",
        PageState.UNKNOWN: "stop_for_review",
    }[state]
HTTP 403 e HTTP 429 não devem entrar em um loop de tentativa genérico. Uma solicitação recusada requer revisão de permissão e configuração. Uma solicitação limitada de taxa requer redução da concorrência global e respeito a qualquer janela de tentativa fornecida pelo servidor.
A API oficial do CapSolver usa createTask para submeter uma tarefa documentada. Tarefas assíncronas são verificadas com getTaskResult. A aplicação deve selecionar o tipo de tarefa do documento atual task documentation e passar apenas os campos necessários para esse checkpoint autorizado.
import os
import time
import requests

CAPSOLVER_BASE = "https://api.capsolver.com"

def solve_supported_task(task: dict, *, timeout_seconds: int = 45) -> dict:
    api_key = os.environ["CAPSOLVER_API_KEY"]
    created = requests.post(
        f"{CAPSOLVER_BASE}/createTask",
        json={"clientKey": api_key, "task": task},
        timeout=15,
    ).json()
    if created.get("errorId") != 0:
        raise RuntimeError(created.get("errorCode", "create_task_failed"))
    if created.get("status") == "ready":
        return created["solution"]

    task_id = created.get("taskId")
    if not task_id:
        raise RuntimeError("missing_task_id")

    deadline = time.monotonic() + timeout_seconds
    while time.monotonic() < deadline:
        time.sleep(3)
        result = requests.post(
            f"{CAPSOLVER_BASE}/getTaskResult",
            json={"clientKey": api_key, "taskId": task_id},
            timeout=15,
        ).json()
        if result.get("errorId") != 0:
            raise RuntimeError(result.get("errorCode", "task_failed"))
        if result.get("status") == "ready":
            return result["solution"]
        if result.get("status") not in {"idle", "processing"}:
            raise RuntimeError("unexpected_task_status")

    raise TimeoutError("verification_task_deadline_exceeded")
O chamador deve permitir apenas uma tentativa limitada por padrão. A solução retornada deve ser aplicada por meio do caminho de integração documentado no mesmo contexto de navegador que detectou o checkpoint. Se a página não transitar para o estado esperado, retorne uma falha ou solicite revisão humana.
Resgate seu código de bônus do CapSolver
Aumente seu orçamento de automação instantaneamente!
Use o código de bônus CAP26 ao recarregar sua conta do CapSolver para obter um bônus adicional de 5% em cada recarga — sem limites.
Resgate-o agora em seu Painel do CapSolver
Após confirmar que a página é conteúdo, remova ruídos de navegação, scripts, elementos ocultos, banners repetidos e chrome de página irrelevante. Preserve títulos, rótulos, tabelas e referências de origem. Não envie cookies do navegador, cabeçalhos de autorização, dados pessoais ou rastros de sessão brutos para o modelo.
import json
import os
import requests

ZAI_ENDPOINT = "https://api.z.ai/api/paas/v4/chat/completions"

def extract_with_glm(job: ExtractionJob, normalized_text: str) -> dict:
    prompt = {
        "source_url": job.source_url,
        "required_fields": list(job.required_fields),
        "rules": [
            "Retorne um objeto JSON e nenhuma prosa.",
            "Use apenas evidência presente em page_text.",
            "Não infira um valor obrigatório ausente.",
            "Inclua source_url exatamente como fornecido.",
        ],
        "page_text": normalized_text[: job.max_input_chars],
    }
    response = requests.post(
        ZAI_ENDPOINT,
        headers={
            "Authorization": f"Bearer {os.environ['ZAI_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "model": os.getenv("GLM_MODEL", "glm-5.3-flash"),
            "messages": [
                {"role": "system", "content": "Extraia dados estruturados com base em evidências."},
                {"role": "user", "content": json.dumps(prompt, ensure_ascii=False)},
            ],
            "temperature": 0,
        },
        timeout=60,
    )
    response.raise_for_status()
    content = response.json()["choices"][0]["message"]["content"]
    return json.loads(content)
Trate o exemplo como uma fronteira de adaptador. Confirme as opções de solicitação e recursos de saída estruturada na documentação oficial da Z.ai antes do uso em produção. Se o modelo envolver JSON em Markdown ou retornar texto fora do contrato, rejeite a resposta em vez de tentar repará-la silenciosamente.
Duas validações diferentes são necessárias.
Primeiro, valide o resultado do navegador. Confirme que a URL final, o título esperado, o contêiner de destino e a ausência de um novo erro correspondam ao fluxo pretendido. Uma resposta de tarefa bem-sucedida não é prova de que a página tenha continuado.
Segundo, valide o registro extraído. Verifique strings obrigatórias, intervalos numéricos, datas, URLs normalizadas, chaves duplicadas e trechos de evidência. Para campos de alto impacto, compare o valor com um seletor determinístico ou uma segunda representação independente da página.
def run_extraction(job: ExtractionJob, state: PageState, page_text: str) -> dict:
    action = choose_action(state)
    if action != "extract":
        raise RuntimeError(f"page_not_ready_for_model:{action}")
    candidate = extract_with_glm(job, page_text)
    return validate_record(job, candidate)
Essa última etapa previne que uma página de desafio, alucinação do modelo ou renderização parcial entre no conjunto de dados como raspagem bem-sucedida.
Registre um ID de rastreamento, URL de origem, URL final, estado da página, hash de conteúdo, nome do modelo, versão do prompt, versão do esquema, resultado da validação e tempo de processamento. Armazene IDs de tarefa e códigos de erro para depuração operacional de curto prazo, mas não armazene tokens de solução, segredos ou dados de sessão irrelevantes.
Aplicar um orçamento em toda a tarefa. Contar tentativas HTTP, navegações do navegador, tentativas de verificação, chamadas do GLM, caracteres de entrada e tempo decorrido. Quando o orçamento for esgotado, retorne uma falha tipada em vez de permitir que um componente reinicie o fluxo.
Um conjunto útil de métricas inclui:
| Sintoma | Causa provável | Ação correta |
|---|---|---|
| GLM retorna detalhes sobre uma página de verificação | A resposta não foi classificada antes do prompt | Pare a chamada do modelo e corrija a detecção do estado da página |
| JSON é analisado, mas os campos obrigatórios estão vazios | Prompt ou evidência da fonte é incompleta | Rejeite o registro e inspecione o conteúdo normalizado |
| Tarefa está pronta, mas a página permanece bloqueada | Contexto do navegador ou parâmetros da tarefa não correspondem | Compare URL, sessão, agente do usuário, tempo e requisitos documentados |
| Custo aumenta enquanto registros aceitos permanecem estáticos | Escalação de navegador ou modelo é muito ampla | Adicione filtros determinísticos e orçamentos por tarefa |
| Linhas duplicadas aparecem após tentativas | Armazenamento não é idempotente | Atualize por chave de origem estável e versão de conteúdo |
| HTTP 429 repete | Concorrência é controlada por trabalhador, não globalmente | Introduza um orçamento de taxa compartilhado e respeite as orientações de tentativa |
O GLM-5.3 pode tornar a extração de dados da web mais flexível, mas a confiabilidade vem do sistema ao redor. Mantenha controle de acesso, renderização, classificação de estado da página, tratamento de verificação, validação de esquema e armazenamento como estágios explícitos. Use o modelo apenas após a aplicação ter confirmado que está olhando para o conteúdo pretendido.
Para um fluxo de navegador autorizado com uma tarefa de verificação suportada, CapSolver pode fornecer a fronteira da tarefa documentada. A aplicação permanece responsável por permissão, continuidade da sessão, tentativas limitadas, tratamento de segredos e prova de que o fluxo original foi concluído.
Q: O GLM-5.3 pode substituir um navegador em raspagem de web?
Não. Ele pode interpretar texto, capturas de tela ou registros normalizados, mas um navegador ou cliente HTTP ainda é responsável pela navegação, renderização, estado, permissões e verificação do resultado final.
Q: O HTML bruto deve ser enviado diretamente para o GLM-5.3?
Normalmente não. Classifique a resposta primeiro, remova scripts e ruído de layout repetido, preservando rótulos e estrutura significativos, e limite a entrada aos dados necessários pelo esquema de extração.
Q: Quando o fluxo de trabalho deve chamar o CapSolver?
Apenas após detectar uma tarefa suportada em um fluxo de trabalho permitido. Use o tipo de tarefa atualmente documentado, preservando o contexto do navegador necessário, defina um prazo e verifique se a página realmente continuou.
Q: Um JSON válido significa que o registro extraído está correto?
Não. A sintaxe JSON não comprova a precisão fática. Campos obrigatórios, tipos, URLs, datas, intervalos numéricos, duplicatas e evidências da fonte ainda devem ser verificados no código.
Q: O que deve acontecer quando o estado da página for desconhecido?
Pare e solicite revisão. Não envie conteúdo desconhecido para o modelo ou tente novamente por meio de etapas adicionais de navegador e verificação.
Q: O design pode ser usado para dados privados ou restritos?
O design não cria permissão. Use-o apenas para dados públicos ou de outra forma autorizados, minimize as informações coletadas e siga os termos, contratos e leis aplicáveis.
Adélia Cruz
MCP Integration Engineer
Making CapSolver tools accessible through MCP.
SOBRE O AUTOR
Entenda o suporte a proxy MCP de CAPTCHA em toda a conexão do cliente, navegador e tarefa de resolução, incluindo os limites das ferramentas MCP da CapSolver atuais.
Entenda o tratamento de CAPTCHA do Stagehand, compare as ações do navegador com serviços de resolução e escolha uma abordagem clara para navegadores locais ou sessões hospedadas.