🎉BARUCapSolver untuk agen AI-Integrasi MCP, alat agen, dan SDK
Ethan Collins
AI Agent Workflow Engineer
Diterbitkan Nov 13, 2026
Diperbarui Nov 13, 2026 · min baca
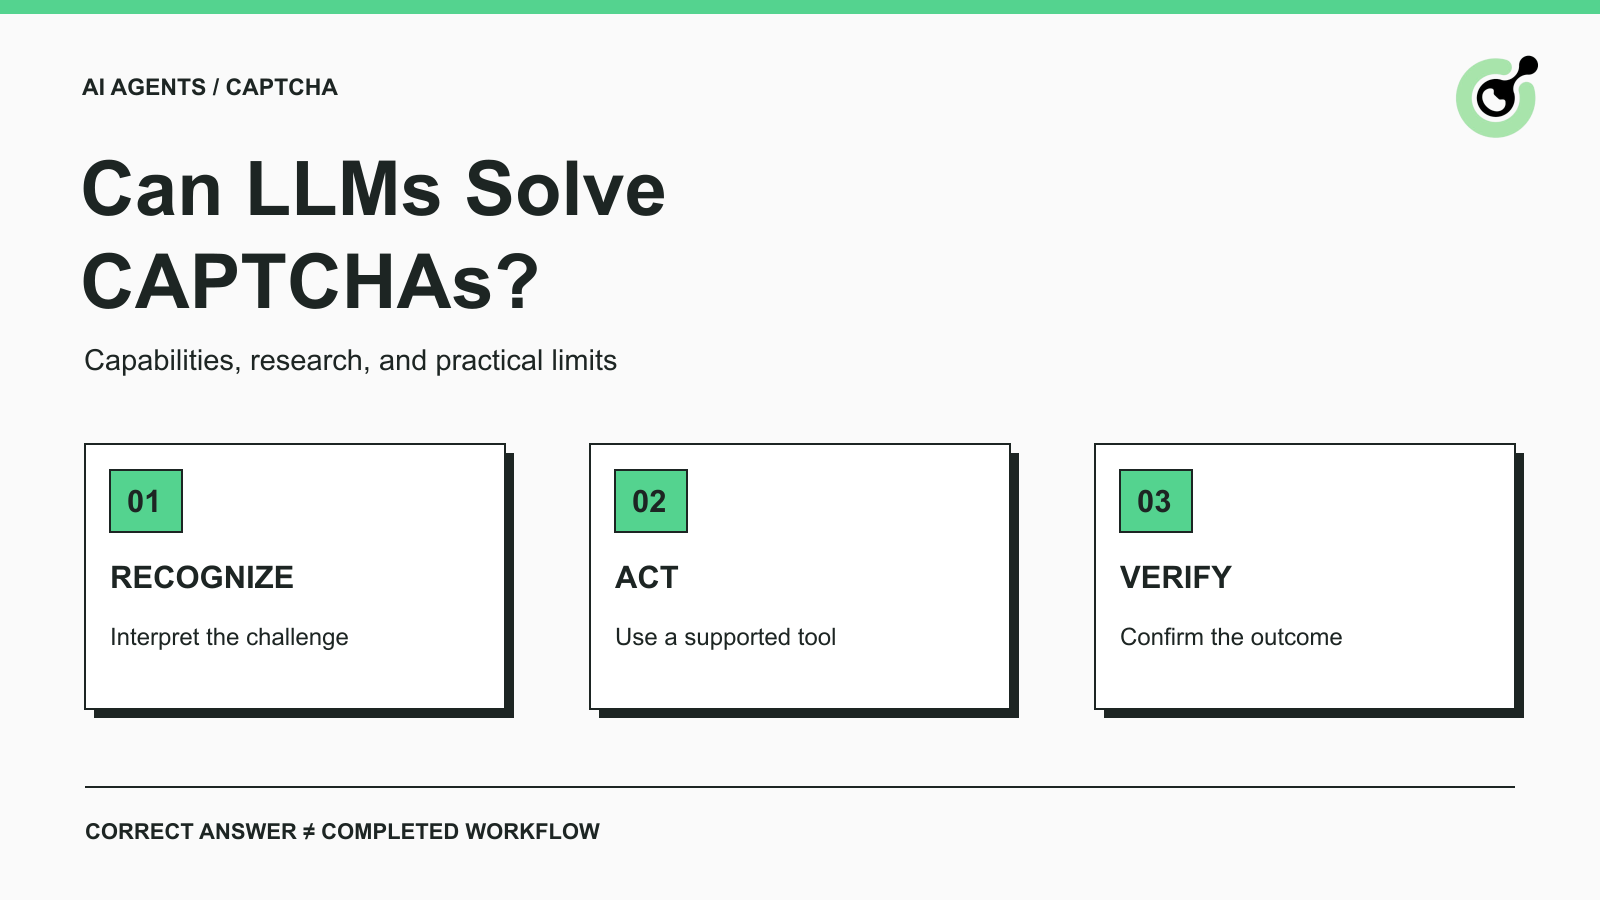
Tangkapan layar yang menunjukkan objek teridentifikasi dengan benar adalah bukti yang berguna tentang kemampuan visi sebuah model. Namun hal itu masih menyisakan pertanyaan: apakah aplikasi menerima verifikasi dan menyelesaikan operasi yang diminta? Pembedaan ini penting saat mengevaluasi pemecah CAPTCHA LLM untuk agen browser, QA, atau pengumpulan data yang diizinkan.
Panduan ini menjelaskan apa arti istilah tersebut, apa yang ditunjukkan riset, dan pemeriksaan apa saja yang termasuk dalam sebuah evaluasi. Panduan ini juga menunjukkan di mana layanan seperti CapSolver berada. Fokusnya adalah kemampuan dan pemilihan produk, bukan prompt untuk menyerang situs tertentu atau klaim bahwa setiap agen AI dapat menyelesaikan setiap tantangan.
Pemecah CAPTCHA berbasis LLM menggunakan model bahasa, biasanya dengan pemahaman gambar, untuk menafsirkan tugas CAPTCHA atau membantu mengoordinasikan penyelesaiannya. Frasa ini mencakup beberapa sistem berbeda, jadi tanyakan apa sebenarnya yang diterima dan dikembalikan produk tersebut.
Satu sistem mungkin menerima gambar dan menghasilkan jawaban teks. Sistem lain mungkin mengembalikan lokasi klik yang diusulkan. Agen browser mungkin memanggil layanan pemecah terpisah, lalu melanjutkan tugas setelah kode aplikasi tepercaya memeriksa hasilnya. Sistem-sistem ini memerlukan metode evaluasi yang berbeda.
Entri glosarium LLM menjelaskan kategori model dasarnya. Menambahkan browser atau alat pemecah memberi model kemampuan tambahan; hal itu tidak membuat setiap hasil alat menjadi hasil penalaran visual model itu sendiri.
Pengenalan menanyakan apakah model menafsirkan input tantangan dengan benar. Orkestrasi menanyakan apakah agen memilih dan menggunakan alat yang tepat pada titik yang tepat dalam sebuah alur kerja.
Agen yang mendelegasikan CAPTCHA ke sebuah API dapat bermanfaat tanpa memecahkan gambar itu sendiri. Sebaliknya, model yang memberi label gambar dengan benar mungkin tetap tidak memiliki kontrol browser, input tugas, atau respons yang diterima yang dibutuhkan untuk menyelesaikan operasi web. Evaluasilah peran yang benar-benar dibutuhkan aplikasi Anda.
Riset yang dipublikasikan menunjukkan bahwa kinerja bervariasi di berbagai jenis tantangan dan desain sistem. Riset ini mendukung jawaban bersyarat untuk pertanyaan “dapatkah LLM memecahkan CAPTCHA?”
Makalah riset Oedipus mengkaji CAPTCHA penalaran dan melaporkan kesulitan saat menggunakan kemampuan LLM secara langsung. Kerangka kerja yang diusulkannya menambahkan dekomposisi tugas dan representasi khusus domain. Hasil kerangka kerja tersebut karenanya mencakup sistem sekitar, bukan hanya model tanpa bantuan.
Studi COGNITION mengevaluasi model multimodal di berbagai jenis tugas CAPTCHA. Temuannya membedakan tugas berorientasi pengenalan dengan interaksi rendah dari tugas lokalisasi, penalaran spasial, dan lintas-bingkai yang lebih sulit. Makalah ini juga mempertimbangkan percobaan ulang, latensi, dan biaya, bukan hanya akurasi.
Studi-studi ini tidak memberikan tingkat keberhasilan yang dapat ditransfer untuk setiap layanan, browser, atau penerapan langsung. Saat membaca hasil, tetap kaitkan model yang dievaluasi, kumpulan tugas, toleransi percobaan ulang, dan titik ukur dengan klaimnya. Nama model yang lebih baru saja bukan bukti bahwa hasil yang sama tetap berlaku.
Deskripsi tolok ukur yang berguna memberi tahu Anda apakah keberhasilan berarti label yang benar, rangkaian interaksi yang diterima, respons server yang valid, atau penyelesaian pekerjaan asli aplikasi.
Untuk tim QA terotorisasi, tolok ukur gambar–jawaban dapat membantu memilih komponen pengenalan. Tim agen browser membutuhkan bukti tambahan tentang interaksi halaman dan penyelesaian aplikasi. Tidak ada tim yang boleh diam-diam mengganti satu pengukuran dengan yang lain.
Periksa juga apakah percobaan yang gagal atau habis waktu tetap berada dalam penyebut. Hanya melaporkan keluaran yang berhasil menyembunyikan pekerjaan yang harus diselidiki operator.
Jawaban visual yang benar dapat tidak memadai karena aplikasi mungkin memerlukan respons verifikasi yang valid dan pemeriksaan penerimaan miliknya sendiri. Teka-teki yang terlihat hanyalah bagian yang terungkap oleh tangkapan layar.
Sebagai contoh, dokumentasi verifikasi respons Google menjelaskan token respons yang diverifikasi backend aplikasi. Dokumentasi itu menyebutkan masa berlaku dua menit dan sekali pakai. Deskripsi gambar yang dihasilkan model bukanlah respons verifikasi tersebut.
Demikian pula, panduan validasi Turnstile Cloudflare mengharuskan validasi token di sisi server dan menjelaskan masa berlaku lima menit dengan token sekali pakai. Turnstile tidak boleh dievaluasi seolah-olah hanya tugas pelabelan gambar.
Contoh-contoh ini menetapkan mengapa titik akhir evaluasi penting. Contoh tersebut tidak menyiratkan bahwa sebuah pemecah menjamin akses aplikasi. Situs tetap mengontrol logika aplikasi dan keputusan aksesnya.
Saat menguji aplikasi Anda sendiri, periksalah hasil validasi sisi server dan status akhir aplikasi. Saat bekerja dengan alur kerja pihak ketiga yang diizinkan, gunakan hasil yang dapat diamati dan terdokumentasi yang tersedia bagi Anda.
Jika hasil backend tidak tersedia, beri label tidak diketahui. Tombol yang berubah, widget yang tertutup, atau respons API yang dikembalikan mungkin sinyal yang berguna, tetapi tidak satu pun yang boleh diam-diam menjadi “server menerima” dalam sebuah laporan.
Tukarkan Kode Bonus CapSolver Anda
Tingkatkan anggaran automasi Anda seketika!
Gunakan kode bonus CAP26 saat mengisi saldo akun CapSolver Anda untuk mendapatkan bonus 5% tambahan pada setiap pengisian — tanpa batas.
Tukarkan sekarang di Dasbor CapSolver
Pemecah CAPTCHA khusus menangani tugas verifikasi yang didukung di dalam alur kerja terotorisasi yang lebih besar. Agen tetap bertanggung jawab atas tujuan awal, dan aplikasi tetap bertanggung jawab atas pemeriksaan hasil.
Dokumentasi CapSolver Agent Tools menjelaskan pembagian antara keputusan model, adaptor alat, dan lapisan eksekusi Core. Itu memberi tim jalur integrasi terdokumentasi tanpa mengharuskan model bahasa menyimpulkan protokol pemecahan dari sebuah tangkapan layar.
Evaluasi praktis sebaiknya mengikuti urutan ini:
Ini adalah daftar tanggung jawab, bukan kode integrasi yang dapat dieksekusi. Gunakan contoh resmi untuk kerangka kerja pilihan Anda dan verifikasikan di lingkungan Anda sebelum penerapan.
Model biasanya memerlukan penjelasan hasil, seperti selesai, masih tertunda, atau dihentikan untuk ditinjau. Model tidak memerlukan seluruh isi cookie browser, kredensial layanan, atau setiap respons mentah.
Hal ini membuat pemecahan masalah lebih jelas. Catat tantangan yang diamati, operasi yang dipilih, dan status akhir secara terpisah. Jika pemanggilan alat tidak pernah dimulai, selidiki pemilihan alat. Jika pemecah mengembalikan hasil tetapi aplikasi menolaknya, selidiki tahap selanjutnya.
Untuk pertanyaan implementasi terpisah mengenai memilih input tangkapan layar atau API token, lihat Penanganan CAPTCHA untuk agen computer-use. Keputusan itu bergantung pada apa yang dapat diamati dan dijalankan runtime.
Evaluasilah pemecah CAPTCHA berbasis LLM terhadap kumpulan tugas kecil yang terotorisasi dengan kondisi penerimaan eksplisit. Tujuannya adalah menguji peran yang Anda butuhkan, bukan membuat papan peringkat universal.
Tuliskan jenis input, tindakan yang diizinkan, keluarga tantangan yang didukung, anggaran percobaan ulang, dan status akhir yang diharapkan sebelum membandingkan sistem. Pisahkan kegagalan browser biasa dari kegagalan tantangan. Jika tidak, pemuatan halaman yang lambat dapat mengaburkan hasil pemecahan yang tampak.
Laporkan jumlah keluaran, waktu yang berlalu, percobaan yang digunakan, dan biaya untuk unit evaluasi lengkap. Jika unitnya adalah pekerjaan agen, sertakan pekerjaan yang gagal dan panggilan berbayar berulang. Jika itu tugas gambar, katakan secara langsung.
Laporan evaluasi yang berguna juga mencatat kasus negatif. Sertakan tantangan yang tidak didukung, input wajib yang hilang, dan hasil yang tiba setelah pekerjaan berakhir. Perilaku yang diinginkan dalam kasus tersebut mungkin adalah berhenti dengan jelas, bukan percobaan lain.
Jangan menafsirkan pernyataan keyakinan model sebagai probabilitas terukur akan penerimaan. Gunakan hasil yang diamati dari aplikasi atau harness uji. Jaga agar harness terbatas pada sistem dan data yang Anda berwenang untuk uji.
Uji kecil dapat menunjukkan bahwa integrasi berperilaku seperti yang dimaksud pada kasus yang diperiksa. Uji tersebut tidak dapat membenarkan klaim seperti “terbaik untuk semua agen” atau “berfungsi di setiap situs.” Pertahankan laporan uji tetap terlampir pada keputusan pembelian sehingga tim lain dapat melihat batasannya.
Saat persyaratan berubah, ulangi kasus yang relevan. Mengubah model, runtime browser, jenis tugas pemecah, atau aplikasi target dapat mengubah apa yang dibuktikan oleh bukti Anda sebelumnya. Pernyataan kompatibilitas yang tepat lebih berguna daripada janji tanpa batas.
Pilih model pengenalan ketika kebutuhannya adalah tugas pemahaman gambar yang terbatas dan dapat Anda evaluasi langsung. Pilih integrasi pemecah yang terdokumentasi ketika aplikasi terotorisasi memerlukan hasil CAPTCHA yang didukung. Gunakan agen ketika pekerjaan di sekitarnya mendapat manfaat dari perencanaan dan pemilihan alat.
CapSolver dapat menyediakan langkah pemecahan yang terdokumentasi. Konfirmasikan jenis tugas yang saat ini didukung, uji alur kerja terotorisasi yang lengkap, dan perlakukan penerimaan aplikasi sebagai hasil terpisah.
Mulailah dengan panduan memulai CAPTCHA resmi dan pilih kapabilitas yang sesuai dengan tantangan Anda yang sebenarnya. Jaga agar uji pertama cukup kecil sehingga Anda dapat memeriksa setiap hasil sebelum memperluas penggunaan.
T: Dapatkah LLM memecahkan CAPTCHA?
LLM dengan kemampuan visual yang memadai dapat memecahkan beberapa tugas CAPTCHA yang dievaluasi. Hasil bergantung pada tantangan, model, sistem sekitar, dan definisi keberhasilan. Jawaban visual yang benar tidak secara otomatis membuktikan verifikasi situs web yang berhasil.
T: Apakah pemecah CAPTCHA berbasis LLM sama dengan API CAPTCHA?
Tidak. LLM adalah komponen model; API CAPTCHA mengekspos operasi layanan yang terdokumentasi. Agen dapat memanggil API tersebut tanpa melakukan pengenalan gambar yang mendasarinya sendiri.
T: Dapatkah LLM teks saja memecahkan CAPTCHA gambar?
LLM teks saja tidak dapat memeriksa gambar secara langsung. Model tersebut memerlukan komponen terpisah yang mampu memproses gambar atau sumber informasi visual lain, dan sistem lengkapnya tetap perlu dievaluasi.
T: Haruskah agen terus mencoba sampai CAPTCHA lolos?
Tidak. Tetapkan anggaran percobaan dan waktu yang eksplisit, lalu berhenti atau minta peninjauan ketika anggaran habis. Percobaan berulang tidak boleh menyembunyikan input yang tidak didukung atau penolakan aplikasi.
T: Apakah tolok ukur riset membuktikan pemecah akan berfungsi di situs saya?
Tidak. Tolok ukur menjelaskan tugas dan kondisi yang dievaluasi. Validasi kapabilitas yang dibutuhkan di lingkungan terotorisasi Anda dan bedakan hasil pengenalan dari penyelesaian aplikasi.
Ethan Collins
AI Agent Workflow Engineer
Building clearer handoffs between AI agents and tools.
TENTANG PENULIS
Tentukan masukan CAPTCHA mana yang sebenarnya dapat diberikan oleh agen penggunaan komputer Anda, dan kapan harus beralih ke inspeksi browser atau meminta masukan manusia.
Tangani pembatalan CAPTCHA MCP dalam agen AI. Hentikan pemanggilan baru, bedakan tugas jarak jauh dari penantian lokal, dan cegah hasil yang terlambat dari memulai ulang pekerjaan.