
🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Jun 10, 2026
अद्यतन Jun 10, 2026 · मिनट पढ़ने का समय
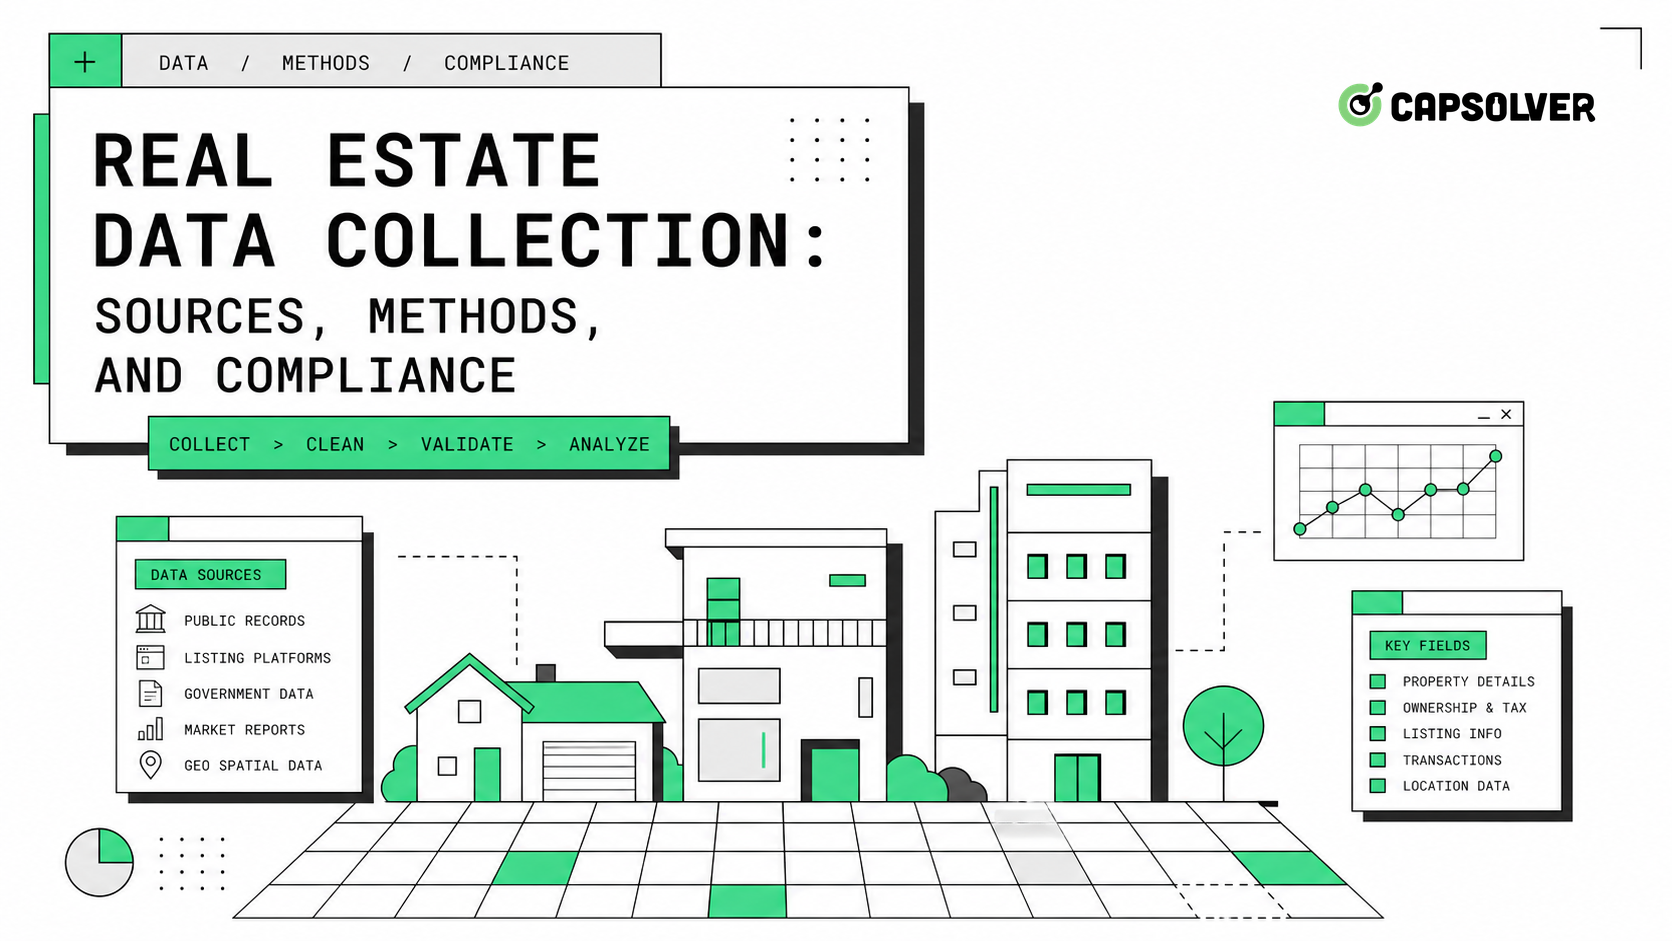
रियल एस्टेट डेटा संग्रह विश्लेषण के लिए अच्छी तरह से संग्रहित, साफ करना और संगठित करना है जो संपत्ति, बाजार, मालिकता, लेन-देन और पड़ोस के डेटा के लिए डेटा के एक विश्वसनीय सेट के निर्माण के लिए लक्ष्य है। लक्ष्य केवल अधिक रिकॉर्ड संग्रहित करना नहीं है। लक्ष्य मूल्य निर्धारण मॉडल, नेतृत्व जनन, निवेश अनुसंधान, पोर्टफोलियो मॉनिटरिंग, मूल्यांकन कार्यप्रणाली और बाजार बुद्धिमत्ता के समर्थन के लिए एक विश्वसनीय डेटा सेट बनाना है। एक मजबूत वर्कफ़्लो आधिकारिक सार्वजनिक डेटासेट, लाइसेंसित MLS या लिस्टिंग फीड्स, सरकारी रिकॉर्ड, भूस्थानिक डेटा और ध्यान से नियंत्रित वेब संग्रह के संयोजन के साथ होता है। CapSolver तब संबंधित होता है जब एक अनुमोदित डेटा वर्कफ़्लो को CAPTCHA या ट्रैफिक सत्यापन के साथ निपटना होता है बिना डेटा संग्रह को अनियंत्रित पुनर्प्रयास व्यवहार में बदले।
रियल एस्टेट डेटा संग्रह आमतौर पर पांच सूचना समूहों को कवर करता है। संपत्ति विशेषताएं संपत्ति के खुद के बारे में होती हैं: पता, पैरसेल आईडी, संपत्ति प्रकार, बेडरूम, बाथरूम, वर्ग फुटेज, लॉट का आकार, बनाए गए वर्ष, जोनिंग और भवन वर्ग। बाजार डेटा मूल्य और मांग के बारे में होता है: लिस्टिंग मूल्य, बिक्री मूल्य, किराया अनुमान, बाजार में दिन, भंडार, मूल्य कमी और अवशोषण प्रवृत्ति। मालिकता और लेन-देन डेटा बताता है कि कौन संपत्ति के मालिक हैं और वे कैसे हाथ बदले हैं। अनुमति और निर्माण डेटा रिनोवेशन, नई निर्माण और सुधार गतिविधि दिखाता है। स्थिति डेटा स्कूल क्षेत्र, यात्रा पैटर्न, बाढ़ का जोखिम, सुविधाएं, सांख्यिकीय जनसांख्यिकी और पड़ोसी सीमाएं जोड़ता है।
एक उपयोगी रियल एस्टेट डेटा सेट न केवल संपत्ति बल्कि उसके आसपास के बाजार के बारे में समझाना चाहिए। एक एकल लिस्टिंग मूल्य पर्याप्त नहीं है। विश्लेषकों को समान बिक्री, लिस्टिंग इतिहास, पड़ोसी संदर्भ और डेटा गुणवत्ता चिह्न की आवश्यकता होती है। उदाहरण के लिए, एक मल्टीफैमिली निवेशक को किराया समान और अनुमति इतिहास की आवश्यकता हो सकती है, जबकि एक ब्रोकरेज प्लेटफॉर्म को सक्रिय लिस्टिंग, खुले घर के समय और एजेंट मेटाडेटा की आवश्यकता हो सकती है। एक लेंडर के पास संपत्ति मूल्यांकन, मालिकता, कर इतिहास और नियामक जोखिम पर ध्यान केंद्रित करना हो सकता है।
रियल एस्टेट डेटा संग्रह रणनीति के लिए सबसे अच्छा आधिकारिक स्रोत होता है। सरकारी डेटा आमतौर पर लिस्टिंग डेटा की तुलना में धीमा होता है, लेकिन यह मूल्यवान होता है क्योंकि यह ट्रेसेबल और संरचित होता है। संयुक्त राज्य अमेरिका के सीनस ब्यूरो निवास विशेषताओं, भूगोल, निर्माण और जनसांख्यिकीय संदर्भ के डेटासेट के लिए APIs प्रदान करता है; इसका सीनस API कैटलॉग निवास और स्थानीय-बाजार सुधार के लिए एक उपयोगी शुरुआती बिंदु है।
उद्योग मानक भी महत्वपूर्ण होते हैं। MLS और ब्रोकरेज परिसर आमतौर पर मानकीकृत क्षेत्र होते हैं ताकि डेटा प्रणालियों के बीच आसानी से आगे बढ़ सके। RESO डेटा शब्दकोश रियल एस्टेट टीमों के लिए बाजार के आसपास लिस्टिंग क्षेत्र, संपत्ति विशेषताएं और लेन-देन अवधारणाओं के साथ संगतता प्रदान करता है। यदि आपके डेटा मॉडल उद्योग शब्दावली को अनदेखा करता है, तो प्रत्येक एकीकरण अधिक महंगा हो जाता है।
बाजार संकेत एक और परत जोड़ते हैं। रियल्टर्स एसोसिएशन के अस्तित्व में घर के डेटा के अस्तित्व में घर के बिक्री डेटा प्रकाशित करता है, जबकि सेंट्रल फेडरल रिजर्व बैंक ऑफ सेंट लुइस बहुत सारे सार्वजनिक निवास समय श्रृंखला के FRED निवास डेटा संगठित करता है। इन स्रोतों की मदद से टीमें संपत्ति-स्तर के संकेतों के साथ व्यापक निवास बाजार प्रवृत्तियों की तुलना कर सकती हैं।
वेब संग्रह तब अंतराल भर सकता है जब डेटा सार्वजनिक, अनुमति और बेहतर API या लाइसेंसित फीड के बिना उपलब्ध नहीं होता है। एक ब्रोकरेज निजी लिस्टिंग परिवर्तनों की निगरानी कर सकता है। एक निवेशक आवेदन किराया की निगरानी कर सकता है। एक प्रोपटेक कंपनी ओपन-हाउस शेड्यूल, ब्रोकर विवरण या सुविधा विवरण के संग्रह कर सकती है। यहीं पर रियल एस्टेट डेटा संग्रह ऑपरेशनल रूप से संवेदनशील हो जाता है।
किसी वेबसाइट से संग्रह करने से पहले, एक्सेस नियमों, शर्तों, रोबोट्स गाइडेंस और स्थानीय कानूनों की समीक्षा करें। अनुमति के बिना निजी, सीमित, खाता-केंद्रित या व्यक्तिगत डेटा का संग्रह न करें। तकनीकी एक्सेस अनुमति नहीं बनाता है। यदि एक साइट एक API, पार्टनर फीड या लाइसेंसिंग मार्ग प्रदान करती है, तो स्क्रैपिंग से पहले इसका उपयोग करें। एक वेब स्क्रैपिंग FAQ उपयोगी होता है जब आप जिम्मेदार संग्रह सीमाओं पर सोचते हैं, और एक बुनियादी वेब स्क्रैपिंग वर्कफ़्लो में दर सीमा, पुनर्प्रयास, लॉगिंग और बंद शर्तों को शामिल करना चाहिए।
एक व्यावहारिक रियल एस्टेट डेटा संग्रह स्कीमा ब्रूट क्षेत्रों को नॉर्मलाइज्ड क्षेत्रों से अलग करना चाहिए। ब्रूट क्षेत्र स्रोत द्वारा प्रदान किए गए डेटा को बरकरार रखते हैं। नॉर्मलाइज्ड क्षेत्र रिकॉर्ड की तुलना करने में मदद करते हैं।
महत्वपूर्ण संपत्ति क्षेत्रों में पूरा पता, पार्स किया गया पता, अक्षांश, देशांतर, पैरसेल आईडी, संपत्ति प्रकार, भवन आकार, लॉट का आकार, बनाए गए वर्ष, इकाइयां, बेडरूम, बाथरूम, पार्किंग, एचओए शुल्क, कर मूल्यांकन, जोनिंग और अंतिम बिक्री की तारीख शामिल हैं। महत्वपूर्ण लिस्टिंग क्षेत्रों में लिस्टिंग आईडी, स्रोत URL, लिस्टिंग स्थिति, कीमत, किराया, कीमत इतिहास, लिस्टिंग तिथि, बाजार में दिन, एजेंट, ब्रोकर, फोटो, विवरण, ओपन-हाउस समय और अपडेट समय शामिल हैं। महत्वपूर्ण बाजार क्षेत्रों में मध्यम मूल्य, भंडार, अवशोषण दर, प्रति वर्ग फुट किराया, बिक्री-सूची अनुपात और तुलना-संपत्ति संदर्भ शामिल हैं।
एक पता मिलान को छोटी बात न मानें। रियल एस्टेट डेटा संग्रह अक्सर इसलिए विफल हो जाता है क्योंकि एक ही संपत्ति थोड़े अलग पते पर दिखाई देती है। सड़क के अंत वाले नाम, फ्लैट नंबर, भूस्थानिक डेटा और पैरसेल पहचानकर्ता को नॉर्मलाइज करें। नीचे के उपयोगकर्ता को बताने के लिए विश्वास स्कोर रखें कि क्या मिलान सटीक, संभावित या अनिर्णीत है।
रियल एस्टेट डेटा संग्रह हर चरण पर गुणवत्ता जांच की आवश्यकता होती है। डुप्लिकेशन हटाना पहला नियंत्रण है। एक ही संपत्ति सार्वजनिक रिकॉर्ड, MLS फीड्स, एग्रीगेटर साइट, किराया प्लेटफॉर्म और जिला कर डेटा में दिखाई दे सकती है। रिकॉर्ड को सावधानी से मिलाएं और स्रोत वंशावली बरकरार रखें। एक कम विश्वास वाला मिलान मूल्य निर्धारण मॉडल को खराब कर सकता है।
ताजगी दूसरा नियंत्रण है। लिस्टिंग स्थिति तेजी से बदल जाती है। एक संपत्ति कुछ दिनों में सक्रिय से प्रतीक्षा से बिक्री तक बदल सकती है। एक जमे हुए सक्रिय लिस्टिंग खरीदारों, निवेशकों और आंतरिक टीमों को भ्रमित कर सकती है। first_seen, last_seen, last_changed और स्रोत अपडेट समय संग्रहित करें। सभी साइटों को एक ही दर पर चलाने के बजाय स्रोत-विशिष्ट अपडेट योजनाओं का उपयोग करें।
सत्यापन तीसरा नियंत्रण है। असंभव मूल्यों को चिह्नित करें जैसे ऋणात्मक वर्ग फुटेज, भविष्य में बिक्री की तारीख, जबकि स्रोत कीमत की आवश्यकता होती है और एक संपत्ति की कीमत शून्य होती है या एक विवरण एक तार्किक रेंज के बाहर होता है। संभव होने पर सार्वजनिक रिकॉर्ड के साथ संपत्ति प्रकार, इकाई संख्या और लॉट के आकार की तुलना करें।
रियल एस्टेट वेबसाइट आमतौर पर ट्रैफिक सत्यापन उपयोग करती है क्योंकि लिस्टिंग पृष्ठ व्यावसायिक रूप से मूल्यवान होते हैं और अक्सर स्क्रैप किए जाते हैं। एक जिम्मेदार रियल एस्टेट डेटा संग्रह वर्कफ़्लो को इन स्थितियों को स्पष्ट रूप से पहचानना चाहिए। यदि कैप्चा, क्लाउडफ़ेयर टर्नस्टाइल, दर सीमा या कठोर ब्लॉक दिखाई देता है, तो संग्रहकर्ता सामान्य स्क्रैपिंग व्यवहार को बंद कर देना चाहिए और एक संरचित स्थिति वापस करना चाहिए।
अनुमति सार्वजनिक डेटा वर्कफ़्लो के लिए, एक कैप्चा हैंडलिंग प्रक्रिया छिपे हुए एक पुनर्प्रयास लूप के बजाय स्पष्ट होनी चाहिए। यदि वर्कफ़्लो में घूमते नेटवर्क का उपयोग करता है, तो प्रॉक्सी गुणवत्ता की समीक्षा करें और सत्र स्थिर रखें। एक लिस्टिंग सत्र के दौरान यादृच्छिक आईपी परिवर्तन वैधता कठिन बना सकते हैं। यदि एक साइट दोहराए गए चुनौतियां दिखाती है, तो धीमा हो जाएं, समानांतरता कम करें, या अनुमोदित डेटा एक्सेस रास्ता का उपयोग करें।
CapSolver बोनस कोड का उपयोग करें
अपने स्वचालन बजट को तुरंत बढ़ाएं!
CapSolver खाता में जमा करते समय बोनस कोड CAP26 का उपयोग करें ताकि प्रत्येक जमा पर 5% बोनस मिले — कोई सीमा नहीं।
अपने CapSolver डैशबोर्ड में अब बोनस कोड का उपयोग करें
रियल एस्टेट डेटा संग्रह संवेदनशील क्षेत्रों को स्पर्श कर सकता है। सार्वजनिक संपत्ति रिकॉर्ड असीमित व्यक्तिगत प्रोफाइलिंग के समान नहीं होते हैं। मालिकता डेटा, फोन नंबर, ईमेल, टेंट के विवरण, वित्तीय कठिनाई संकेत और आवास संकेतों की आवश्यकता होती है। बड़े पैमाने पर संग्रह करने से पहले एक डेटा नीति बनाएं।
एक जिम्मेदार नीति अनुमति स्रोत, निषिद्ध क्षेत्र, बनाए रखने की अवधि, एक्सेस नियंत्रण और मिटाने की प्रक्रिया को परिभाषित करना चाहिए। यह यह भी परिभाषित करना चाहिए कि कब संग्रह बंद कर देना चाहिए। एक कठोर 403, लॉगिन दीवार, खाता सीमा या स्पष्ट अस्वीकृति को बंद संकेत के रूप में लें। यदि आपकी टीम लेंडिंग, बीमा, टेंट स्क्रीनिंग या विज्ञापन के लिए डेटा संग्रह करती है, तो कानूनी समीक्षा विशेष रूप से महत्वपूर्ण है क्योंकि आवास डेटा न्यायसंगत आवास, गोपनीयता और उपभोक्ता-सुरक्षा नियमों के साथ एकजुट हो सकता है।
एक साफ वर्कफ़्लो में छह चरण होते हैं। पहला, व्यापार प्रश्न को परिभाषित करें। एक मूल्य निर्धारण मॉडल, नेतृत्व सूची, किराया समान इंजन और निवेश डैशबोर्ड के लिए अलग-अलग क्षेत्र की आवश्यकता होती है। दूसरा, अनुमति स्रोतों का नक्शा बनाएं। एपीआई, लाइसेंसित फीड्स, सार्वजनिक रिकॉर्ड और अनुमति वाले वेब स्रोत चुनें। तीसरा, स्कीमा डिजाइन करें। स्थिर पहचानकर्ता, स्रोत वंशावली और गुणवत्ता चिह्न का उपयोग करें। चौथा, अनुक्रमिक रूप से संग्रह करें। बदलाव की जांच के लिए पूर्ण पुनर्संग्रह बचें। पांचवां, नॉर्मलाइज और सत्यापित करें। पता, संपत्ति प्रकार, मुद्रा, क्षेत्र और समय चिह्न को मानकीकृत करें। छठा, ड्रिफ्ट की निगरानी करें। स्रोत व्यवस्था, क्षेत्र के अर्थ और बाजार स्थिति बदलती रहती हैं।
स्वचालन दृश्यमान होना चाहिए। क्रॉल स्थिति, स्रोत उत्तर, पता चला चुनौति स्थिति, रिकॉर्ड संख्या, सत्यापन त्रुटियां और अपलोड समय संग्रहित करें। यदि संग्रह विफल रहता है, तो प्रणाली यह स्पष्ट करना चाहिए कि कारण स्रोत बंद हो गया, स्कीमा बदल गई, दर सीमा, कैप्चा, पार्सर त्रुटि या अनुमति की कमी थी।
सबसे बड़ी गलती उपयोग के मामले की परिभाषा के बिना संग्रह करना है। रियल एस्टेट डेटा संग्रह बड़े डेटासेट उत्पन्न कर सकता है जो अभी भी उपयोगी नहीं हो सकता है। एक अद्यतन लिस्टिंग या दोहराए गए संपत्ति पर आधारित मॉडल खराब सुझाव उत्पन्न करेगा। शोर एजेंसी डेटा पर आधारित नेतृत्व जनन वर्कफ़्लो बिक्री समय बर्बाद करेगा। एक बाजार डैशबोर्ड जो एक्टिव लिस्टिंग के साथ बिकी गई संपत्ति को स्पष्ट स्थिति चिह्न के बिना मिश्रित करता है, उपयोगकर्ताओं को भ्रमित करेगा।
दूसरी गलती एक स्रोत पर भरोसा करना है। आधिकारिक रिकॉर्ड सटीक हो सकते हैं लेकिन देरी हो सकती है। लिस्टिंग साइट ताजा हो सकती है लेकिन अस्थिर हो सकती है। ब्रोकर फीड्स संरचित हो सकती हैं लेकिन लाइसेंस द्वारा सीमित हो सकती हैं। वेब डेटा समृद्ध हो सकता है लेकिन नाजुक हो सकता है। सबसे अच्छे सिस्टम स्रोतों के संयोजन के साथ आते हैं और विश्वास दिखाते हैं।
तीसरी गलती ऑपरेशनल नैतिकता को अनदेखा करना है। आक्रामक संग्रह साइटों को भारित कर सकता है, ब्लॉक उत्पन्न कर सकता है और कानूनी जोखिम उत्पन्न कर सकता है। एक मापदंडित, दस्तावेजीकृत, अनुमति-जागरूक वर्कफ़्लो अधिक टिकाऊ होता है।
रियल एस्टेट डेटा संग्रह तब मूल्यवान होता है जब यह सटीक, ताजा, ट्रेसेबल और कानूनी होता है। एक स्पष्ट उपयोग मामले से शुरू करें, जहां संभव हो उच्चाधिकार स्रोतों का उपयोग करें, संपत्ति पहचानकर्ता के सामान्यीकरण करें, प्रत्येक क्षेत्र की सत्यापन करें और वेब संग्रह को एक नियंत्रित वर्कफ़्लो के रूप में नहीं बल्कि एक ब्रूट-फोर्स कार्य के रूप में लें। अनुमोदित स्वचालन में जब सार्वजनिक डेटा संग्रह के दौरान ट्रैफिक सत्यापन या कैप्चा दिखाई देता है, तो CapSolver एक नियंत्रित संग्रह प्रक्रिया का हिस्सा हो सकता है।
रियल एस्टेट डेटा संग्रह विश्लेषण या व्यावसायिक वर्कफ़्लो के लिए अनुमोदित स्रोतों से संपत्ति, लिस्टिंग, लेन-देन, मालिकता, बाजार और स्थिति डेटा के संग्रह की प्रक्रिया है।
एक मजबूत डेटा सेट आमतौर पर पता, पैरसेल आईडी, कीमत, लिस्टिंग स्थिति, संपत्ति प्रकार, वर्ग फुटेज, लॉट का आकार, बनाए गए वर्ष, कर डेटा, लेन-देन इतिहास, किराया संकेत और स्थिति संदर्भ शामिल करता है।
इसके लिए स्रोत, शर्तें, अधिकार, डेटा प्रकार और संग्रह विधि पर निर्भर करता है। जब उपलब्ध हो, एपीआई या लाइसेंसित फीड्स का उपयोग करें, एक्सेस नियमों का सम्मान करें और अनुमति के बिना निजी या सीमित डेटा का संग्रह न करें।
पता सामान्यीकरण, पैरसेल मैचिंग, स्रोत वंशावली, डुप्लिकेशन हटाना, ताजगी जांच, सत्यापन नियम और मिलाए गए रिकॉर्ड के लिए विश्वास स्कोर का उपयोग करें।
रियल एस्टेट साइट आमतौर पर उच्च-आयतन स्वचालित ट्रैफिक से लिस्टिंग डेटा के संरक्षण के लिए कैप्चा का उपयोग करती है। एक जिम्मेदार संग्रहकर्ता को कैप्चा या ट्रैफिक सत्यापन का पता लगाना चाहिए, धीमा हो जाए, और केवल जब वर्कफ़्लो अनुमोदित हो तो आगे बढ़े।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
Rust में वेब स्क्रैपिंग के स्केलेबल आर्किटेक्चर सीखें, reqwest, scraper, असिंक्रोनस स्क्रैपिंग, हेडलेस ब्राउज़र स्क्रैपिंग, प्रॉक्सी रोटेशन, और संगत CAPTCHA का निपटारा।
CapSolver के साथ RoxyBrowser के एकीकरण करें ताकि ब्राउज़र के कार्यों को स्वचालित किया जा सके और reCAPTCHA, Turnstile और अन्य CAPTCHAs को बायपास किया जा सके।
