

🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Nov 16, 2026
अद्यतन Nov 16, 2026 · मिनट पढ़ने का समय
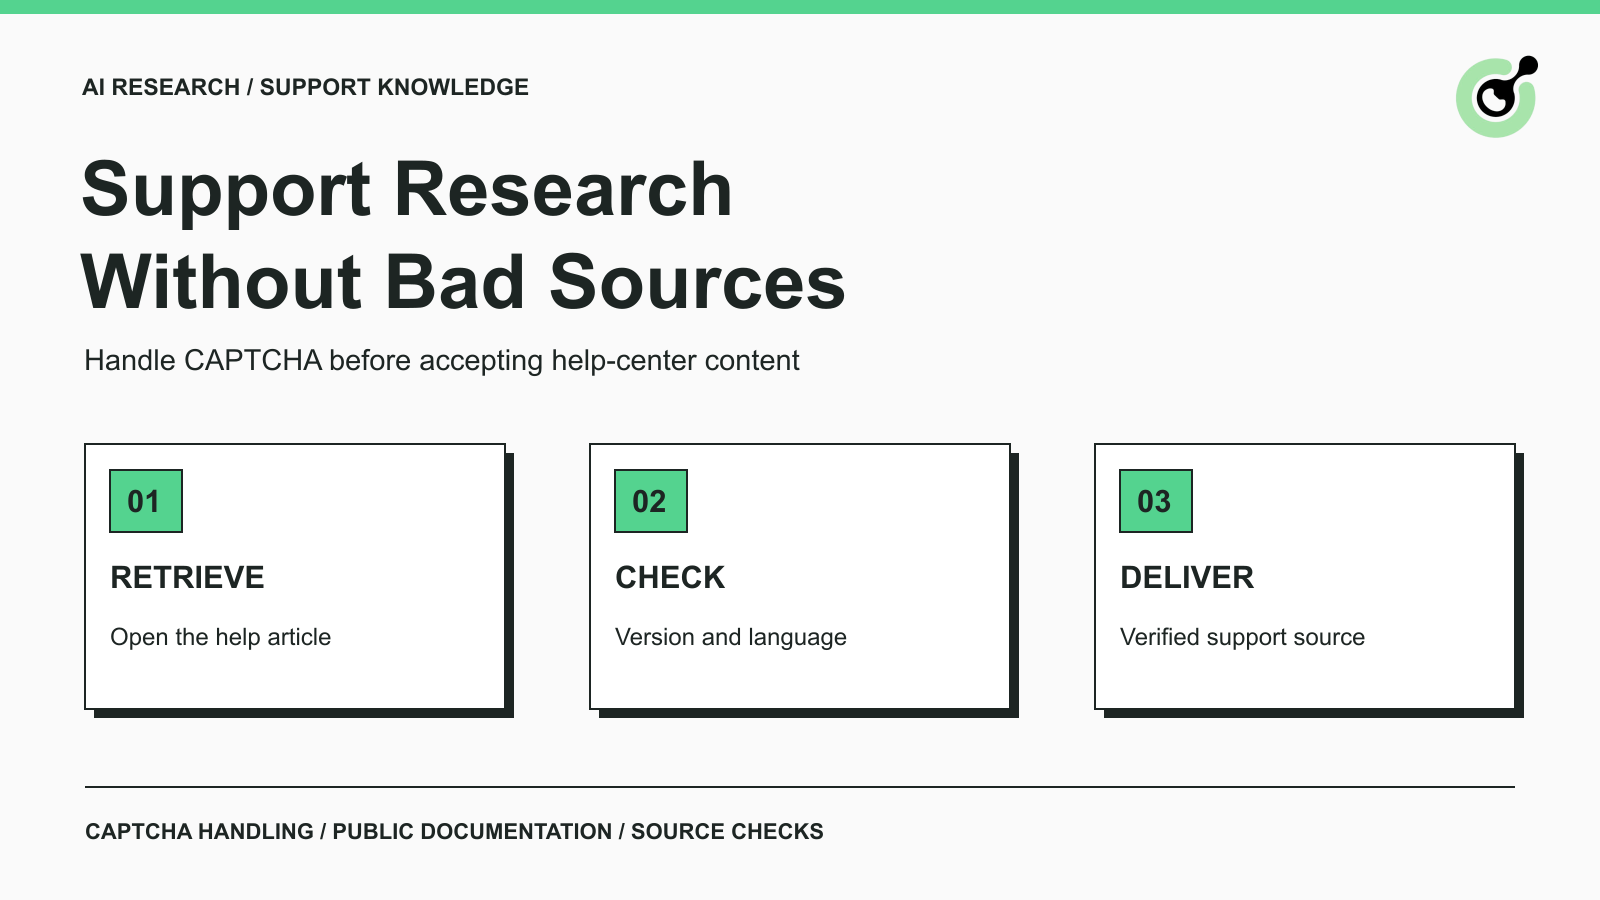
एक सपोर्ट एजेंट किसी उत्पाद से जुड़े प्रश्न की जाँच कर रहा है और आधिकारिक हेल्प‑सेंटर लिंक खोलता है। ऑटोमेशन को आर्टिकल की जगह CAPTCHA पेज मिलता है, लेकिन बाकी वर्कफ़्लो अब भी एक आर्टिकल की उम्मीद कर रहा होता है। यदि यह CAPTCHA प्रतिक्रिया नॉलेज कलेक्शन में चली जाए, तो असिस्टेंट असल निर्देशों की जगह उसी वैरिफिकेशन पेज का सारांश दे सकता है या यह रिपोर्ट कर सकता है कि डॉक्युमेंटेशन में कोई उत्तर नहीं है।
CapSolver अनुमत लुकअप के भीतर आने वाले समर्थित चैलेंज को संभाल सकता है। उसके बाद सपोर्ट वर्कफ़्लो को मूल आर्टिकल पर लौटकर यह पुष्टि करनी होती है कि वह ग्राहक के उत्पाद पर लागू होता है या नहीं। यह गाइड सपोर्ट रिसर्च के लिए सार्वजनिक हेल्प और उत्पाद डॉक्युमेंटेशन इकट्ठा करने पर केंद्रित है। यह ग्राहक टिकट निकालने, अकाउंट एक्सेस, या ग्राहकों को स्वतः जवाब भेजने को कवर नहीं करता।
रिट्रीवल के समय ही CAPTCHA वैरिफिकेशन पेज को पहचानें ताकि वह हेल्प आर्टिकल के रूप में स्वीकार न हो पाए।
समस्या वास्तविक है: Zendesk की हेल्प‑सेंटर CAPTCHA गाइडेंस यह दर्ज करती है कि उपयोगकर्ता और एजेंट, हेल्प‑सेंटर एक्सेस करते समय ऐसे चैलेंज का सामना करते हैं। यह व्यवधान का प्रमाण है, न कि यह सबूत कि हर हेल्प‑सेंटर पेज के लिए सॉल्वर आवश्यक है या CapSolver का Zendesk के साथ कोई प्रमाणित इंटीग्रेशन है।
केवल अपेक्षित आर्टिकल सामग्री ही नहीं, बल्कि चैलेंज के संकेत भी देखें। नेविगेशन, पेज‑टाइटल और वैरिफिकेशन प्रॉम्प्ट के साथ मिली कोई प्रतिक्रिया पूरा HTML दस्तावेज़ हो सकती है, लेकिन फिर भी उसमें अनुरोधित निर्देश अनुपस्थित हो सकते हैं।
संभावित परिणामों को अलग‑अलग पहचानें: सही आर्टिकल लोड हुआ, समर्थित CAPTCHA ने एक्सेस रोका, आर्टिकल कहीं और चला गया, या अनुमति की ज़रूरत है। इन सभी परिणामों को “कोई उपयोगी उत्तर नहीं मिला” की एक ही श्रेणी में नहीं डालना चाहिए। अगले कदम इस बात पर निर्भर करते हैं कि वास्तव में क्या हुआ।
एक AI असिस्टेंट को या तो सत्यापित स्रोत सामग्री मिलनी चाहिए या स्पष्ट “स्रोत उपलब्ध नहीं” जैसा परिणाम। मॉडल से यह उम्मीद करना कि वह केवल चैलेंज पेज देखकर मनचाहा हेल्प आर्टिकल “अंदाजा” लगा लेगा, रिट्रीवल की समस्या हल नहीं करता।
जब हेल्प‑सेंटर का समर्थित API, एक्सपोर्ट या आधिकारिक डॉक्युमेंट फ़ीड आवश्यक सामग्री उपलब्ध करा रहा हो, तो उसी का उपयोग करें।
हेल्प‑सेंटर की अपनी डॉक्युमेंटेशन देखें कि कौन‑सा एक्सपोर्ट या API आवश्यक आर्टिकल कंटेंट, भाषा और एक्सेस‑लेवल को कवर करता है। केवल विज़िटर के लिए उपलब्ध होना यह सिद्ध नहीं करता कि हर एंडपॉइंट या री‑यूज़ विधि आधिकारिक रूप से समर्थित है।
अपने संगठन की सपोर्ट नॉलेज को नियमित रूप से ताज़ा रखने के लिए API या एक्सपोर्ट अक्सर बेहतर विकल्प होते हैं। फिर भी किसी अधिकृत बाहरी प्रोडक्ट गाइड या ऐसे पेज के लिए ब्राउज़र लुकअप की ज़रूरत पड़ सकती है जो इस चैनल से नहीं मिलता। सॉल्वर जोड़ने से पहले यह ज़रूरत निश्चित कर लें।
इस वर्कफ़्लो को चार इनपुट चाहिए: अनुमत स्रोत, अनुरोधित आर्टिकल या प्रश्न, संबंधित उत्पाद संदर्भ, और अपेक्षित भाषा। साथ ही, इसे स्वीकार किए गए स्रोत कंटेंट के लिए गंतव्य और अधूरे लुकअप्स के लिए एक अलग रास्ते की ज़रूरत होती है।
यहाँ कलेक्शन‑स्कोप केवल सार्वजनिक डॉक्युमेंटेशन है। ग्राहक के नाम, टिकट‑इतिहास, अकाउंट टोकन, और निजी अटैचमेंट न तो रिट्रीवल रिक्वेस्ट में और न CAPTCHA पेलोड में शामिल होने चाहिए।
सपोर्ट ऑपरेटर बिना ग्राहक की पूरी बातचीत भेजे रिसर्च टास्क व्यक्त कर सकता है: उत्पाद की पहचान, जहाँ ज्ञात हो वहाँ संबंधित संस्करण, और जो फीचर या एरर डॉक्युमेंटेड है उसे निर्दिष्ट करना। ग्राहक‑विशेष निर्णय संगठन की सपोर्ट प्रणाली में ही रहें।
सार्वजनिक एक्सेस अपने आप सामूहिक री‑यूज़ की अनुमति नहीं देता। स्रोत की कलेक्शन और री‑यूज़ शर्तों का पालन करें, और जहाँ उपलब्ध हो वहाँ उचित आधिकारिक चैनल चुनें।
CAPTCHA हैंडलिंग को इस तरह जोड़ें कि वह समर्थित चैलेंज पहचानने के बाद और आर्टिकल बॉडी निकालने से पहले चले।
क्रम यह होना चाहिए: लक्षित डॉक्युमेंटेशन पेज खोलें, प्रतिक्रिया को वर्गीकृत करें, जहाँ उपयुक्त हो वहाँ समर्थित CAPTCHA संभालें, फिर आर्टिकल पर लौटें और कंटेंट की पुष्टि करें। कलेक्टर को इस पूरी श्रृंखला में मूल स्रोत URL और सपोर्ट‑प्रश्न दोनों को सुरक्षित रखना चाहिए।
टेक्स्ट‑इमेज CAPTCHA के लिए प्रलेखित ImageToTextTask व्यवहार अपनाएँ। reCAPTCHA v2 विजेट के लिए संबद्ध टोकन‑टास्क स्पेसिफिकेशन उपयोग करें। ये दोनों टास्क सपोर्ट आर्टिकल स्वयं नहीं देते।
CapSolver एरर रेफ़रेंस सेवा‑स्तर की विफलता और बाद में आने वाली पेज‑समस्या के बीच भेद करने में मदद कर सकता है। वास्तविक त्रुटि‑सूचना को ऑपरेशनल रिकॉर्ड में (सीक्रेट हटाकर) सुरक्षित रखें। अनुपलब्ध आर्टिकल‑सेलेक्टर को यह “सबूत” न मानें कि CAPTCHA हल करना असफल हो गया।
उसी लुकअप के साथ आगे की सभी कार्रवाइयों को जोड़े रखें। यदि हेल्प‑सेंटर होमपेज या लैंग्वेज‑सेलेक्टर पर रीडायरेक्ट कर देता है, तो रोबोट के पास अभी भी काम बाकी है—वह अभी अनुरोधित निर्देशों तक नहीं पहुँचा। चैलेंज पूरा हो जाना यह साबित नहीं करता कि वह सही जगह पर पहुँच गया।
व्यापक स्रोत‑निरीक्षण पैटर्न के लिए मौजूदा AI रिसर्च CAPTCHA गाइड देखें। ग्राहक सहायता के संदर्भ में अतिरिक्त आवश्यकता “अप्लिकेबिलिटी” है: कोई उत्तर एक उत्पाद संस्करण के लिए सही हो सकता है लेकिन दूसरे के लिए अनुपयुक्त।
अपना CapSolver बोनस कोड रिडीम करें
अपना ऑटोमेशन बजट तुरंत बढ़ाएँ!
CapSolver अकाउंट में टॉप‑अप करते समय बोनस कोड CAP26 उपयोग करें और हर रीचार्ज पर अतिरिक्त 5% बोनस पाएँ — बिना किसी सीमा के।
इसे अभी अपने CapSolver डैशबोर्ड में रिडीम करें।
किसी पेज को तभी स्वीकार करें जब उसके निर्देश रिसर्च‑टास्क के उत्पाद संदर्भ पर लागू हों।
मान लीजिए सपोर्ट टीम “Example Console” नाम के उत्पाद में फ़ाइल‑एक्सपोर्ट सेटिंग की जाँच कर रही है। चुनौती के बाद जो अनुमत हेल्प‑आर्टिकल खुला, वह पुराने एडमिन इंटरफ़ेस का वर्णन करता है। रिट्रीवल असली डॉक्युमेंटेशन तक पहुँचा, फिर भी ये निर्देश मौजूदा प्रश्न के लिए गलत हो सकते हैं।
दिखने वाला शीर्षक, प्रोडक्ट‑फैमिली, वर्शन नोट्स और भाषा को रिक्वेस्ट से मिला कर देखें। जहाँ प्रकाशक अपडेट‑डेट देता है, उसे स्रोत तथ्य की तरह दर्ज करें; पेज पर रोबोट के विजिट‑टाइम को नया प्रकाशन‑तारीख मान कर न बैठें।
भाषा के लिए स्पष्ट जाँच ज़रूरी है क्योंकि ऑटो‑रीडायरेक्ट आर्टिकल की लोकैल बदल सकता है। HTML का lang एट्रिब्यूट किसी एलिमेंट की भाषा बताता है। यह उपयोगी संकेत दे सकता है, लेकिन पूरे पेज के लिए एक मान देख कर यह न मान लें कि पूरा टेक्स्ट वही भाषा है जो उपयोगकर्ता ने माँगी थी; आर्टिकल की वास्तविक सामग्री भी जाँचें।
अनुवाद तब उपयोगी है जब वह स्पष्ट रूप से पहचाना गया हो। उसे स्रोत रिकॉर्ड में प्रकाशक के मूल टेक्स्ट की “चुपचाप जगह” न लेनी चाहिए, न ही यह संकेत देना चाहिए कि दोनों भाषा‑संस्करण एक‑साथ अपडेट हुए थे।
स्वीकृत स्रोत को हेल्प‑आर्टिकल की वास्तविक सामग्री पर केंद्रित रखें। वैरिफिकेशन प्रॉम्प्ट, नेविगेशन मेनू, असंबंधित सुझाव और पेज‑स्तरीय एरर‑संदेश बाहर रखें।
ऐसे सभी प्री‑रिक्विज़िट या वर्शन‑प्रतिबंध ज़रूर बचाकर रखें जो उत्तर को प्रभावित करते हैं। यदि आप वह नोट हटा दें जो किसी फ़ीचर को किसी खास उत्पाद‑एडिशन तक सीमित बताता है, तो अन्यथा सही सारांश भी भ्रामक हो सकता है।
जहाँ स्रोत में कोई प्रक्रिया (स्टेप‑बाय‑स्टेप) दी हो, वहाँ चरण और उसकी शर्त के बीच का संबंध सुरक्षित रखें। केवल इस वजह से कि पेज पर कोई मिलते‑जुलते की‑वर्ड हैं, सपोर्ट असिस्टेंट को किसी ऑपरेशन की अनुशंसा नहीं कर देनी चाहिए।
किसी सहेजे हुए आर्टिकल को केवल तब बदलें जब नया रिट्रीवल कंटेंट और अप्लिकेबिलिटी की जाँचों में पास हो जाए।
नॉलेज‑बेस को स्टोर किए गए स्रोत और उसे ताज़ा करने के ताज़े प्रयास के बीच भेद रखना चाहिए। यदि आज का रिक्वेस्ट CAPTCHA पर ही अटक गया, तो पुराने सत्यापित आर्टिकल को उसकी मौजूदा स्रोत‑जानकारी सहित रखें और असफल रिफ्रेश को अलग से दर्ज करें।
उदाहरण के लिए किसी स्रोत‑रिकॉर्ड को उपयोगी और समीक्षा‑योग्य बनाने के लिए ये जानकारी पर्याप्त है:
| आइटम | उद्देश्य |
|---|---|
| आधिकारिक आर्टिकल URL और शीर्षक | समर्थित स्रोत की पहचान करता है |
| उत्पाद और संबंधित संस्करण | दिखाता है कि यह किस ग्राहक‑स्थिति पर लागू है |
| आर्टिकल भाषा | अनचाही लोकैल‑बदलाव से बचाती है |
| प्रकाशक की अपडेट‑डेट (यदि दी हो) | स्वयं स्रोत के “ताज़ापन” सिग्नल को सुरक्षित रखती है |
| आखिरी सत्यापित रिट्रीवल‑समय | बताता है कि कंटेंट आखिरी बार कब सफलतापूर्वक जाँचा गया |
| नवीनतम रिट्रीवल‑परिणाम | एक्सेस‑इंटरप्शन और कंटेंट‑चेंज को अलग करता है |
W3C की Data on the Web Best Practices यह सुझाव देती है कि डेटा‑उपयोगकर्ताओं को मदद के लिए प्रोविनेंस और वर्शन‑सूचना दी जाए। यहाँ लागू करने पर, स्रोत URL और अपडेट‑इन्फ़ो यह बताते हैं कि कौन‑सा डॉक्युमेंटेशन किसी उत्तर को सपोर्ट कर रहा है। ये प्रस्तावित कलेक्शन‑फ़ील्ड हैं, CapSolver रिस्पॉन्स‑स्कीमा नहीं। स्वीकृत आर्टिकल को अपने संगठन की रिटेंशन और री‑यूज़ नीति के तहत स्टोर करें। सॉल्वर‑डायग्नॉस्टिक्स को सपोर्ट‑टेक्स्ट से अलग रखें।
यदि पुराना स्रोत मौजूदा प्रश्न के लिए बहुत पुराना पड़ गया है, तो इस टास्क को “रीव्यू” के लिए रूट करें, न कि उसे “ताज़ा सत्यापित” जैसा प्रस्तुत करें। उपयुक्त अधिकतम‑आयु उत्पाद और प्रश्न पर निर्भर करती है; यह गाइड कोई सार्वभौमिक एक्सपायरी‑पीरियड निर्धारित नहीं करता।
जब कोई लुकअप पूरा नहीं हो पाता, तो एक स्पष्ट स्रोत‑सीमा लौटाएँ ताकि सपोर्ट एजेंट किसी अन्य अनुमत स्रोत का चयन कर सके या मैन्युअल जाँच कर सके।
उदाहरण: आधिकारिक गाइड की पहचान हो गई, पर उसका मौजूदा कंटेंट इसलिए नहीं मिल सका क्योंकि वैरिफिकेशन अधूरा रह गया। यह कथन किसी खाली आर्टिकल या गढ़े हुए उत्तर से कहीं अधिक उपयोगी है। जहाँ उपलब्ध हो, अनुरोधित स्रोत और अंतिम सत्यापित कंटेंट‑डेट भी संलग्न करें।
बार‑बार के प्रयास सीमित रखें। यदि सॉल्वर रिक्वेस्ट‑एरर रिपोर्ट करता है, तो रिक्वेस्ट ठीक करें। यदि CAPTCHA हल हो जाती है लेकिन नेविगेशन बार‑बार साइन‑इन पेज पर ही रुक जाता है, तो एक्सेस‑रिक्वायरमेंट की जाँच करें। अतिरिक्त सॉल्व प्रयास अनुपलब्ध अनुमति नहीं दे सकते।
अंतिम सपोर्ट‑उत्तर को फिर भी संगठन की समीक्षा‑प्रक्रिया पास करनी होगी। सफल डॉक्युमेंटेशन‑लुकअप किसी ग्राहक अकाउंट में बदलाव की अनुमति नहीं देता, न ही किसी संवेदनशील ऑपरेशन का निर्देश अपने आप अधिकृत करता है।
जब अनुमत डॉक्युमेंटेशन लुकअप के बीच कोई समर्थित CAPTCHA बाधा डाले, तो CapSolver का उपयोग करें, फिर यह सत्यापित करें कि प्राप्त आर्टिकल वास्तव में उत्पाद‑प्रश्न का उत्तर देता है। डिलीवेरेबल है सपोर्ट टीम के लिए उपयोगी स्रोत सामग्री, और यह भी स्पष्टता कि जब नवीनतम स्रोत अब भी अनुपलब्ध हो।
प्रश्न: क्या हर कस्टमर‑सपोर्ट नॉलेज वर्कफ़्लो को CAPTCHA सॉल्वर चाहिए?
नहीं। जहाँ उपयुक्त API या एक्सपोर्ट आवश्यक सामग्री दे रहा हो, वहाँ उसी का उपयोग करें। सॉल्विंग केवल उसी आवश्यक, अनुमति‑प्राप्त ब्राउज़र‑स्टेप में जोड़ें जो किसी समर्थित CAPTCHA से टकराता है।
प्रश्न: क्या CAPTCHA पेज को हेल्प‑आर्टिकल की तरह इंडेक्स किया जा सकता है?
नहीं। इसे अधूरे लुकअप के रूप में खारिज कर देना चाहिए। वैरिफिकेशन टेक्स्ट अनुरोधित उत्पाद डॉक्युमेंटेशन नहीं है और उसे उत्तर‑सबूत के रूप में नहीं जोड़ा जाना चाहिए।
प्रश्न: यदि नवीनतम रिफ्रेश असफल हो जाए तो क्या होना चाहिए?
अपनी रिटेंशन नीति के तहत आखिरी सत्यापित आर्टिकल को सुरक्षित रखें और असफल रिफ्रेश को अलग से रिकॉर्ड करें। स्रोत की उम्र सपोर्ट एजेंट के लिए स्पष्ट रूप से दिखाई दे।
प्रश्न: क्या यह प्रक्रिया निजी टिकट या ग्राहक अकाउंट डेटा इकट्ठा करती है?
नहीं। स्कोप केवल अनुमत स्रोतों से सार्वजनिक हेल्प और उत्पाद डॉक्युमेंटेशन है। निजी ग्राहक‑रिकॉर्ड इस कलेक्शन वर्कफ़्लो से बाहर रहते हैं।
प्रश्न: क्या यह Zendesk के साथ CapSolver का आधिकारिक इंटीग्रेशन है?
नहीं। Zendesk डॉक्युमेंटेशन यह दिखाता है कि वास्तविक उपयोग में हेल्प‑सेंटर CAPTCHA व्यवधान आ सकते हैं। यह गाइड किसी प्रमाणित इंटीग्रेशन या किसी Zendesk ग्राहक साइट पर लाइव‑टेस्ट का दावा नहीं करता।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
Rust में वेब स्क्रैपिंग के स्केलेबल आर्किटेक्चर सीखें, reqwest, scraper, असिंक्रोनस स्क्रैपिंग, हेडलेस ब्राउज़र स्क्रैपिंग, प्रॉक्सी रोटेशन, और संगत CAPTCHA का निपटारा।
CapSolver के साथ RoxyBrowser के एकीकरण करें ताकि ब्राउज़र के कार्यों को स्वचालित किया जा सके और reCAPTCHA, Turnstile और अन्य CAPTCHAs को बायपास किया जा सके।
