🎉नयाAI एजेंट के लिए CapSolver-MCP, एजेंट टूल और SDK एकीकरण
Rajinder Singh
Deep Learning Researcher
प्रकाशित Sep 29, 2026
अद्यतन Sep 29, 2026 · मिनट पढ़ने का समय
बड़े भाषा मॉडल असमान वेब सामग्री को उपयोगी रिकॉर्ड में बदल सकते हैं, लेकिन वे विश्वसनीय पृष्ठ डेटा प्राप्त करने के लिए आवश्यक ऑपरेशनल कार्य को हटा नहीं सकते। एक उत्पादन पाइपलाइन को अनुमति चेक, अनुरोध सीमा, जावास्क्रिप्ट के आवश्यकता पर ब्राउजर निष्पादन, सत्यापन चेकपॉइंट के लिए स्पष्ट नियंत्रण और डेटाबेस में रिकॉर्ड पहुंचने से पहले निश्चित सत्यापन की आवश्यकता होती है।
GLM-5.3 अर्थ-अनुमान लेयर पर उपयोगी है। इसका API-संगत कार्य प्रवाह रेंडर किए गए सामग्री को वर्गीकृत कर सकता है, टेक्स्ट को स्कीमा में मैप कर सकता है, एक फील्ड के अनुपस्थिति के कारण समझा सकता है, और पृष्ठों के बीच अंतर सामान्यीकृत कर सकता है। अधिकृत स्वचालन के लिए जिसे समर्थित सत्यापन कार्य मिलता है, CapSolver को निकालने से पहले रखा जा सकता है जबकि एप्लिकेशन पृष्ठ सेशन और अंतिम परिणाम के सत्यापन के नियंत्रण में रहता है।
इस गाइड में एक व्यापक वास्तुविधि प्रस्तुत की जाती है, एक विशिष्ट वेबसाइट के लिए निर्देश नहीं। इसका उपयोग केवल सार्वजनिक या अन्यथा अनुमोदित डेटा के लिए करें और जब एक वर्कफ़्लो अपने अनुमोदित सीमा से बाहर लॉगिन, भुगतान, व्यक्तिगत-डेटा या अनुमति सीमाओं तक पहुंच जाता है तो रोक दें।
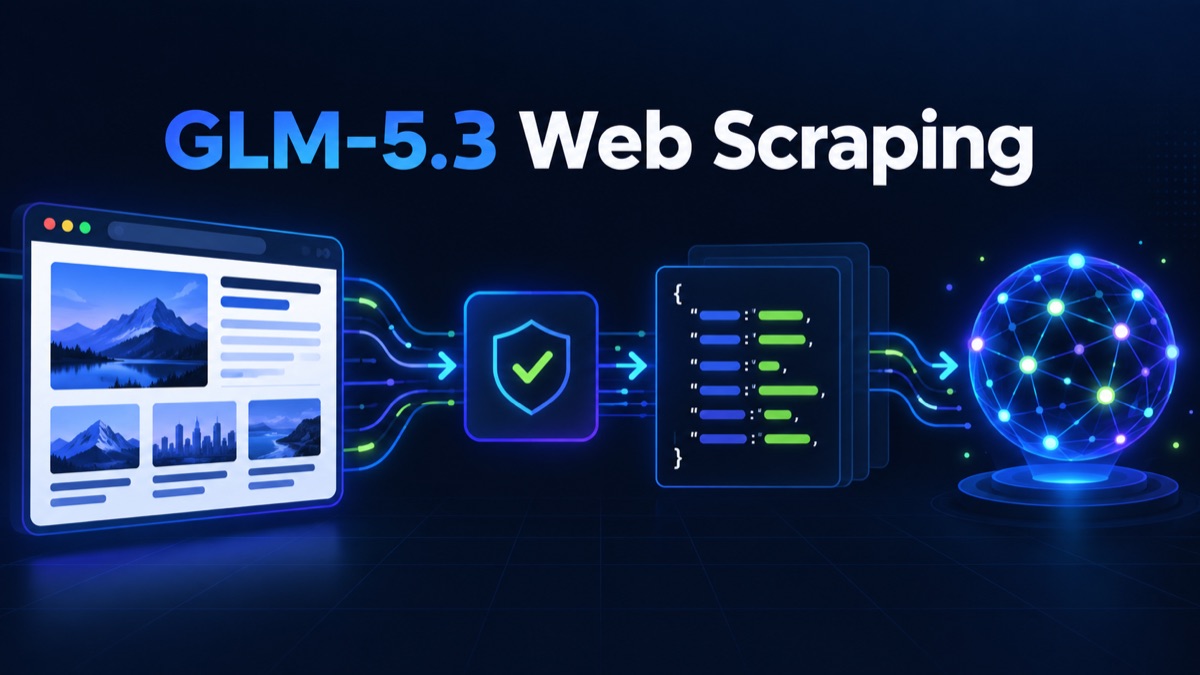
एक विश्वसनीय GLM-5.3 वेब स्क्रैपिंग प्रणाली छोटे चरणों के अनुक्रम का उपयोग करती है। प्रत्येक चरण अगले चरण द्वारा सत्यापित कर सकने योग्य एक टाइप किए गए परिणाम उत्पन्न करता है।
| चरण | जिम्मेदारी | अपेक्षित आउटपुट | बंद करने की शर्त |
|---|---|---|---|
| अनुमति गेट | लक्ष्य, डेटा श्रेणी, दर और उद्देश्य की जांच करें | अनुमोदित कार्य परिभाषा | श्रेणी अनुमोदित नहीं है |
| एक्सेस लेयर | पृष्ठ को डाउनलोड करें या रेंडर करें | स्थिति, हेडर, अंतिम URL, HTML या स्क्रीनशॉट | लॉगिन, भुगतान, निजी डेटा या अस्वीकृत पहुंच |
| रिस्पॉन्स वर्गीकरण | सामग्री, खाली शेल, दर सीमा या सत्यापन पृष्ठ की पहचान करें | नामित पृष्ठ स्थिति | अज्ञात या समर्थित स्थिति नहीं |
| सत्यापन अनुकूलक | जब अनुमति होती है तो एक दस्तावेजीकृत कार्य प्रस्तुत करें | तैयार, प्रसंस्करण या अंतिम त्रुटि | समय सीमा या प्रयास बजट पूरा हो गया |
| GLM निकालना | अनुमति प्राप्त सामग्री को एक सख्त स्कीमा में बदलें | उम्मीदवार जेसॉन रिकॉर्ड | आउटपुट अमान्य या साक्ष्य द्वारा समर्थित नहीं है |
| निश्चित सत्यापन | प्रकार, आवश्यक क्षेत्र, दोहराए गए और स्रोत साक्ष्य की जांच करें | स्वीकृत रिकॉर्ड या स्पष्ट अस्वीकृति | कोई व्यावसायिक नियम विफल हो जाता है |
| संग्रहण | अद्वितीय लिखावट करें | स्थिर रिकॉर्ड ID और ट्रेस लिंक | स्रोत कुंजी पहले से मौजूद है बिना एक नई संस्करण के |
सबसे महत्वपूर्ण सीमा एक्सेस और अर्थानुमान के बीच है। यदि मॉडल को चुनौती पृष्ठ के HTML प्राप्त होता है, तो यह निश्चित रूप से इस पृष्ठ को लक्ष्य सामग्री के रूप में वर्णित कर सकता है। मॉडल को प्रेरित करने से पहले रिस्पॉन्स को वर्गीकृत करें।
ओर्केस्ट्रेशन उदाहरण में पायथन 3.11 या नए उपयोग किया जाता है और requests पैकेज। पहचान प्रमाण वातावरण चर में रखें और कभी-कभी उन्हें स्रोत कोड, प्रेरणा, लॉग, स्क्रीनशॉट या संगत विन्यास में शामिल न करें।
python -m venv .venv
source .venv/bin/activate
pip install requests

export ZAI_API_KEY="replace-with-your-z-ai-key"
export CAPSOLVER_API_KEY="replace-with-your-capsolver-key"
आधिकारिक Z.ai API दस्तावेज़ीकरण में https://api.z.ai/api/paas/v4/chat/completions पर चैट-पूर्णता एंडपॉइंट का उपयोग किया जाता है। डेप्लॉयमेंट से पहले GLM-5 रिपॉजिटरी या आपके Z.ai कंसोल में वर्तमान मॉडल पहचानकर्ता की पुष्टि करें; इस गाइड में glm-5.3-flash का उपयोग एक वातावरण-संगत डिफ़ॉल्ट के रूप में किया जाता है।
मॉडल से "सभी महत्वपूर्ण चीजों को निकालें" मत पूछें। पृष्ठ एकत्र करने से पहले क्षेत्र, अनुमति शून्य व्यवहार और साक्ष्य की आवश्यकता की परिभाषा करें।
from dataclasses import dataclass
from datetime import datetime, timezone
from typing import Any

@dataclass(frozen=True)
class ExtractionJob:
    source_url: str
    allowed_host: str
    required_fields: tuple[str, ...]
    max_input_chars: int = 40_000

def validate_record(job: ExtractionJob, record: dict[str, Any]) -> dict[str, Any]:
    missing = [name for name in job.required_fields if not record.get(name)]
    if missing:
        raise ValueError(f"missing_required_fields:{','.join(missing)}")
    if record.get("source_url") != job.source_url:
        raise ValueError("source_url_mismatch")
    record["validated_at"] = datetime.now(timezone.utc).isoformat()
    return record
मॉडल को केवल तभी null लौटाया जा सकता है जब स्कीमा स्पष्ट रूप से इसकी अनुमति देता है। आवश्यक मानों को सामान्य कोड द्वारा पृष्ठ साक्ष्य के साथ पुष्टि करनी चाहिए।
एक्सेस लेयर को केवल HTML के एक स्ट्रिंग के बजाय छोटा स्टेट ऑब्जेक्ट वापस करना चाहिए। वर्गीकरण कर सकता है जो स्थिति कोड, अंतिम URL, सामग्री प्रकार, अपेक्षित सेलेक्टर और ज्ञात चेकपॉइंट चिह्नों का उपयोग करता है।
from enum import Enum

class PageState(str, Enum):
    CONTENT = "content"
    JAVASCRIPT_REQUIRED = "javascript_required"
    RATE_LIMITED = "rate_limited"
    LOGIN_REQUIRED = "login_required"
    VERIFICATION = "verification"
    UNKNOWN = "unknown"

def choose_action(state: PageState) -> str:
    return {
        PageState.CONTENT: "extract",
        PageState.JAVASCRIPT_REQUIRED: "render_in_authorized_browser",
        PageState.RATE_LIMITED: "back_off",
        PageState.LOGIN_REQUIRED: "stop_for_operator",
        PageState.VERIFICATION: "evaluate_supported_task",
        PageState.UNKNOWN: "stop_for_review",
    }[state]
HTTP 403 और HTTP 429 को सामान्य पुनर्प्रयास लूप में नहीं भेजें। अस्वीकृत अनुरोध के लिए अनुमति और विन्यास समीक्षा की आवश्यकता होती है। दर सीमा अनुरोध के लिए एक वैश्विक संयोजन कम करना आवश्यक है और किसी भी सर्वर प्रदत्त पुनर्प्रयास खंड का सम्मान करना आवश्यक है।
CapSolver के आधिकारिक API का उपयोग createTask के माध्यम से एक दस्तावेजीकृत कार्य प्रस्तुत करने के लिए किया जाता है। असिंक्रनस कार्य की जांच getTaskResult के साथ की जाती है। एप्लिकेशन को वर्तमान कार्य दस्तावेज़ीकरण से कार्य प्रकार चुनना चाहिए और केवल उन क्षेत्रों को पारित करें जो इस अनुमति चेकपॉइंट के लिए आवश्यक हैं।
import os
import time
import requests

CAPSOLVER_BASE = "https://api.capsolver.com"

def solve_supported_task(task: dict, *, timeout_seconds: int = 45) -> dict:
    api_key = os.environ["CAPSOLVER_API_KEY"]
    created = requests.post(
        f"{CAPSOLVER_BASE}/createTask",
        json={"clientKey": api_key, "task": task},
        timeout=15,
    ).json()
    if created.get("errorId") != 0:
        raise RuntimeError(created.get("errorCode", "create_task_failed"))
    if created.get("status") == "ready":
        return created["solution"]

    task_id = created.get("taskId")
    if not task_id:
        raise RuntimeError("missing_task_id")

    deadline = time.monotonic() + timeout_seconds
    while time.monotonic() < deadline:
        time.sleep(3)
        result = requests.post(
            f"{CAPSOLVER_BASE}/getTaskResult",
            json={"clientKey": api_key, "taskId": task_id},
            timeout=15,
        ).json()
        if result.get("errorId") != 0:
            raise RuntimeError(result.get("errorCode", "task_failed"))
        if result.get("status") == "ready":
            return result["solution"]
        if result.get("status") not in {"idle", "processing"}:
            raise RuntimeError("unexpected_task_status")

    raise TimeoutError("verification_task_deadline_exceeded")
कॉलर को डिफ़ॉल्ट रूप से केवल एक सीमित प्रयास की अनुमति दें। वापस किए गए समाधान को उसी ब्राउजर संदर्भ में दस्तावेज़ीकृत एंट्री पथ के माध्यम से लागू किया जाना चाहिए जिसने चेकपॉइंट की पहचान की। यदि पृष्ठ अपेक्षित स्थिति में संक्रमित नहीं होता है, तो विफलता की घोषणा करें या मानव समीक्षा के लिए अनुरोध करें।
CapSolver बोनस कोड का उपयोग करें
अपने स्वचालन बजट को तत्काल बढ़ाएं!
CapSolver खाता में जमा करते समय बोनस कोड CAP26 का उपयोग करें ताकि प्रत्येक भुगतान पर 5% बोनस मिले — कोई सीमा नहीं।
अपने CapSolver डैशबोर्ड में अब बोनस कोड का उपयोग करें
जब पृष्ठ को सामग्री के रूप में पुष्टि कर ली जाती है, तो नेविगेशन शोर, स्क्रिप्ट, छिपे तत्व, दोहराए गए बैनर और असंबंधित पृष्ठ च्रोम को हटा दें। शीर्षक, लेबल, तालिकाएं और स्रोत संदर्भ बरकरार रखें। ब्राउजर कुकीज, प्राधिकरण हेडर, व्यक्तिगत डेटा या कच्चे सेशन ट्रेस को मॉडल को नहीं भेजें।
import json
import os
import requests

ZAI_ENDPOINT = "https://api.z.ai/api/paas/v4/chat/completions"

def extract_with_glm(job: ExtractionJob, normalized_text: str) -> dict:
    prompt = {
        "source_url": job.source_url,
        "required_fields": list(job.required_fields),
        "rules": [
            "एक जेसॉन ऑब्जेक्ट लौटाएं और कोई प्रोसा नहीं।",
            "केवल पृष्ठ_टेक्स्ट में मौजूद साक्ष्य का उपयोग करें।",
            "एक अनुपस्थित आवश्यक मान का अनुमान न लगाएं।",
            "स्रोत_यूआरएल केवल आपूर्ति किए गए रूप में शामिल करें।",
        ],
        "page_text": normalized_text[: job.max_input_chars],
    }
    response = requests.post(
        ZAI_ENDPOINT,
        headers={
            "Authorization": f"Bearer {os.environ['ZAI_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "model": os.getenv("GLM_MODEL", "glm-5.3-flash"),
            "messages": [
                {"role": "system", "content": "साक्ष्य-समर्थित संरचित डेटा निकालें।"},
                {"role": "user", "content": json.dumps(prompt, ensure_ascii=False)},
            ],
            "temperature": 0,
        },
        timeout=60,
    )
    response.raise_for_status()
    content = response.json()["choices"][0]["message"]["content"]
    return json.loads(content)
इस उदाहरण को एक एडाप्टर सीमा के रूप में लें। उत्पादन उपयोग से पहले आधिकारिक Z.ai दस्तावेज़ीकरण में वर्तमान अनुरोध विकल्प और संरचित-आउटपुट विशेषताओं की पुष्टि करें। यदि मॉडल जेसॉन को मार्कडाउन में बंद कर देता है या संकल्प के अनुबंध के बाहर टेक्स्ट लौटाता है, तो इसे चुपके से ठीक करने के बजाय अस्वीकृत कर दें।
दो अलग-अलग पुष्टि की आवश्यकता होती है।
पहले, ब्राउजर परिणाम की पुष्टि करें। अंतिम URL, अपेक्षित शीर्षक, लक्ष्य कंटेनर और नई त्रुटि की अनुपस्थिति के साथ अपेक्षित वर्कफ़्लो के मेल की पुष्टि करें। एक सफल कार्य प्रतिक्रिया अकेले पृष्ठ के आगे बढ़ने के बारे में सबूत नहीं है।
दूसरा, निकाला गया रिकॉर्ड की पुष्टि करें। आवश्यक स्ट्रिंग, संख्यात्मक श्रेणी, तारीख, सामान्यीकृत URL, दोहराए गए कुंजी और साक्ष्य टुकड़े की जांच करें। उच्च प्रभाव वाले क्षेत्रों के लिए, मान की तुलना निश्चित सेलेक्टर या पृष्ठ के दूसरे स्वतंत्र प्रतिनिधित्व से करें।
def run_extraction(job: ExtractionJob, state: PageState, page_text: str) -> dict:
    action = choose_action(state)
    if action != "extract":
        raise RuntimeError(f"page_not_ready_for_model:{action}")
    candidate = extract_with_glm(job, page_text)
    return validate_record(job, candidate)
इस अंतिम द्वार से एक चुनौती पृष्ठ, मॉडल विचलन या आंशिक रेंडरिंग को डेटासेट में सफल खोज के रूप में प्रवेश नहीं करने दें।
एक ट्रेस आईडी, स्रोत यूआरएल, अंतिम यूआरएल, पृष्ठ स्थिति, सामग्री हैश, मॉडल नाम, प्रेरणा संस्करण, स्कीमा संस्करण, सत्यापन परिणाम और प्रक्रिया समय के साथ रिकॉर्ड करें। लघु-जीवी ऑपरेशनल डीबगिंग के लिए कार्य आईडी और त्रुटि कोड संग्रहीत करें, लेकिन समाधान टोकन, गुप्त और असंबंधित सेशन डेटा संग्रहीत न करें।
एक बजट के साथ पूरे कार्य के लिए एक बजट लागू करें। HTTP प्रयास, ब्राउजर नेविगेशन, सत्यापन प्रयास, GLM कॉल, इनपुट अक्षर और बीते समय की गणना करें। जब बजट समाप्त हो जाता है, तो एक टाइप किए गए विफलता लौटाएं बजाय एक घटक के पुनः शुरू करने के।
एक उपयोगी मापदंड सेट में शामिल हो सकते हैं:
| लक्षण | संभावित कारण | सही कार्यवाही |
|---|---|---|
| GLM एक सत्यापन पृष्ठ के बारे में विवरण लौटाता है | प्रेरणा से पहले पृष्ठ-स्थिति वर्गीकरण नहीं किया गया | मॉडल कॉल रोकें और पृष्ठ-स्थिति निर्धारण ठीक करें |
| JSON पार्स करता है लेकिन आवश्यक क्षेत्र खाली हैं | प्रेरणा या स्रोत साक्ष्य अपूर्ण है | रिकॉर्ड को अस्वीकृत करें और निकाला गया सामग्री की जांच करें |
| कार्य तैयार है लेकिन पृष्ठ अभी भी ब्लॉक है | ब्राउजर संदर्भ या कार्य पैरामीटर मेल नहीं खाते | URL, सेशन, उपयोगकर्ता एजेंट, समय और दस्तावेज़ीकृत आवश्यकताओं की तुलना करें |
| स्वीकृत रिकॉर्ड बरकरार रहते हैं लेकिन लागत बढ़ती है | ब्राउजर या मॉडल एस्केलेशन बहुत व्यापक है | निश्चित फ़िल्टर और प्रति कार्य बजट जोड़ें |
| पुनर्प्रयास के बाद दोहराए गए पंक्तियां दिखाई देती हैं | संग्रहण अद्वितीय नहीं है | स्थिर स्रोत कुंजी और सामग्री संस्करण द्वारा अपडेट करें |
| HTTP 429 दोहराता है | कार्यकर्ता पर एक्सेस नियंत्रित होता है, न कि वैश्विक रूप से | एक साझा दर बजट जोड़ें और पुनर्प्रयास दिशानिर्देशों का सम्मान करें |
GLM-5.3 वेब डेटा निकालने को अधिक लचीला बना सकता है, लेकिन विश्वसनीयता आसपास के प्रणाली से आती है। एक्सेस नियंत्रण, रेंडरिंग, पृष्ठ-स्थिति वर्गीकरण, सत्यापन नियंत्रण, स्कीमा सत्यापन और संग्रहण को स्पष्ट चरणों के रूप में रखें। एप्लिकेशन द्वारा लक्ष्य सामग्री देख रहा है इसकी पुष्टि करने के बाद ही मॉडल का उपयोग करें।
अधिकृत ब्राउजर वर्कफ़्लो के लिए समर्थित सत्यापन कार्य के साथ, CapSolver दस्तावेज़ीकृत कार्य सीमा प्रदान कर सकता है। एप्लिकेशन के लिए अनुमति, सेशन लगातारता, सीमित पुनर्प्रयास, गुप्त नियंत्रण और मूल वर्कफ़्लो के पूरा होने के सबूत की जिम्मेदारी रहती है।
Q: क्या GLM-5.3 वेब स्क्रैपिंग में ब्राउज़र की जगह ले सकता है?
नहीं। यह पाठ, स्क्रीनशॉट या नॉर्मलाइज्ड रिकॉर्ड की व्याख्या कर सकता है, लेकिन नेविगेशन, रेंडरिंग, स्टेट, परमिशन और अंतिम परिणाम की पुष्टि करने वाला ब्राउज़र या HTTP क्लाइंट अभी भी स्वामी है।
Q: क्या कच्चा HTML सीधे GLM-5.3 को भेजा जाना चाहिए?
आमतौर पर नहीं। पहले प्रतिक्रिया को वर्गीकृत करें, स्क्रिप्ट और दोहराए गए लेआउट शोर को हटाएं, महत्वपूर्ण लेबल और संरचना को बरकरार रखें, और निष्कर्षण स्कीम द्वारा आवश्यक डेटा तक सीमित रखें।
Q: कार्यप्रवाह कब CapSolver कॉल करना चाहिए?
केवल अनुमत कार्यप्रवाह में समर्थित कार्य की पहचान करने के बाद। वर्तमान दस्तावेज़ीकृत कार्य प्रकार का उपयोग करें, आवश्यक ब्राउज़र संदर्भ को बरकरार रखें, एक समय सीमा निर्धारित करें, और यह सत्यापित करें कि पेज वास्तव में जारी रहा।
Q: मान्य JSON का अर्थ निकाले गए रिकॉर्ड की सही होने का अर्थ है?
नहीं। JSON सिंटैक्स तथ्यात्मक सटीकता को साबित नहीं करता है। आवश्यक क्षेत्र, प्रकार, URL, तारीखें, संख्यात्मक सीमाएं, दोहराव और स्रोत साक्ष्य को अभी भी कोड में जांचा जाना चाहिए।
Q: जब पेज स्टेट अज्ञात होता है तो क्या होना चाहिए?
रोकें और समीक्षा के लिए अनुरोध करें। मॉडल को अज्ञात सामग्री न भेजें या अतिरिक्त ब्राउज़र और सत्यापन चरणों के माध्यम से पुनः प्रयास न करें।
Q: क्या इस डिज़ाइन का निजी या सीमित डेटा के लिए उपयोग किया जा सकता है?
डिज़ाइन के कारण अनुमति नहीं बनती है। इसका उपयोग केवल सार्वजनिक या अन्यथा अनुमत डेटा के लिए करें, संग्रहित जानकारी को कम करें, और लागू शर्तों, संविदाओं और कानून का पालन करें।
Rajinder Singh
Deep Learning Researcher
Making CAPTCHA solving more reliable in automated workflows.
लेखक के बारे में
कैप्चा एमसीपी प्रॉक्सी समर्थन को क्लाइंट कनेक्शन, ब्राउज़र और सॉल्वर कार्य के बीच समझें, वर्तमान कैपसॉल्वर एमसीपी टूल्स की सीमाओं को शामिल करते हुए।
स्टेजहैंड कैप्चा हैंडलिंग को समझें, ब्राउज़र कार्यों की तुलना सॉल्वर सेवाओं के साथ करें, और स्थानीय ब्राउज़रों या होस्टेड सेशन के लिए एक स्पष्ट दृष्टिकोण चुनें।